


Knowledge Catalog(旧称 Dataplex Universal Catalog)のデータリネージを使用すると、データアセットがシステム間でどのように移動し、変化するかを追跡して、変換の検査、実行履歴の確認、依存関係の分析を行うことができます。トラッキングを有効にすると、 Google Cloud コンソールで BigQuery、Vertex AI、カタログ化されたエントリのグラフとリストを探索したり、Data Lineage API を使用してリネージの詳細を取得したりできます。詳細については、データリネージについてをご覧ください。
ロールと権限
Data Lineage API を有効にすると、データリネージはリネージ情報を自動的に追跡します。データアセットのリネージのキャプチャには管理者や編集者のロールは必要ありません。
データリネージを表示するには、特定の Identity and Access Management(IAM)権限が必要です。リネージ情報はプロジェクト間でキャプチャされるため、複数のプロジェクトで権限が必要です。
Knowledge Catalog、BigQuery、または Vertex AI でリネージを表示する場合: リネージを表示するプロジェクトでリネージ情報を表示する権限が必要です。
他のプロジェクトで記録されたリネージを表示する場合: リネージが記録されたプロジェクトでリネージ情報を表示する権限が必要です。
データリネージの表示に必要な権限を取得するには、次の IAM ロールを付与するよう管理者に依頼してください。
-
すべて: リネージが記録されるプロジェクトと、リネージが表示されるプロジェクトに対するデータリネージ閲覧者(
roles/datalineage.viewer) -
BigQuery テーブルの詳細を表示する: テーブルのストレージ プロジェクトに対する BigQuery メタデータ閲覧者(
roles/bigquery.metadataViewer) -
BigQuery ジョブの詳細を表示する: ジョブのコンピューティング プロジェクトに対する BigQuery リソース閲覧者(
roles/bigquery.resourceViewer) -
カタログ化された他のアセットの詳細を表示する: カタログ エントリが保存されているプロジェクトに対する Dataplex Catalog 閲覧者(
roles/dataplex.catalogViewer) -
リネージグラフから Dataform リポジトリまたは BigQuery パイプラインを開く: Dataform リポジトリが保存されているプロジェクトに対する Dataform 閲覧者(
roles/dataform.viewer)
ロールの付与については、プロジェクト、フォルダ、組織へのアクセス権の管理をご覧ください。
これらの事前定義ロールには、データリネージの表示に必要な権限が含まれています。必要とされる正確な権限については、「必要な権限」セクションを開いてご確認ください。
必要な権限
データリネージを表示するには、次の権限が必要です。
-
BigQuery テーブルの詳細を表示する: テーブルのストレージ プロジェクトに対する
bigquery.tables.get -
BigQuery ジョブの詳細を表示する: ジョブのコンピューティング プロジェクトに対する
bigquery.jobs.get -
リネージグラフから Dataform リポジトリまたは BigQuery パイプラインを開く: Dataform リポジトリが保存されているプロジェクトに対する
dataform.repositories.getとdataform.workflowInvocations.get
カスタムロールや他の事前定義ロールを使用して、これらの権限を取得することもできます。
データリネージ ビューのタイプ
リネージ情報は、 Google Cloud コンソールでインタラクティブなグラフまたは構造化リストとして表示できます。どちらのビューにも、プロジェクトのリソースと、それらを作成または変換したプロセスの関係が表示されます。たとえば、クエリとパイプラインがテーブル、データセット、モデルなどのデータアセットをどのように変換するかを確認できます。
グラフ要素(ノード、エッジ、プロセス アイコン、ラベルなど)とリスト表示で使用可能な列の詳細については、Knowledge Catalog のデータリネージの可視化についてをご覧ください。
データリネージを有効にする
データリネージを有効にして、サポートされているシステムのリネージ情報の自動追跡を開始します。デフォルトでは、API を有効にすると、サポートされているほとんどのサービスでリネージ トラッキングが有効になります。詳細については、自動データリネージ トラッキングとデータリネージ取り込み制御についてをご覧ください。
Knowledge Catalog では、プレミアム処理 SKU とメタデータ ストレージ SKU に基づいてデータリネージの料金が請求されます。詳細については、データリネージの概要の料金セクションと Knowledge Catalog の料金をご覧ください。
リネージを表示するプロジェクトと、リネージが記録されているプロジェクトの両方で Data Lineage API を有効にする必要があります。詳細については、プロジェクトのタイプをご覧ください。
- リネージ情報をキャプチャする手順は次のとおりです。
-
Google Cloud コンソールの [プロジェクト セレクタ] ページで、リネージを記録するプロジェクトを選択します。
データリネージ API を有効にします。
- リネージを記録するプロジェクトごとに、上記の手順を繰り返します。
-
リネージを表示するプロジェクトで、データリネージ API と Dataplex API を有効にします。
サービスの系統の取り込みを制御する
プロジェクト、フォルダ、または組織レベルで、特定のサービスの自動リネージ トラッキングを選択的に有効または無効にできます。
これらの構成がリソースツリーを介して階層的に適用される方法については、データリネージ取り込み制御についてをご覧ください。
リネージを表示
データがどのように変換され、システム間で移動するかを追跡するには、 Google Cloud コンソールまたは API を使用してデータリネージを表示します。
コンソール
Google Cloud コンソールのデータリネージ情報には、さまざまな開始点からアクセスできます。
- Knowledge Catalog: Knowledge Catalog の [検索] ページに移動し、検索モードとして [Knowledge Catalog] を選択します。表示するエントリを検索してクリックします。詳細については、Knowledge Catalog でデータアセットを検索するをご覧ください。
- BigQuery: [BigQuery] ページに移動し、データリネージを表示するテーブルを開きます。
- Vertex AI: [データセット] ページまたは [Model Registry] ページに移動し、データリネージを表示するデータセットまたはモデルをクリックします。
リネージグラフを表示する手順は次のとおりです。
[リネージ] タブをクリックします。
デフォルトの [グラフ] ビューが開き、システムとリージョン間のテーブルレベルのリネージが表示されます。詳細については、リネージグラフ ビューをご覧ください。
リネージグラフを手動で探索するには、ノードの横にある [展開] をクリックして、一度に 5 つのノードを読み込みます。
詳細については、リネージグラフを探索するをご覧ください。
[グラフ] ビューでノードをクリックします。
[詳細] パネルが開き、完全修飾名やタイプなど、アセットに関する情報が表示されます。詳細については、リネージノードの詳細を表示するをご覧ください。
[グラフ] ビューで、プロセス アイコン付きのエッジをクリックします。
[クエリ] パネルが開きます。詳細については、変換ロジックを検査すると実行の監査と履歴をご覧ください。
- 変換ロジックを検査するには、[詳細] タブをクリックします。
- 実行の監査と履歴を表示するには、[実行] タブをクリックします。
[リネージ エクスプローラ] パネルで、[方向]、[依存関係のタイプ]、[期間] などのフィルタ条件を選択し、[適用] をクリックします。
これによって、特定のリージョン内のフォーカス ビューが開きます。このビューでは、グラフが自動的に最大 3 レベルのノードまで展開されます。詳細については、データリネージ ビューをフィルタしてハイライト表示するをご覧ください。
フォーカスした [グラフ] ビューでノードを選択し、ノードの詳細パネルで [Visualize Path] をクリックして、選択したノードからルートエントリまでのリネージパスを可視化します(フォーカスされたビューのみ)。
詳細については、データリネージパスを可視化するをご覧ください。
列レベルのリネージを表示するには(BigQuery ジョブと Managed Service for Apache Spark ジョブのみ)、次のいずれかを行います。
- フォーカスされた [グラフ] ビューで、表の列アイコンをクリックします。
列アイコン - [リネージ エクスプローラ] パネルで、列名でフィルタして [適用] をクリックします。
詳細については、列レベルのリネージを使用するタイミングをご覧ください。
- フォーカスされた [グラフ] ビューで、表の列アイコンをクリックします。
[リセット] をクリックします。
この操作を行うと、適用されているすべてのフィルタが削除され、グラフビューの先頭に移動します。
[リスト] をクリックして、リスト表示に切り替えます。
リストビューには、テーブルレベルと列レベルの両方のリネージの簡略化された表形式の表現と詳細な表形式の表現が表示されます。これは、グラフビューと同期されます。デフォルトでは、簡略化されたリスト表示が表示されます。個々のソースとターゲットの関係を分析するために、詳細なリスト表示に切り替えることが可能です。表示する列を構成し、リネージデータをエクスポートできます。詳細については、リネージのリスト表示をご覧ください。
Java
import com.google.api.gax.rpc.ApiException;
import com.google.cloud.datacatalog.lineage.v1.BatchSearchLinkProcessesRequest;
import com.google.cloud.datacatalog.lineage.v1.EntityReference;
import com.google.cloud.datacatalog.lineage.v1.EventLink;
import com.google.cloud.datacatalog.lineage.v1.LineageClient;
import com.google.cloud.datacatalog.lineage.v1.LineageEvent;
import com.google.cloud.datacatalog.lineage.v1.Link;
import com.google.cloud.datacatalog.lineage.v1.ListLineageEventsRequest;
import com.google.cloud.datacatalog.lineage.v1.ListRunsRequest;
import com.google.cloud.datacatalog.lineage.v1.LocationName;
import com.google.cloud.datacatalog.lineage.v1.ProcessLinks;
import com.google.cloud.datacatalog.lineage.v1.Run;
import com.google.cloud.datacatalog.lineage.v1.SearchLinksRequest;
import java.io.IOException;
import java.util.ArrayList;
import java.util.HashSet;
import java.util.LinkedList;
import java.util.List;
import java.util.Queue;
import java.util.Set;

public class ViewLineageExample {

  public static void main(String[] args) throws IOException {
    // TODO(developer): Replace these variables before running the sample.
    String projectId = "my-project-id";
    String location = "us";
    String targetFullyQualifiedName = "bigquery:my-project-id.my_dataset.my_table";
    int maxDepth = 3;

    viewLineage(projectId, location, targetFullyQualifiedName, maxDepth);
  }

  static class Node {
    String fqn;
    int depth;
    Node(String fqn, int depth) {
      this.fqn = fqn;
      this.depth = depth;
    }
  }

  public static void viewLineage(
      String projectId, String location, String targetFullyQualifiedName, int maxDepth)
      throws IOException {
    // Initialize client that will be used to send requests. This client only needs
    // to be created once, and can be reused for multiple requests.
    try (LineageClient client = LineageClient.create()) {
      String parent = LocationName.of(projectId, location).toString();

      Set<String> visitedNodes = new HashSet<>();
      Queue<Node> queue = new LinkedList<>();

      visitedNodes.add(targetFullyQualifiedName);
      queue.offer(new Node(targetFullyQualifiedName, 0));

      while (!queue.isEmpty()) {
        Node current = queue.poll();
        System.out.printf("\nExploring node (Depth %d): %s\n", current.depth, current.fqn);

        if (current.depth >= maxDepth) {
          continue;
        }

        EntityReference targetEntity =
            EntityReference.newBuilder().setFullyQualifiedName(current.fqn).build();
        SearchLinksRequest searchLinksRequest =
            SearchLinksRequest.newBuilder().setParent(parent).setTarget(targetEntity).build();

        List<String> linkNames = new ArrayList<>();
        try {
          // 1. Search for links related to the target entity
          for (Link link : client.searchLinks(searchLinksRequest).iterateAll()) {
            linkNames.add(link.getName());
          }
        } catch (ApiException e) {
          System.out.printf("  Failed to retrieve links for %s: %s\n", current.fqn, e.getMessage());
          continue;
        }

        if (linkNames.isEmpty()) {
          continue;
        }

        // 2. Batch search for processes in chunks of 100
        for (int i = 0; i < linkNames.size(); i += 100) {
          List<String> batch = linkNames.subList(i, Math.min(linkNames.size(), i + 100));
          BatchSearchLinkProcessesRequest batchSearchRequest =
              BatchSearchLinkProcessesRequest.newBuilder()
                  .setParent(parent)
                  .addAllLinks(batch)
                  .build();

          try {
            for (ProcessLinks processLinks :
                client.batchSearchLinkProcesses(batchSearchRequest).iterateAll()) {
              String processName = processLinks.getProcess();
              System.out.printf("  Process: %s\n", processName);

              // 3. List runs for the process
              ListRunsRequest runsRequest =
                  ListRunsRequest.newBuilder().setParent(processName).build();
              for (Run run : client.listRuns(runsRequest).iterateAll()) {
                System.out.printf("    Run: %s\n", run.getName());

                // 4. List events for the run
                ListLineageEventsRequest eventsRequest =
                    ListLineageEventsRequest.newBuilder().setParent(run.getName()).build();
                for (LineageEvent event : client.listLineageEvents(eventsRequest).iterateAll()) {
                  for (EventLink eventLink : event.getLinksList()) {
                    String sourceFqn = eventLink.getSource().getFullyQualifiedName();
                    // If exploring upstream, queue the source
                    if (!sourceFqn.isEmpty() && !visitedNodes.contains(sourceFqn)) {
                      visitedNodes.add(sourceFqn);
                      queue.offer(new Node(sourceFqn, current.depth + 1));
                    }
                  }
                }
              }
            }
          } catch (ApiException e) {
            System.out.printf("  Failed to retrieve processes/runs: %s\n", e.getMessage());
          }
        }
      }
    }
  }
}
Python
from google.cloud import datacatalog_lineage_v1
from google.api_core.exceptions import GoogleAPICallError

def view_lineage(project_id: str, location: str, target_fully_qualified_name: str, max_depth: int = 3):
    """Retrieves lineage for a given entity using a depth-limited search."""
    client = datacatalog_lineage_v1.LineageClient()
    parent = f"projects/{project_id}/locations/{location}"

    # Store visited nodes to avoid infinite loops in cyclic graphs
    visited_nodes = set([target_fully_qualified_name])
    queue = [(target_fully_qualified_name, 0)]

    while queue:
        current_node, current_depth = queue.pop(0)
        print(f"\nExploring node (Depth {current_depth}): {current_node}")

        if current_depth >= max_depth:
            continue

        target_entity = datacatalog_lineage_v1.EntityReference(
            fully_qualified_name=current_node
        )
        search_links_request = datacatalog_lineage_v1.SearchLinksRequest(
            parent=parent,
            target=target_entity,
        )

        try:
            links = list(client.search_links(request=search_links_request))
        except GoogleAPICallError as e:
            print(f"  Failed to retrieve links for {current_node}: {e.message}")
            continue

        if not links:
            continue

        # Extract link names to query processes in batches
        link_names = [link.name for link in links]

        # Batch max size is 100
        for i in range(0, len(link_names), 100):
            batch = link_names[i:i + 100]
            batch_request = datacatalog_lineage_v1.BatchSearchLinkProcessesRequest(
                parent=parent,
                links=batch
            )

            try:
                for process_links in client.batch_search_link_processes(request=batch_request):
                    process_name = process_links.process
                    print(f"  Process: {process_name}")

                    runs_request = datacatalog_lineage_v1.ListRunsRequest(parent=process_name)
                    for run in client.list_runs(request=runs_request):
                        print(f"    Run: {run.name}")

                        events_request = datacatalog_lineage_v1.ListLineageEventsRequest(parent=run.name)
                        for event in client.list_lineage_events(request=events_request):
                            for event_link in event.links:
                                source_fqn = event_link.source.fully_qualified_name

                                # If exploring upstream, queue the source
                                if source_fqn and source_fqn not in visited_nodes:
                                    visited_nodes.add(source_fqn)
                                    queue.append((source_fqn, current_depth + 1))

            except GoogleAPICallError as e:
                 print(f"  Failed to retrieve processes/runs: {e.message}")
リネージの可視化を絞り込む
リネージの可視化を絞り込むには、リネージ エクスプローラのハイライト表示とフィルタ オプションを使用します。
特定のプロジェクト、データセット、エンティティ名を検索するには、[フィルタ] パネルを使用します。
フィルタを適用すると、フィルタ条件に一致するリネージノードが一致するノードと見なされます。一致するノードと一致しないノードの表示方法を調整できます。
リネージグラフで、[フィルタをクリア] ボタンの横にある [その他の操作] アイコンをクリックして、表示オプションを表示します。
次のいずれかまたは両方を選択します。
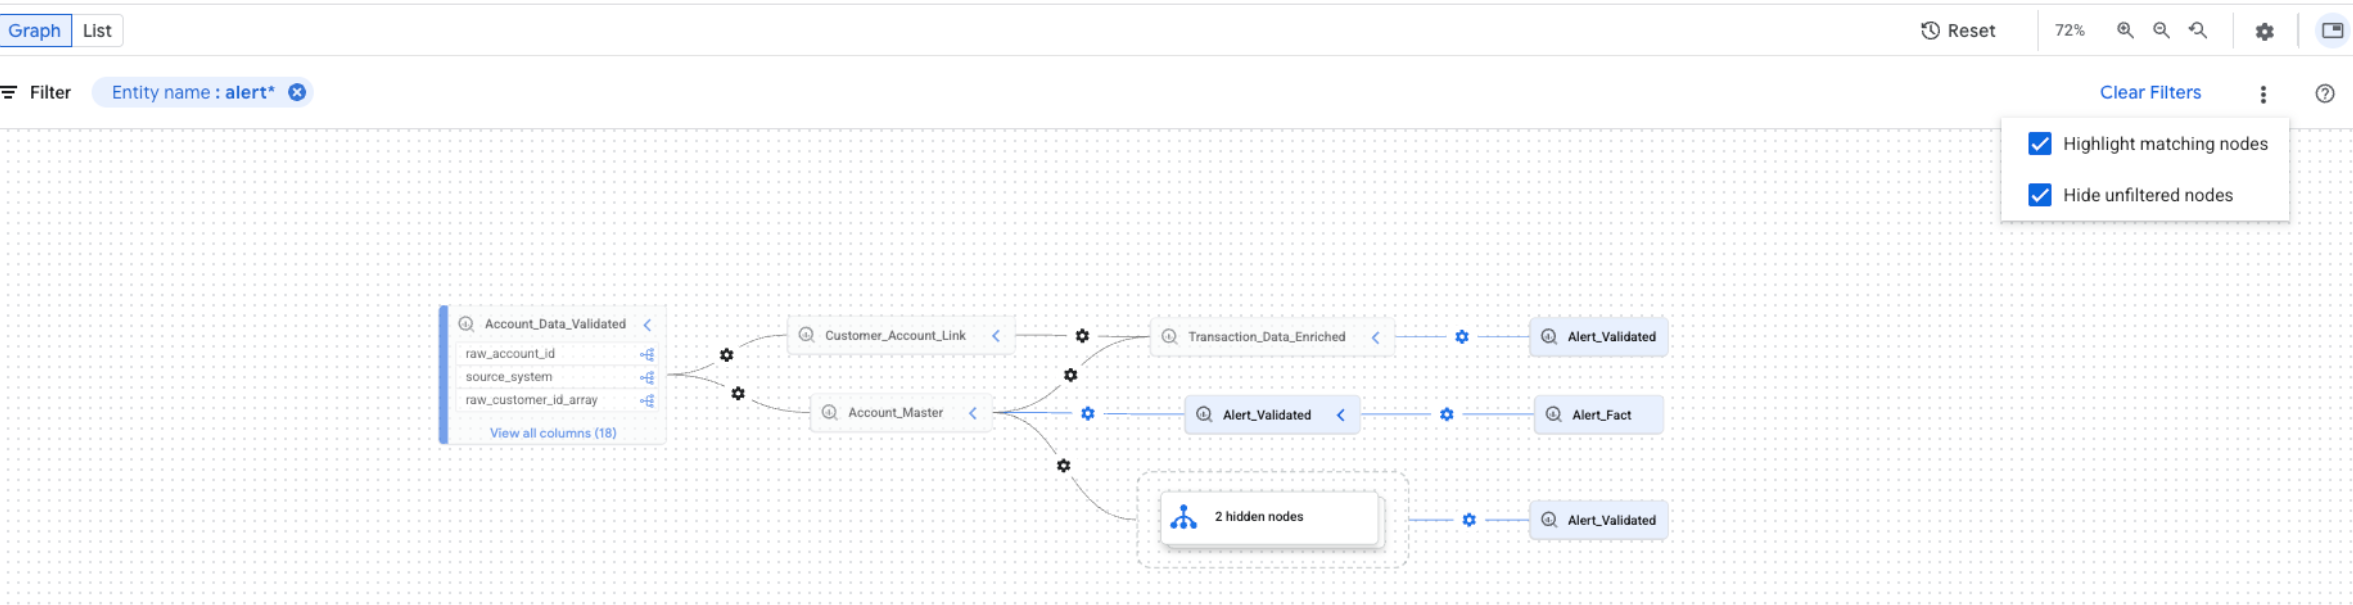
両方のオプションを同時に選択することもできます。両方のオプションを選択すると、フィルタされていないノードが非表示になり、一致するノードがフィルタされたグラフビューでハイライト表示されます。
データリネージをオフにする
新しいリネージ イベントのトラッキングを停止し、新しいデータリネージ プレミアム処理(DCU)の料金を停止するには、有効になっている各プロジェクトで Data Lineage API(datalineage.googleapis.com)を無効にします。
Dataplex API を無効にしても、データリネージは無効にならず、課金も停止されません。Data Lineage API を無効にする必要があります。API を無効にした後も、以前に取り込まれたリネージ メタデータに対して、保持期間が終了するかメタデータを削除するまで、最大 30 日間メタデータ ストレージ料金が発生します。
データリネージをオフにするには、次のいずれかのタブを選択し、リネージ トラッキングが有効になっているプロジェクトごとに手順を完了します。
コンソール
Google Cloud コンソールで、[有効な API とサービス] ページに移動します。
API のリストで、[Data Lineage API] をクリックします。
[API を無効にする] をクリックします。
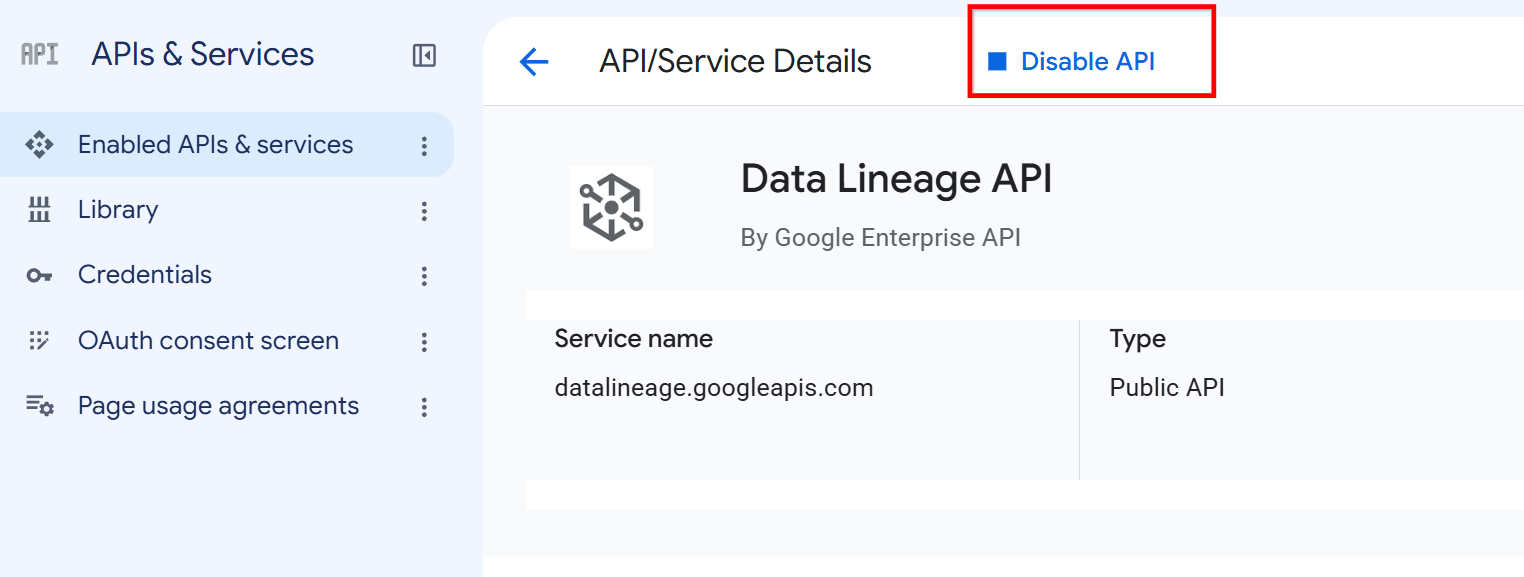
Data Lineage API の詳細ページにある [API を無効にする] ボタン。 プロンプトが表示されたら、[無効にする] をクリックします。
gcloud
Data Lineage API を無効にするには、gcloud services
disable コマンドを使用します。
gcloud services disable datalineage.googleapis.com --project=PROJECT_ID
次のように置き換えます。
PROJECT_ID: Google Cloudの ID
API を完全に無効にせずに特定のサービスのリネージ トラッキングを停止する場合は、サービスのデータリネージ取り込みを構成するをご覧ください。
次のステップ
- BigQuery テーブルのデータリネージを追跡する。
- データリネージ情報モデルについて学習する。
- データリネージに関する考慮事項と制限事項について学習する。
- Data Lineage API の監査ロギングについて学習する。
- データリネージの問題のトラブルシューティング。
- OpenLineage と統合する。
- Managed Service for Apache Spark でデータリネージを使用する。