


Sehen Sie sich die Datenherkunft an, um die Beziehungen zwischen den Ressourcen Ihres Projekts und den Prozessen, die sie erstellt haben, zu verstehen. Diese Beziehungen zeigen, wie Daten-Assets wie Tabellen und Datasets durch Prozesse wie Abfragen und Pipelines transformiert werden. In dieser Anleitung wird beschrieben, wie Sie Details zum Datenursprung in der Google Cloud Console aufrufen oder mit der Data Lineage API abrufen.
Rollen und Berechtigungen
Die Datenherkunft verfolgt Herkunftsinformationen automatisch, wenn Sie die Data Lineage API aktivieren. Sie benötigen keine Administrator- oder Bearbeiterrollen, um die Herkunft Ihrer Daten-Assets zu erfassen.
Zum Aufrufen des Datenursprungs benötigen Sie bestimmte IAM-Berechtigungen (Identity and Access Management). Abstammungsinformationen werden projektübergreifend erfasst. Daher benötigen Sie Berechtigungen für mehrere Projekte.
Wenn Sie die Data Lineage in Knowledge Catalog, BigQuery oder Vertex AI ansehen, benötigen Sie Berechtigungen zum Aufrufen von Data Lineage-Informationen in dem Projekt, in dem Sie sie ansehen.
Wenn Sie die Data Lineage ansehen, die in anderen Projekten aufgezeichnet wurde, benötigen Sie Berechtigungen zum Ansehen von Data-Lineage-Informationen in den Projekten, in denen sie aufgezeichnet wurde.
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Aufrufen der Datenherkunft benötigen:
- Data Lineage-Betrachter (
roles/datalineage.viewer) für das Projekt, in dem die Datenherkunft aufgezeichnet wird, und das Projekt, in dem die Datenherkunft angezeigt wird -
Details zur BigQuery-Tabelle ansehen:
BigQuery-Datenbetrachter (
roles/bigquery.dataViewer) für das Speicherprojekt der Tabelle -
BigQuery-Jobdetails ansehen:
BigQuery Resource Viewer (
roles/bigquery.resourceViewer) für das Compute-Projekt des Jobs -
Details zu anderen katalogisierten Assets ansehen:
Dataplex Catalog Viewer (
roles/dataplex.catalogViewer) für das Projekt, in dem Katalogeinträge gespeichert sind
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Aufrufen des Datenursprungs erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um den Datenursprung aufzurufen:
-
BigQuery-Tabellendetails ansehen:
bigquery.tables.get– das Speicherprojekt der Tabelle -
BigQuery-Jobdetails aufrufen:
bigquery.jobs.get– das Compute-Projekt des Jobs
Sie können diese Berechtigungen auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erhalten.
Arten von Ansichten zur Datenherkunft
Sie können Herkunftsinformationen in der Google Cloud Console als interaktives Diagramm oder als strukturierte Liste ansehen.
Eine detaillierte Beschreibung der Grafikelemente (z. B. Knoten, Kanten, Prozesssymbole und Labels) und der in den Listenansichten verfügbaren Spalten finden Sie unter Datenherkunft in Knowledge Catalog visualisieren.
Datenherkunft aktivieren
Aktivieren Sie die Lineage-Funktion, damit Lineage-Informationen für unterstützte Systeme automatisch erfasst werden. Wenn Sie die API aktivieren, wird die Datenherkunft standardmäßig für die meisten unterstützten Dienste aktiviert. Informationen zum Steuern der Aufnahme von Herkunftsdaten für Managed Service for Apache Spark finden Sie unter Aufnahme von Herkunftsdaten für einen Dienst steuern.
Die Data Lineage API wird unter der Knowledge Catalog Premium Processing-SKU abgerechnet. Weitere Informationen finden Sie unter Preise für den Knowledge Catalog.
Sie müssen die Data Lineage API sowohl in dem Projekt, in dem Sie die Datenherkunft ansehen, als auch in den Projekten, in denen die Datenherkunft aufgezeichnet wird, aktivieren. Weitere Informationen finden Sie unter Projekttypen.
- So erfassen Sie Informationen zur Herkunft:
-
Wählen Sie in der Google Cloud Console auf der Seite Projektauswahl das Projekt aus, in dem Sie die Herkunft aufzeichnen möchten.
Aktivieren Sie die Data Lineage API.
- Wiederholen Sie die vorherigen Schritte für jedes Projekt, in dem Sie den Datenursprung aufzeichnen möchten.
-
Aktivieren Sie im Projekt, in dem Sie die Data Lineage ansehen, die Data Lineage API und die Dataplex API.
Erfassung von Lineage-Daten für einen Dienst steuern
Sie können die automatische Lineage-Erfassung für bestimmte Dienste auf Projekt-, Ordner- oder Organisationsebene selektiv aktivieren oder deaktivieren.
Weitere Informationen dazu, wie diese Konfigurationen hierarchisch über den Ressourcenbaum angewendet werden, finden Sie unter Erfassung von Herkunftsinformationen steuern.
Lineage ansehen
Wenn Sie nachvollziehen möchten, wie Daten transformiert werden und sich zwischen Systemen bewegen, können Sie die Datenherkunft über die Google Cloud Console oder die API ansehen.
Console
Sie können über verschiedene Einstiegspunkte in der Google Cloud Console auf Informationen zum Datenursprung zugreifen:
- Knowledge Catalog:Rufen Sie die Seite Suchen im Knowledge Catalog auf, wählen Sie Knowledge Catalog als Suchmodus aus, suchen Sie nach dem Eintrag, den Sie aufrufen möchten, und klicken Sie dann darauf. Weitere Informationen finden Sie unter Ressourcen in Knowledge Catalog suchen.
- BigQuery:Rufen Sie die Seite BigQuery auf und öffnen Sie die Tabelle, für die Sie die Datenherkunft sehen möchten.
- Vertex AI: Rufen Sie die Seite Datasets oder Model Registry auf und klicken Sie auf das Dataset oder Modell, für das Sie die Datenherkunft sehen möchten.
So rufen Sie das Herkunftsdiagramm auf:
Klicken Sie auf den Tab Lineage.
Die Standardansicht Diagramm wird geöffnet. Sie zeigt die Lineage auf Tabellenebene über Systeme und Regionen hinweg. Weitere Informationen finden Sie unter Lineage-Diagrammansicht.
Wenn Sie den Lineage-Graphen manuell untersuchen möchten, klicken Sie neben einem Knoten auf Maximieren, um jeweils fünf weitere Knoten zu laden.
Weitere Informationen finden Sie unter Abstammungsdiagramm manuell untersuchen.
Klicken Sie in der Ansicht Diagramm auf einen Knoten.
Der Bereich Details wird geöffnet und enthält Informationen zum Asset, z. B. den vollständig qualifizierten Namen und den Typ. Weitere Informationen finden Sie unter Knotendetails.
Klicken Sie in der Ansicht Diagramm auf eine Kante mit einem Prozesssymbol.
Der Bereich Abfrage wird geöffnet. Weitere Informationen finden Sie unter Transformationslogik prüfen und Ausführung prüfen und Verlauf ansehen.
- Klicken Sie auf den Tab Details, um die Transformationslogik zu prüfen.
- Klicken Sie auf den Tab Ausführungen, um die Audit- und Ausführungsverläufe aufzurufen.
Wählen Sie im Bereich Lineage Explorer Filterkriterien aus, z. B. Richtung, Abhängigkeitstyp oder Zeitraum, und klicken Sie dann auf Anwenden.
Dadurch wird eine fokussierte Ansicht in einer bestimmten Region geöffnet (Vorschau). In dieser Ansicht wird das Diagramm automatisch auf bis zu drei Knotenebenen erweitert. Weitere Informationen finden Sie unter Filter anwenden, um eine fokussierte Lineage-Ansicht zu erhalten.
Wählen Sie in der fokussierten Graph-Ansicht einen Knoten aus und klicken Sie dann im Detailbereich des Knotens auf Pfad visualisieren, um den Lineage-Pfad vom ausgewählten Knoten zurück zum Stammknoten zu visualisieren (nur in der fokussierten Ansicht).
Weitere Informationen finden Sie unter Visualisierung des Lineage-Pfads.
Wenn Sie die Herkunft auf Spaltenebene aufrufen möchten (nur für BigQuery- und Managed Service for Apache Spark-Jobs), haben Sie folgende Möglichkeiten:
- Klicken Sie in einer fokussierten Diagramm-Ansicht in einer Tabelle auf das Spaltensymbol.
Spaltensymbol - Filtern Sie im Bereich Lineage Explorer nach Spaltenname und klicken Sie auf Übernehmen.
Weitere Informationen finden Sie unter Herkunft auf Spaltenebene.
- Klicken Sie in einer fokussierten Diagramm-Ansicht in einer Tabelle auf das Spaltensymbol.
Klicken Sie auf Zurücksetzen.
Durch diese Aktion werden alle angewendeten Filter entfernt und Sie gelangen zum Anfang der Grafikanzeige.
Klicken Sie auf Liste, um zur Listenansicht zu wechseln.
Die Listenansicht bietet vereinfachte und detaillierte tabellarische Darstellungen der Herkunft sowohl auf Tabellen- als auch auf Spaltenebene, die mit der Diagrammansicht synchronisiert werden. Standardmäßig wird die vereinfachte Listenansicht angezeigt. Sie können zur detaillierten Listenansicht wechseln, um einzelne Quell-Ziel-Beziehungen zu analysieren. Sie können konfigurieren, welche Spalten angezeigt werden, und Herkunftsdaten exportieren. Weitere Informationen finden Sie unter Listenansicht für Lineage.
Java
import com.google.api.gax.rpc.ApiException;
import com.google.cloud.datacatalog.lineage.v1.BatchSearchLinkProcessesRequest;
import com.google.cloud.datacatalog.lineage.v1.EntityReference;
import com.google.cloud.datacatalog.lineage.v1.EventLink;
import com.google.cloud.datacatalog.lineage.v1.LineageClient;
import com.google.cloud.datacatalog.lineage.v1.LineageEvent;
import com.google.cloud.datacatalog.lineage.v1.Link;
import com.google.cloud.datacatalog.lineage.v1.ListLineageEventsRequest;
import com.google.cloud.datacatalog.lineage.v1.ListRunsRequest;
import com.google.cloud.datacatalog.lineage.v1.LocationName;
import com.google.cloud.datacatalog.lineage.v1.ProcessLinks;
import com.google.cloud.datacatalog.lineage.v1.Run;
import com.google.cloud.datacatalog.lineage.v1.SearchLinksRequest;
import java.io.IOException;
import java.util.ArrayList;
import java.util.HashSet;
import java.util.LinkedList;
import java.util.List;
import java.util.Queue;
import java.util.Set;

public class ViewLineageExample {

  public static void main(String[] args) throws IOException {
    // TODO(developer): Replace these variables before running the sample.
    String projectId = "my-project-id";
    String location = "us";
    String targetFullyQualifiedName = "bigquery:my-project-id.my_dataset.my_table";
    int maxDepth = 3;

    viewLineage(projectId, location, targetFullyQualifiedName, maxDepth);
  }

  static class Node {
    String fqn;
    int depth;
    Node(String fqn, int depth) {
      this.fqn = fqn;
      this.depth = depth;
    }
  }

  public static void viewLineage(
      String projectId, String location, String targetFullyQualifiedName, int maxDepth)
      throws IOException {
    // Initialize client that will be used to send requests. This client only needs
    // to be created once, and can be reused for multiple requests.
    try (LineageClient client = LineageClient.create()) {
      String parent = LocationName.of(projectId, location).toString();

      Set<String> visitedNodes = new HashSet<>();
      Queue<Node> queue = new LinkedList<>();

      visitedNodes.add(targetFullyQualifiedName);
      queue.offer(new Node(targetFullyQualifiedName, 0));

      while (!queue.isEmpty()) {
        Node current = queue.poll();
        System.out.printf("\nExploring node (Depth %d): %s\n", current.depth, current.fqn);

        if (current.depth >= maxDepth) {
          continue;
        }

        EntityReference targetEntity =
            EntityReference.newBuilder().setFullyQualifiedName(current.fqn).build();
        SearchLinksRequest searchLinksRequest =
            SearchLinksRequest.newBuilder().setParent(parent).setTarget(targetEntity).build();

        List<String> linkNames = new ArrayList<>();
        try {
          // 1. Search for links related to the target entity
          for (Link link : client.searchLinks(searchLinksRequest).iterateAll()) {
            linkNames.add(link.getName());
          }
        } catch (ApiException e) {
          System.out.printf("  Failed to retrieve links for %s: %s\n", current.fqn, e.getMessage());
          continue;
        }

        if (linkNames.isEmpty()) {
          continue;
        }

        // 2. Batch search for processes in chunks of 100
        for (int i = 0; i < linkNames.size(); i += 100) {
          List<String> batch = linkNames.subList(i, Math.min(linkNames.size(), i + 100));
          BatchSearchLinkProcessesRequest batchSearchRequest =
              BatchSearchLinkProcessesRequest.newBuilder()
                  .setParent(parent)
                  .addAllLinks(batch)
                  .build();

          try {
            for (ProcessLinks processLinks :
                client.batchSearchLinkProcesses(batchSearchRequest).iterateAll()) {
              String processName = processLinks.getProcess();
              System.out.printf("  Process: %s\n", processName);

              // 3. List runs for the process
              ListRunsRequest runsRequest =
                  ListRunsRequest.newBuilder().setParent(processName).build();
              for (Run run : client.listRuns(runsRequest).iterateAll()) {
                System.out.printf("    Run: %s\n", run.getName());

                // 4. List events for the run
                ListLineageEventsRequest eventsRequest =
                    ListLineageEventsRequest.newBuilder().setParent(run.getName()).build();
                for (LineageEvent event : client.listLineageEvents(eventsRequest).iterateAll()) {
                  for (EventLink eventLink : event.getLinksList()) {
                    String sourceFqn = eventLink.getSource().getFullyQualifiedName();
                    // If exploring upstream, queue the source
                    if (!sourceFqn.isEmpty() && !visitedNodes.contains(sourceFqn)) {
                      visitedNodes.add(sourceFqn);
                      queue.offer(new Node(sourceFqn, current.depth + 1));
                    }
                  }
                }
              }
            }
          } catch (ApiException e) {
            System.out.printf("  Failed to retrieve processes/runs: %s\n", e.getMessage());
          }
        }
      }
    }
  }
}
Python
from google.cloud import datacatalog_lineage_v1
from google.api_core.exceptions import GoogleAPICallError

def view_lineage(project_id: str, location: str, target_fully_qualified_name: str, max_depth: int = 3):
    """Retrieves lineage for a given entity using a depth-limited search."""
    client = datacatalog_lineage_v1.LineageClient()
    parent = f"projects/{project_id}/locations/{location}"

    # Store visited nodes to avoid infinite loops in cyclic graphs
    visited_nodes = set([target_fully_qualified_name])
    queue = [(target_fully_qualified_name, 0)]

    while queue:
        current_node, current_depth = queue.pop(0)
        print(f"\nExploring node (Depth {current_depth}): {current_node}")

        if current_depth >= max_depth:
            continue

        target_entity = datacatalog_lineage_v1.EntityReference(
            fully_qualified_name=current_node
        )
        search_links_request = datacatalog_lineage_v1.SearchLinksRequest(
            parent=parent,
            target=target_entity,
        )

        try:
            links = list(client.search_links(request=search_links_request))
        except GoogleAPICallError as e:
            print(f"  Failed to retrieve links for {current_node}: {e.message}")
            continue

        if not links:
            continue

        # Extract link names to query processes in batches
        link_names = [link.name for link in links]

        # Batch max size is 100
        for i in range(0, len(link_names), 100):
            batch = link_names[i:i + 100]
            batch_request = datacatalog_lineage_v1.BatchSearchLinkProcessesRequest(
                parent=parent,
                links=batch
            )

            try:
                for process_links in client.batch_search_link_processes(request=batch_request):
                    process_name = process_links.process
                    print(f"  Process: {process_name}")

                    runs_request = datacatalog_lineage_v1.ListRunsRequest(parent=process_name)
                    for run in client.list_runs(request=runs_request):
                        print(f"    Run: {run.name}")

                        events_request = datacatalog_lineage_v1.ListLineageEventsRequest(parent=run.name)
                        for event in client.list_lineage_events(request=events_request):
                            for event_link in event.links:
                                source_fqn = event_link.source.fully_qualified_name

                                # If exploring upstream, queue the source
                                if source_fqn and source_fqn not in visited_nodes:
                                    visited_nodes.add(source_fqn)
                                    queue.append((source_fqn, current_depth + 1))

            except GoogleAPICallError as e:
                 print(f"  Failed to retrieve processes/runs: {e.message}")
Visualisierung der Herkunft optimieren
Um die Lineage-Visualisierung zu optimieren, können Sie im Lineage Explorer Optionen zum Hervorheben und Filtern verwenden:
Wenn Sie nach bestimmten Projekten, Datasets oder Entitätsnamen suchen möchten, verwenden Sie den Bereich Filter.
Nachdem Sie Filter angewendet haben, werden Abstammungsknoten, die Ihren Filterkriterien entsprechen, als übereinstimmende Knoten betrachtet. Sie können die Darstellung von übereinstimmenden und nicht übereinstimmenden Knoten anpassen.
Klicken Sie im Lineage-Diagramm neben dem Button Filter löschen auf das Symbol Weitere Aktionen , um Anzeigeoptionen aufzurufen.
Wählen Sie eine oder beide der folgenden Optionen aus:
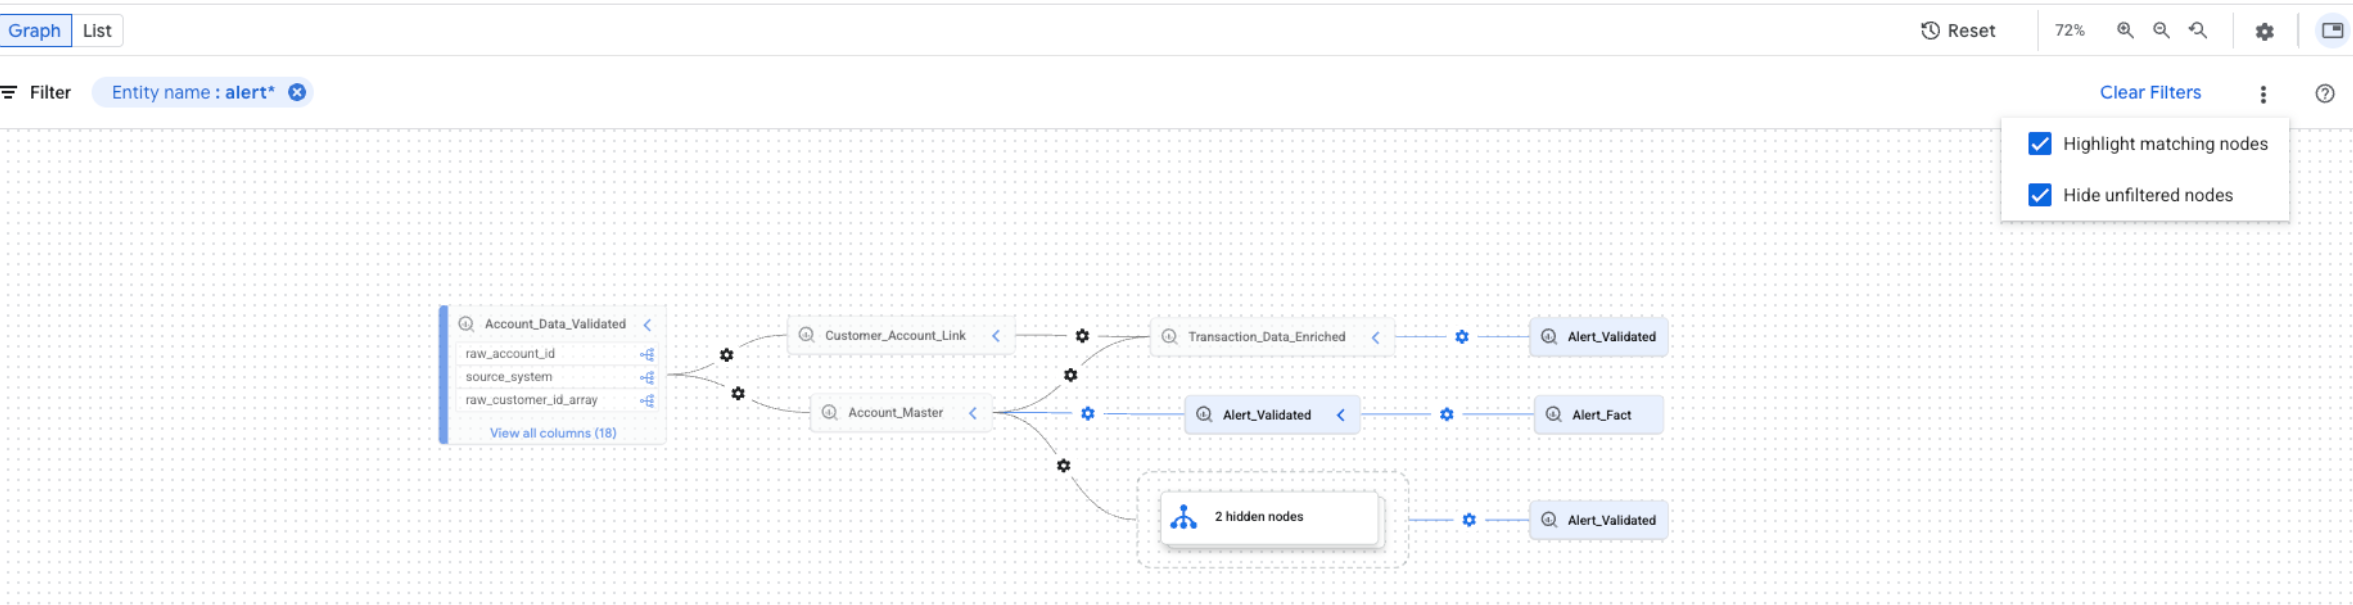
Sie können beide Optionen gleichzeitig auswählen. Wenn beide Optionen ausgewählt sind, werden ungefilterte Knoten ausgeblendet und übereinstimmende Knoten in der gefilterten Diagrammansicht hervorgehoben.
Datenherkunft deaktivieren
Wenn Sie die Herkunft nicht mehr erfassen und Gebühren für die Data Lineage API vermeiden möchten, deaktivieren Sie die Data Lineage API (datalineage.googleapis.com) in jedem Projekt, in dem sie aktiviert ist.
Wenn Sie die Dataplex API deaktivieren, wird Data Lineage nicht deaktiviert und die Abrechnung dafür wird nicht beendet. Sie müssen die Data Lineage API deaktivieren.
Wenn Sie die Datenherkunft deaktivieren möchten, wählen Sie einen der folgenden Tabs aus und führen Sie die Schritte für jedes Projekt aus, in dem die Herkunftserfassung aktiviert wurde:
Console
Rufen Sie in der Google Cloud Console die Seite Aktivierte APIs und Dienste auf.
Klicken Sie in der Liste der APIs auf Data Lineage API.
Klicken Sie auf API deaktivieren.
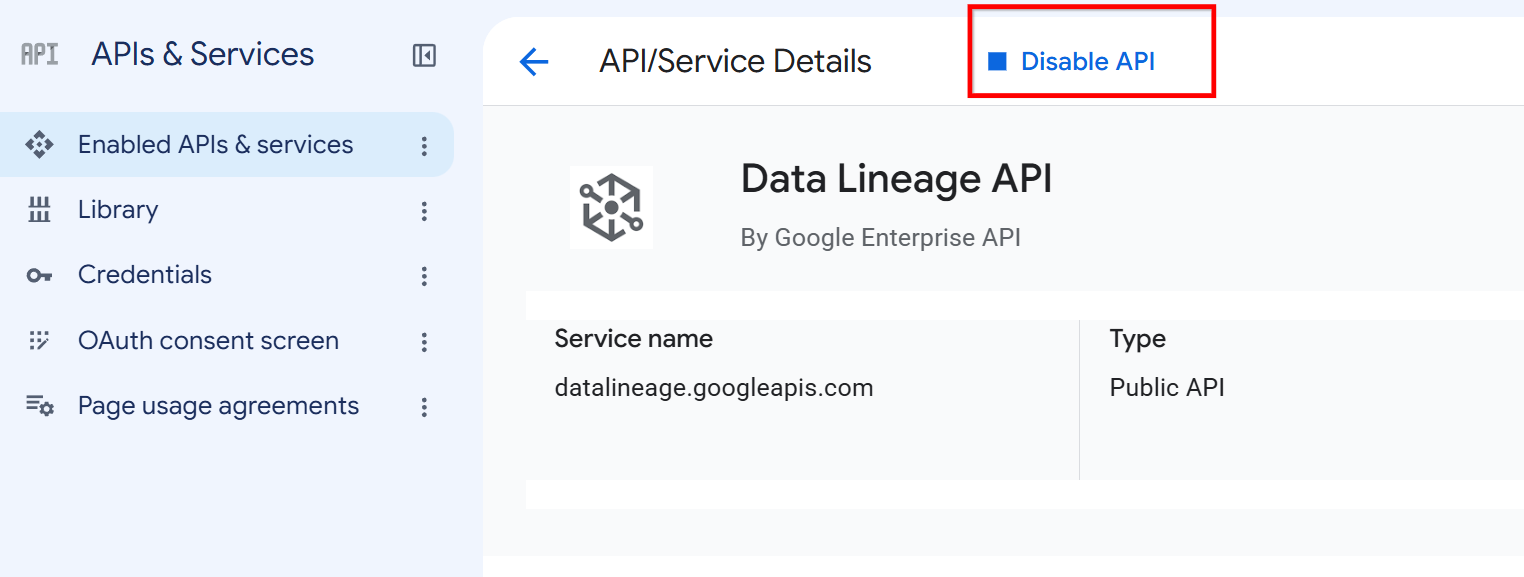
Schaltfläche „API deaktivieren“ auf der Detailseite der Data Lineage API. Klicken Sie bei Aufforderung auf Deaktivieren.
gcloud
Verwenden Sie den Befehl gcloud services disable, um die Data Lineage API zu deaktivieren:
gcloud services disable datalineage.googleapis.com --project=PROJECT_ID
Ersetzen Sie Folgendes:
PROJECT_ID: die ID Ihres Google Cloud -Projekts
Wenn Sie das Lineage-Tracking für bestimmte Dienste beenden möchten, ohne die API vollständig zu deaktivieren, lesen Sie den Abschnitt Lineage-Aufnahme für einen Dienst steuern.
Nächste Schritte
- Datenherkunft für Kopier- und Abfragejobs einer BigQuery-Tabelle nachverfolgen
- Weitere Informationen zum Datenherkunfts-Informationsmodell
- Überlegungen und Einschränkungen zur Datenherkunft
- Audit-Logging für die Datenherkunft
- Informationen zur Fehlerbehebung bei der Datenherkunft
- Informationen zur Einbindung in OpenLineage
- Datenherkunft mit Managed Service for Apache Spark verwenden