


Confidential Computing te permite colaborar con datos sensibles, entrenar modelos de IA y ejecutar cargas de trabajo de aprendizaje federado mientras mantienes los datos encriptados en la memoria. En este documento, se describen casos de uso de la industria y arquitecturas de referencia para el análisis confidencial, la IA y el aprendizaje federado en Google Cloud.
Casos de uso
En las siguientes secciones, se proporcionan ejemplos de casos de uso de Confidential Computing para varias industrias.
Salud y ciencias biológicas
Confidential Computing permite el uso compartido y el análisis de datos seguros en todas las organizaciones, a la vez que ayuda a preservar la privacidad de los pacientes. Confidential Computing permite que las organizaciones de atención médica participen en investigaciones colaborativas, modelado de enfermedades, descubrimiento de medicamentos y planes de tratamiento personalizados.
En la siguiente tabla, se describen algunos ejemplos de uso de Confidential Computing en el cuidado de la salud.
| Caso de uso | Descripción |
|---|---|
| Predicción y detección temprana de enfermedades | Los hospitales entrenan un modelo de aprendizaje federado para detectar lesiones cancerosas a partir de datos de imágenes médicas (por ejemplo, imágenes por resonancia magnética o tomografías computarizadas en varios hospitales o regiones hospitalarias) y, al mismo tiempo, mantener la confidencialidad de los pacientes. |
| Supervisión de pacientes en tiempo real | Los proveedores de atención médica analizan los datos de los dispositivos de salud wearable y las apps de salud para dispositivos móviles para realizar un monitoreo y recibir alertas en tiempo real. Por ejemplo, los dispositivos wearable recopilan datos sobre los niveles de glucosa, la actividad física y los hábitos alimentarios para proporcionar recomendaciones personalizadas y advertencias tempranas sobre las fluctuaciones de azúcar en sangre. |
| Descubrimiento de fármacos y ensayos clínicos colaborativos | Las empresas farmacéuticas y los hospitales de investigación reúnen datos de ensayos clínicos, secuencias genómicas y estructuras moleculares para descubrir terapias y modelar interacciones de medicamentos. |
| Documentación clínica y transcripción médica autónomas | Los asistentes de IA capturan las conversaciones entre el profesional clínico y el paciente para redactar resúmenes clínicos, actualizar los registros de salud electrónicos (HCE) y sugerir códigos de facturación. |
| Evaluación y comparativas de IA médica multiinstitucional | Las instituciones de atención médica y los consorcios de investigación validan modelos de diagnóstico de propiedad exclusiva en diversas poblaciones de pacientes globales sin mover ni exponer datos clínicos sin procesar. |
Servicios financieros
Confidential Computing permite que las instituciones financieras creen un sistema financiero más seguro y resistente.
En la siguiente tabla, se describen algunos ejemplos de usos de Confidential Computing en los servicios financieros.
| Caso de uso | Descripción |
|---|---|
| Detección de fraudes y prevención del lavado de dinero (AML) | Varias instituciones financieras comparten flujos de transacciones sensibles y, también, indicadores de fraude para entrenar modelos de aprendizaje automático o implementar agentes analíticos. Con estos datos recopilados, las instituciones pueden detectar sindicatos de lavado de dinero transfronterizo y fraude en los pagos sin revelar los números de cuenta de los clientes ni los registros de transacciones propios a los competidores. |
| Evaluación de riesgos y suscripción del crédito | Los prestamistas evalúan las solicitudes de crédito comercial o minorista analizando datos financieros sensibles y no tradicionales (como los pagos de servicios públicos en tiempo real) sin exponer esos datos a terceros. Ejecutar agentes de suscripción automatizados en un entorno de ejecución confiable (TEE) ayuda a aislar los registros contables de un solicitante y los algoritmos de puntuación de riesgo de propiedad del banco durante la evaluación. |
| Análisis financiero automatizado e informes reglamentarios | Los agentes de IA autónomos buscan en los libros de contabilidad corporativos internos, las carteras de inversión y la información no pública material (MNPI) para preparar memorandos de diligencia debida, informes de auditoría y presentaciones regulatorias. |
Sector público
Confidential Computing permite que los gobiernos creen servicios más transparentes, eficientes y eficaces, a la vez que conservan el control y la soberanía de sus datos.
En la siguiente tabla, se describen algunos ejemplos de uso de Confidential Computing en el sector público.
| Caso de uso | Descripción |
|---|---|
| Análisis confidenciales de varias agencias | Confidential Computing permite el análisis de datos de varias partes en varios organismos gubernamentales (por ejemplo, salud, impuestos y educación) o en varios gobiernos de diferentes regiones o países. Confidential Computing ayuda a garantizar que se protejan los límites de confianza y la privacidad de los datos, a la vez que habilita el análisis de datos (con la prevención de pérdida de datos (DLP), el análisis a gran escala y los motores de políticas) y el entrenamiento y la entrega de IA. |
| Análisis de investigación y uso compartido de inteligencia entre agencias | Los organismos gubernamentales independientes (como las agencias fiscales, de aplicación de la ley y de aduanas) usan Confidential Space para realizar análisis de datos conjuntos. Las agencias pueden comparar datos mediante referencia cruzada de declaraciones de impuestos, manifiestos de viaje y registros contables para identificar fraudes o amenazas a la seguridad nacional sin compartir bases de datos clasificadas sin procesar entre límites jurisdiccionales. |
| Identidad digital y verificación de credenciales de ciudadanos | Los organismos públicos y las plataformas de identidad verifican los pasaportes biométricos oficiales y los documentos de identidad nacionales sin almacenar ni exponer los datos personales de los ciudadanos. Los ciudadanos pueden demostrar de forma criptográfica atributos específicos (como la nacionalidad, la residencia o la elegibilidad por edad), mientras que los datos sin procesar del pasaporte y las firmas biométricas permanecen encriptados en la memoria y se borran después de que se genera la prueba. |
Cadena de suministro
Confidential Computing permite que las organizaciones que administran cadenas de suministro y programas de sustentabilidad colaboren y compartan estadísticas, a la vez que ayudan a mantener la privacidad de los datos.
En la siguiente tabla, se describen algunos ejemplos de uso de Confidential Computing en las cadenas de suministro.
| Caso de uso | Descripción |
|---|---|
| Organización autónoma de logística y envíos de varias partes | Las organizaciones implementan agentes de IA autónomos para negociar tarifas de envío, coordinar entregas de contenedores y redirigir la carga con empresas de transporte externas durante las interrupciones del tránsito. Ejecutar estos agentes de logística dentro de una instancia de Confidential VM ayuda a proteger los manifiestos de envío activos, los acuerdos de precios de los transportistas y las credenciales de la API de los transportistas para que no se expongan en la memoria a otros usuarios de la nube. |
| Detección de anomalías en la cadena de suministro y optimización de rutas en tiempo real | Los agentes de IA procesan la telemetría en tiempo real (como los registros de tránsito de GPS, los sensores de las puertas de los almacenes y las alertas meteorológicas) para optimizar las rutas de envío. El procesamiento de esta telemetría operativa sensible dentro de Confidential Space permite que los fabricantes y distribuidores ejecuten algoritmos automatizados de cambio de ruta sin exponer las capacidades de fábrica patentadas ni las vulnerabilidades de cuello de botella a terceros. |
| Cumplimiento aduanero y documentación comercial automatizados | Los agentes de IA procesan facturas comerciales, conocimientos de embarque y declaraciones de aduana de alto valor para automatizar el cumplimiento fronterizo. Aislar estos agentes de análisis de documentos dentro de un TEE ayuda a proteger los secretos comerciales sensibles mientras se extraen y verifican con las bases de datos de aduanas. |
Publicidad digital
En lugar de usar cookies de terceros, la publicidad digital utiliza cada vez más alternativas que mejoran la privacidad y usan TEE para ayudar a las empresas de publicidad a procesar sus datos en un entorno seguro. Por ejemplo, Google Ads usa Confidential Computing para ayudar a proteger los datos propios cuando se ejecutan campañas.
Puedes usar los TEEs en los siguientes casos de uso de publicidad digital:
- Algoritmos de coincidencia: Encuentran correspondencias o relaciones dentro de los conjuntos de datos.
- Atribución: Vincular los efectos o eventos con sus causas probables.
- Agregación: Se calculan resúmenes o estadísticas a partir de los datos sin procesar.
Arquitecturas de referencia
Puedes implementar Confidential Computing en Google Cloud para abordar los siguientes casos de uso:
- Análisis confidenciales
- Confidential AI
- Aprendizaje federado confidencial
En las siguientes secciones, se proporciona más información sobre la arquitectura de estos casos de uso, incluidos ejemplos para empresas financieras y de atención médica.
Arquitectura de Confidential Analytics para instituciones de atención médica
La arquitectura de Confidential Analytics demuestra cómo varias instituciones de atención médica (como proveedores de atención médica, empresas biofarmacéuticas e instituciones de investigación) pueden trabajar juntas para acelerar la investigación de medicamentos. En esta arquitectura, se usan técnicas de Confidential Computing para crear una sala limpia digital en la que se ejecutan análisis colaborativos confidenciales.
Esta arquitectura tiene los siguientes beneficios:
- Estadísticas mejoradas: El análisis colaborativo permite que las organizaciones de salud obtengan estadísticas más amplias y disminuyan el tiempo de salida al mercado para mejorar el descubrimiento de medicamentos.
- Privacidad de los datos: Los datos sensibles de los pacientes y los ensayos clínicos permanecen encriptados en tránsito, en reposo y en la memoria, y no se exponen en texto sin formato a otros participantes ni al proveedor de servicios en la nube.
- Cumplimiento de reglamentaciones: La arquitectura ayuda a las instituciones de salud a cumplir con las reglamentaciones de protección de datos, ya que mantiene un control estricto sobre sus datos.
- Confianza y colaboración: La arquitectura permite la colaboración segura entre instituciones competidoras, lo que fomenta un esfuerzo colectivo para descubrir medicamentos.
En el siguiente diagrama, se muestra esta arquitectura.
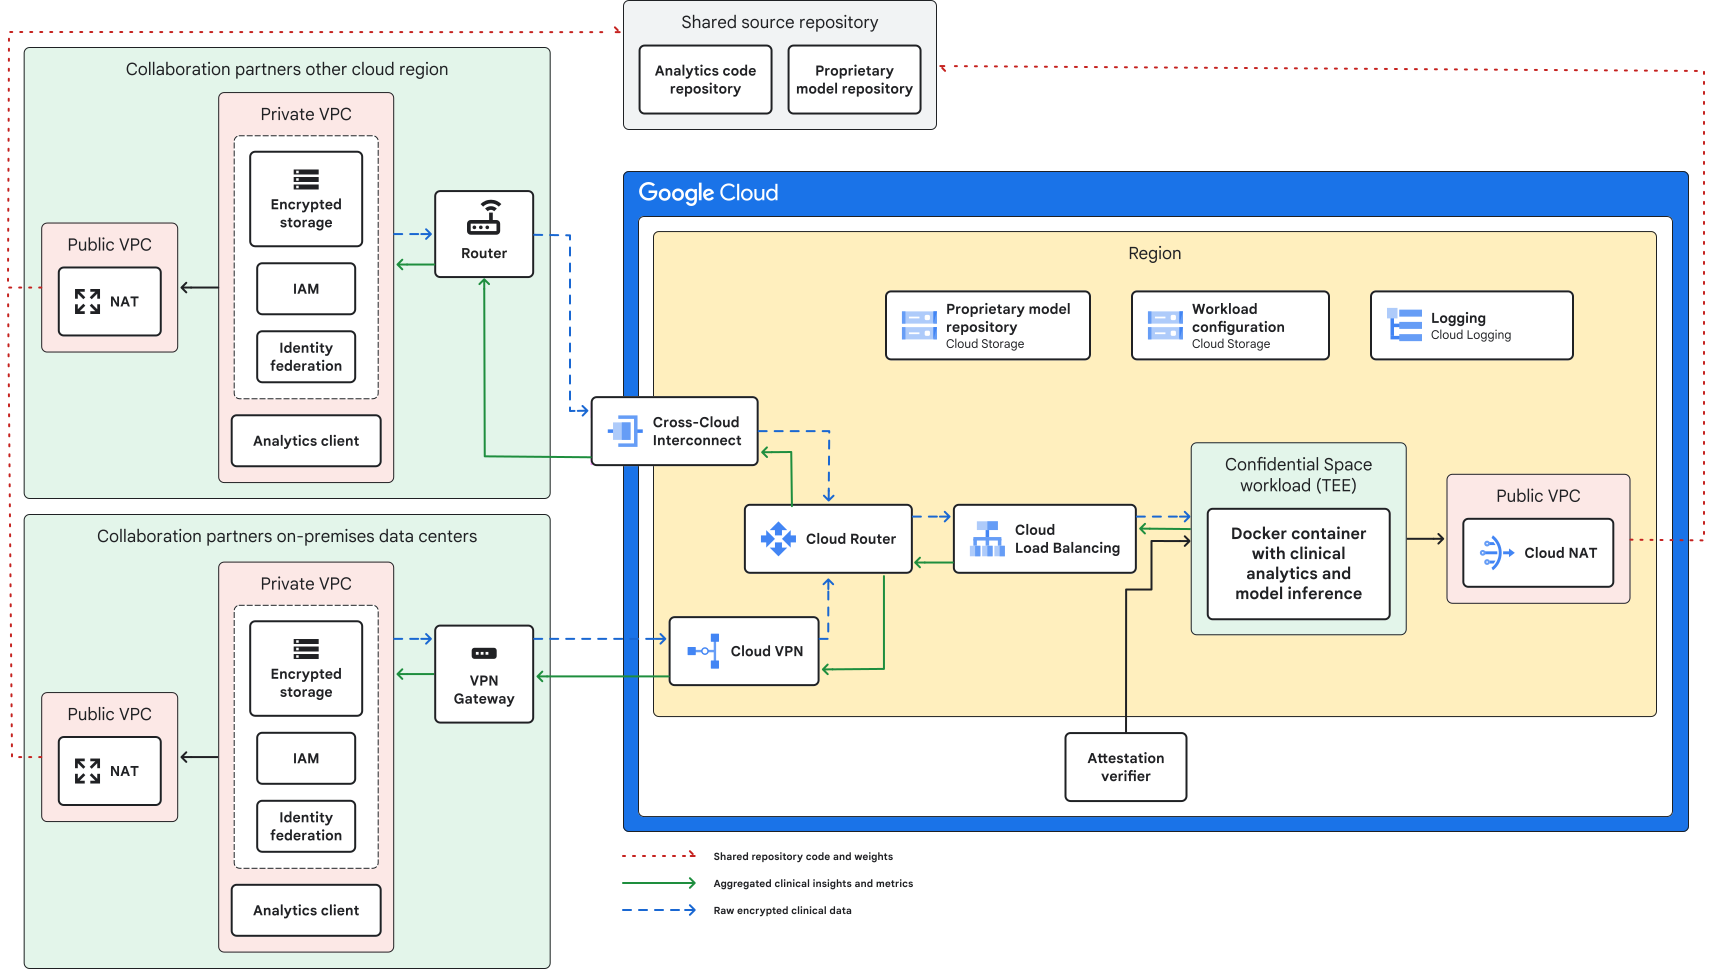
Los componentes clave de esta arquitectura incluyen los siguientes:
- Carga de trabajo de Confidential Space (TEE): Es un entorno seguro y aislado en el que los datos y el código dentro del TEE están protegidos contra el acceso no autorizado, incluso desde el sistema operativo o el proveedor de servicios en la nube subyacentes.
- Socios de colaboración: Cada institución de salud participante tiene un entorno local que actúa como intermediario entre los datos privados de la institución y el TEE.
- Datos encriptados específicos del proveedor: Cada institución de atención médica almacena sus propios datos privados y encriptados de los pacientes, que incluyen registros de salud electrónicos. Cada proveedor divulga sus datos (y el acceso a las claves de desencriptación) al TEE solo después de validar las declaraciones de certificación de la carga de trabajo del TEE. Los datos se desencriptan solo dentro del TEE certificado durante el procesamiento y permanecen encriptados en la memoria.
- Cliente de estadísticas: Las instituciones de salud participantes pueden ejecutar consultas confidenciales en sus datos para obtener estadísticas.
Arquitectura de Confidential AI para instituciones financieras
En este patrón de arquitectura, se muestra cómo las instituciones financieras pueden entrenar de forma colaborativa un modelo de detección de fraudes mientras usan etiquetas de fraude para preservar la confidencialidad de sus datos de transacciones sensibles. La arquitectura usa técnicas de Confidential Computing para habilitar el aprendizaje automático seguro de varias partes.
Esta arquitectura tiene los siguientes beneficios:
- Detección de fraudes mejorada: El entrenamiento colaborativo usa un conjunto de datos más grande y diverso, lo que genera un modelo de detección de fraudes más preciso y eficaz.
- Privacidad de los datos: Los datos sensibles de las transacciones permanecen encriptados en tránsito, en reposo y en la memoria, y no se exponen en texto sin formato a otros participantes ni al proveedor de servicios en la nube.
- Cumplimiento de reglamentaciones: La arquitectura ayuda a las instituciones financieras a cumplir con las reglamentaciones de protección de datos, ya que mantiene un control estricto sobre sus datos.
- Confianza y colaboración: Esta arquitectura permite la colaboración segura entre instituciones competidoras, lo que fomenta un esfuerzo colectivo para combatir el fraude financiero.
En el siguiente diagrama, se muestra esta arquitectura.
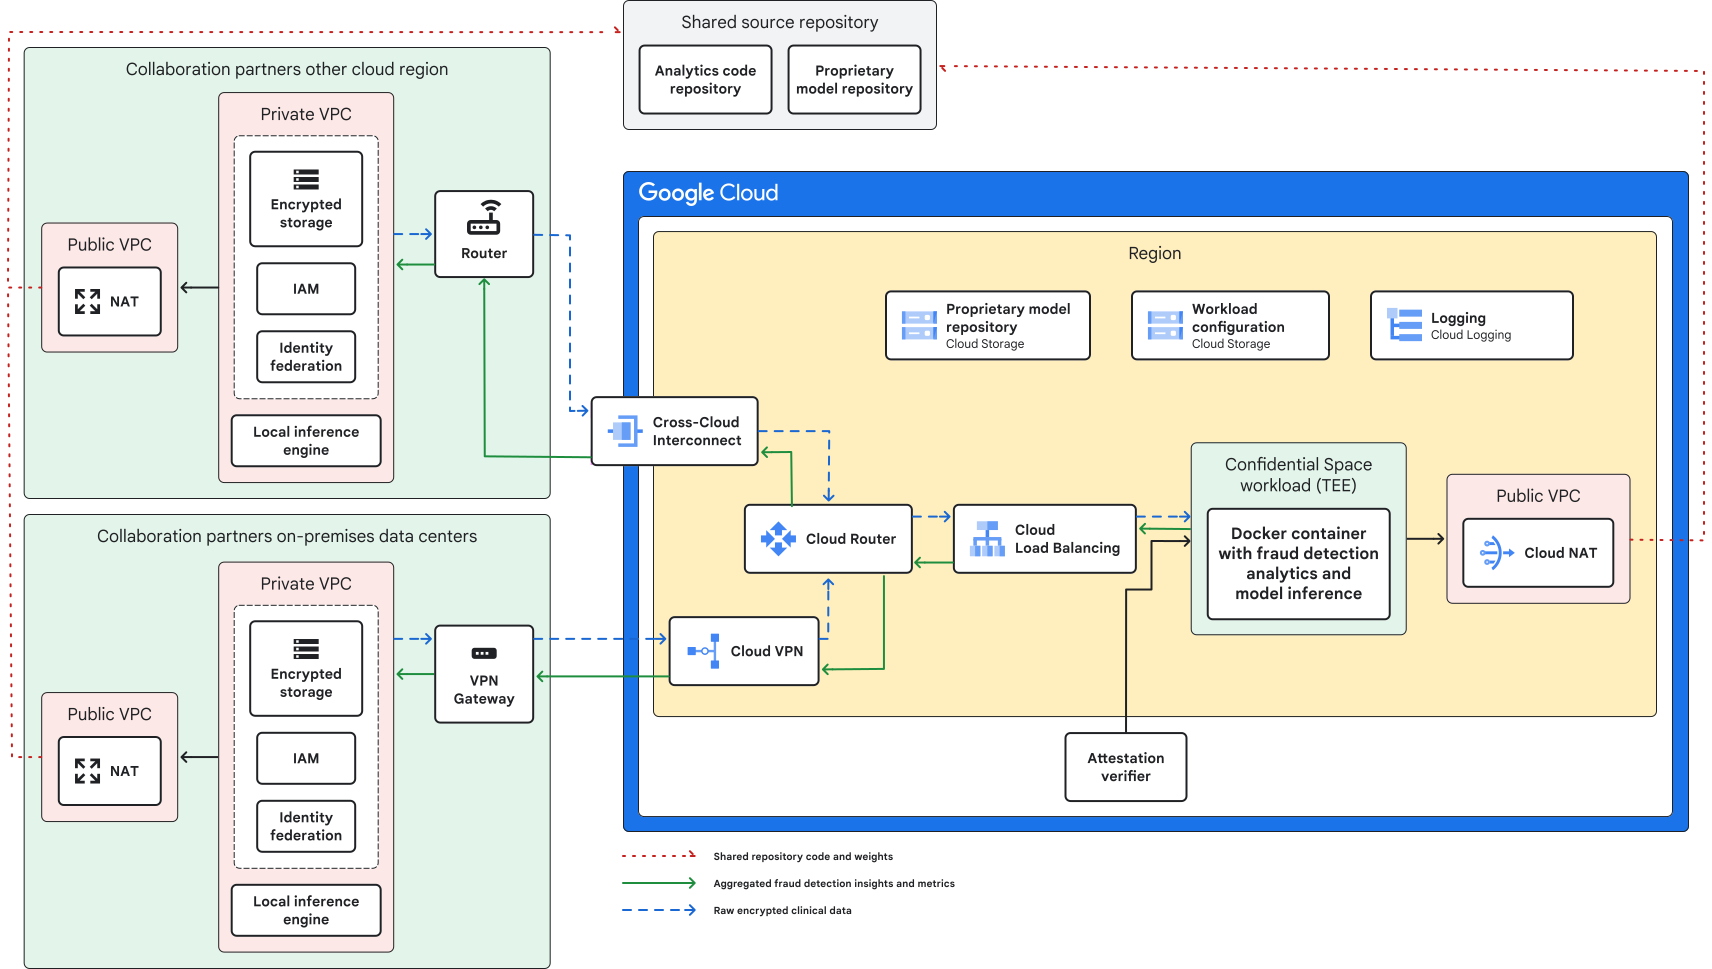
Entre los componentes clave de esta arquitectura, se incluyen los siguientes:
- Carga de trabajo de Confidential Space (TEE): Es un entorno seguro y aislado en el que los datos y el código dentro del TEE están protegidos contra el acceso no autorizado, incluso desde el sistema operativo o el proveedor de servicios en la nube subyacentes.
- Socios de colaboración: Cada institución financiera participante tiene un entorno local que actúa como intermediario entre los datos privados de la institución y el TEE.
- Datos encriptados específicos del banco: Cada banco tiene sus propios datos de transacciones privados y encriptados que incluyen etiquetas de fraude. Cada banco divulga sus datos (y el acceso a las claves de desencriptación) al TEE solo después de validar las reclamaciones de certificación de la carga de trabajo del TEE. Los datos se desencriptan solo dentro del TEE certificado durante el procesamiento y permanecen encriptados en la memoria.
- Repositorio de modelos de propiedad: Es un modelo de detección de fraudes entrenado previamente que sirve como punto de partida para el entrenamiento colaborativo.
- Modelo y pesos globales entrenados para detectar fraudes (se muestran con las flechas verdes salientes del TEE a cada banco): El modelo mejorado de detección de fraudes, junto con sus pesos aprendidos, se intercambia de forma segura con los bancos participantes. Luego, pueden implementar este modelo mejorado de forma local para detectar fraudes en sus propias transacciones.
Arquitectura de aprendizaje federado confidencial para instituciones financieras
El aprendizaje federado ofrece una solución avanzada para los clientes que valoran la privacidad y la soberanía de los datos estrictas. La arquitectura de aprendizaje federado confidencial proporciona una forma segura, escalable y eficiente de usar datos para aplicaciones de IA. Esta arquitectura lleva los modelos a la ubicación en la que se almacenan los datos, en lugar de centralizarlos en una sola ubicación, lo que reduce los riesgos asociados con la filtración de datos.
Este patrón de arquitectura demuestra cómo varias instituciones financieras pueden entrenar de forma colaborativa un modelo de detección de fraudes y, al mismo tiempo, preservar la confidencialidad de sus datos de transacciones sensibles con etiquetas de fraude. Usa el aprendizaje federado junto con técnicas de Confidential Computing para habilitar el aprendizaje automático seguro de varias partes sin mover los datos de entrenamiento.
Esta arquitectura tiene los siguientes beneficios:
- Privacidad y seguridad de los datos mejoradas: El aprendizaje federado permite la privacidad y la localidad de los datos, ya que mantiene los datos sensibles en cada sitio. Además, las instituciones financieras pueden usar técnicas que preserven la privacidad, como la encriptación homomórfica y los filtros de privacidad diferencial, para proteger aún más los datos transferidos (como los pesos del modelo).
- Precisión y diversidad mejoradas: Con el entrenamiento con una variedad de fuentes de datos en diferentes clientes, las instituciones financieras pueden desarrollar un modelo global sólido y generalizable para representar mejor los conjuntos de datos heterogéneos.
- Escalabilidad y eficiencia de la red: Con la capacidad de realizar el entrenamiento en el perímetro, las instituciones pueden escalar el aprendizaje federado a nivel global. Además, las instituciones solo necesitan transferir los pesos del modelo, en lugar de conjuntos de datos completos, lo que permite un uso eficiente de los recursos de red.
En el siguiente diagrama, se muestra esta arquitectura.
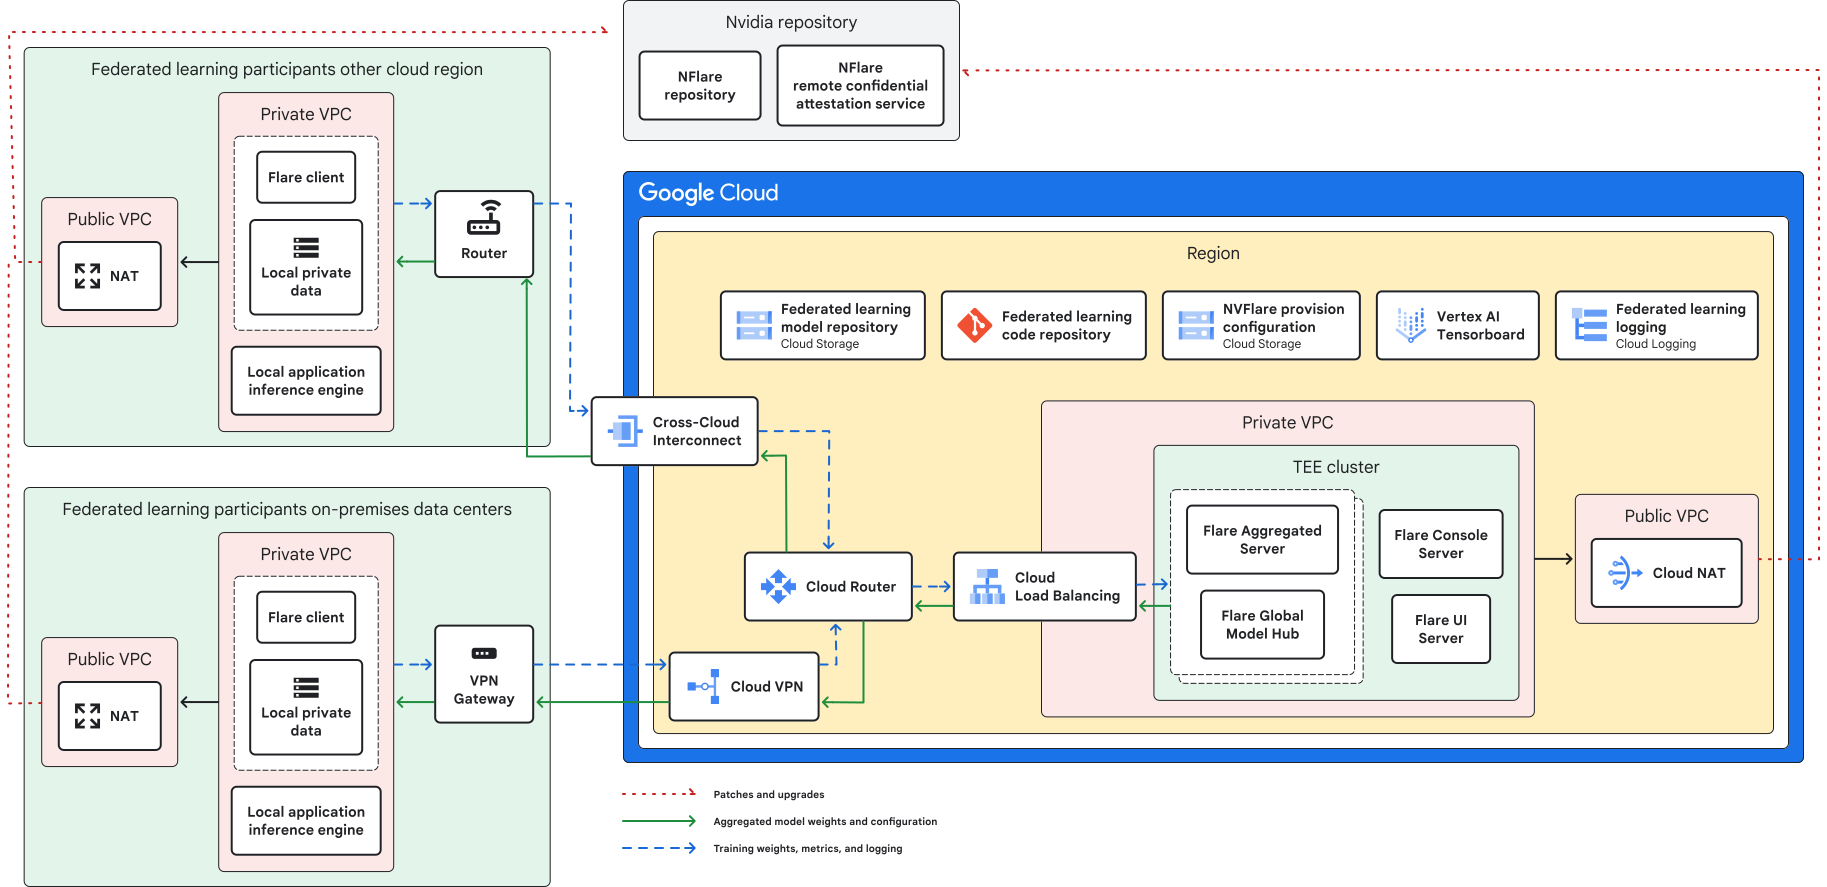
Entre los componentes clave de esta arquitectura, se incluyen los siguientes:
- Servidor federado en el clúster de TEE: Es un entorno seguro y aislado en el que el servidor de aprendizaje federado organiza la colaboración de varios clientes enviando primero un modelo inicial a los clientes de aprendizaje federado. Los clientes realizan el entrenamiento en sus conjuntos de datos locales y, luego, envían las actualizaciones del modelo de vuelta al servidor de aprendizaje federado para que se agreguen y formen un modelo global.
- Repositorio de modelos de aprendizaje federado: Es un modelo de detección de fraudes entrenado previamente que sirve como punto de partida para el aprendizaje federado.
- Motor de inferencia de la aplicación local: Es una aplicación que ejecuta tareas, realiza cálculos y aprendizajes locales con conjuntos de datos locales, y envía los resultados al servidor de aprendizaje federado para su agregación segura.
- Datos privados locales: Cada banco tiene sus propios datos de transacciones privados y encriptados, que incluyen etiquetas de fraude. Estos datos sin procesar nunca salen del entorno local del banco, lo que ayuda a proteger la privacidad de los datos.
- Protocolo de agregación segura (se muestra con las flechas azules punteadas entrantes de cada banco al clúster de TEE): El servidor de aprendizaje federado no necesita acceder a la actualización de ningún banco individual para entrenar el modelo. El servidor solo requiere los promedios ponderados por elementos de los vectores de actualización, tomados de un subconjunto aleatorio de bancos o sitios. Con un protocolo de agregación seguro para calcular estos promedios ponderados, el servidor solo aprende las actualizaciones del modelo agregadas del subconjunto seleccionado, en lugar de qué banco específico contribuyó con una actualización determinada. Este enfoque ayuda a preservar la privacidad de cada participante en el proceso de aprendizaje federado.
- Modelo global entrenado para detectar fraudes y pesos agregados (se muestran con las flechas verdes salientes del clúster de TEE a cada banco): El modelo mejorado de detección de fraudes, junto con sus pesos aprendidos, se envía de forma segura a los bancos participantes. Luego, los bancos pueden implementar este modelo mejorado de forma local para detectar fraudes en sus propias transacciones.
¿Qué sigue?
- Implementa Confidential Computing y Confidential Space en tu entorno.
- Obtén más información sobre los conceptos básicos de Confidential Computing en Google Cloud.
- Obtén más información para proteger un modelo de AA en Confidential Space.
- Lee sobre la IA médica que prioriza la privacidad con MedPerf y Google Cloud.
- Obtén información para impulsar la próxima era de la IA confidencial.