


Les zones d'IA sont des zones spécialisées utilisées pour les charges de travail d'entraînement et d'inférence d'intelligence artificielle et de machine learning (IA et ML). Elles fournissent une capacité d'accélérateur de ML (GPU et TPU) importante.
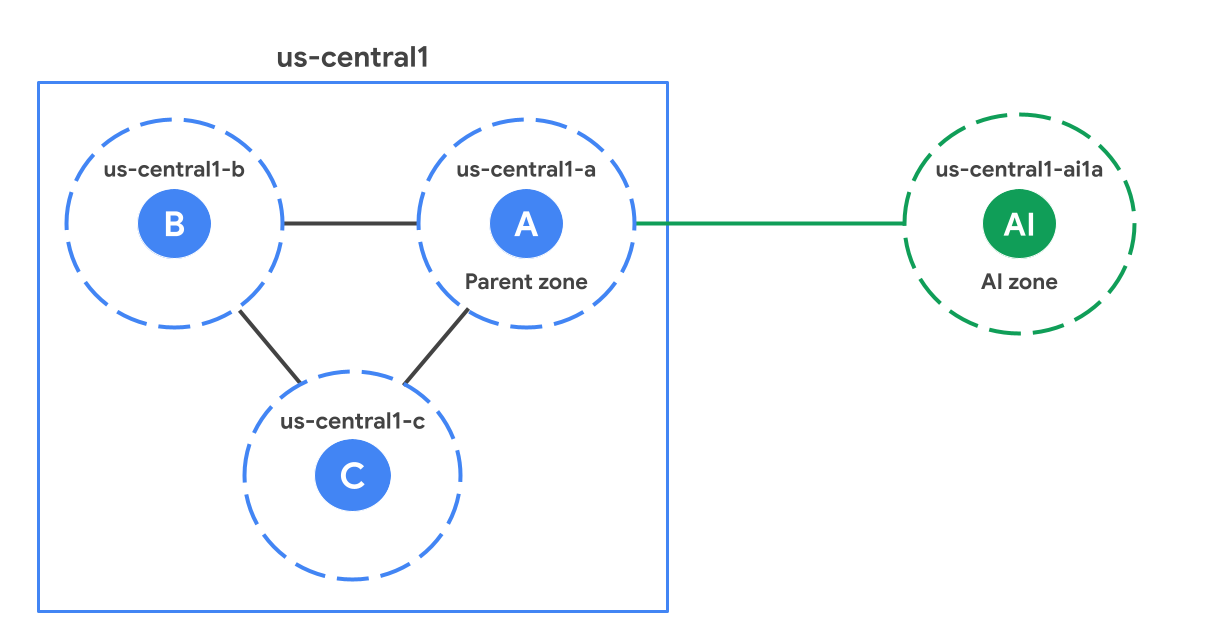
Dans une région, les zones d'IA sont géographiquement éloignées des zones standards (non IA). La figure suivante montre un exemple de zone d'IA (us-south1-ai1b) située plus loin que les zones standards de la région us-south1.
Zone parente
Chaque zone d'IA est associée à une zone standard de la région, appelée zone parente. Une zone parente est une zone standard portant le même suffixe que la zone d'IA. Par exemple, dans le diagramme, us-central1-a est la zone parente de us-central1-ai1a. Ils partagent les calendriers de mise à jour logicielle et parfois l'infrastructure. Cela signifie que tout problème logiciel ou d'infrastructure affectant une zone parente peut également affecter la zone d'IA. Lorsque vous concevez vos solutions de haute disponibilité, consultez les considérations relatives à la haute disponibilité pour tenir compte de la dépendance à la zone parente.
Quand utiliser les zones d'IA ?
Les zones d'IA sont optimisées pour les charges de travail d'IA et de ML. Suivez les conseils ci-dessous pour déterminer quelles charges de travail sont les mieux adaptées aux zones d'IA et lesquelles sont mieux adaptées aux zones standards.
Recommandé pour :
Entraînement à grande échelle : idéal pour les charges de travail d'entraînement à grande échelle, telles que l'entraînement de grands modèles de langage (LLM) et de modèles de fondation, en raison de la disponibilité d'un grand nombre d'accélérateurs.
Entraînement à petite échelle, réglage, inférence groupée et réentraînement : les zones d'IA sont performantes pour les charges de travail nécessitant une capacité d'accélérateur importante.
Inférence de ML en temps réel : les zones d'IA sont compatibles avec les charges de travail d'inférence en temps réel. Les performances dépendent de la conception de l'application et des exigences de latence du modèle, en particulier si la charge de travail nécessite des requêtes aller-retour vers la région parente.
Non recommandé pour :
- Charges de travail non liées au ML : étant donné que les zones d'IA ne proposent pas tous les services Google Cloud localement, nous vous recommandons d'exécuter vos charges de travail non liées au ML dans les zones standards.
Accéder aux services depuis une zone d'IA
Vous pouvez accéder à tous les produits Google Cloud dans une région Google Cloud depuis sa zone d'IA. Toutefois, l'accès aux services d'une région Google Cloud à partir d'une zone d'IA peut ajouter de la latence réseau, car la zone d'IA est physiquement séparée des emplacements des zones standards de la région.
Pour afficher les zones d'IA dans la console Google Cloud , la Google Cloud CLI et l'API REST, vous devez activer la visibilité des zones d'IA pour votre projet. La visibilité des zones d'IA est distincte du contrôle des accès et des limites du service de règles d'administration. Pour en savoir plus, consultez Gérer la visibilité des zones d'IA.
Certains produits permettent de créer des ressources zonales ou d'y accéder localement dans une zone d'IA. Pour en savoir plus sur ces services, consultez le tableau suivant :
| Produit | Description |
|---|---|
| Google Kubernetes Engine (GKE) | Configuration pour l'utilisation des zones d'IA dans les clusters GKE, y compris la configuration à l'aide de ComputeClasses, le provisionnement automatique des nœuds et les pools de nœuds GKE Standard. Utiliser des zones d'IA dans GKE |
| Cloud Storage | Configuration du stockage d'objets pour les charges de travail dans les zones d'IA, y compris le stockage zonal pour maximiser les performances pendant les jobs actifs et le stockage persistant pour les ensembles de données et les points de contrôle des modèles. Utiliser des zones d'IA avec Cloud Storage |
| Compute Engine | Méthodes pour identifier les zones d'IA disponibles à l'aide de la console, de la Google Cloud CLI et de l'API REST, y compris comment filtrer par convention d'attribution de noms, type d'accélérateur ou machine Trouver les zones d'IA disponibles |
| Google Cloud Managed Lustre | Optimisez les performances des charges de travail d'IA et de ML déployées sur GKE Standard. Optimiser les charges de travail d'IA et de ML avec Google Cloud Managed Lustre |
Emplacements
Les zones d'IA sont disponibles dans les emplacements suivants :
| Zone d'IA | Emplacement de la zone d'IA | Google Cloud region | Google Cloud emplacement de la région | Zone parente |
|---|---|---|---|---|
europe-west4-ai1a |
De Kooy, Pays-Bas, Europe | europe-west4 |
Eemshaven, Pays-Bas, Europe | europe-west4-a |
us-south1-ai1b |
Austin, Texas, Amérique du Nord | us-south1 |
Dallas, Texas, Amérique du Nord | us-south1-b |
us-central1-ai1a |
Lincoln, Nebraska, Amérique du Nord | us-central1 |
Council Bluffs, Iowa, Amérique du Nord | us-central1-a |
Pour savoir quels types de GPU et de TPU sont disponibles dans les zones d'IA, consultez les ressources suivantes :
- Afficher les types de GPU et les emplacements disponibles dans les zones d'IA
- Afficher les types de TPU et les emplacements disponibles dans les zones d'IA
Déployer des ressources dans des zones d'IA
Les zones d'IA sont accessibles via la console Google Cloud , la Google Cloud CLI ou REST. Toutefois, lorsque vous utilisez la console Google Cloud pour créer vos VM, vous devez sélectionner manuellement une zone d'IA. Elle n'est pas sélectionnée pour vous, comme c'est le cas pour les zones standards. Pour utiliser les zones d'IA avec les fonctionnalités suivantes, vous devez sélectionner explicitement une zone d'IA lors de la configuration de ces ressources.
Certaines fonctionnalités de Compute Engine : les zones d'IA ne sont pas automatiquement sélectionnées dans certaines fonctionnalités régionales de Compute Engine, telles que les opérations d'insertion groupée régionales ou les groupes d'instances gérés (MIG) régionaux.
Insertion groupée : pour inclure des zones d'IA dans les opérations d'insertion groupée régionales, vous devez utiliser le champ
locationPolicy.zones[]. Le champlocations[]n'est pas compatible avec les zones d'IA. L'exemple suivant montre ce format pour la zoneus-south1-ai1b:{ "locationPolicy": { "zones": [ "zones/us-south1-ai1b" ] } }MIG régionaux : pour créer des instances dans une zone d'IA de la région sélectionnée, vous devez la spécifier explicitement dans la règle de distribution (
distributionPolicy.zones[]) avec les autres zones préférées. L'exemple suivant montre ce format pour la zoneus-south1-ai1b:{ "distributionPolicy": { "zones": [ "zones/us-south1-a", "zones/us-south1-b", "zones/us-south1-ai1b" ] } }
Certaines fonctionnalités GKE : les zones d'IA ne sont pas automatiquement sélectionnées dans certaines fonctionnalités régionales de GKE, telles que les clusters GKE régionaux. Pour en savoir plus sur GKE, consultez Utiliser des zones d'IA dans GKE dans ce document.
Vertex AI : les produits régionaux Vertex AI basés sur GKE doivent configurer GKE pour inclure des zones d'IA dans les clusters régionaux. Vous n'avez pas besoin d'activer Vertex AI. Vertex AI gère cette configuration.
Google Cloud API Service Metadata Locations : vous devez activer l'option
--extraLocationTypeslorsque vous utilisez l'API locations.list pour vous assurer que les zones d'IA n'apparaissent qu'aux personnes qui ont l'intention de les utiliser.Restrictions concernant les charges de travail sans accélérateur : Compute Engine limite la création de VM n'utilisant que des processeurs dans les zones d'IA.
Utiliser des zones d'IA dans GKE
Par défaut, GKE ne déploie pas vos charges de travail dans les zones d'IA. Pour utiliser une zone d'IA, configurez l'une des options suivantes :
ComputeClasses : définissez votre priorité la plus élevée pour demander des TPU à la demande dans une zone d'IA. Les ComputeClasses vous aident à définir une liste prioritaire de configurations matérielles pour vos charges de travail. Pour obtenir un exemple, consultez À propos des ComputeClasses.
Provisionnement automatique des nœuds : utilisez un
nodeSelectorou unnodeAffinitydans la spécification de votre pod pour indiquer au provisionnement automatique des nœuds de créer un pool de nœuds dans la zone d'IA. Si votre charge de travail ne cible pas explicitement une zone d'IA, le provisionnement automatique des nœuds ne prend en compte que les zones standards lors de la création de pools de nœuds. Cette configuration garantit que les charges de travail qui n'exécutent pas de modèles d'IA/ML restent dans des zones standards, sauf si vous configurez explicitement le contraire. Pour obtenir un exemple de fichier manifeste utilisant unnodeSelector, consultez Définir les zones par défaut pour les nœuds créés automatiquement.GKE Standard : si vous gérez directement vos pools de nœuds, utilisez une zone d'IA dans l'option
--node-locationslorsque vous créez un pool de nœuds. Pour obtenir un exemple, consultez Déployer des charges de travail TPU dans GKE Standard.
Limites
Les éléments suivants ne sont pas disponibles dans les zones d'IA :
Considérations de conception avec les zones d'IA
Tenez compte des points suivants lorsque vous concevez vos applications pour utiliser des zones d'IA.
Points à prendre en compte concernant la haute disponibilité (HA)
Les zones d'IA partagent les déploiements logiciels et l'infrastructure avec leurs zones parentes. Pour garantir une haute disponibilité de vos charges de travail, évitez ces modèles de déploiement lorsque vous sélectionnez des zones, que ce soit automatiquement ou manuellement :
Évitez de déployer des charges de travail à haute disponibilité dans une zone d'IA et sa zone parente.
Évitez de déployer des charges de travail à haute disponibilité sur deux zones d'IA partageant la même zone parente.
Bonnes pratiques de stockage
Nous vous recommandons une architecture de stockage hiérarchisée pour équilibrer les coûts, la durabilité et les performances :
- Couche de stockage à froid : utilisez des buckets Cloud Storage régionaux dans des zones standards pour un stockage persistant et hautement durable de vos ensembles de données d'entraînement et de vos points de contrôle de modèle.
Couche de performances : utilisez des services de stockage zonaux spécialisés pour servir de cache à grande vitesse ou d'espace de travail temporaire. Cette approche élimine la latence interzone et maximise le débit utile pendant les jobs actifs.
Pour vous assurer que les GPU et les TPU restent entièrement saturés, ce qui maximise le débit utile, provisionnez votre couche de performances dans la même zone d'IA que vos ressources de calcul.
Les solutions de stockage suivantes sont recommandées pour optimiser les performances des systèmes d'IA et de ML avec les zones d'IA :
| Service de stockage | Description | Cas d'utilisation |
|---|---|---|
| Fonctionnalité Anywhere Cache de Cloud Storage | Un cache de lecture zonal entièrement géré et basé sur un disque SSD qui transfère les données fréquemment lues d'un bucket vers la zone d'IA. | Recommandé pour :
|
Inclure ou exclure des zones d'IA
Pour inclure ou exclure manuellement des zones d'IA d'une liste de zones, utilisez un filtre :
- Pour filtrer une liste de zones afin de n'inclure que les zones d'IA, consultez Rechercher des zones d'IA.
- Pour filtrer une liste de zones afin d'exclure les zones d'IA, consultez Exclure les zones d'IA des listes.
Étapes suivantes
- Consulter la liste des zones d'IA
- Configurer une règle d'administration pour limiter la création de VM dans les zones d'IA