


Compute Engine의 두 개 영역에서 SQL Server의 고가용성을 달성하려면 멀티 작성자 디스크를 사용하는 Linux에 SQL Server 장애 조치 클러스터 인스턴스 (FCI)를 배포하면 됩니다. 기존의 공유 없음 아키텍처와 달리 이 구성을 사용하면 서로 다른 영역의 노드를 동일한 디스크에 동시에 연결할 수 있습니다. 이 가이드에서는 Google Cloud Hyperdisk의 짧은 지연 시간의 동기 복제를 사용하여 Compute Engine의 Linux에 고가용성 SQL Server FCI를 배포하는 방법을 설명합니다.
이 설계는 영역 중단이라는 예기치 않은 상황에서도 SQL Server를 계속 사용할 수 있도록 보장합니다. 클러스터 오케스트레이션을 위한 Pacemaker를 Compute Engine의 영역 간 복원력과 결합하면 공유 스토리지의 단순성이 필요한 미션 크리티컬 데이터베이스 워크로드를 위한 강력한 고성능 솔루션을 제공할 수 있습니다.
멀티 작성자 디스크로 고가용성을 구현할 때의 이점
Linux에서 Always On 가용성 그룹 (AG) 대신 멀티 작성자 디스크가 있는 SQL Server FCI를 사용하면 여러 데이터 복사본 관리의 복잡성과 AG 구성으로 발생하는 동기화 오버헤드가 제거됩니다.
공유 볼륨 아키텍처는 각 노드에서 전체 데이터 복제본을 사용하는 AG 아키텍처와 비교할 때 스토리지 효율성도 더 높습니다. 공유 볼륨은 미러 시나리오에서 디스크 비용을 줄일 수도 있습니다.
이 아키텍처의 주요 특징
- 영역 중복: 노드 장애 또는 영역 서비스 중단이 드물게 발생하는 경우의 데이터 보호
- 간소화된 관리: Always On 가용성 그룹에 비해 여러 데이터 복사본을 관리하는 복잡성이 줄어듭니다.
- 스토리지 효율성: 멀티 라이터 기능을 사용하여 최적화된 데이터 및 로그용 단일 공유 볼륨을 활용합니다.
- Linux 네이티브 오케스트레이션: 원활한 장애 조치를 위해 업계 표준 고가용성 확장 프로그램 (HAE)을 사용합니다.
온프레미스 환경에서는 WSFC에서 ARP 알림을 수행하여 장애 조치 발생 시 네트워크 장비에 IP 주소 변경을 알리게 할 수 있습니다. 하지만Google Cloud는 ARP 알림을 무시합니다. 따라서 내부 부하 분산기를 구현해야 합니다 (Windows Server 장애 조치 클러스터링 실행 참고).
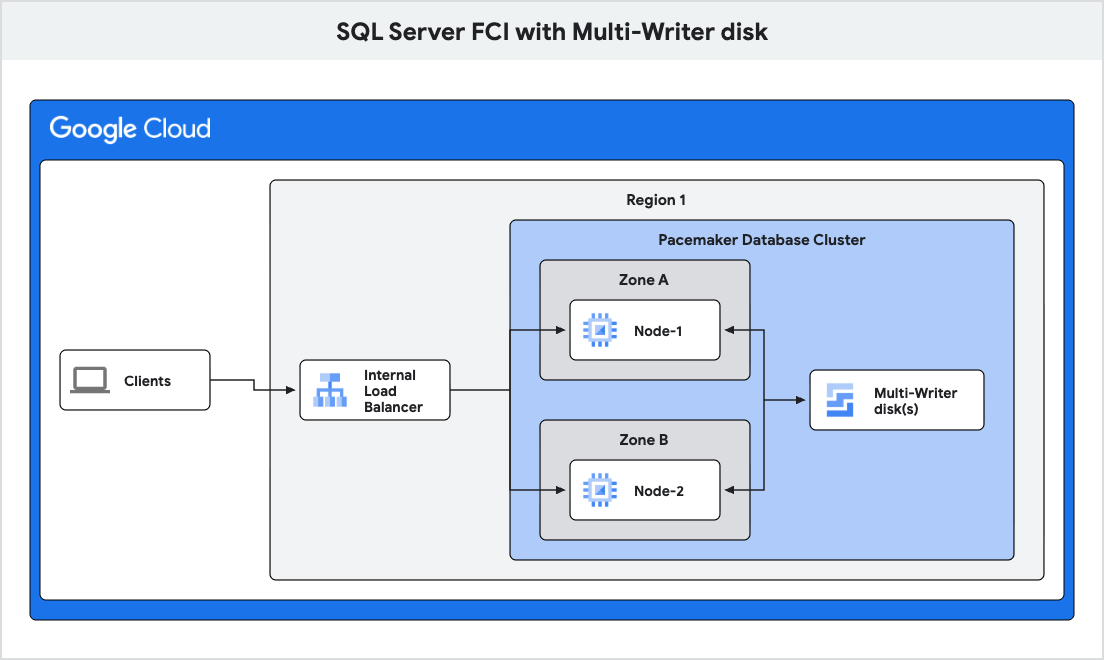
이 문서에서는 SQL Server, Active Directory, Compute Engine에 대한 기본 지식이 있다고 가정합니다.
목표
이 튜토리얼에서는 목표를 달성하기 위해 다음 작업을 완료하는 방법을 보여줍니다.- Linux에 SQL Server 배포를 만듭니다.
- 멀티 작성자 디스크를 만들고 연결하고 구성합니다.
- Pacemaker 클러스터를 구성합니다.
- 부하 분산기를 설정합니다.
- 장애 조치 테스트를 수행합니다.
비용
이 튜토리얼에서는 비용이 청구될 수 있는 Google Cloud구성요소를 사용합니다.
가격 계산기를 사용하면 예상 사용량을 기준으로 예상 비용을 산출할 수 있습니다.
시작하기 전에
이 튜토리얼을 진행하려면 Google Cloud 프로젝트가 필요합니다. 새 프로젝트를 만들거나 기존에 만든 프로젝트를 선택할 수 있습니다.
-
Google Cloud 콘솔의 프로젝트 선택기 페이지에서 Google Cloud 프로젝트를 선택하거나 만듭니다.
프로젝트를 선택하거나 만드는 데 필요한 역할
- 프로젝트 선택: 프로젝트를 선택하는 데는 특정 IAM 역할이 필요하지 않습니다. 역할이 부여된 프로젝트를 선택하면 됩니다.
-
프로젝트 만들기: 프로젝트를 만들려면
resourcemanager.projects.create권한이 포함된 프로젝트 생성자 역할(roles/resourcemanager.projectCreator)이 필요합니다. 역할 부여 방법 알아보기
-
Google Cloud 콘솔에서 Cloud Shell을 활성화합니다.
-
프로젝트 및 네트워크 준비
SQL Server FCI를 배포할 수 있도록 Google Cloud 프로젝트와 VPC를 준비하려면 다음을 수행합니다.
Google Cloud 콘솔에서 Cloud Shell 활성화
 버튼을 클릭하여 Cloud Shell을 엽니다.
기본 프로젝트 ID를 설정합니다.
gcloud config set project
PROJECT_IDPROJECT_ID를 Google Cloud 프로젝트의 ID로 바꿉니다.기본 리전을 설정합니다.
gcloud config set compute/region
REGIONREGION을 배포하려는 리전의 ID로 바꿉니다.
클러스터 노드 만들기
VM 2개를 클러스터 노드로 배포하고 세 번째 VM을 연결 및 장애 조치 성능을 검증하는 전용 클라이언트로 배포합니다.
나머지 명령어에 사용될 다음 변수를 초기화합니다.
BOOT_DISK_SIZE=50 BOOT_IOPS=10000 BOOT_THROUGHPUT=400 DATA_IOPS=10000 DATA_THROUGHPUT=400 DATA_DISK_SIZE=
200REGION=$(gcloud config get-value compute/region) ZONE1=$REGION-a ZONE2=$REGION-b SUBNET=SUBNET_NAMEMACHINE_TYPE=c3-standard-8 VPC_NAME=VPC_NAME데이터 디스크 하나와 로그용 디스크 하나 등 리전 디스크 두 개를 만듭니다. 두 인스턴스 모두 디스크에 액세스할 수 있도록 하려면 --access-mode=READ_WRITE_MANY 플래그를 사용하여 두 디스크 모두에 멀티 작성자 모드를 사용 설정합니다.
gcloud compute disks create sqlfci-mw-data-disk \
--size=$DATA_DISK_SIZE \
--type=hyperdisk-balanced-high-availability \
--region=$REGION \
--replica-zones=$ZONE1,$ZONE2 \
--provisioned-iops=$DATA_IOPS \
--provisioned-throughput=$DATA_THROUGHPUT \
--access-mode=READ_WRITE_MANY

gcloud compute disks create sqlfci-mw-log-disk \
--size=$DATA_DISK_SIZE \
--type=hyperdisk-balanced-high-availability \
--region=$REGION \
--replica-zones=$ZONE1,$ZONE2 \
--provisioned-iops=$DATA_IOPS \
--provisioned-throughput=$DATA_THROUGHPUT \
--access-mode=READ_WRITE_MANY
Linux VM을 만들고 만든 멀티 작성자 디스크를 연결합니다.
gcloud compute instances create node-1 \
--boot-disk-size=$BOOT_DISK_SIZE \
--boot-disk-type=hyperdisk-balanced \
--boot-disk-provisioned-iops=$BOOT_IOPS \
--boot-disk-provisioned-throughput=$BOOT_THROUGHPUT \
--zone $ZONE1 \
--machine-type $MACHINE_TYPE \
--subnet $SUBNET \
--image-family ubuntu-2204-lts \
--image-project ubuntu-os-cloud \
--disk="name=sqlfci-mw-data-disk,scope=regional,mode=rw" \
--disk="name=sqlfci-mw-log-disk,scope=regional,mode=rw" \
--scopes=compute-rw,trace,service-control,service-management,pubsub,monitoring-write,logging-write,storage-rw \
--tags=sqlfci

gcloud compute instances create node-2 \
--boot-disk-size=$BOOT_DISK_SIZE \
--boot-disk-type=hyperdisk-balanced \
--boot-disk-provisioned-iops=$BOOT_IOPS \
--boot-disk-provisioned-throughput=$BOOT_THROUGHPUT \
--zone $ZONE2 \
--machine-type $MACHINE_TYPE \
--subnet $SUBNET \
--image-family ubuntu-2204-lts \
--image-project ubuntu-os-cloud \
--disk="name=sqlfci-mw-data-disk,scope=regional,mode=rw" \
--disk="name=sqlfci-mw-log-disk,scope=regional,mode=rw" \
--scopes=compute-rw,trace,service-control,service-management,pubsub,monitoring-write,logging-write,storage-rw \
--tags=sqlfci
연결을 테스트하는 데 사용할 Windows 클라이언트 VM(
cl-node)을 만듭니다.gcloud compute instances create cl-node \ --boot-disk-size=100 \ --boot-disk-type=hyperdisk-balanced \ --machine-type $MACHINE_TYPE \ --image-family windows-2025 \ --image-project windows-cloud \ --zone $ZONE1 \ --subnet $SUBNET \ --scopes=compute-rw,trace,service-control,service-management,pubsub,monitoring-write,logging-write,storage-rw
내부 부하 분산기 만들기
클러스터 및 부하 분산기의 IP 주소를 예약합니다.
gcloud compute addresses create sqlfci-lb-ipaddress \
--region=$REGION \
--subnet=$SUBNET \
--purpose="SHARED_LOADBALANCER_VIP"
CLUSTER_ADDRESS=$(gcloud compute addresses describe sqlfci-lb-ipaddress \
--region $REGION \
--format=value\(address\)) && \
echo "Cluster IP address: $CLUSTER_ADDRESS"
클러스터의 상태 점검을 만듭니다.
gcloud compute health-checks create tcp sqlfci-healthcheck \
--port="60008" \
--region=$REGION \
--check-interval=3 \
--timeout=2 \
--unhealthy-threshold=2 \
--healthy-threshold=5
상태 점검 포트에 연결하려면 방화벽 규칙을 만드세요.
gcloud compute firewall-rules create "allow-sqlfci-healthcheck-60008" \
--allow "tcp:60008" \
--target-tags sqlfci \
--network $VPC_NAME \
--source-ranges="35.191.0.0/16,130.211.0.0/22" \
--priority="1000"
자세한 내용은 상태 점검을 위한 방화벽 규칙을 참조하세요.
클러스터 노드의 인스턴스 그룹을 만듭니다.
gcloud compute instance-groups unmanaged create sqlfci-1-uig \
--zone=$ZONE1
gcloud compute instance-groups unmanaged add-instances sqlfci-1-uig \
--zone=$ZONE1 \
--instances=node-1

gcloud compute instance-groups unmanaged create sqlfci-2-uig \
--zone=$ZONE2
gcloud compute instance-groups unmanaged add-instances sqlfci-2-uig \
--zone=$ZONE2 \
--instances=node-2
부하 분산기 백엔드 서비스를 만듭니다.
gcloud compute backend-services create sqlfci-backend-services \
--region=$REGION \
--load-balancing-scheme="INTERNAL" \
--protocol="TCP" \
--health-checks=sqlfci-healthcheck \
--health-checks-region=$REGION
gcloud compute backend-services add-backend sqlfci-backend-services \
--region=$REGION \
--instance-group=sqlfci-1-uig \
--instance-group-zone=$ZONE1
gcloud compute backend-services add-backend sqlfci-backend-services \
--region=$REGION \
--instance-group=sqlfci-2-uig \
--instance-group-zone=$ZONE2
부하 분산기 전달 규칙을 만듭니다.
gcloud compute forwarding-rules create "sqlfci-forwarding-rule" \
--load-balancing-scheme=INTERNAL \
--network=$VPC_NAME \
--subnet=$SUBNET \
--region=$REGION \
--address=$CLUSTER_ADDRESS \
--ip-protocol="TCP" \
--ports="ALL" \
--backend-service=sqlfci-backend-services \
--backend-service-region=$REGION
기본 클러스터 노드에서 보조 클러스터 노드로 파일을 전송할 Cloud Storage 버킷을 만듭니다.
gcloud storage buckets create gs://
BUCKET_NAME\ --location=$REGION \ --public-access-preventionBUCKET_NAME을 만들 버킷의 이름으로 바꿉니다.자세한 내용은 버킷 만들기를 참고하세요.
필요한 소프트웨어 설치
장애 조치 클러스터에 참여할 Linux VM 2개(node-1 및 node-2)에 SQL Server 엔진과 클러스터 관리를 다운로드, 설치, 구성합니다.
SSH를 사용하여 각 VM에 연결합니다. 자세한 내용은 Linux VM에 연결 및 SSH 네트워크 액세스 제어 권장사항을 참고하세요.
node-1및node-2에서hosts file업데이트수정할
hosts file을 엽니다.sudo vi /etc/hosts
각 Linux VM의 내부 IP 주소를 찾고 호스트 항목을 파일 하단에 추가합니다.
NODE1_INTERNAL_IPnode-1NODE2_INTERNAL_IPnode-2NODE1_INTERNAL_IP및NODE2_INTERNAL_IP을 각 Linux VM의 내부 IP 주소로 바꿉니다.
VM 간의 통신을 확인합니다. Always On 가용성 그룹에 참여하는 모든 VM은 다른 VM과 통신할 수 있어야 합니다. 각 Linux VM으로 돌아가서 각 VM에서 명령어를 실행하고 모든 VM이 서로 통신할 수 있는지 확인합니다.
ping -c 4 node-1
ping -c 4 node-2
출력은 다음과 비슷하게 표시됩니다.
PING node-1 (10.128.0.37) 56(84) bytes of data.
64 bytes from node-1 (10.128.0.37): icmp_seq=1 ttl=128 time=1.91 ms
64 bytes from node-1 (10.128.0.37): icmp_seq=2 ttl=128 time=0.234 ms
64 bytes from node-1 (10.128.0.37): icmp_seq=3 ttl=128 time=0.249 ms
64 bytes from node-1 (10.128.0.37): icmp_seq=4 ttl=128 time=0.263 ms
SQL Server 2025를 설치합니다.
SQL Server 저장소를 시스템에 추가합니다.
curl https://packages.microsoft.com/keys/microsoft.asc | sudo tee /etc/apt/trusted.gpg.d/microsoft.asc
curl -fsSL https://packages.microsoft.com/config/ubuntu/22.04/mssql-server-2025.list | sudo tee /etc/apt/sources.list.d/mssql-server-2025.list
sudo apt-get update
SQL Server를 설치합니다.
sudo apt-get install -y mssql-server
SQL Server 개발자 도구를 설치합니다. 장애 조치 클러스터에 참여할 Linux VM 2개에 SQL Server 도구를 다운로드하여 설치합니다.
curl https://packages.microsoft.com/config/ubuntu/22.04/prod.list | sudo tee /etc/apt/sources.list.d/mssql-release.list
sudo apt-get update
sudo ACCEPT_EULA=Y apt-get install -y mssql-tools18 unixodbc-dev
Pacemaker를 설치합니다. Pacemaker는 Corosync Cluster Engine과 함께 사용되는 오픈소스 고가용성 리소스 관리자 소프트웨어입니다. 이 섹션에서는 두 클러스터 VM에 Pacemaker를 설치합니다.
node-1및node-2에 Pacemaker를 설치합니다.sudo apt-get install -y pacemaker pcs fence-agents resource-agents pacemaker-cli-utils crmsh
Pacemaker용 SQL Server 리소스 에이전트를 설치합니다.
sudo apt-get install -y mssql-server-ha
VM에 방화벽이 사용 설정되어 있으면 SQL Server용 방화벽을 엽니다.
다음 명령어를 실행하여
Uncomplicated Firewall이 설치되어 있고 사용 설정되었는지 확인합니다.sudo ufw status
활성 상태이면 다음 명령어를 실행하여 포트를 엽니다. 방화벽 서비스가 실행되고 있지 않으면 이 단계를 무시해도 됩니다.
sudo ufw allow 1433
sudo ufw allow 5022
sudo ufw reload
기본 데이터베이스 노드 구성
이 섹션에서는 멀티 작성자 디스크 두 개를 초기화하고 볼륨 그룹과 논리 그룹을 사용하여 각 디스크를 설정합니다.
LVM을 구성합니다.
LVM 설정을 구성합니다.
기존 구성을 백업합니다.
sudo cp /etc/lvm/lvm.conf /etc/lvm/lvm.conf.bak
시스템 ID 소스를 업데이트합니다.
sudo sed -i 's/^\(\s*system_id_source\s*=\s*\)"none"/\1"uname"/' /etc/lvm/lvm.conf
변경사항이 적용되었는지 확인합니다.
grep 'system_id_source *= *"uname"' /etc/lvm/lvm.conf
LVM 볼륨 그룹과 논리 볼륨을 구성합니다.
sudo pvcreate /dev/nvme0n2 /dev/nvme0n3
sudo pvs
sudo vgcreate vgdata /dev/nvme0n2
sudo lvcreate -l 100%FREE -n lvdata vgdata
sudo vgcreate vglogtmp /dev/nvme0n3
sudo lvcreate -l 70%FREE  -n lvlog vglogtmp
sudo lvcreate -l 100%FREE -n lvtmp vglogtmp
sudo vgs -o+systemid
64KB 블록 크기로
xfs파일 시스템을 사용하여 볼륨을 포맷합니다.sudo mkfs.xfs -d su=64k,sw=1 -L data /dev/vgdata/lvdata -f sudo mkfs.xfs -d su=64k,sw=1 -L dblog /dev/vglogtmp/lvlog -f sudo mkfs.xfs -d su=64k,sw=1 -L tmp /dev/vglogtmp/lvtmp -f
볼륨이 생성되었는지 확인합니다.
sudo lvs
디스크 마운트 및 포맷
공유 디스크의 마운트 포인트를 설정하고 mssql 사용자에게 액세스 권한을 부여합니다.
새 볼륨의 마운트 지점을 만듭니다.
sudo mkdir /mssql
sudo mkdir -p /mssql/db_data
sudo mkdir -p /mssql/db_log
sudo mkdir -p /mssql/db_temp
마운트 지점에 LVM 볼륨을 마운트합니다.
sudo mount /dev/vgdata/lvdata /mssql/db_data
sudo mount /dev/vglogtmp/lvlog /mssql/db_log
sudo mount /dev/vglogtmp/lvtmp /mssql/db_temp
mssql사용자를 마운트 지점의 소유자로 설정합니다.sudo chown mssql:mssql /mssql/db_data sudo chown mssql:mssql /mssql/db_log sudo chown mssql:mssql /mssql/db_temp
SQL Server를 구성합니다.
마스터 데이터베이스를 공유 스토리지로 재배치하는 변수를 설정하고
mssql-conf도구를 실행합니다.sudo MSSQL_MASTER_DATA_FILE="/mssql/db_data/master.mdf" MSSQL_MASTER_LOG_FILE="/mssql/db_data/mastlog.ldf" /opt/mssql/bin/mssql-conf setup
SQL Server 개발자 버전을 선택하고 라이선스 계약에 동의합니다.
개발자 버전에는 모든 엔터프라이즈 기능이 포함되어 있지만 비프로덕션 환경에서만 사용할 수 있습니다. SQL Server 버전 및 Microsoft 라이선스에 관한 자세한 정보를 확인할 수 있습니다.
SA 계정의 비밀번호를 지정합니다.
mssql-server서비스가 실행 중인지 확인합니다.systemctl status mssql-server --no-pager
SQL Server 및 Pacemaker 구성
Pacemaker용 SQL Server 사용자를 만듭니다.
SA_PASSWORD를 SQL Server의 SA 계정 비밀번호로 바꾸고PA_PASSWORD를 pacemaker 계정에 사용할 비밀번호로 바꿉니다.QUERY=" CREATE LOGIN [pacemaker] with PASSWORD= N'
PA_PASSWORD'; ALTER SERVER ROLE [sysadmin] ADD MEMBER [pacemaker]; GO"/opt/mssql-tools18/bin/sqlcmd -No -S localhost -U sa -P '
SA_PASSWORD' -Q "$QUERY"Pacemaker 로그인 정보 및 비밀번호를 SQL Server 보안 비밀 폴더에 추가합니다.
{ echo 'pacemaker' echoPA_PASSWORD' } | sudo tee /var/opt/mssql/secrets/passwd > /dev/null sudo chown root:root /var/opt/mssql/secrets/passwd sudo chmod 400 /var/opt/mssql/secrets/passwd새 데이터, 로그, 임시 위치를 사용하도록 SQL Server 구성을 업데이트합니다. SQL Server 권장 설정도 설정합니다.
sudo /opt/mssql/bin/mssql-conf set filelocation.defaultdatadir /mssql/db_data
sudo /opt/mssql/bin/mssql-conf set filelocation.defaultlogdir /mssql/db_log
sudo /opt/mssql/bin/mssql-conf set filelocation.defaultdumpdir /mssql/db_log
sudo /opt/mssql/bin/mssql-conf traceflag 9944 3979 on
sudo /opt/mssql/bin/mssql-conf set control.alternatewritethrough 0
sudo /opt/mssql/bin/mssql-conf set control.writethrough 1
TempDB를 공유 디스크로 이동
TempDB 파일 목록을 가져와서 이를 사용하여 변경 쿼리를 만듭니다. 이 쿼리는 다음 단계에서 TempDB 파일의 새 위치를 설정하는 데 사용됩니다.
QUERY="
SET NOCOUNT ON;
SELECT 'ALTER DATABASE tempdb MODIFY FILE (NAME = [' + f.name + '],' + ' FILENAME = ''/mssql/db_temp/' + f.name + CASE WHEN f.type = 1 THEN '.ldf' ELSE '.mdf' END + ''');' FROM sys.master_files f WHERE f.database_id = DB_ID(N'tempdb');"
/opt/mssql-tools18/bin/sqlcmd -No -S localhost -U sa -P '
SA_PASSWORD' -Q "$QUERY"이전 명령어의 출력을 캡처합니다. 출력을 사용하여 실행할 다음 명령어를 구성합니다.
QUERY="
QUERY_OUTPUT"출력을 사용하는 쿼리의 예:
QUERY="
ALTER DATABASE tempdb MODIFY FILE (NAME = [tempdev], FILENAME = '/mssql/db_temp/tempdev.mdf');
ALTER DATABASE tempdb MODIFY FILE (NAME = [templog], FILENAME = '/mssql/db_temp/templog.ldf');
ALTER DATABASE tempdb MODIFY FILE (NAME = [tempdev2], FILENAME = '/mssql/db_temp/tempdev2.mdf');
ALTER DATABASE tempdb MODIFY FILE (NAME = [tempdev3], FILENAME = '/mssql/db_temp/tempdev3.mdf');"
생성된 SQL 명령어를 실행하여 TempDB 파일을 이동합니다.
/opt/mssql-tools18/bin/sqlcmd -No -S localhost -U sa -P '
SA_PASSWORD' -Q "$QUERY"변경사항이 적용되도록 SQL Server 서비스를 다시 시작합니다.
sudo systemctl restart mssql-server.service
TempDB 파일이 생성되었는지 확인합니다.
ls -l /mssql/db_temp/
SQL Server 서비스가 실행 중인지 확인합니다.
systemctl status mssql-server --no-pager
HAProxy 구성
hacluster의 새 비밀번호를 설정합니다.sudo passwd hacluster
설정을 완료하고 네트워크 부하 분산기가 올바르게 설정되었는지 테스트하려면 두 클러스터 노드에
HAProxy tcp listener를 설치하고 구성합니다.HAProxy를 설치합니다.
sudo apt-get install haproxy
Y를 입력하여 설치를 완료합니다.haproxy.cfg파일을 수정합니다.sudo vi /etc/haproxy/haproxy.cfg
haproxy.cfg file의defaults섹션에서 모드를tcp로 변경합니다.haproxy.cfg파일 끝에 다음 섹션을 추가합니다.#--------------------------------------------------------------- # Set up health check listener for SQL Server Availability Group #--------------------------------------------------------------- listen healthcheck bind *:60008
HAProxy 서비스를 시작합니다.
sudo systemctl start haproxy.service
sudo systemctl status haproxy.service
HAProxy 서비스를 중지하고 사용 중지합니다.
sudo systemctl stop haproxy.service
sudo systemctl disable haproxy.service
다음 명령어를 사용하여 머신 키 파일을 Cloud Storage에 업로드합니다.
sudo gcloud storage cp /var/opt/mssql/secrets/machine-key gs://
BUCKET_NAME/BUCKET_NAME을 생성된 버킷의 이름으로 바꿉니다.SQL Server 서비스를 중지하고 사용 중지합니다. 이 시점부터 서비스는 클러스터에 의해 제어됩니다.
sudo systemctl stop mssql-server.service
sudo systemctl disable mssql-server.service
공유 저장소를 마운트 해제합니다.
sudo umount /mssql/db_data
sudo umount /mssql/db_log
sudo umount /mssql/db_temp
기존 기본 클러스터 구성을 정리합니다.
sudo pcs cluster destroy
보조 노드 구성
LVM 볼륨의 마운트 지점을 만듭니다. 이 디스크는
node-1와 공유되므로 디스크를 포맷하지 않아도 됩니다.node-1를 구성할 때 이미 디스크를 포맷하고 LVM 볼륨을 구성했습니다.sudo mkdir /mssql sudo mkdir -p /mssql/db_data sudo mkdir -p /mssql/db_log sudo mkdir -p /mssql/db_temp sudo chown mssql:mssql /mssql/db_data sudo chown mssql:mssql /mssql/db_log sudo chown mssql:mssql /mssql/db_temp
SQL Server를 구성합니다.
마스터 데이터베이스를 공유 데이터 디스크로 이전하려면 다음 변수를 설정한 다음
mssql-conf도구를 실행하여 변경사항을 적용합니다.sudo MSSQL_MASTER_DATA_FILE="/mssql/db_data/master.mdf" MSSQL_MASTER_LOG_FILE="/mssql/db_data/mastlog.ldf" /opt/mssql/bin/mssql-conf setup
SQL Server 개발자 버전을 선택하고 라이선스 계약에 동의합니다.
개발자 버전에는 모든 엔터프라이즈 기능이 포함되어 있지만 비프로덕션 환경에서만 사용할 수 있습니다. SQL Server 버전 및 Microsoft 라이선스에 관한 자세한 정보를 확인할 수 있습니다.
SA 계정의 비밀번호를 지정합니다.
mssql-server서비스가 실행 중인지 확인합니다.systemctl status mssql-server --no-pager
Pacemaker 클러스터의 SQL Server 사용자를 만듭니다.
SA_PASSWORD를 SQL Server의 SA 계정 비밀번호로 바꾸고PA_PASSWORD를 pacemaker 계정에 사용할 비밀번호로 바꿉니다.QUERY=" CREATE LOGIN [pacemaker] with PASSWORD= N'
PA_PASSWORD'; ALTER SERVER ROLE [sysadmin] ADD MEMBER [pacemaker]; GO"/opt/mssql-tools18/bin/sqlcmd -No -S localhost -U sa -P '
SA_PASSWORD' -Q "$QUERY"Pacemaker 로그인 정보 및 비밀번호를 SQL Server 보안 비밀 폴더에 추가합니다.
{
  echo 'pacemaker'
  echo 'PA_PASSWORD'
} | sudo tee /var/opt/mssql/secrets/passwd > /dev/null
sudo chown root:root /var/opt/mssql/secrets/passwd
sudo chmod 400 /var/opt/mssql/secrets/passwd
새 데이터, 로그, 임시 위치를 사용하도록 SQL Server 구성을 업데이트합니다. SQL Server 권장 설정도 지정합니다.
sudo /opt/mssql/bin/mssql-conf set filelocation.defaultdatadir /mssql/db_data
sudo /opt/mssql/bin/mssql-conf set filelocation.defaultlogdir /mssql/db_log
sudo /opt/mssql/bin/mssql-conf set filelocation.defaultdumpdir /mssql/db_log
sudo /opt/mssql/bin/mssql-conf traceflag 9944 3979 on
sudo /opt/mssql/bin/mssql-conf set control.alternatewritethrough 0
sudo /opt/mssql/bin/mssql-conf set control.writethrough 1
TempDB를 공유 데이터 디스크로 이동합니다.
TempDB 파일 목록을 가져와서 이를 사용하여 변경 쿼리를 만듭니다.
QUERY="
SET NOCOUNT ON;
SELECT 'ALTER DATABASE tempdb MODIFY FILE (NAME = [' + f.name + '],' + ' FILENAME = ''/mssql/db_temp/' + f.name + CASE WHEN f.type = 1 THEN '.ldf' ELSE '.mdf' END + ''');' FROM sys.master_files f WHERE f.database_id = DB_ID(N'tempdb');"
/opt/mssql-tools18/bin/sqlcmd -No -S localhost -U sa -P '
SA_PASSWORD' -Q "$QUERY"이전 명령어의 출력을 캡처합니다. 출력을 사용하여 실행할 다음 명령어를 구성합니다.
QUERY="
QUERY_OUTPUT"출력을 사용하는 쿼리의 예:
QUERY="
ALTER DATABASE tempdb MODIFY FILE (NAME = [tempdev], FILENAME = '/mssql/db_temp/tempdev.mdf');
ALTER DATABASE tempdb MODIFY FILE (NAME = [templog], FILENAME = '/mssql/db_temp/templog.ldf');
ALTER DATABASE tempdb MODIFY FILE (NAME = [tempdev2], FILENAME = '/mssql/db_temp/tempdev2.mdf');
ALTER DATABASE tempdb MODIFY FILE (NAME = [tempdev3], FILENAME = '/mssql/db_temp/tempdev3.mdf');"
TempDB 파일을 이동하려면 생성된 SQL 명령어를 실행합니다.
/opt/mssql-tools18/bin/sqlcmd -No -S localhost -U sa -P '
SA_PASSWORD' -Q "$QUERY"변경사항을 적용하려면 SQL Server 서비스를 다시 시작합니다.
sudo systemctl restart mssql-server.service
SQL Server 서비스가 실행 중인지 확인합니다.
sudo systemctl status mssql-server --no-pager
TempDB 파일이 생성되었는지 확인합니다.
ls -l /mssql/db_temp/
SQL Server 서비스를 중지하고 일시적으로 사용 중지합니다.
sudo systemctl stop mssql-server.service
sudo systemctl disable mssql-server.service
두 노드에서 SQL Server에 동일한 키를 사용하도록 하려면
node-1에서 머신 키 파일을 다운로드합니다.sudo rm /var/opt/mssql/secrets/machine-key sudo gcloud storage cp gs://
BUCKET_NAME/machine-key /var/opt/mssql/secrets/machine-key sudo chown mssql:mssql /var/opt/mssql/secrets/machine-key sudo chmod 0600 /var/opt/mssql/secrets/machine-keyLVM 설정을 구성합니다.
기존 구성을 백업합니다.
sudo cp /etc/lvm/lvm.conf /etc/lvm/lvm.conf.bak
시스템 ID 소스를 업데이트합니다.
sudo sed -i 's/^\(\s*system_id_source\s*=\s*\)"none"/\1"uname"/' /etc/lvm/lvm.conf
다음을 실행하여 변경사항을 확인합니다.
cat /etc/lvm/lvm.conf | grep uname
출력은 다음과 비슷하게 표시됩니다.
#     Set the system ID from the hostname (uname) of the system.
system_id_source = "uname"
변경사항이 적용되었는지 확인합니다.
grep 'system_id_source *= *"uname"' /etc/lvm/lvm.conf
hacluster의 새 비밀번호를 설정합니다.sudo passwd hacluster
설정을 완료하고 네트워크 부하 분산기가 올바르게 설정되었는지 테스트하려면 두 클러스터 노드에
HAProxy tcp listener를 설치하고 구성합니다.HAProxy를 설치합니다.
sudo apt-get install haproxy
Y를 선택하여 설치를 완료합니다.haproxy.cfg파일을 수정합니다.sudo vi /etc/haproxy/haproxy.cfg
haproxy.cfg file의 defaults 섹션에서 mode를tcp로 변경합니다.haproxy.cfg파일 끝에 다음 섹션을 추가합니다.#--------------------------------------------------------------- # Set up health check listener for SQL Server Availability Group #--------------------------------------------------------------- listen healthcheck bind *:60008
HAProxy 서비스를 시작합니다.
sudo systemctl start haproxy.service
sudo systemctl status haproxy.service
HAProxy 서비스를 중지하고 사용 중지합니다.
sudo systemctl stop haproxy.service
sudo systemctl disable haproxy.service
기존 기본 클러스터 구성 정리
sudo pcs cluster destroy
클러스터 구성 완료
node-1로 돌아가 클러스터 구성을 계속합니다.
hacluster사용자로 인증합니다.sudo pcs host auth node-1 node-2 -u hacluster -p "
HA_PASSWORD"ubuntu_fci라는 클러스터를 만듭니다.sudo pcs cluster setup ubuntu_fci node-1 addr="
NODE1_INTERNAL_IP" node-2 addr="NODE2_INTERNAL_IP" --start --enable2노드 클러스터의 no-quorum-policy를 설정합니다.
sudo pcs property set no-quorum-policy="ignore"
가상 IP 주소 클러스터 리소스를 만듭니다.
sudo pcs resource create pcs-cluster-vip ocf:heartbeat:IPaddr2 ip="
CLUSTER_ADDRESS" cidr_netmask=32 nic=ens3 op monitor interval=30sCLUSTER_ADDRESS를 이전에 예약된 IP 주소로 바꿉니다.모든 공유 볼륨의 클러스터 리소스 객체를 만듭니다.
sudo pcs resource create vgdata ocf:heartbeat:LVM-activate vgname=vgdata vg_access_mode=system_id activation_mode=exclusive
sudo pcs resource create vglogtmp ocf:heartbeat:LVM-activate vgname=vglogtmp vg_access_mode=system_id activation_mode=exclusive
sudo pcs resource create data_dir ocf:heartbeat:Filesystem device="/dev/mapper/vgdata-lvdata" directory="/mssql/db_data" fstype="xfs"
sudo pcs resource create log_dir ocf:heartbeat:Filesystem device="/dev/mapper/vglogtmp-lvlog" directory="/mssql/db_log" fstype="xfs"
sudo pcs resource create tmp_dir ocf:heartbeat:Filesystem device="/dev/mapper/vglogtmp-lvtmp" directory="/mssql/db_temp" fstype="xfs"
리소스 그룹을 만들고 생성된 모든 객체를 새 그룹에 추가합니다.
sudo pcs resource group add sql_group pcs-cluster-vip vgdata vglogtmp data_dir log_dir tmp_dir
Microsoft SQL Server 서비스의 클러스터 리소스를 만들고 기존 리소스 그룹에 추가합니다.
sudo pcs resource create sql_fci ocf:mssql:fci op stop timeout=60s --group sql_group
HAProxy의 클러스터 리소스를 만들고 동일한 그룹에 추가합니다.
sudo pcs resource create pcs-healthcheck systemd:haproxy.service op monitor interval=20s timeout=30s --group sql_group
리소스의 시작 순서를 제어하는 클러스터 제약조건을 만듭니다.
sudo pcs constraint order set pcs-cluster-vip vgdata vglogtmp data_dir log_dir tmp_dir sql_fci pcs-healthcheck
STONITH 펜스 설정
STONITH는 HA 클러스터에서 노드의 무결성을 유지하기 위한 펜싱 전략입니다. STONITH 서비스는 노드 수준에서 작동하며 응답하지 않거나 알 수 없는 상태인 노드로부터 클러스터를 보호합니다. Google Cloud의 Compute Engine에 특화된 fence_gce 펜싱 기기를 사용하는 것이 좋습니다.
펜싱 기기 설정
node-1에 Compute Engine용 펜스 에이전트인fence_gce가 설치되었는지 확인합니다.sudo pcs stonith list | grep fence_gce
자세한 내용은 다음을 참고하세요.
- Google Compute Engine용 펜스 에이전트
에이전트와 연결된 매개변수를 확인하려면 다음 명령어를 실행합니다.
sudo pcs stonith describe fence_gce
클러스터 펜싱 리소스를 구성합니다.
sudo pcs stonith create node-1-fence fence_gce \ plug=node-1 \ zone=
ZONE1\ project=PROJECT_ID\ pcmk_reboot_timeout=300 pcmk_monitor_retries=4 pcmk_delay_max=30 \ op monitor interval="300s" timeout="120s" \ op start interval="0" timeout="60s" sudo pcs stonith create node-2-fence fence_gce \ plug=node-2 \ zone=ZONE2\ project=PROJECT_ID\ pcmk_reboot_timeout=300 pcmk_monitor_retries=4 pcmk_delay_max=30 \ op monitor interval="300s" timeout="120s" \ op start interval="0" timeout="60s"ZONE1및ZONE2을 Linux VM이 배포된 영역으로 바꾸고PROJECT_ID을 프로젝트 ID로 바꿉니다.상태 명령어를 실행하여 펜싱 에이전트의 상태를 테스트할 수 있습니다.
sudo fence_gce -o status -n node-1 --zone=
ZONE1sudo fence_gce -o status -n node-2 --zone=ZONE2출력은 다음과 비슷하게 표시됩니다.
Status: ON
ZONE1 및 ZONE2을 Linux VM이 배포된 영역으로 바꿉니다.
펜싱 기기가 정해진 인스턴스에서만 실행되도록 하는 위치 제약조건을 만듭니다.
sudo pcs constraint location node-1-fence avoids node-1
sudo pcs constraint location node-2-fence avoids node-2
Pacemaker 클러스터에서 펜싱을 사용 설정하고 클러스터 펜싱 제한 시간을 설정합니다.
sudo pcs -f stonith_cfg property set stonith-enabled=true
sudo pcs property set stonith-timeout="300s"
클러스터 시작 프로세스 정리
sudo pcs resource cleanup
클러스터의 상태를 확인합니다.
sudo crm status
출력은 다음과 비슷하게 표시됩니다.
  Cluster Summary:
    * Stack: corosync
    * Current DC: node-1 (version 2.1.2-ada5c3b36e2) - partition with quorum
    * Last updated: Tue Jun  2 21:36:47 2026
    * Last change:  Mon Apr 27 12:31:58 2026 by root via crm_resource on node-1
    * 2 nodes configured
    * 10 resource instances configured

  Node List:
    * Online: [ node-1 node-2 ]

  Full List of Resources:
    * Resource Group: sql_group:
      * pcs-cluster-vip   (ocf:heartbeat:IPaddr2):         Started node-2
      * vgdata    (ocf:heartbeat:LVM-activate):    Started node-2
      * vglogtmp  (ocf:heartbeat:LVM-activate):    Started node-2
      * data_dir  (ocf:heartbeat:Filesystem):      Started node-2
      * log_dir   (ocf:heartbeat:Filesystem):      Started node-2
      * tmp_dir   (ocf:heartbeat:Filesystem):      Started node-2
      * sql_fci   (ocf:mssql:fci):                 Started node-2
      * pcs-healthcheck   (systemd:haproxy.service):       Started node-2
    * node-1-fence       (stonith:fence_gce):     Started node-2
    * node2-fence        (stonith:fence_gce):     Started node-1
펜싱 기기 테스트
펜싱 기기를 설정한 후에는 다음 단계에 따라 테스트하는 것이 좋습니다.
node-2에서 펜스를 중지합니다.node-1에 연결하고 다음 명령어를 실행하여 클러스터에서node-2와 연결된 펜스 기기를 테스트합니다.fence_gce -o off -n node-2 --zone=
ZONE2출력은 다음과 비슷하게 표시됩니다.
Success: Powered OFF
클러스터의 상태를 확인합니다.
sudo crm status
출력은 다음과 비슷하게 표시됩니다.
    Cluster Summary:
      * Stack: corosync
      * Current DC: node-1 (version 2.1.2-ada5c3b36e2) - partition with quorum
      * Last updated: Tue Jun  2 21:52:00 2026
      * Last change:  Mon Apr 27 12:31:58 2026 by root via crm_resource on node-1
      * 2 nodes configured
      * 10 resource instances configured

    Node List:
      * Online: [ node-1 ]
      * OFFLINE: [ node-2 ]

    Full List of Resources:
      * Resource Group: sql_group:
        * pcs-cluster-vip   (ocf:heartbeat:IPaddr2): Started node-1
        * vgdata    (ocf:heartbeat:LVM-activate):    Started node-1
        * vglogtmp  (ocf:heartbeat:LVM-activate):    Started node-1
        * data_dir  (ocf:heartbeat:Filesystem):      Started node-1
        * log_dir   (ocf:heartbeat:Filesystem):      Started node-1
        * tmp_dir   (ocf:heartbeat:Filesystem):      Started node-1
        * sql_fci   (ocf:mssql:fci):                 Started node-1
        * pcs-healthcheck   (systemd:haproxy.service):       Started node-1
      * node-1-fence       (stonith:fence_gce):     Stopped
      * node-2-fence        (stonith:fence_gce):     Started node-1
또한 Compute Engine에서
node-2가 사용 중지된 것을 확인할 수 있습니다.
node-2에서 펜스를 다시 시작합니다.node-1로 돌아가서 다음 명령어를 실행하여 인스턴스를 다시 시작합니다.fence_gce -o on -n node-2 --zone=
ZONE2출력은 다음과 비슷하게 표시됩니다.
Success: Powered ON
Pacemaker 및 Compute Engine에서 클러스터 상태를 확인합니다. 잠시 후
node-2가 다시 온라인 상태가 되는 것을 확인할 수 있습니다.$ sudo crm status
장애 조치 테스트
이제 장애 조치가 예상대로 작동하는지 테스트할 수 있습니다.
- VM 인스턴스에 대해 사용자 이름과 비밀번호를 만듭니다.
- 원격 데스크톱을 사용하여 VM에 연결하고 이전 단계에서 만든 사용자 이름과 비밀번호를 사용하여 로그인합니다.
- 원격 데스크톱을 통해
cl-node의 Windows VM에 연결합니다. - PowerShell 세션을 엽니다.
다음 스크립트를 실행하여 서버에 연결합니다. 스크립트는 5초마다 가용성 그룹 리스너를 사용하여 SQL Server에 연결하고 서버 이름을 쿼리합니다.
while ($True){ try { $Conn = New-Object System.Data.SqlClient.SqlConnection $Conn.ConnectionString = "Server=CLUSTER_ADDRESS;User ID=sa;Password=SA_PASSWORD;Initial Catalog=master" $Conn.Open() $Cmd = $Conn.CreateCommand() $Cmd.CommandText = "SELECT SERVERPROPERTY('ComputerNamePhysicalNetBIOS')" $Result = $Cmd.ExecuteReader() if ($Result.Read()) { $currentNode = $Result.GetString(0) Write-Host "Current Node: $currentNode at $(Get-Date)" } $Conn.Close() Start-Sleep -Seconds 5 } catch { Write-Host "SQL Connection Failed at $(Get-Date). Retrying..." Start-Sleep -Seconds 15 # Wait before retrying } }CLUSTER_ADDRESS를 리스너 IP 주소로,SA_PASSWORD를 SQL Server의 SA 계정 비밀번호로 바꿉니다.출력은 다음과 비슷하게 표시됩니다.
  Current Node: node-1 at 06/09/2026 20:24:35
  Current Node: node-1 at 06/09/2026 20:24:40
  Current Node: node-1 at 06/09/2026 20:24:45
  Current Node: node-1 at 06/09/2026 20:24:50
  Current Node: node-1 at 06/09/2026 20:24:55
스크립트가 실행되도록 둡니다.
node-2로 장애 조치를 트리거합니다.node-1에서 SSH 터미널로 돌아가 다음 명령어를 실행합니다.sudo pcs resource move sql_group node-2
cl-node의 PowerShell 세션으로 돌아갑니다.- 실행 중인 스크립트의 출력을 관찰하고 장애 조치의 결과로 서버 이름이
node-1에서node-2로 변경되는 것을 확인합니다.
출력은 다음과 비슷하게 표시됩니다.
  Current Node: node-1 at 06/09/2026 20:28:51
  Current Node: node-1 at 06/09/2026 20:28:56
  SQL Connection Failed at 06/09/2026 20:29:16. Retrying...
  Current Node: node-2 at 06/09/2026 20:29:31
  Current Node: node-2 at 06/09/2026 20:29:36
- 실행 중인 스크립트의 출력을 관찰하고 장애 조치의 결과로 서버 이름이
node-1로 장애 복구를 시작합니다. node-1의 명령줄에서 다음 명령어를 실행합니다.sudo pcs resource move sql_group node-1
cl-node의 Powershell로 돌아갑니다.Ctrl+C를 눌러 스크립트를 중지합니다.
삭제
튜토리얼을 완료한 후에는 만든 리소스를 삭제하여 할당량 사용을 중지하고 요금이 청구되지 않도록 할 수 있습니다. 다음 섹션은 이러한 리소스를 삭제하거나 사용 중지하는 방법을 설명합니다.
프로젝트 삭제
비용이 청구되지 않도록 하는 가장 쉬운 방법은 튜토리얼에서 만든 프로젝트를 삭제하는 것입니다.
프로젝트를 삭제하는 방법은 다음과 같습니다.
- Google Cloud 콘솔에서 리소스 관리 페이지로 이동합니다.
- 프로젝트 목록에서 삭제할 프로젝트를 선택하고 삭제를 클릭합니다.
- 대화상자에서 프로젝트 ID를 입력한 후 종료를 클릭하여 프로젝트를 삭제합니다.