


Questo documento descrive i principi e le tecniche per l'implementazione di un flusso di lavoro ripetibile che ti aiuterà a integrare le modifiche ai dati nel tuo data warehouse (DWH) basato su BigQuery. Queste modifiche potrebbero includere nuovi set di dati, nuove origini dati o aggiornamenti e modifiche ai set di dati esistenti. Il documento descrive anche un'architettura di riferimento per questa attività.
Questo documento è rivolto ad architetti di software e dati e data engineer che utilizzano BigQuery come DWH. Il documento presuppone che tu abbia familiarità con i concetti di base di CI/CD o con pratiche di gestione del ciclo di vita delle applicazioni simili.
Introduzione
L'integrazione continua e la distribuzione continua (CI/CD) sono diventate una tecnica essenziale nel ciclo di vita dello sviluppo software. L'adozione dei principi di CI/CD consente ai team di fornire software migliore con meno problemi rispetto all'integrazione delle funzionalità e al loro deployment manuale. CI/CD può anche far parte di una strategia di gestione dei dati quando modernizzi il tuo data warehousing.
Tuttavia, quando lavori con un DWH come BigQuery, esistono differenze nel modo in cui implementi CI/CD rispetto all'implementazione di CI/CD nel codice sorgente. Queste differenze sono in parte dovute al fatto che il data warehousing è un sistema intrinsecamente stateful per la gestione dei dati sottostanti.
Questo documento fornisce le seguenti informazioni:
- Tecniche per l'implementazione di una strategia di integrazione continua (CI) in BigQuery.
- Indicazioni e metodi che ti aiutano a evitare le insidie.
- Suggerimenti per le funzionalità di BigQuery che aiutano con CI;integrazione continua in BigQuery.
Questo documento si concentra sulla CI, perché l'integrazione ha più considerazioni specifiche per i dati per un team di data warehousing rispetto alla distribuzione continua (CD).
Quando utilizzare CI;integrazione continua per un DWH BigQuery
In questo documento, l'integrazione dei dati è un'attività solitamente eseguita dal team DWH, che include l'incorporazione di nuovi dati nel DWH. Questa attività potrebbe comportare l'incorporazione di una nuova origine dati nel DWH o la modifica della struttura di una tabella già presente nel DWH.
L'integrazione di nuovi dati nel DWH è un'attività simile all'integrazione di una nuova funzionalità nel software esistente. Potrebbe introdurre bug e influire negativamente sull'esperienza dell'utente finale. Quando integri i dati in BigQuery, i consumer dei dati downstream (ad esempio applicazioni, dashboard BI e singoli utenti) potrebbero riscontrare problemi dovuti a mancate corrispondenze degli schemi. In alternativa, i consumer potrebbero utilizzare dati errati che non riflettono i dati dell'origine dati originale.
CI per DWH è utile quando vuoi:
- Descrivere i punti chiave della CI per un sistema DWH.
- Progetta e implementa una strategia di CI per il tuo ambiente BigQuery.
- Scopri come utilizzare le funzionalità di BigQuery per implementare la CI.
Questa guida non descrive come gestire la CI per i prodotti non DWH, inclusi i prodotti di dati come Dataflow e Bigtable.
Scenario di esempio
Example Company è una grande azienda di vendita al dettaglio che gestisce il proprio DWH in BigQuery. Nel prossimo anno, l'azienda vuole integrare nel suo DWH nuove origini dati provenienti da aziende acquisite di recente da Example Company. Le nuove origini dati da integrare hanno schemi diversi. Tuttavia, il DWH deve mantenere lo schema esistente e fornire una forte coerenza e completezza dei dati, in modo che i consumer di dati a valle non subiscano conseguenze negative.
Attualmente, il team DWH di Example Company esegue l'integrazione dei dati. L'integrazione si basa sulla presenza delle origini dati esistenti in uno schema predefinito. Questo workflow prevede processi di importazione dei dati legacy, database acquisiti e servizi delle applicazioni.
Per aggiornare i processi di integrazione dei dati in modo da adattarli alle nuove origini dati, il team DWH deve riprogettare il proprio approccio all'integrazione dei dati per soddisfare i requisiti indicati in precedenza, come la forte coerenza dei dati. Il team deve implementare le modifiche in modo isolato, in modo che le modifiche ai dati possano essere testate e misurate prima che i dati vengano resi disponibili ai consumatori downstream.
Dopo aver adottato il nuovo flusso di lavoro, il team DWH ha un processo ripetibile. Ogni sviluppatore può creare un ambiente di sviluppo isolato basato sui dati di produzione. Utilizzando questi ambienti isolati, gli sviluppatori possono quindi apportare modifiche, testarle, farle esaminare e fornire le modifiche richieste all'ambiente di produzione. Se le modifiche causano bug o problemi imprevisti, è possibile eseguirne facilmente il rollback.
Cosa significa integrazione continua per un DWH
L'integrazione continua (CI) è un insieme di pratiche che consente ai team di sviluppo di abbreviare i cicli di sviluppo e di trovare i problemi nel codice più velocemente rispetto ai sistemi manuali. Il vantaggio principale dell'adozione di un approccio CI è la possibilità di sviluppare rapidamente, riducendo i rischi di interferenza tra gli sviluppatori. Questo obiettivo viene raggiunto assicurandosi che il processo sia ripetibile, consentendo al contempo a ogni sviluppatore di lavorare in isolamento dagli altri sviluppatori.
Questi principi si applicano anche quando un'organizzazione deve integrare i dati in un DWH, con alcune differenze. Nel contesto del tipico sviluppo software, la CI isola le modifiche al codice sorgente, che è stateless. Nel contesto della CI nei dati, la CI integra i dati in un sistema DWH. Tuttavia, i dati sono stateful per definizione. Questa differenza ha implicazioni sul modo in cui l'CI si applica agli scenari DWH, come descritto in questo documento.
Scenari aggiuntivi non trattati in questo documento
Sebbene questo documento si concentri sull'isolamento delle modifiche di sviluppo dall'ambiente di produzione, non copre i seguenti aspetti dell'integrazione dei dati:
- Test dei dati: sei in grado di verificare che i dati in tuo possesso siano conformi ai requisiti aziendali? I dati sono affidabili per fungere da fonte di verità? Per aumentare il livello di affidabilità dei dati che pubblichi dal tuo DWH, è importante testarli. Per eseguire il test, puoi eseguire un insieme di query, verificando che i dati non contengano valori mancanti o che contengano valori "errati".
- Lineage dei dati: riesci a vedere una tabella nel suo contesto? Ad esempio, puoi vedere da dove sono stati raccolti i dati e quali set di dati sono stati precalcolati per generare la tabella? Nelle moderne architetture DWH, i dati sono suddivisi in molti sistemi che utilizzano strutture di dati diverse e specializzate. Questi includono database relazionali, database NoSQL e origini dati esterne. Per comprendere appieno i dati di cui disponi, devi tenerne traccia. Devi anche capire come e da dove sono stati generati i dati.
Questi argomenti non rientrano nell'ambito di questa guida. Tuttavia, la tua strategia per i dati trarrà vantaggio dalla pianificazione di questi argomenti durante la progettazione di un flusso di lavoro per il tuo team.
Configurazione tipica di BigQuery come DWH
Il seguente diagramma illustra un tipico design di DWH per BigQuery. Mostra come i dati provenienti da origini esterne vengono importati nel DWH e come i consumatori utilizzano i dati del DWH.

I dati iniziano nelle origini dati, dove si trovano in database transazionali o a bassa latenza convenzionali, come i database SQL OLTP e i database NoSQL. Un processo pianificato copia i dati in un'area di gestione temporanea.
I dati vengono archiviati temporaneamente nell'area di gestione temporanea. Se necessario, i dati vengono trasformati per adattarsi a un sistema analitico prima di essere caricati nelle tabelle del DWH. (In questo diagramma, l'area di gestione temporanea si trova all'interno di Google Cloud, ma non è necessario che sia così). Le trasformazioni potrebbero includere la denormalizzazione, l'arricchimento di determinati set di dati o la gestione di voci con formato non corretto (ad esempio, voci con valori mancanti).
Dall'area di gestione temporanea, i nuovi dati vengono caricati nelle tabelle del DWH. Le tabelle potrebbero essere organizzate in modi diversi a seconda del design del DWH e sono solitamente chiamate tabelle principali. Alcuni esempi di paradigmi di progettazione delle tabelle includono il paradigma dello schema a stella, il paradigma denormalizzato e gli aggregati multilivello.
Indipendentemente dal design della tabella, queste tabelle salvano i dati nel tempo. Le tabelle devono rispettare lo schema e si presume che contengano la fonte di verità per tutti gli scopi analitici. Questo ruolo per le tabelle significa che i dati in queste tabelle devono essere completi, coerenti e conformi agli schemi predefiniti.
Queste tabelle non forniscono dati direttamente ai consumatori. I dati vengono invece forniti tramite un livello di accesso, progettato per incapsulare la logica di business che deve essere applicata ai dati sottostanti. Esempi di questo tipo di logica di business sono il calcolo di una metrica per ogni record o il filtro e il raggruppamento dei dati.
I consumer dei dati possono connettersi e leggere i dati dal livello di accesso al DWH. Questi consumer di dati potrebbero includere sistemi come i seguenti:
- Dashboard di business intelligence (BI)
- Notebook di data science
- Sistemi operativi che si basano sui dati calcolati nel DWH
- Utenti umani per query ad hoc
I consumer di dati fanno molto affidamento sul DWH per fornire schemi coerenti e sulla logica di business che il DWH incapsula. Questi schemi e la logica di business possono essere considerati come gli accordi sul livello del servizio (SLA) della piattaforma DWH. Qualsiasi modifica alla logica di business, allo schema o alla completezza dei dati potrebbe avere implicazioni significative a valle. Data la natura in continua evoluzione delle moderne piattaforme di dati, il team DWH potrebbe dover apportare queste modifiche, pur rispettando rigorosamente gli SLA. Per consentire al team di rispettare questi SLA e mantenere aggiornato il DWH, è necessario un flusso di lavoro che consenta l'integrazione dei dati riducendo al minimo l'attrito che queste modifiche potrebbero creare.
Asset per l'integrazione continua in un DWH
Come qualsiasi altro team di sviluppo o IT, il team DWH deve gestire gli asset essenziali per le proprie responsabilità. In genere, questi asset possono essere suddivisi nelle seguenti categorie:
La codebase per le pipeline di dati: questi asset di solito sono costituiti da codice sorgente in un linguaggio di programmazione di alto livello come Python o Java. Per questi tipi di asset, i processi CI/CD vengono creati utilizzando strumenti come Git e Jenkins o soluzioniGoogle Cloud come Cloud Source Repositories e Cloud Build.
Script SQL: questi asset descrivono la struttura e la logica di business incapsulate all'interno del DWH. All'interno di questa categoria, gli asset possono essere ulteriormente suddivisi nelle seguenti sottocategorie:
- Data Definition Language (DDL): questi asset vengono utilizzati per definire lo schema di tabelle e viste.
- Data Manipulation Language (DML): questi asset vengono utilizzati per manipolare i dati all'interno di una tabella. I comandi DML vengono utilizzati anche per creare nuove tabelle basate su tabelle esistenti.
- Data Control Language (DCL): questi asset vengono utilizzati per controllare le autorizzazioni e l'accesso alle tabelle. In BigQuery, puoi controllare l'accesso utilizzando SQL e lo strumento a riga di comando
bqo l'API REST BigQuery. Tuttavia, ti consigliamo di utilizzare IAM.
Questi asset e altri, come gli script Terraform utilizzati per creare i componenti, vengono gestiti all'interno dei repository di codice. Strumenti come Dataform possono aiutarti a creare una pipeline CI/CD che convalida gli script SQL e controlla le regole di convalida predefinite sulle tabelle create dagli script DDL. Questi strumenti ti consentono di applicare processi di compilazione e test per SQL, che nella maggior parte dei contesti non dispone di un ambiente di test naturale.
Oltre agli asset associati a strumenti e processi, l'asset principale di un team DWH sono i dati. I dati non sono tracciabili utilizzando sistemi di monitoraggio degli asset come Git, progettato per monitorare il codice sorgente. Questo documento affronta i problemi associati al monitoraggio dei dati.
Problemi con l'integrazione dei dati
A causa della potenziale complessità delle relazioni tra le tabelle all'interno di un DWH (ad esempio, in uno dei paradigmi di progettazione delle tabelle menzionati in precedenza), mantenere lo stato dei dati di produzione isolato da un ambiente di test è una sfida. Le pratiche standard di sviluppo software non possono essere applicate allo scenario di integrazione dei dati.
La seguente tabella riassume le differenze tra le pratiche per l'integrazione del codice e quelle per l'integrazione dei dati.
| Integrazione del codice | Integrazione dei dati | |
|---|---|---|
| Sviluppo locale | Il codice sorgente è facilmente clonabile grazie alle sue dimensioni relativamente ridotte. In genere, il codice si adatta alla maggior parte delle macchine degli utenti finali (esclusi i casi di monorepository, che hanno altre soluzioni). | La maggior parte delle tabelle di un DWH non può essere inserita in una macchina di sviluppo a causa delle sue dimensioni. |
| Test centralizzati | I diversi stati del codice sorgente vengono clonati in un sistema centrale (un server CI) per essere sottoposti a test automatici. La presenza di stati diversi del codice ti consente di confrontare i risultati tra una versione stabile e una versione di sviluppo. | Creare stati diversi dei dati in un ambiente isolato non è semplice. Lo spostamento dei dati all'esterno del DWH è un'operazione che richiede molto tempo e risorse. Non è pratico farlo con la frequenza necessaria per i test. |
| Versioni precedenti | Durante il processo di rilascio di nuove versioni del software, puoi monitorare le versioni precedenti. Se rilevi un problema in una nuova release, puoi eseguire il rollback a una versione sicura. | L'esecuzione di backup delle tabelle all'interno del DWH è una pratica standard nel caso in cui sia necessario eseguire il rollback. Tuttavia, devi assicurarti che venga eseguito il rollback di tutte le tabelle interessate allo stesso momento. In questo modo, le tabelle correlate sono coerenti tra loro. |
Integra i dati nelle tabelle BigQuery
BigQuery offre due funzionalità che possono aiutarti a progettare un flusso di lavoro per l'integrazione dei dati: snapshot delle tabelle e cloni delle tabelle. Puoi combinare queste funzionalità per ottenere un flusso di lavoro che ti offre un ambiente di sviluppo conveniente. Gli sviluppatori possono manipolare i dati e la loro struttura in modo isolato dall'ambiente di produzione e possono eseguire il rollback di una modifica, se necessario.
Uno snapshot della tabella BigQuery è una rappresentazione di sola lettura di una tabella (chiamata tabella di base) in un determinato momento. Analogamente, un clone di una tabella BigQuery è una rappresentazione di lettura/scrittura di una tabella in un determinato momento. In entrambi i casi, i costi di archiviazione sono ridotti al minimo perché vengono archiviate solo le differenze rispetto alla tabella di base. I cloni di tabella iniziano a generare costi quando la tabella di base o i cloni di tabella cambiano. Poiché gli snapshot delle tabelle sono di sola lettura, comportano costi solo quando la tabella di base cambia.
Per saperne di più sui prezzi degli snapshot e dei cloni delle tabelle, consulta Introduzione agli snapshot delle tabelle e Introduzione ai cloni delle tabelle.
Puoi acquisire snapshot e cloni delle tabelle utilizzando la funzionalità di spostamento cronologico di BigQuery (fino a sette giorni nel passato). Questa funzionalità ti consente di acquisire snapshot e cloni di più tabelle nello stesso momento, in modo che l'ambiente di lavoro e gli snapshot siano coerenti tra loro. L'utilizzo di questa funzionalità può essere utile per le tabelle che vengono aggiornate di frequente.
Come utilizzare i cloni e gli snapshot delle tabelle per consentire l'isolamento
Per illustrare il workflow di integrazione per la CI in un DWH, immagina il seguente scenario. Ti viene assegnata l'attività di integrazione di un nuovo set di dati nel DWH. L'attività potrebbe consistere nella creazione di nuove tabelle DWH, nell'aggiornamento di tabelle esistenti, nella modifica della struttura delle tabelle o in una combinazione di queste attività. Il flusso di lavoro potrebbe essere simile alla seguente sequenza:
- Identifichi le tabelle che potrebbero essere interessate dalle modifiche e altre tabelle che potresti voler controllare.
- Crea un nuovo set di dati BigQuery per contenere gli asset per questa modifica. Questo set di dati aiuta a isolare le modifiche e separa questa attività da altre attività su cui lavorano altri membri del team. Il set di dati deve trovarsi nella stessa regione del set di dati di origine. Tuttavia, il progetto può essere separato dal progetto di produzione per soddisfare i requisiti di sicurezza e fatturazione della tua organizzazione.
Per ogni tabella, crei sia un clone sia uno snapshot nel nuovo set di dati, potenzialmente per lo stesso momento. Questo approccio offre i seguenti vantaggi:
- Il clone della tabella può fungere da copia di lavoro in cui puoi apportare modifiche liberamente senza influire sulla tabella di produzione. Puoi creare più cloni della stessa tabella di base per testare contemporaneamente diversi percorsi di integrazione, con un overhead minimo.
- Lo snapshot può fungere da punto di ripristino e riferimento, un punto in cui è noto che i dati funzionavano prima di qualsiasi modifica. Questo snapshot ti consente di eseguire un rollback nel caso in cui venga rilevato un problema in un secondo momento del processo.
Utilizza i cloni delle tabelle per implementare le modifiche necessarie per le tabelle. Questa azione genera una versione aggiornata dei cloni della tabella, che puoi testare in un set di dati isolato.
Se vuoi, al termine della fase di implementazione, puoi presentare un set di dati che può essere utilizzato per le seguenti attività:
- Test delle unità con uno strumento di convalida come Dataform. I test delle unità sono autonomi, il che significa che l'asset viene testato in isolamento. In questo caso, l'asset è la tabella in BigQuery. I test delle unità possono verificare la presenza di valori null, controllare che tutte le stringhe soddisfino i requisiti di lunghezza e assicurarsi che determinati aggregati producano risultati utili. I test delle unità possono includere qualsiasi test di affidabilità che garantisca che la tabella mantenga le regole aziendali dell'organizzazione.
- Test di integrazione con i consumer downstream.
- Revisione tra pari.
Questo workflow ti consente di eseguire test con i dati di produzione senza influire sui consumer downstream.
Prima di unire i nuovi dati in BigQuery, puoi creare un altro snapshot. Questo snapshot è utile come ulteriore opzione di rollback nel caso in cui i dati nella tabella di base siano stati modificati.
Il processo di unione delle modifiche dipende dal processo che la tua organizzazione vuole adottare e dalle modifiche richieste. Ad esempio, per una modifica agli script SQL, il nuovo set di dati potrebbe essere accompagnato da una richiesta di pull alla codebase standard. Se la modifica è limitata a una modifica dei dati all'interno di una determinata tabella, puoi semplicemente copiare i dati utilizzando i metodi standard di BigQuery.
Puoi utilizzare uno script di stored procedure per incapsulare e automatizzare i passaggi per la creazione di un set di dati e la creazione di cloni e snapshot. L'automazione di queste attività riduce il rischio di errori umani. Per un esempio di script che può aiutarti ad automatizzare i processi, consulta il repository GitHub CI for Data in BigQuery CLI utility.
Vantaggi dell'utilizzo di cloni e snapshot delle tabelle
Quando utilizzi il flusso di lavoro descritto nella sezione precedente, i tuoi sviluppatori possono lavorare in modo isolato e in parallelo, senza interferire con i colleghi. Gli sviluppatori possono testare ed esaminare le modifiche e, se si verifica un problema, eseguire il rollback delle modifiche. Poiché lavori con snapshot di tabelle e non con tabelle complete, puoi ridurre al minimo i costi e lo spazio di archiviazione rispetto all'utilizzo di tabelle complete.
Questa sezione fornisce maggiori dettagli su come gli snapshot e i cloni delle tabelle consentono agli sviluppatori di ottenere questo flusso di lavoro. Il seguente diagramma mostra la relazione tra gli snapshot e i cloni delle tabelle e i dati nel set di dati di produzione.
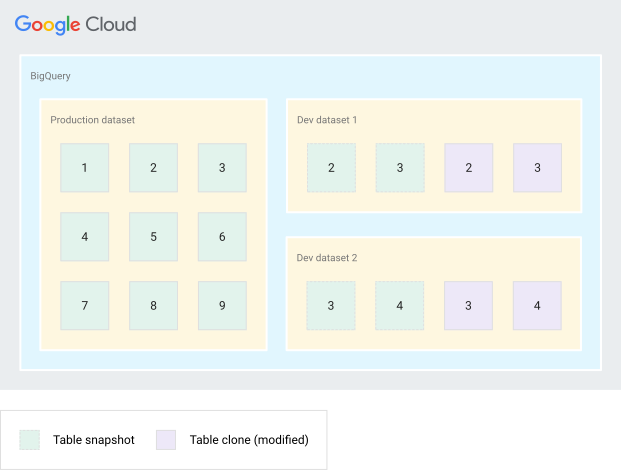
Nel diagramma, il set di dati di produzione contiene tutte le tabelle utilizzate in produzione. Ogni sviluppatore può creare un set di dati per il proprio ambiente di sviluppo. Il diagramma mostra due set di dati per sviluppatori, etichettati come Set di dati per sviluppatori 1 e Set di dati per sviluppatori 2. Utilizzando questi set di dati per gli sviluppatori, questi ultimi possono lavorare contemporaneamente sulle stesse tabelle senza interferire l'uno con l'altro.
Dopo aver creato un set di dati, gli sviluppatori possono creare cloni e snapshot delle tabelle su cui stanno lavorando. I cloni e gli snapshot rappresentano i dati in un momento specifico. A questo punto, gli sviluppatori sono liberi di modificare i cloni della tabella, perché le modifiche non sono visibili nella tabella di base.
Uno sviluppatore può esaminare i cloni delle tabelle, confrontarli con lo snapshot e testarli per verificarne la compatibilità con i consumer downstream. Altri sviluppatori possono lavorare con altri cloni e snapshot, senza interferenze e senza creare troppe copie della tabella di base che consumano risorse.
Gli sviluppatori possono unire le modifiche alla tabella di base mantenendo lo snapshot sicuro da utilizzare come opzione di rollback, se necessario. Questo processo può essere ripetuto anche per ambienti diversi, come sviluppo, test e produzione.
Alternative ai cloni e agli snapshot delle tabelle
Esistono alternative all'utilizzo di cloni e snapshot di tabelle che ti consentono di ottenere un risultato simile. Questi metodi alternativi vengono in genere utilizzati in modo diverso rispetto ai cloni e agli snapshot. È importante comprendere le differenze tra questi metodi e quando potresti preferire un metodo rispetto all'altro.
Copia intere tabelle in un set di dati diverso
Un metodo alternativo consiste nell'utilizzare un set di dati diverso e copiare le tabelle in quel set di dati. L'utilizzo di questo metodo è simile all'utilizzo di cloni e snapshot di tabelle, ma copi l'intero set di tabelle. A seconda delle dimensioni dei dati copiati, i costi di archiviazione potrebbero essere elevati. Alcune organizzazioni utilizzavano questo metodo prima che i cloni delle tabelle diventassero disponibili in BigQuery. Tuttavia, questo metodo non presenta vantaggi rispetto all'utilizzo di cloni e snapshot.
Esporta e importa tabelle in Cloud Storage
Un altro metodo alternativo consiste nello spostare i dati tramite Cloud Storage. Questo metodo è simile anche all'utilizzo di cloni e snapshot delle tabelle. Tuttavia, include il passaggio aggiuntivo di esportazione dei dati in un bucket Cloud Storage. Un vantaggio di questo metodo è che ti offre un backup aggiuntivo dei tuoi dati. Puoi scegliere questo metodo se vuoi un backup per ripristino di emergenza o per soluzioni ibride.
Utilizza BigQuery sharing
BigQuery sharing (in precedenza Analytics Hub) consente di condividere i set di dati sia all'esterno che all'interno dell'organizzazione in modo sicuro. Offre molte funzionalità che ti consentono di pubblicare set di dati per fornire agli iscritti un accesso controllato di sola lettura a questi set di dati. Tuttavia, anche se puoi utilizzare BigQuery sharing per esporre i set di dati per implementare le modifiche, uno sviluppatore deve comunque creare cloni di tabelle per lavorare con le tabelle.
Riepilogo delle opzioni di integrazione continua del DWH
La seguente tabella riassume le differenze, i vantaggi e i potenziali svantaggi tra le opzioni per l'integrazione continua del DWH. (La condivisione offre un insieme di funzionalità diverso e, pertanto, non è misurabile utilizzando i parametri elencati nella tabella).
| Costi | Rollback | Rischi | |
|---|---|---|---|
| Snapshot e cloni delle tabelle | Minima. Paghi solo la differenza tra lo snapshot o il clone e la tabella di base. | Lo snapshot funge da backup per il rollback, se necessario. | Sei tu a controllare il livello di rischio. È possibile acquisire snapshot in un determinato momento per tutte le tabelle, il che riduce le incoerenze anche in caso di rollback. |
| Copia tabella | Costi più elevati rispetto all'utilizzo di snapshot e cloni delle tabelle. La totalità dei dati viene duplicata. Per supportare i rollback, devi avere più copie della stessa tabella. | Possibile, ma richiede due copie della tabella: una copia da utilizzare come backup e una copia da utilizzare per apportare modifiche. | La clonazione è più difficile da eseguire per un momento specifico. Se è necessario un rollback, non tutte le tabelle vengono prese dallo stesso momento. |
| Esporta e importa | Costi più elevati rispetto all'utilizzo di snapshot e cloni delle tabelle. I dati sono duplicati. Per supportare il rollback, sono necessarie più copie della stessa tabella. | I dati esportati fungono da backup. | I dati esportati non sono un'esportazione point-in-time per più tabelle. |
Passaggi successivi
- Scopri di più sugli snapshot delle tabelle BigQuery in Introduzione agli snapshot delle tabelle.
- Scopri di più sull'integrazione continua per lo sviluppo software in Tecnologia DevOps: integrazione continua.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.