


במסמך הזה מתוארים עקרונות ושיטות להטמעת תהליך עבודה שניתן לחזור עליו, שיעזור לכם לשלב שינויים בנתונים במחסן הנתונים (DWH) שמבוסס על BigQuery. השינויים האלה יכולים לכלול קבוצות נתונים חדשות, מקורות נתונים חדשים או עדכונים ושינויים בקבוצות נתונים קיימות. במסמך מתוארת גם ארכיטקטורה לדוגמה למשימה הזו.
המאמר הזה מיועד לאדריכלי תוכנה ונתונים ולמהנדסי נתונים שמשתמשים ב-BigQuery כמחסן נתונים. ההנחה במסמך היא שאתם מכירים את המושגים הבסיסיים של CI/CD או שיטות דומות לניהול מחזור החיים של אפליקציות.
מבוא
אינטגרציה רציפה (CI) ופיתוח רציף (CD) הפכו לטכניקה חיונית במחזור החיים של פיתוח התוכנה. אימוץ העקרונות של CI/CD מאפשר לצוותים לספק תוכנה טובה יותר עם פחות בעיות, בהשוואה לשילוב תכונות ופריסה שלהן באופן ידני. CI/CD יכול להיות גם חלק מאסטרטגיה לניהול נתונים כשאתם משדרגים את מחסן הנתונים שלכם.
עם זאת, כשעובדים עם מחסן נתונים כמו BigQuery, יש הבדלים בין הטמעת CI/CD לבין הטמעת CI/CD בקוד מקור. ההבדלים האלה נובעים בין השאר מכך שמחסן נתונים הוא מערכת עם מצב (stateful) לניהול הנתונים הבסיסיים.
במסמך הזה מפורטים הנושאים הבאים:
- שיטות להטמעת אסטרטגיית אינטגרציה רציפה (CI) ב-BigQuery.
- הנחיות ושיטות שיעזרו לכם להימנע מטעויות.
- הצעות לתכונות של BigQuery שעוזרות ב-CI ב-BigQuery.
המסמך הזה מתמקד ב-CI, כי לאינטגרציה יש יותר שיקולים ספציפיים לנתונים עבור צוות מחסן נתונים מאשר לפיתוח רציף (CD).
מתי להשתמש ב-CI למחסן נתונים ב-BigQuery
במסמך הזה, שילוב נתונים הוא משימה שבדרך כלל מבוצעת על ידי צוות ה-DWH, וכוללת שילוב של נתונים חדשים ב-DWH. המשימה הזו יכולה לכלול שילוב של מקור נתונים חדש ב-DWH, או שינוי המבנה של טבלה שכבר נמצאת ב-DWH.
שילוב נתונים חדשים ב-DWH הוא משימה שדומה לשילוב תכונה חדשה בתוכנה קיימת. הוא עלול לגרום לבאגים ולפגוע בחוויית המשתמש. כשמשלבים נתונים ב-BigQuery, צרכני נתונים במורד הזרם (לדוגמה, אפליקציות, לוחות בקרה של BI ומשתמשים ספציפיים) עלולים להיתקל בבעיות בגלל חוסר התאמה בסכימה. או שהצרכנים עלולים להשתמש בנתונים שגויים שלא משקפים את הנתונים ממקור הנתונים המקורי.
כדאי להשתמש ב-CI למחסן נתונים כשרוצים:
- לתאר את הנקודות העיקריות ב-CI למערכת DWH.
- תכנון והטמעה של אסטרטגיית CI לסביבת BigQuery.
- איך משתמשים בתכונות של BigQuery כדי להטמיע CI.
המדריך הזה לא מתאר איך לנהל CI למוצרים שאינם DWH, כולל מוצרי נתונים כמו Dataflow ו-Bigtable.
מקרה לדוגמה
"חברה לדוגמה" היא חברה קמעונאית גדולה שמנהלת את מחסן הנתונים שלה ב-BigQuery. בשנה הקרובה, החברה רוצה לשלב במחסן הנתונים שלה מקורות נתונים חדשים מחברות שנרכשו לאחרונה על ידי Example Company. למקורות הנתונים החדשים שרוצים לשלב יש סכימות שונות. עם זאת, מחסן הנתונים חייב לשמור על הסכימה הקיימת שלו ולספק עקביות ושלמות נתונים חזקות, כדי שהצרכנים של הנתונים במורד הזרם לא יושפעו לרעה.
נכון לעכשיו, צוות ה-DWH של Example Company מבצע שילוב נתונים. השילוב מתבסס על כך שמקורות הנתונים הקיימים נמצאים בסכימה מוגדרת מראש. תהליך העבודה הזה כולל תהליכים קודמים של ייבוא נתונים, מסדי נתונים שנרכשו ושירותי אפליקציות.
כדי לעדכן את תהליכי שילוב הנתונים כך שיתאימו למקורות הנתונים החדשים, צוות ה-DWH צריך לתכנן מחדש את הגישה שלו לשילוב נתונים, כך שתעמוד בדרישות שצוינו קודם, כמו עקביות חזקה של נתונים. הצוות צריך להטמיע את השינויים בצורה מבודדת, כדי שיהיה אפשר לבדוק ולמדוד את השינויים בנתונים לפני שהם יהיו זמינים לצרכנים בהמשך.
אחרי שצוות ה-DWH מאמץ את תהליך העבודה החדש, יש לו תהליך שניתן לחזור עליו. כל מפתח יכול ליצור סביבת פיתוח מבודדת שמבוססת על נתוני ייצור. בסביבות המבודדות האלה, המפתחים יכולים לבצע שינויים, לבדוק אותם, לשלוח אותם לבדיקה ולהעביר את השינויים הנדרשים לסביבת הייצור. אם השינויים גורמים לבאגים או לבעיות בלתי צפויות, אפשר לבטל אותם בקלות.
מה המשמעות של אינטגרציה רציפה (CI) במחסן נתונים (DWH)
אינטגרציה רציפה (CI) היא קבוצה של שיטות עבודה שמאפשרות לצוותי פיתוח לקצר את מחזורי הפיתוח ולמצוא בעיות בקוד מהר יותר מאשר במערכות ידניות. היתרון העיקרי של גישת CI הוא היכולת לפתח במהירות, תוך צמצום הסיכונים להפרעות בין המפתחים. כדי להשיג את המטרה הזו, צריך לוודא שאפשר לחזור על התהליך, ולאפשר לכל מפתח לעבוד בנפרד ממפתחים אחרים.
העקרונות האלה חלים גם כשארגון צריך לשלב נתונים ב-DWH, עם כמה הבדלים. בהקשר של פיתוח תוכנה טיפוסי, CI מבודד שינויים בקוד המקור, שהוא חסר מצב (stateless). בהקשר של CI בנתונים, CI משלב נתונים במערכת DWH. עם זאת, נתונים הם בעלי מצב (stateful) בהגדרה. להבדל הזה יש השלכות על האופן שבו CI חל על תרחישים של DWH, כפי שמתואר במאמר הזה.
תרחישים נוספים שלא מפורטים במסמך הזה
למרות שהמסמך הזה מתמקד בבידוד של שינויי פיתוח מסביבת הייצור, הוא לא עוסק בהיבטים הבאים של שילוב נתונים:
- בדיקת נתונים: האם אתם יכולים לוודא שהנתונים שברשותכם תואמים לדרישות העסקיות? האם הנתונים אמינים מספיק כדי לשמש כמקור אמין? כדי להגביר את רמת האמון בנתונים שאתם מציגים ממחסן הנתונים, חשוב לבדוק את הנתונים. כדי לבדוק, אפשר להריץ קבוצה של שאילתות, ולוודא שבנתונים לא חסרים ערכים או שהם מכילים ערכים "שגויים".
- שושלת נתונים: האם אתם יכולים לראות כל טבלה בהקשר שלה? לדוגמה, האם אתם יכולים לראות מהיכן נאספו הנתונים ואילו מערכי נתונים חושבו מראש כדי ליצור את הטבלה? בארכיטקטורות מודרניות של מחסני נתונים, הנתונים מפוצלים להרבה מערכות שמשתמשות במבני נתונים שונים וייעודיים. הם כוללים מסדי נתונים רלציוניים, מסדי נתונים NoSQL ומקורות נתונים חיצוניים. כדי להבין את הנתונים שיש לכם, אתם צריכים לעקוב אחריהם. אתם צריכים גם להבין איך הנתונים נוצרו ומאיפה הם נוצרו.
הנושאים האלה לא נכללים במדריך הזה. עם זאת, כדאי לתכנן את הנושאים האלה כשאתם מתכננים תהליך עבודה לצוות, כדי לשפר את אסטרטגיית הנתונים שלכם.
הגדרה אופיינית של BigQuery כמחסן נתונים (DWH)
התרשים הבא ממחיש עיצוב אופייני של מחסן נתונים ב-BigQuery. הוא מראה איך נתונים ממקורות חיצוניים נקלטים במחסן הנתונים, ואיך הצרכנים צורכים נתונים ממחסן הנתונים.
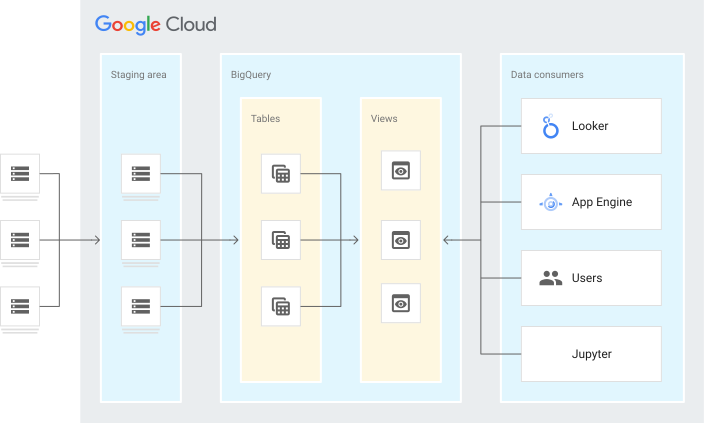
הנתונים מתחילים במקורות הנתונים, שבהם הנתונים נמצאים במסדי נתונים רגילים של טרנזקציות או של זמן אחזור קצר, כמו מסדי נתונים של OLTP SQL ומסדי נתונים של NoSQL. תהליך מתוזמן מעתיק את הנתונים לסביבת Staging.
הנתונים מאוחסנים באופן זמני בסביבת ה-Staging. במקרה הצורך, הנתונים עוברים טרנספורמציה כדי להתאים למערכת אנליטית לפני שהם נטענים לטבלאות של מחסן הנתונים. (בדיאגרמה הזו, סביבת ה-Staging נמצאת בתוך Google Cloud, אבל זה לא חובה). הטרנספורמציות יכולות לכלול דה-נורמליזציה, העשרה של מערכי נתונים מסוימים או טיפול ברשומות פגומות (לדוגמה, רשומות עם ערכים חסרים).
מסביבת ה-Staging, הנתונים החדשים נטענים לטבלאות של מחסן הנתונים. הטבלאות יכולות להיות מאורגנות בדרכים שונות בהתאם לעיצוב של ה-DWH, ובדרך כלל הן נקראות טבלאות ליבה. דוגמאות לפרדיגמות של עיצוב טבלאות: סכימת כוכב, דנורמליזציה וצבירה בכמה רמות.
לא משנה מה עיצוב הטבלה, הטבלאות האלה שומרות נתונים לאורך זמן. הטבלאות חייבות להתאים לסכימה, והן נחשבות למקור האמת לכל מטרות הניתוח. התפקיד הזה של הטבלאות אומר שהנתונים בטבלאות האלה חייבים להיות מלאים, עקביים ולעמוד בסכימות שהוגדרו מראש.
הטבלאות האלה לא מציגות נתונים ישירות לצרכנים. במקום זאת, הנתונים מוצגים דרך שכבת גישה, שנועדה להכיל את הלוגיקה העסקית שצריך להחיל על הנתונים הבסיסיים. דוגמאות לסוג כזה של לוגיקה עסקית הן חישוב מדד לכל רשומה, או סינון וקיבוץ של הנתונים.
צרכני הנתונים יכולים להתחבר לשכבת הגישה של מחסן הנתונים ולקרוא ממנה נתונים. צרכני הנתונים האלה יכולים לכלול מערכות כמו:
- מרכזי בקרה של בינה עסקית (BI)
- תיקיות Notebook של מדע הנתונים
- מערכות תפעוליות שמסתמכות על נתונים שמחושבים ב-DWH
- משתמשים אנושיים לשאילתות אד-הוק
צרכני הנתונים מסתמכים מאוד על ה-DWH כדי לספק סכימות עקביות ועל הלוגיקה העסקית שה-DWH כולל. אפשר להתייחס לסכימות וללוגיקה העסקית האלה כאל הסכמי רמת השירות (SLA) של פלטפורמת ה-DWH. כל שינוי בלוגיקה העסקית, בסכימה או בשלמות הנתונים עלול להשפיע באופן משמעותי על השלבים הבאים. בגלל האופי המשתנה של פלטפורמות הנתונים המודרניות, יכול להיות שצוות ה-DWH יידרש לבצע את השינויים האלה, אבל עדיין להקפיד על עמידה בהסכמי ה-SLA. כדי שהצוות יעמוד בהסכמי ה-SLA האלה וגם יעדכן את ה-DWH, הוא צריך תהליך עבודה שמאפשר שילוב נתונים תוך צמצום החיכוך שהשינויים האלה עלולים ליצור.
נכסים לאינטגרציה רציפה (CI) במחסן נתונים (DWH)
כמו כל צוות פיתוח או IT אחר, צוות ה-DWH צריך לתחזק נכסים שחיוניים לתחומי האחריות שלו. בדרך כלל אפשר לחלק את הנכסים האלה לקטגוריות הבאות:
בסיס הקוד של פייפליינים: הנכסים האלה בדרך כלל מורכבים מקוד מקור בשפת תכנות ברמה גבוהה, כמו Python או Java. לסוגי הנכסים האלה, תהליכי ה-CI/CD נוצרים באמצעות כלים כמו Git ו-Jenkins, או באמצעות פתרונות שלGoogle Cloud כמו Cloud Source Repositories ו-Cloud Build.
סקריפטים של SQL: הנכסים האלה מתארים את המבנה ואת הלוגיקה העסקית שכלולים ב-DWH. בקטגוריה הזו, אפשר לחלק את הנכסים לקטגוריות המשנה הבאות:
- שפת הגדרת נתונים (DDL): הנכסים האלה משמשים להגדרת הסכימה של הטבלאות והתצוגות.
- שפת טיפול בנתונים (DML): הנכסים האלה משמשים לטיפול בנתונים בתוך טבלה. פקודות DML משמשות גם ליצירת טבלאות חדשות על סמך טבלאות קיימות.
- שפת בקרת נתונים (DCL): נכסים שמשמשים לשליטה בהרשאות ובגישה לטבלאות. ב-BigQuery, אתם יכולים לשלוט בגישה באמצעות SQL וכלי שורת הפקודה
bq, או באמצעות BigQuery API בארכיטקטורת REST. עם זאת, מומלץ להשתמש ב-IAM.
הנכסים האלה, ונכסים אחרים כמו סקריפטים של Terraform שמשמשים לבניית רכיבים, מנוהלים בתוך מאגרי המקורות של הקוד. כלים כמו Dataform יכולים לעזור לכם לבנות צינור עיבוד נתונים של CI/CD שמאמת את הסקריפטים של SQL ובודק כללי אימות מוגדרים מראש בטבלאות שנוצרו על ידי סקריפטים של DDL. הכלים האלה מאפשרים להחיל תהליכי קומפילציה ובדיקה על SQL, שברוב ההקשרים אין לו סביבת בדיקה טבעית.
בנוסף לנכסים שמשויכים לכלים ולתהליכים, הנכס העיקרי של צוות DWH הוא הנתונים. אי אפשר לעקוב אחרי נתונים באמצעות מערכות למעקב אחרי נכסים כמו Git, שמיועדות למעקב אחרי קוד מקור. במאמר הזה נתייחס לבעיות שקשורות למעקב אחרי נתונים.
בעיות בשילוב נתונים
בגלל המורכבות הפוטנציאלית של קשרי הגומלין בין הטבלאות בתוך מחסן נתונים (לדוגמה, באחת מהפרדיגמות של עיצוב הטבלאות שהוזכרו קודם), קשה לשמור על בידוד של מצב נתוני הייצור מסביבת הבדיקה. אי אפשר ליישם שיטות סטנדרטיות לפיתוח תוכנה בתרחיש של שילוב נתונים.
בטבלה הבאה מפורטים ההבדלים בין השיטות לשילוב קוד לבין השיטות לשילוב נתונים.
| שילוב קוד | שילוב הנתונים | |
|---|---|---|
| פיתוח מקומי | קל לשכפל קוד מקור כי הוא קטן יחסית. בדרך כלל הקוד מתאים לרוב המכונות של משתמשי הקצה (לא כולל מקרים של מונוריפו, שיש להם פתרונות אחרים). | רוב הטבלאות ב-DWH לא מתאימות למחשב פיתוח בגלל הגודל שלהן. |
| בדיקה מרכזית | מצבים שונים של קוד המקור משוכפלים למערכת מרכזית (שרת CI) כדי לעבור בדיקה אוטומטית. מצבים שונים של הקוד מאפשרים להשוות בין התוצאות של גרסה יציבה לבין התוצאות של גרסת פיתוח. | לא פשוט ליצור מצבים שונים של הנתונים בסביבה מבודדת. העברת נתונים אל מחוץ למחסן הנתונים היא פעולה שדורשת הרבה משאבים וזמן. לא מעשי לבצע את זה בתדירות הנדרשת לבדיקה. |
| גירסאות קודמות | במהלך תהליך ההשקה של גרסאות תוכנה חדשות, אתם יכולים לעקוב אחרי גרסאות קודמות. אם אתם מזהים בעיה בגרסה חדשה, אתם יכולים לחזור לגרסה בטוחה. | גיבוי טבלאות בתוך ה-DWH הוא נוהג מקובל למקרה שצריך לבצע חזרה למצב קודם. עם זאת, חשוב לוודא שכל הטבלאות המושפעות יוחזרו לאותה נקודת זמן. כך הטבלאות הקשורות יהיו עקביות זו עם זו. |
שילוב נתונים בטבלאות ב-BigQuery
ב-BigQuery יש שתי תכונות שיכולות לעזור לכם לתכנן תהליך עבודה לשילוב נתונים: תמונות מצב של טבלאות ושיבוטים של טבלאות. אפשר לשלב את התכונות האלה כדי ליצור תהליך עבודה שנותן סביבת פיתוח חסכונית. המפתחים יכולים לשנות את הנתונים ואת המבנה שלהם בנפרד מסביבת הייצור, ולבטל שינויים במקרה הצורך.
תמונת מצב של טבלה ב-BigQuery היא ייצוג לקריאה בלבד של טבלה (שנקראת מסד נתונים טבלאי) בנקודת זמן נתונה. באופן דומה, שיבוט של טבלה ב-BigQuery הוא ייצוג לקריאה ולכתיבה של טבלה בנקודת זמן נתונה. בשני המקרים, עלויות האחסון ממוזערות כי רק ההבדלים ממסד הנתונים הטבלאי מאוחסנים. העלויות של שיבוטי טבלאות מתחילות להצטבר כשמסד הנתונים הטבלאי משתנה או כששיבוטי הטבלאות משתנים. מכיוון שתמונות המצב של מסדי הנתונים הטבלאיים הן לקריאה בלבד, הן צוברות עלויות רק כשהטבלה הבסיסית משתנה.
למידע נוסף על התמחור של קובצי Snapshot ושיבוטים של טבלאות, קראו את המאמרים מבוא לקובצי Snapshot של טבלאות ומבוא לשיבוטים של טבלאות.
אפשר ליצור תמונות מצב ושיבוטים של טבלאות באמצעות התכונה מסע בזמן ב-BigQuery (עד שבעה ימים בעבר). התכונה הזו מאפשרת לצלם תמונות מצב ולשכפל כמה טבלאות באותו זמן, וכך סביבת העבודה ותמונות המצב יהיו עקביות. התכונה הזו יכולה להיות שימושית בטבלאות שמתעדכנות לעיתים קרובות.
איך משתמשים בשיבוטי טבלאות ובתמונות מצב של טבלאות כדי לאפשר בידוד
כדי להמחיש את תהליך העבודה של שילוב CI במחסן נתונים, נתאר את התרחיש הבא. קיבלתם משימה לשלב קבוצת נתונים חדשה במחסן הנתונים. המשימה יכולה להיות יצירת טבלאות DWH חדשות, עדכון טבלאות קיימות, שינוי מבנה הטבלאות או כל שילוב של המשימות האלה. תהליך העבודה יכול להיראות כך:
- אתם מזהים את הטבלאות שעשויות להיות מושפעות מהשינויים, וטבלאות נוספות שאולי תרצו לבדוק.
- יוצרים קבוצת נתונים חדשה ב-BigQuery שיכיל את הנכסים לשינוי הזה. קבוצת הנתונים הזו עוזרת לבודד את השינויים ולהפריד את המשימה הזו ממשימות אחרות שחברי צוות אחרים עובדים עליהן. מערך הנתונים צריך להיות באותו אזור שבו נמצא מערך הנתונים של המקור. עם זאת, אפשר להפריד את הפרויקט מפרויקט הייצור כדי לעזור בדרישות האבטחה והחיוב של הארגון.
לכל אחת מהטבלאות, יוצרים שיבוט ותמונת מצב במערך הנתונים החדש, אולי לאותה נקודת זמן. היתרונות של הגישה הזו:
- הטבלה המשוכפלת יכולה לשמש כעותק עבודה שבו אפשר לבצע שינויים באופן חופשי בלי להשפיע על טבלת הייצור. אפשר ליצור כמה שיבוטי טבלאות של אותו מסד נתונים טבלאי כדי לבדוק נתיבי שילוב שונים בו-זמנית, עם תקורה מינימלית.
- התמונה יכולה לשמש כנקודת שחזור וייחוס, נקודה שבה הנתונים פעלו לפני שבוצע שינוי כלשהו. תמונת המצב הזו מאפשרת לבצע חזרה למצב קודם אם מתגלה בעיה בהמשך התהליך.
אתם משתמשים בשיבוטי הטבלאות כדי להטמיע את השינויים שנדרשים בטבלאות. הפעולה הזו יוצרת גרסה מעודכנת של השיבוטים של הטבלאות, שאותה אפשר לבדוק בקבוצת נתונים מבודדת.
בסוף שלב ההטמעה, אתם יכולים להציג קבוצת נתונים שאפשר להשתמש בה למשימות הבאות:
- בדיקת יחידה באמצעות כלי אימות כמו Dataform. בדיקות יחידה הן בדיקות עצמאיות, כלומר הנכס נבדק בנפרד. במקרה הזה, הנכס הוא הטבלה ב-BigQuery. בדיקות יחידה יכולות לבדוק אם יש ערכי null, לוודא שכל המחרוזות עומדות בדרישות האורך ולוודא שצבירות מסוימות מניבות תוצאות שימושיות. בדיקות יחידה יכולות לכלול כל בדיקת אמינות שמוודאת שהטבלה עומדת בכללים העסקיים של הארגון.
- בדיקת אינטגרציה עם צרכנים במורד הזרם.
- ביקורת עמיתים.
תהליך העבודה הזה מאפשר לכם לבדוק את נתוני הייצור בלי להשפיע על הצרכנים במורד הזרם.
לפני שממזגים את הנתונים החדשים ב-BigQuery, אפשר ליצור עוד תמונת מצב. תמונת המצב הזו שימושית כאפשרות נוספת לחזרה לגרסה קודמת, למקרה שהנתונים במסד הנתונים הטבלאי השתנו.
תהליך מיזוג השינויים תלוי בתהליך שהארגון שלכם רוצה לאמץ ובשינויים הנדרשים. לדוגמה, אם יש שינוי בסקריפטים של SQL, יכול להיות שלמערך הנתונים החדש תצורף בקשת משיכה (pull request) לבסיס הקוד הרגיל. אם השינוי מוגבל לשינוי בנתונים בטבלה מסוימת, אפשר פשוט להעתיק את הנתונים באמצעות השיטות הרגילות של BigQuery.
אתם יכולים להשתמש בסקריפט של פרוצדורות מאוחסנות כדי להכיל את השלבים ליצירת מערך נתונים, שיבוטים ותמונות מצב, ולהפוך אותם לאוטומטיים. אוטומציה של המשימות האלה מפחיתה את הסיכון לטעויות אנוש. במאגר GitHub של כלי ה-CLI של CI for Data in BigQuery תוכלו למצוא דוגמה לסקריפט שיכול לעזור לכם להפוך את התהליכים לאוטומטיים.
יתרונות השימוש בשיבוטי טבלאות ובתמונות מצב של טבלאות
כשמשתמשים בתהליך העבודה שמתואר בקטע הקודם, המפתחים יכולים לעבוד בנפרד ובמקביל, בלי להפריע לעמיתים שלהם. המפתחים יכולים לבדוק ולסקור את השינויים, ואם יש בעיה, לבטל אותם. מכיוון שאתם עובדים עם קובצי snapshot של טבלאות ולא עם טבלאות מלאות, אתם יכולים למזער את העלויות ואת נפח האחסון בהשוואה לעבודה עם טבלאות מלאות.
בקטע הזה מוסבר איך תמונות מצב ושיבוטים של טבלאות מאפשרים למפתחים להשתמש בתהליך העבודה הזה. בתרשים הבא מוצג הקשר בין תמונות המצב של הטבלאות והשיבוטים של הטבלאות לבין הנתונים במערך הנתונים בסביבת הייצור.
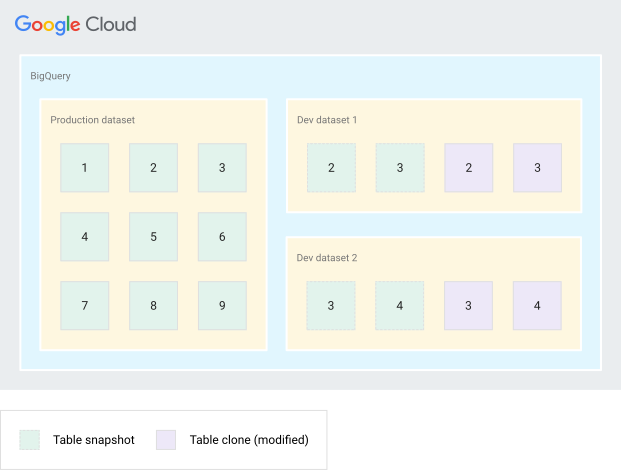
בתרשים, מערך הנתונים בסביבת הייצור מכיל את כל הטבלאות שמשמשות בסביבת הייצור. כל מפתח יכול ליצור מערך נתונים לסביבת הפיתוח שלו. בדיאגרמה מוצגות שתי קבוצות נתונים של מפתחים, שנקראות Dev Dataset 1 ו-Dev Dataset 2. באמצעות מערכי הנתונים האלה, המפתחים יכולים לעבוד בו-זמנית על אותן טבלאות בלי להפריע זה לזה.
אחרי שהמפתחים יוצרים מערך נתונים, הם יכולים ליצור שיבוטים ותמונות מצב של הטבלאות שהם עובדים עליהן. העותקים המשוכפלים ותמונות המצב מייצגים את הנתונים בנקודת זמן מסוימת. בשלב הזה, המפתחים יכולים לשנות את השיבוטים של הטבלה, כי השינויים לא גלויים במסד הנתונים הטבלאי.
המפתח יכול לבדוק את הטבלאות המשוכפלות, להשוות אותן לתמונת המצב ולבדוק את התאימות שלהן לצרכנים במורד הזרם. מפתחים אחרים יכולים לעבוד עם שיבוטים ותמונות מצב אחרים, בלי הפרעה ובלי ליצור יותר מדי עותקים של מסד הנתונים הטבלאי שצורכים משאבים.
המפתחים יכולים למזג שינויים במסד הנתונים הטבלאי, ובמקביל לשמור את קובץ ה-snapshot כאפשרות חזרה למצב קודם, במקרה הצורך. אפשר גם לחזור על התהליך הזה בסביבות שונות, כמו פיתוח, בדיקה וייצור.
חלופות לשיבוטי טבלאות ולתמונות מצב של טבלאות
יש חלופות לשימוש בשיבוטי טבלאות ובתמונות מצב של טבלאות, שמאפשרות להשיג תוצאה דומה. בדרך כלל משתמשים בשיטות החלופיות האלה באופן שונה מאשר בשיבוטים ובתמונות מצב. חשוב להבין את ההבדלים בין השיטות האלה, ובאילו מקרים כדאי להשתמש בכל אחת מהן.
העתקת טבלאות שלמות למערך נתונים אחר
אפשרות אחרת היא להשתמש במערך נתונים אחר ולהעתיק אליו את הטבלאות. השיטה הזו דומה לשימוש בשיבוטים ובתמונות מצב של טבלאות, אבל מעתיקים את כל קבוצת הטבלאות. בהתאם לגודל הנתונים שמועתקים, עלויות האחסון עשויות להיות גבוהות. חלק מהארגונים השתמשו בשיטה הזו לפני ששיבוטי טבלאות היו זמינים ב-BigQuery. עם זאת, לשיטה הזו אין יתרונות על פני שימוש בשיבוטים ובתמונות מצב.
ייצוא וייבוא של טבלאות ל-Cloud Storage
דרך חלופית נוספת היא להעביר את הנתונים דרך Cloud Storage. השיטה הזו דומה גם לשימוש בשיבוטי טבלאות ובתמונות מצב של טבלאות. עם זאת, הוא כולל את השלב הנוסף של ייצוא הנתונים לקטגוריה של Cloud Storage. אחד היתרונות של השיטה הזו הוא שהיא מספקת גיבוי נוסף לנתונים. השיטה הזו מתאימה אם אתם רוצים גיבוי לתוכנית התאוששות מאסון (DR) או לפתרונות היברידיים.
שימוש ב-BigQuery sharing
BigQuery sharing (לשעבר Analytics Hub) מאפשר לשתף מערכי נתונים מחוץ לארגון ובתוכו בצורה מאובטחת. הוא מציע תכונות רבות שמאפשרות לפרסם מערכי נתונים כדי לספק למנויים גישה מבוקרת לקריאה בלבד למערכי הנתונים האלה. עם זאת, למרות שאפשר להשתמש ב-BigQuery sharing כדי לחשוף מערכי נתונים כדי להטמיע שינויים, המפתח עדיין צריך ליצור שיבוטי טבלאות כדי לעבוד עם הטבלאות.
סיכום של אפשרויות האינטגרציה הרציפה של DWH
בטבלה הבאה מפורטים ההבדלים, היתרונות והחסרונות האפשריים של האפשרויות לאינטגרציה רציפה (CI) של DWH. (שיתוף מציע קבוצת תכונות שונה, ולכן לא ניתן למדוד אותו באמצעות הפרמטרים המפורטים בטבלה).
| עלויות | חזרה לגרסה קודמת | הסיכונים | |
|---|---|---|---|
| תמונות מצב של טבלאות ושיבוטי טבלאות | מינימלי. אתם משלמים רק על ההבדל בין קובץ ה-snapshot או השכפול לבין מסד הנתונים הטבלאי. | ה-snapshot משמש כגיבוי שאפשר לחזור אליו במקרה הצורך. | אתם קובעים את רמת הסיכון. אפשר ליצור תמונות מצב בנקודת זמן מסוימת לכל הטבלאות, וכך לצמצם את חוסר העקביות גם אם יש החזרה למצב קודם. |
| העתקת הטבלה | עלויות גבוהות יותר מאשר שימוש בתמונות מצב של טבלאות ובשיבוטי טבלאות. כל הנתונים משוכפלים. כדי לתמוך בביטול שינויים, צריך כמה עותקים של אותה טבלה. | אפשרי, אבל צריך שני עותקים של הטבלה – עותק אחד שישמש כגיבוי ועותק אחד לעבודה ולביצוע שינויים. | קשה יותר לשכפל נקודת זמן. אם צריך לבצע חזרה למצב קודם, לא כל הטבלאות נלקחות מאותה נקודת זמן. |
| ייצוא וייבוא | עלויות גבוהות יותר מאשר שימוש בתמונות מצב של טבלאות ובשיבוטי טבלאות. הנתונים משוכפלים. כדי לתמוך בהחזרה למצב קודם, צריך כמה עותקים של אותה טבלה. | הנתונים המיוצאים משמשים כגיבוי. | הנתונים שמיוצאים הם לא ייצוא של נקודת זמן מסוימת לכמה טבלאות. |
המאמרים הבאים
- במאמר מבוא לתמונות מצב של טבלאות תוכלו לקרוא על תמונות מצב של טבלאות ב-BigQuery.
- מידע נוסף על אינטגרציה רציפה (CI) לפיתוח תוכנה זמין במאמר DevOps טכנולוגי: אינטגרציה רציפה (CI).
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.