


このドキュメントでは、Google Kubernetes Engine(GKE)を使用して複数モデルの推論サービスを作成するためのリファレンス アーキテクチャについて説明します。このアーキテクチャでは、GKE ホスト型の推論プールは GKE Inference Gateway の背後に配置されます。このアーキテクチャには次の利点があります。
- すべての推論リクエストに対応する単一のインターフェース。
- 各リクエストを、最も効率的に処理できるモデルと推論サーバーにインテリジェントにルーティングします。
- 一元化された認可、セキュリティ、その他のサービス。
このドキュメントは、GKE で実行される推論サーバーのデプロイの統合を担当するネットワーク アーキテクトを対象としています。すべての推論サーバーが GKE でホストされていない場合は、すべてのバックエンドでの AI 推論モデル提供のネットワーキングをご覧ください。このドキュメントでは、アプリケーションの設計方法や個々の生成 AI モデルのデプロイ方法については説明しません。モデルのデプロイ方法については、企業で生成 AI モデルと ML モデルを構築してデプロイするをご覧ください。
このアーキテクチャは、アプリケーション ネットワーキング アーキテクチャの分散型アプリケーション向けクロスクラウド ネットワークやその他の設計と連携します。
アーキテクチャ
次の図は、GKE ホストの推論サーバーの前に Inference Gateway があるアーキテクチャを示しています。Gateway は、ホストされているすべてのモデルに統合サービスを提供します。
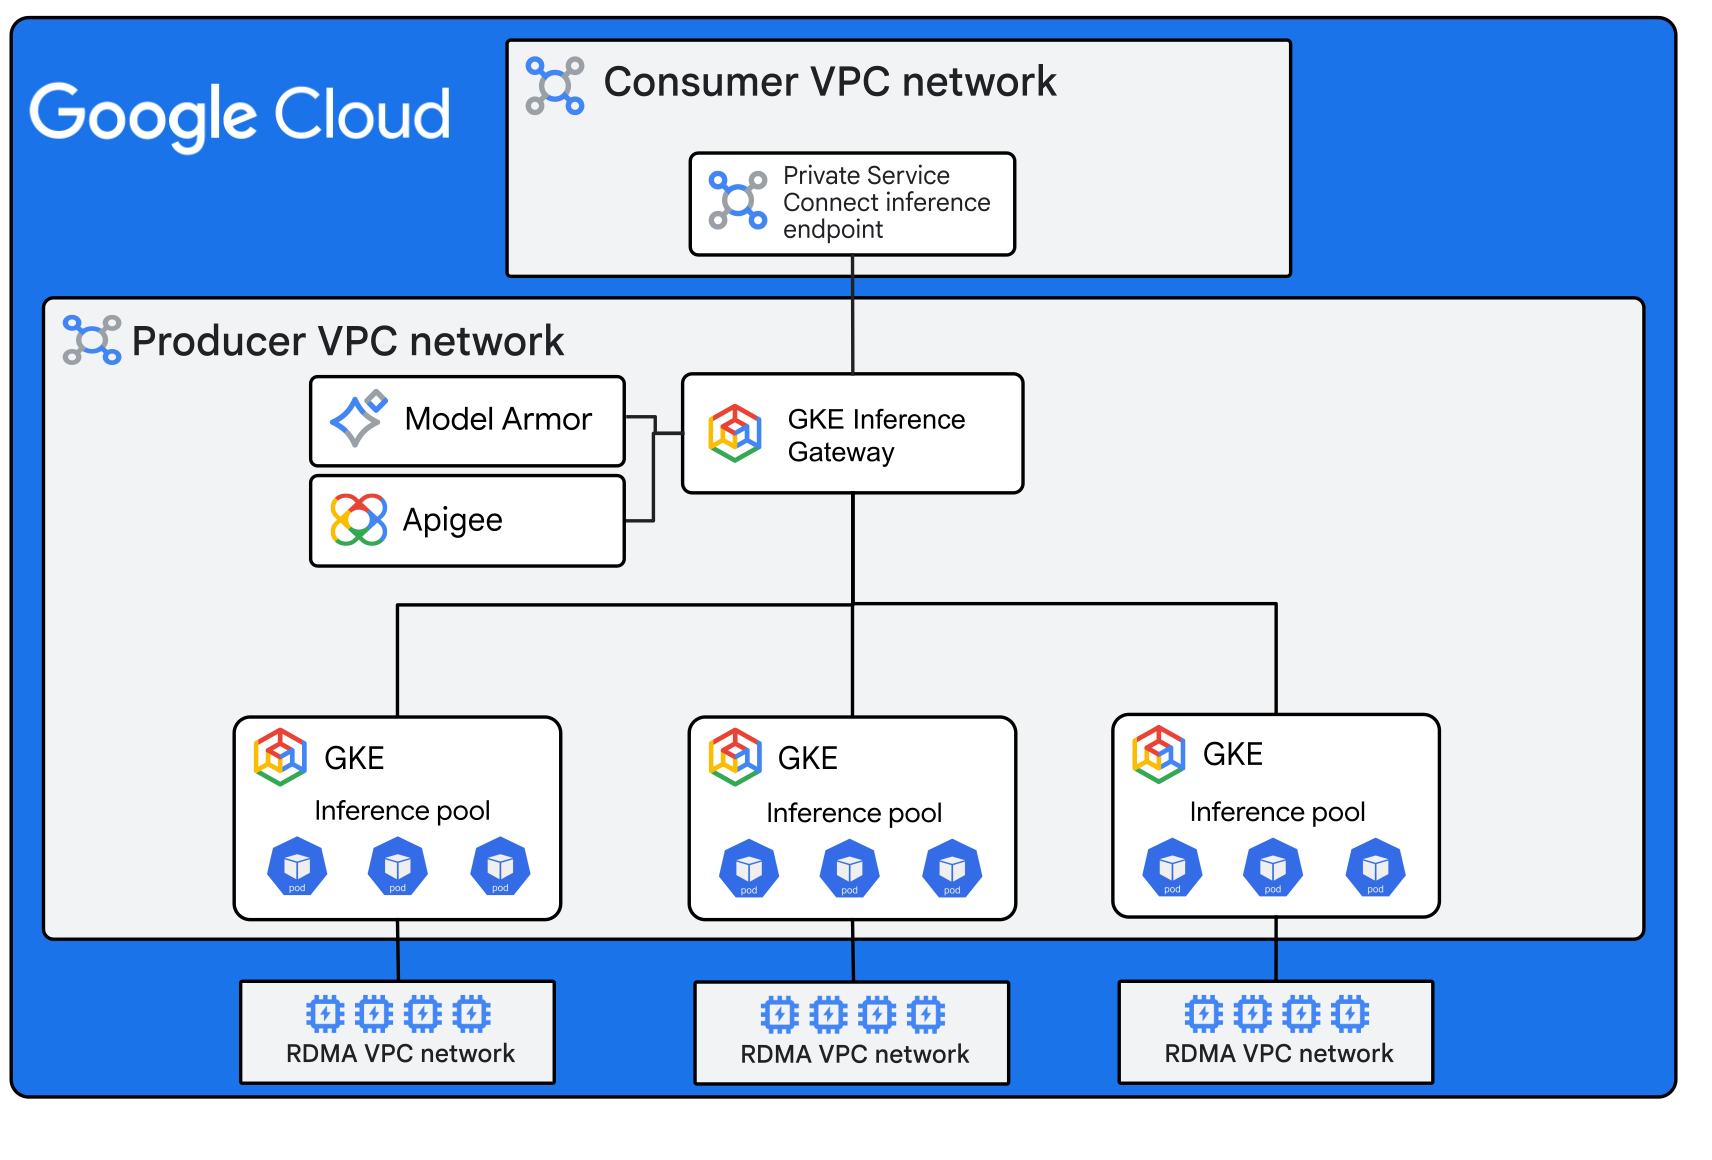
この図のアーキテクチャには、次のコンポーネントが含まれています。
- Private Service Connect 推論エンドポイント: ホストされているすべてのモデルの統合エンドポイント。エンドユーザーは、エンドポイントの IP アドレスに推論リクエストを送信します。この図は、単一のコンシューマー Virtual Private Cloud(VPC)ネットワーク内の Private Service Connect エンドポイントを示しています。エンドポイントは、複数の VPC ネットワークまたは共有サービス VPC ネットワークでホストできます。
- Inference Gateway: Inference Gateway は、GKE Gateway を拡張して、GKE が生成 AI アプリケーションとワークロードを処理する方法を最適化します。モデル名に基づいて、モデルレプリカの推論プールにトラフィックをルーティングします。Gateway は、プレフィックス マッチングを使用してレプリカ プール内のトラフィックをルーティングします。プレフィックスが一致しない場合、Gateway 推論プロセッサは GPU または TPU の Prometheus 指標を使用して、プール内で最も負荷の低いレプリカを選択します。推論プロセッサは、接頭辞のキャッシュ保存も処理します。このアーキテクチャでは、顧客向けアプリケーションが OpenAI API 呼び出しを行い、Gateway を介してモデルにアクセスします。Gateway はリージョン内部アプリケーション ロードバランサ(
gke-l7-rilb)に基づいてデプロイされるため、インターネットから直接アクセスできません。- API 管理: API マネージャーは、API 認証、セキュリティ、レート制限、割り当ての追跡、その他の API 管理サービスを提供します。このアーキテクチャでは Apigee を使用しますが、他のオプションもサポートしています。ロードバランサから Apigee を呼び出すために、アーキテクチャと Terraform デプロイでは、Service Extensions のトラフィック拡張機能を使用して Apigee Extension Processor を呼び出します。
- Model Armor: 推論プロンプトが推論サーバーに到達する前に安全性チェックを実行する AI ガードレール システム。その後、送信するレスポンスに対して安全性チェックを実行します。このアーキテクチャでは、AI ガードレールに Model Armor を使用していますが、NVIDIA Nemo Guardrails などの他のオプションもサポートしています。このリファレンス アーキテクチャで提供される Terraform デプロイには、基本的な Model Armor 構成が含まれています。
- 推論プール: 推論プールには、同じモデルのレプリカが含まれます。Gateway は、プロンプトを受信すると、
HTTPRouteルックアップを使用して、モデル ID に基づいて推論プールを選択します。プールには初期サイズがありますが、自動スケーリングするように構成できます。 - モデル レプリカ セット: モデル レプリカは、1 つ以上の GPU または TPU にデプロイされる推論サーバーのコピーです。モデル レプリカは、単一ノードまたはマルチノードにできます。レプリカ セットは、ロードバランサによってフロントエンド処理されるモデル レプリカの均一なグループです。レプリカ セットがマルチノードの場合、GPU はバックエンド RDMA VPC ネットワークを介して相互に接続します。このネットワークは、レール整列型の GPU 間ロスレス低レイテンシ ネットワーキングを提供します。
リクエスト フロー
システムは推論リクエストを次のように転送します。
- エンドユーザーが OpenAI API リクエストを Private Service Connect エンドポイントに送信します。このリクエストには次のものが含まれています。
- プロンプト。
- モデル名。ホストされている推論サーバーのいずれかのモデル名と一致する必要があります。
- Private Service Connect エンドポイントは、リクエストを Inference Gateway のリージョン内部アプリケーション ロードバランサ バージョンに転送します。
- Gateway は、リクエスト本文からモデル名を抽出し、本文ベースのルーティングを使用してリクエスト ヘッダーに挿入します。
- Gateway は、必要な API 管理サービスのリクエストを API 管理システムに転送します。
- ゲートウェイは、スクリーニングのためにプロンプトを Model Armor に送信します。
- プロンプトに編集できない機密情報が含まれている場合、プロンプトはブロックされ、Model Armor はポリシー違反が検出されたことを示すレスポンスを返します。
- プロンプトに編集可能な機密情報が含まれている場合、またはプロンプトに問題がまったくない場合、Model Armor は機密情報を編集してプロンプトを転送します。
- Gateway は
HTTPRouteに、リクエストのモデルに一致する推論プールのリストを照会します。このリストから、優先度に基づいて 1 つが選択されます。 - Gateway は、プール内のすべてのレプリカのプレフィックス キャッシュと現在の負荷を調べ、その情報を使用してレプリカを選択します。
- レプリカがリクエストを処理し、Gateway に返送します。
- Gateway は、承認または拒否のためにレスポンスを Model Armor に送信します。
- Gateway は、レスポンスを Private Service Connect エンドポイントに送り返し、エンドユーザーに転送します。
次の図は、サンプル デプロイのルーティング ビューを示しています。
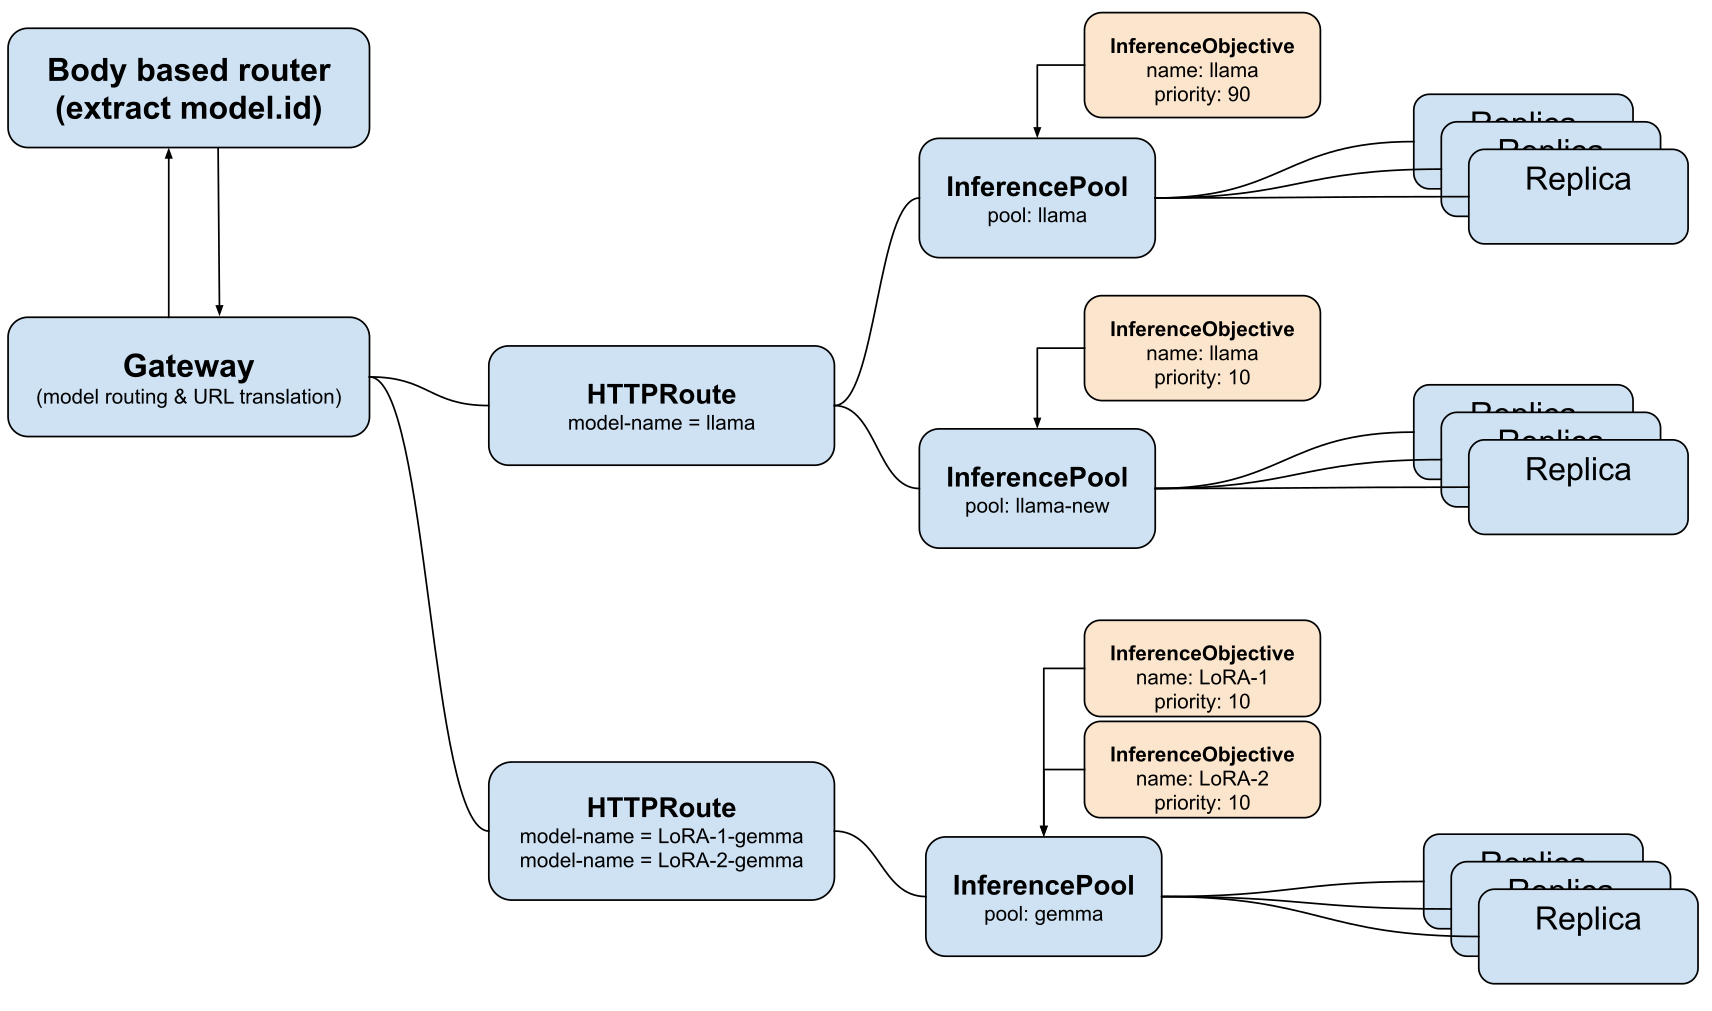
この例では、ユーザーが選択したモデルに応じてプロンプトが処理されます。
- Llama: システムは、Llama モデルをホストする 2 つのレプリカ セット間で、これらのプロンプトを 90 対 10 の比率でロード バランシングします。これらの 2 つのレプリカ セットは、同じ方法でホストする必要はありません。たとえば、1 つのレプリカ セットを Gemini Enterprise Agent Platform でホストし、もう 1 つのレプリカ セットを GKE でホストできます。
- LoRA-1-gemma または LoRA-2-gemma: システムはすべてのプロンプトを同じレプリカ セットに送信します。このレプリカ セットは両方のモデルを処理できます。
いずれの場合も、Gateway はプレフィックス マッチングと最小負荷の組み合わせを使用して、関連するプール内のレプリカを選択します。
使用するプロダクト
このリファレンス アーキテクチャでは、次の Google Cloudプロダクトを使用します。
- Google Kubernetes Engine(GKE): Google のインフラストラクチャを使用して、コンテナ化されたアプリケーションを大規模にデプロイして運用するために使用できる Kubernetes サービス。
- GKE Inference Gateway: 生成 AI ワークロードの提供に最適化されたルーティングとロード バランシングを提供する Google Kubernetes Engine Gateway の拡張機能。これにより、AI 推論ワークロードのデプロイ、管理、オブザーバビリティが簡素化されます。
- Virtual Private Cloud(VPC): Google Cloud ワークロードにグローバルでスケーラブルなネットワーキング機能を提供する仮想システム。VPC には、VPC ネットワーク ピアリング、Private Service Connect、プライベート サービス アクセス、共有 VPC が含まれます。
- Private Service Connect: コンシューマーが VPC ネットワーク内からマネージド サービスにプライベート接続でアクセスできるようにする機能。
- Cloud Run: Google のスケーラブルなインフラストラクチャ上でコンテナを直接実行できるマネージド コンピューティング プラットフォーム。
- Apigee: API のアクセス方法と使用方法を細かく制御できる API 管理ツール。セキュリティ、レート制限、割り当ての適用、分析を提供します。
- Model Armor: プロンプト インジェクション、センシティブ データの漏洩、有害なコンテンツから生成 AI とエージェント型 AI のリソースを保護するサービス。
代替案を設計する
このセクションでは、このアーキテクチャの基本前提の代替案について説明します。
AI ガードレール
AI ガードレールには Model Armor を使用することをおすすめします。管理を一元化するには、このアーキテクチャのように、ロードバランサから直接呼び出すことをおすすめします。Model Armor は、次の方法でも実装できます。
- API 管理ポリシーを使用して Model Armor を呼び出します。
- レプリカにのみ Model Armor をデプロイします。
モデル エンドポイント以外の場所に AI ガードレールを実装する場合は、必要に応じてフロントエンド ロードバランサで Model Armor をオフにできます。Model Armor を使用しない場合は、トラフィック拡張機能を使用して、NVIDIA NeMo Guardrails などの他のガードレール サービスをデプロイできます。
API 管理
このドキュメントのアーキテクチャでは、API 管理に Apigee を使用します。これは、ロードバランサ Service Extension を使用してデプロイされます。Apigee がニーズを満たしていない場合は、Service Extensions を使用して別の API 管理サービスをデプロイできます。
Service Extensions を使用した API 管理のデプロイがニーズを満たしていない場合は、クライアント向けのネットワークと API 向けのネットワークをデプロイする必要があるかもしれません。このシナリオでは、API 管理サービスが 2 つのネットワーク間のブリッジとして機能します。Apigee にデプロイする方法については、Apigee ネットワーキング オプションをご覧ください。
他のネットワークへの接続
このドキュメントのアーキテクチャでは、単一のコンシューマー VPC ネットワークを使用します。ただし、クロスクラウド ネットワークのデプロイでサービス アクセス VPC ネットワークを使用すると、Private Service Connect エンドポイントを他の多くのネットワークと共有できます。
設計上の考慮事項
ワークロードのアーキテクチャを構築する際は、Google Cloud Well-Architected Framework のベスト プラクティスと推奨事項を検討してください。
セキュリティ、プライバシー、コンプライアンス
分散型サービス拒否攻撃(DDoS)からの保護、ウェブ アプリケーション ファイアウォール(WAF)機能、IP アドレス検査をデプロイに追加するには、フロントエンドのリージョン内部アプリケーション ロードバランサに Google Cloud Armor を追加します。
信頼性
リージョンの障害を防ぐには、Google Cloud マルチリージョン デプロイ アーキタイプを使用して、デプロイをセカンダリ リージョンに複製します。
費用の最適化
GKE の費用最適化に関する推奨事項については、GKE でコスト最適化 Kubernetes アプリケーションを実行するためのベスト プラクティスをご覧ください。
運用効率
Inference Gateway ダッシュボードを使用して、Inference Gateway 推論リクエストのパフォーマンスをモニタリングします。ダッシュボードには、エラーと、リクエスト率、レイテンシ、飽和度などの指標が表示されます。ダッシュボードの検出結果を使用して、デプロイを最適化します。
パフォーマンスの最適化
GKE での推論に関するベスト プラクティスの概要の推奨事項に従います。
デプロイ
このアーキテクチャのサンプル実装をデプロイするには、GitHub で入手できる AI 推論モデル サービングのネットワーキングのコードサンプルを使用します。
次のステップ
- 検索拡張生成(RAG)をデプロイに追加する方法については、RAG 対応生成 AI アプリケーションのプライベート接続をご覧ください。
- Cloud アーキテクチャ センターで、リファレンス アーキテクチャ、図、ベスト プラクティスを確認する。
寄稿者
著者: Victor Moreno | プロダクト マネージャー、クラウド ネットワーキング
その他の寄稿者:
- Mark Schlagenhauf | テクニカル ライター、ネットワーキング
- James Duncan | ソリューション プロダクト マネージャー
- Ammett Williams | デベロッパー リレーションズ エンジニア