


このドキュメントでは、AI エージェントを使用するクロス クラウド分析ワークフローを実装するためのアーキテクチャの概要について説明します。このドキュメントは、マルチクラウド データレイク、構造化データ ウェアハウス、非構造化データストアにわたる分析ワークフローにエージェント型 AI を使用するクラウド アーキテクト、データ エンジニア、データ サイエンティストを対象としています。このドキュメントは、エージェント型 AI のコンセプト、データ分析、クラウド アーキテクチャに関する基本的な知識があることを前提としています。
このドキュメントのデプロイ セクションでは、エージェント分析ソリューションの構築方法を学習できる Codelab を紹介しています。
アーキテクチャ
次の図は、複数のデータストアとクラウド サービス プロバイダに分散された構造化データと非構造化データからビジネス分析情報を導き出すエージェント分析ソリューションのアーキテクチャを示しています。
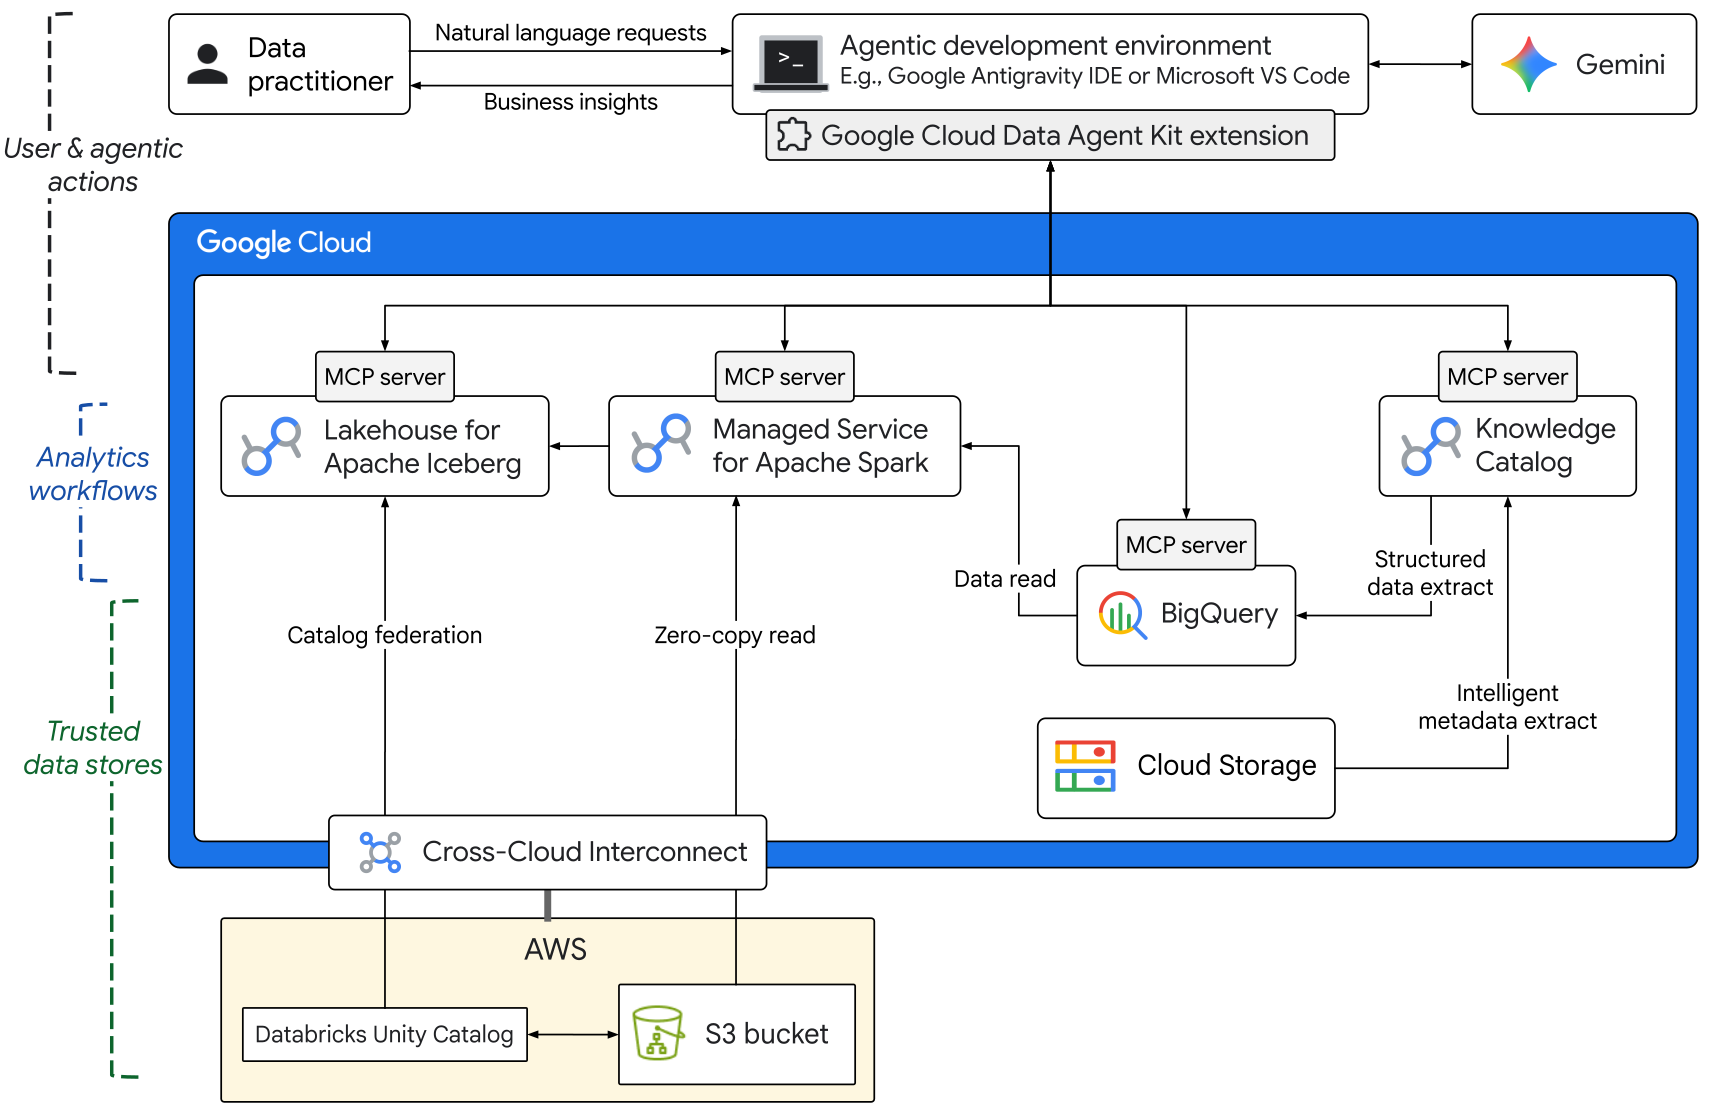
このアーキテクチャのコンポーネントは、次のレイヤに編成されています。
ユーザーとエージェントのアクション
- エージェント型開発環境: データ エンジニアやデータ サイエンティストなどのデータ実務担当者は、次のいずれかの方法で自然言語リクエストを送信します。
- Google Antigravity IDE や Microsoft Visual Studio Code などのエージェント開発環境。
- Gemini CLI、Claude Code、Codex などの CLI エージェント。
- Google Cloud Data Agent Kit: Data Agent Kit を使用すると、エージェントは適切なスキルを読み込み、 Google Cloud サービスのリモート MCP サーバーに接続することで、Google Cloud の信頼できるデータにアクセスできます。
- 基盤モデル: 信頼できるコンテキストとデータからビジネス分析情報を生成するために、エージェント開発環境では Gemini ファミリーのモデルなどの基盤モデルを使用します。モデルは、Data Agent Kit の適切なスキルを使用し、必要な MCP サーバーツールを使用して複雑な分析ワークフローを実装します。
- エージェント型開発環境: データ エンジニアやデータ サイエンティストなどのデータ実務担当者は、次のいずれかの方法で自然言語リクエストを送信します。
分析ワークフロー
- ボーダーレス レイクハウス: Lakehouse は、Apache Iceberg オープン テーブル形式と Google Cloudのエンタープライズ グレードのストレージを統合する、高パフォーマンスの統合メタデータ カタログを提供します。クロスクラウド データアクセスを使用すると、Lakehouse はデータを移動またはコピーすることなく、Databricks Unity Catalog などの外部カタログを連携できます。
- Managed Service for Apache Spark: これは、アーキテクチャのコアデータ処理コンポーネントです。Managed Service for Apache Spark の Lightning Engine 機能は、バッチモードとインタラクティブ モードで高パフォーマンスのサーバーレス データ処理をサポートします。Spark データ処理ジョブは、Lakehouse の Iceberg カタログのメタデータを使用し、BigQuery から構造化データを読み取り、Amazon S3 などの外部ソースからゼロコピー読み取りを実行します。
- Knowledge Catalog: エージェントは、Knowledge Catalog を使用して Cloud Storage 内の非構造化データのインテリジェント スキャンを実行し、セマンティック メタデータを抽出して、コンテキスト グラフを構築します。
信頼できるデータストア
- Google Cloud のデータ: BigQuery は、Cloud Storage の非構造化データから抽出された構造化データを含む、構造化データの中央ウェアハウスとして機能します。
- 外部ソースからのデータ: このアーキテクチャは、Amazon S3 バケット内のデータや Databricks Unity Catalog 内のメタデータなどの外部データソースを示しています。Cross-Cloud Interconnect は、 Google Cloudと他のクラウド サービス プロバイダの間で高帯域幅の専用接続を提供します。
使用するプロダクト
このアーキテクチャでは、次の Google Cloud プロダクトとツールを使用します。
- Google Cloud Data Agent Kit: データ サイエンティスト、データ エンジニア、データアプリ デベロッパーが、好みのエージェント型開発環境内からデータ ライフサイクル全体を管理できるようにするエージェント拡張機能。
- BigQuery: ML、地理空間分析、ビジネス インテリジェンスなどの組み込み機能を使用してデータの管理と分析を支援する、Google Cloud のフルマネージド エンタープライズ データ ウェアハウス。
- Managed Service for Apache Spark: マネージド コンピューティング インフラストラクチャで Apache Spark バッチ ワークロードを実行するマネージド サービス。
- Lakehouse: オープンデータ レイクハウスを構築できる高パフォーマンスのストレージ エンジン。高度な分析と AI のための統合インターフェースを提供します。
- Knowledge Catalog: インテリジェントなメタデータとガバナンス機能を備えたデータアセットの統合カタログを提供する AI 搭載サービス。
- Gemini: Google が開発したマルチモーダル AI モデルのファミリー。
- Cloud Storage: 低コストで無制限のオブジェクト ストア。さまざまなデータ型に対応しています。データには Google Cloudの内部および外部からアクセスでき、冗長性を確保するために複数のロケーションに複製されます。
- Cross-Cloud Interconnect: Google Cloud と他のクラウド サービス プロバイダの間で、高帯域幅、低レイテンシの専用接続を提供するサービス。
- Google Cloud MCP サーバー: Model Context Protocol(MCP)を実装する Google マネージド リモート サービス。AI アプリケーションに Google と Google Cloud のプロダクトとサービスへのアクセスを提供します。
ユースケース
このドキュメントで説明するアーキテクチャは、次のユースケースに適しています。
- マルチクラウド データ分析: ファイルを移動したり、複雑な抽出、変換、読み込み(ETL)パイプラインを構築したりすることなく、 Google Cloud や他のクラウド サービス プロバイダに分散されたデータを効率的にクエリして分析します。たとえば、グローバルな小売業者のマーケティング マネージャーは、Amazon S3 の顧客ロイヤリティ データと BigQuery のマーケティング オペレーション データを結合して、マーケティング キャンペーンの効果を分析できます。
- インテリジェントなデータ検出: 自然言語プロンプトと AI エージェントを使用して、複数の環境にわたるフェデレーション データセットを検出、クエリ、処理します。たとえば、調達スペシャリストは、サプライ チェーン管理(SCM)システムの構造化データと、非構造化メール通信や損害評価レポートの分析情報を組み合わせて、サプライ チェーンの混乱の一般的な原因を特定できます。
- 非構造化ソースからの構造化データの抽出: 大量の非構造化データをスキャンし、セマンティック メタデータを導出して、構造化データの抽出を BigQuery に保存し、ダウンストリーム分析に使用します。たとえば、オペレーション コントローラは、PDF ファイルなどの非構造化形式で保存されている数千の請求書から構造化データを抽出することで、費用を効率的に分析できます。
セキュリティ上の考慮事項
AI エージェントに固有のセキュリティ リスクに対処するため、Google は、決定論的なセキュリティ管理と動的な推論ベースの防御を組み合わせたアプローチを推奨しています。
- 人間による監視: ビジネス クリティカルなシステムに人間参加型のフローを組み込み、人間の監督者がアウトプットを確認して、エージェントのアクションを承認、オーバーライド、一時停止できるようにします。
- Agent Identity: 各エージェントにワークロードにバインドされた ID を割り当てて、最小権限のアクセス制御を適用し、外部ツールの認証情報を一元管理します。
- Agent Gateway: Model Armor を使用して、上り(内向き)トラフィックと下り(外向き)トラフィックのガバナンス、デフォルト拒否アクセス ポリシー、インライン プロンプトとツールの検査を適用します。
- Agent Registry: エージェントが承認済みのサブエージェントと MCP ツールにのみ接続することを確認します。
このセクションのガイダンスはすべてを網羅しているわけではありません。設計要素とベスト プラクティスの詳細、およびマルチエージェント AI システムの構築とデプロイに関する推奨事項については、 Google Cloudのマルチエージェント AI システムをご覧ください。
AI ワークロードと ML ワークロードに固有のセキュリティの原則と推奨事項については、Well-Architected Framework の AI と ML の視点: セキュリティをご覧ください。
デプロイ
Data Agent Kit を使用してエージェント分析ソリューションを構築する方法については、Codelab の AI エージェントを使用して元データを数秒で予測に変換するをご覧ください。この Codelab では、Data Agent Kit を使用して、好みのエージェント開発環境内からデータを効率的に分析する方法について説明します。Codelab で使用するサンプルデータはすべてGoogle Cloudに保存されます。
次のステップ
- Data Agent Kit でノートブックを使用してデータ変換と分析を行う方法を学習する。
- Knowledge Catalog のユースケースを確認する。
- Lakehouse を使用したクロスクラウド データアクセスの詳細を確認する。
- Lightning Engine を使用して Apache Spark ワークロードを高速化する方法を学習する。
- BigQuery のガバナンス レイヤとエージェント レイヤとして Knowledge Catalog を使用する方法を学習する。
- Cloud アーキテクチャ センターで、リファレンス アーキテクチャ、図、ベスト プラクティスを確認する。
協力者
著者: Kumar Dhanagopal | クロスプロダクト ソリューション デベロッパー
その他の寄稿者:
- Abirami Sukumaran | スタッフ デベロッパー アドボケイト
- Arti Prasad | テクニカル ライター
- Brad Miro | シニア デベロッパー アドボケイト
- Matthew Rahmann | シニア プロダクト マネージャー
- Ranadip Chatterjee | ソリューション エンジニア
- Remigiusz Samborski | リード デベロッパー リレーションズ エンジニア