


O AlloyDB Omni é um pacote de software de banco de dados para download que permite implantar uma versão simplificada do AlloyDB para PostgreSQL em ambientes de computação gerenciados por você. O AlloyDB Omni e o serviço totalmente gerenciado do AlloyDB no Google Cloud compartilham os mesmos componentes principais. O AlloyDB usa uma camada de armazenamento desagregada nativa da nuvem, enquanto o AlloyDB Omni é implantado no armazenamento de sua escolha.
A portabilidade do AlloyDB Omni permite que ele seja executado em muitos ambientes, incluindo os seguintes:
- Seus data centers particulares
- Qualquer nuvem pública
- Seu laptop
- Instâncias de VM baseadas na nuvem
O AlloyDB Omni oferece várias melhorias, além do PostgreSQL padrão, que dão suporte à escalonabilidade, disponibilidade, confiabilidade, desempenho, IA e linguagem natural. Para mais informações, consulte Adições do AlloyDB Omni ao PostgreSQL padrão.
Casos de uso do AlloyDB Omni
O AlloyDB Omni é adequado para os seguintes cenários:
- Você precisa de uma versão escalonável e de alto desempenho do PostgreSQL que precisa ser executada no local devido a requisitos regulatórios ou de soberania de dados.
- Você precisa de um banco de dados que continue em execução mesmo quando estiver desconectado da Internet.
- Você quer migrar de um banco de dados legado sem se comprometer com um serviço de nuvem totalmente gerenciado, como o AlloyDB para PostgreSQL.
Principais recursos
- Um servidor de banco de dados 100% compatível com PostgreSQL.
- Suporte para a IA do AlloyDB, que ajuda a criar aplicativos de IA generativa de nível empresarial usando seus dados operacionais.
- Integrações com o ecossistema de IA Google Cloud , incluindo o Vertex AI Model Garden e ferramentas de IA generativa de código aberto.
Suporte para recursos de piloto automático do AlloyDB para PostgreSQL no Google Cloud , que permite que o AlloyDB Omni se autogerencie e se autoajuste.
Por exemplo, o AlloyDB Omni é compatível com o gerenciamento automático de memória e o autovacuum adaptável de dados desatualizados.
O mecanismo colunar do AlloyDB Omni, que mantém os dados relevantes em um formato colunar na memória para consultas analíticas, relatórios e cargas de trabalho de processamento híbrido de transação e análise (HTAP) mais rápidos.
A interface do usuário da Web do AlloyDB Omni, que permite o monitoramento gráfico de telemetria e auditorias de configuração para seus clusters autogerenciados.
Em testes de desempenho, as cargas de trabalho transacionais no AlloyDB Omni são mais de duas vezes mais rápidas, e as consultas analíticas são até 100 vezes mais rápidas do que o PostgreSQL padrão.
Opções de implantação do AlloyDB Omni
No console do Google Cloud , é possível conferir as opções de implantação, acessar recursos de aprendizado e gerenciar licenças diretamente na página de destino do AlloyDB Omni:
A página de destino do console tem duas guias principais:
- Opções de implantação: oferece caminhos e guias personalizados para instalar o AlloyDB Omni em diferentes ambientes de infraestrutura, além de acesso a codelabs e demonstrações de IA.
- Assinaturas: centraliza o gerenciamento de licenças para implantações de produção. É possível calcular e comprar licenças com base na contagem total de vCPUs, escalonar vCPUs, visualizar custos e gerenciar descontos por compromisso de uso.
É possível instalar o AlloyDB Omni usando uma das seguintes opções de implantação:
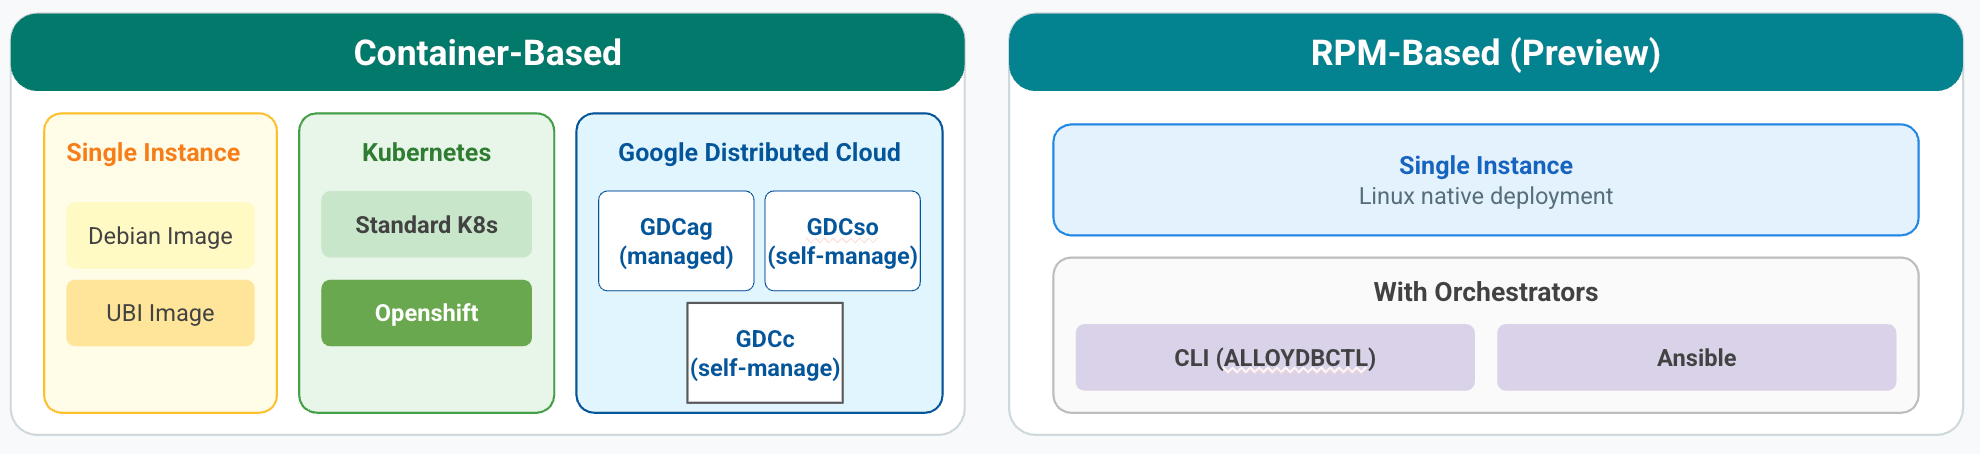
AlloyDB Omni usando contêineres: um contêiner de banco de dados independente. Execute o AlloyDB Omni em um sistema Linux com armazenamento SSD e pelo menos 8 GB de memória por CPU.
AlloyDB Omni usando o orquestrador de contêineres: parte de um contêiner em um ambiente do Kubernetes. O operador do AlloyDB Omni no Kubernetes é uma extensão da API do Kubernetes que permite executar o AlloyDB Omni na maioria dos ambientes do Kubernetes em conformidade com a CNCF.
O operador do AlloyDB Omni simplifica as operações básicas de banco de dados, permitindo automatizar implantações únicas ou de alta disponibilidade (HA) e operações do dia 2, como backup, restauração, failover e configuração de recuperação de desastres (DR) entre regiões.
AlloyDB Omni usando RPM: um pacote independente executado diretamente em uma VM ou bare metal. O AlloyDB Omni que usa RPM é executado como um conjunto de componentes de software integrados diretamente no sistema operacional host. Ele usa o sistema de arquivos padrão do Linux para armazenamento, permitindo que você use sua infraestrutura de armazenamento e práticas de gerenciamento atuais.
AlloyDB Omni usando o orquestrador RPM: uma implantação do Red Hat Package Manager (RPM) para VMs ou servidores bare metal. Essa opção inclui uma plataforma de orquestração que automatiza a implantação e o gerenciamento em ambientes que não são do Kubernetes. Ele estende a flexibilidade semelhante à nuvem para a infraestrutura de sua escolha, sem exigir camadas de conteinerização como o Docker.
Seus aplicativos se conectam e se comunicam com o banco de dados do AlloyDB Omni, assim como se conectam e se comunicam com um servidor de banco de dados PostgreSQL padrão. O controle de acesso do usuário também depende dos padrões do PostgreSQL.
É possível configurar o comportamento do banco de dados do AlloyDB Omni usando flags de banco de dados, incluindo geração de registros, limpeza e o mecanismo colunar. Para mais informações, consulte Opções de download e instalação disponíveis do AlloyDB Omni.
AlloyDB Omni como um contêiner
O Google distribui o AlloyDB Omni como um contêiner que pode ser executado com ambientes de execução de contêiner, como o Docker e o Podman. Também é possível implantar contêineres do AlloyDB Omni em um ambiente do Kubernetes com muitas operações básicas automatizadas.
Em termos operacionais, os contêineres oferecem as seguintes vantagens:
- Gerenciamento transparente de dependências: todas as dependências necessárias são agrupadas no contêiner e testadas pelo Google para garantir que sejam totalmente compatíveis com o AlloyDB Omni.
- Portabilidade: o AlloyDB Omni opera de forma consistente em todos os ambientes.
- Isolamento de segurança: você escolhe o que o contêiner do AlloyDB Omni pode acessar na máquina host.
- Gerenciamento de recursos: é possível definir a quantidade de recursos de computação que você quer que o contêiner do AlloyDB Omni use.
- Correções e upgrades contínuos: para corrigir um contêiner, substitua a imagem atual por uma nova.
AlloyDB Omni em um ambiente RHEL
O AlloyDB Omni oferece duas opções de implantação para um ambiente do RHEL, que dependem dos seus requisitos de automação e escalonamento.
O AlloyDB Omni está usando RPM
A opção de implantação de RPM é uma instalação independente do Red Hat Package Manager (RPM) projetada para ambientes em que você quer um banco de dados do AlloyDB Omni não conteinerizado. Essa opção é compatível com o RHEL 9 e o Rocky Linux 9.
- Integração direta com o SO: é executado como um conjunto de componentes de software integrados diretamente no sistema operacional (SO) do host.
- Armazenamento atual: usa o sistema de arquivos padrão do Linux (ext4 e xfs), que é compatível com a infraestrutura de armazenamento e as práticas de gerenciamento atuais.
- Simplicidade: adequado para configurações de instância única em que é necessária uma integração profunda com o SO host, sem camadas de orquestração adicionais.
O orquestrador de RPM
A opção de implantação do orquestrador RPM usa os mesmos pacotes RPM que o AlloyDB Omni usando RPM, mas adiciona uma plataforma de orquestração para automatizar o gerenciamento em ambientes que não são do Kubernetes.
- Flexibilidade semelhante à da nuvem: estende a automação para a infraestrutura local, lidando com inicialização, failover e gerenciamento do ciclo de vida.
- Frameworks de Automation: integração com ferramentas conhecidas, como o Ansible, permitindo que as equipes usem as habilidades que já têm. Também é possível usar ferramentas de linha de comando criadas para essa finalidade.
- Recursos empresariais: projetados especificamente para oferecer alta disponibilidade (HA) e recuperação de desastres (DR) por meio de um gerenciador de clusters centralizado.
Backup de dados e recuperação de desastres
O AlloyDB Omni conta com um sistema de backup e recuperação contínuos que permite criar um novo cluster de banco de dados com base em qualquer momento dentro de um período de armazenamento ajustável. Isso permite que você se recupere de acidentes de perda de dados.
Além disso, o AlloyDB Omni pode criar e armazenar backups completos dos dados do cluster de banco de dados, sob demanda ou de forma programada. A qualquer momento, é possível restaurar um backup para um cluster de banco de dados do AlloyDB Omni que contenha todos os dados do cluster de banco de dados original no momento em que o backup foi criado.
Como outro método de recuperação de desastres, é possível realizar a replicação entre data centers criando clusters de banco de dados secundários em data centers separados. O AlloyDB Omni transmite dados de forma assíncrona de um cluster de banco de dados principal designado para cada um dos clusters secundários. Sempre que necessário, é possível promover um cluster de banco de dados secundário para um cluster de banco de dados primário do AlloyDB Omni.
Componentes do AlloyDB Omni
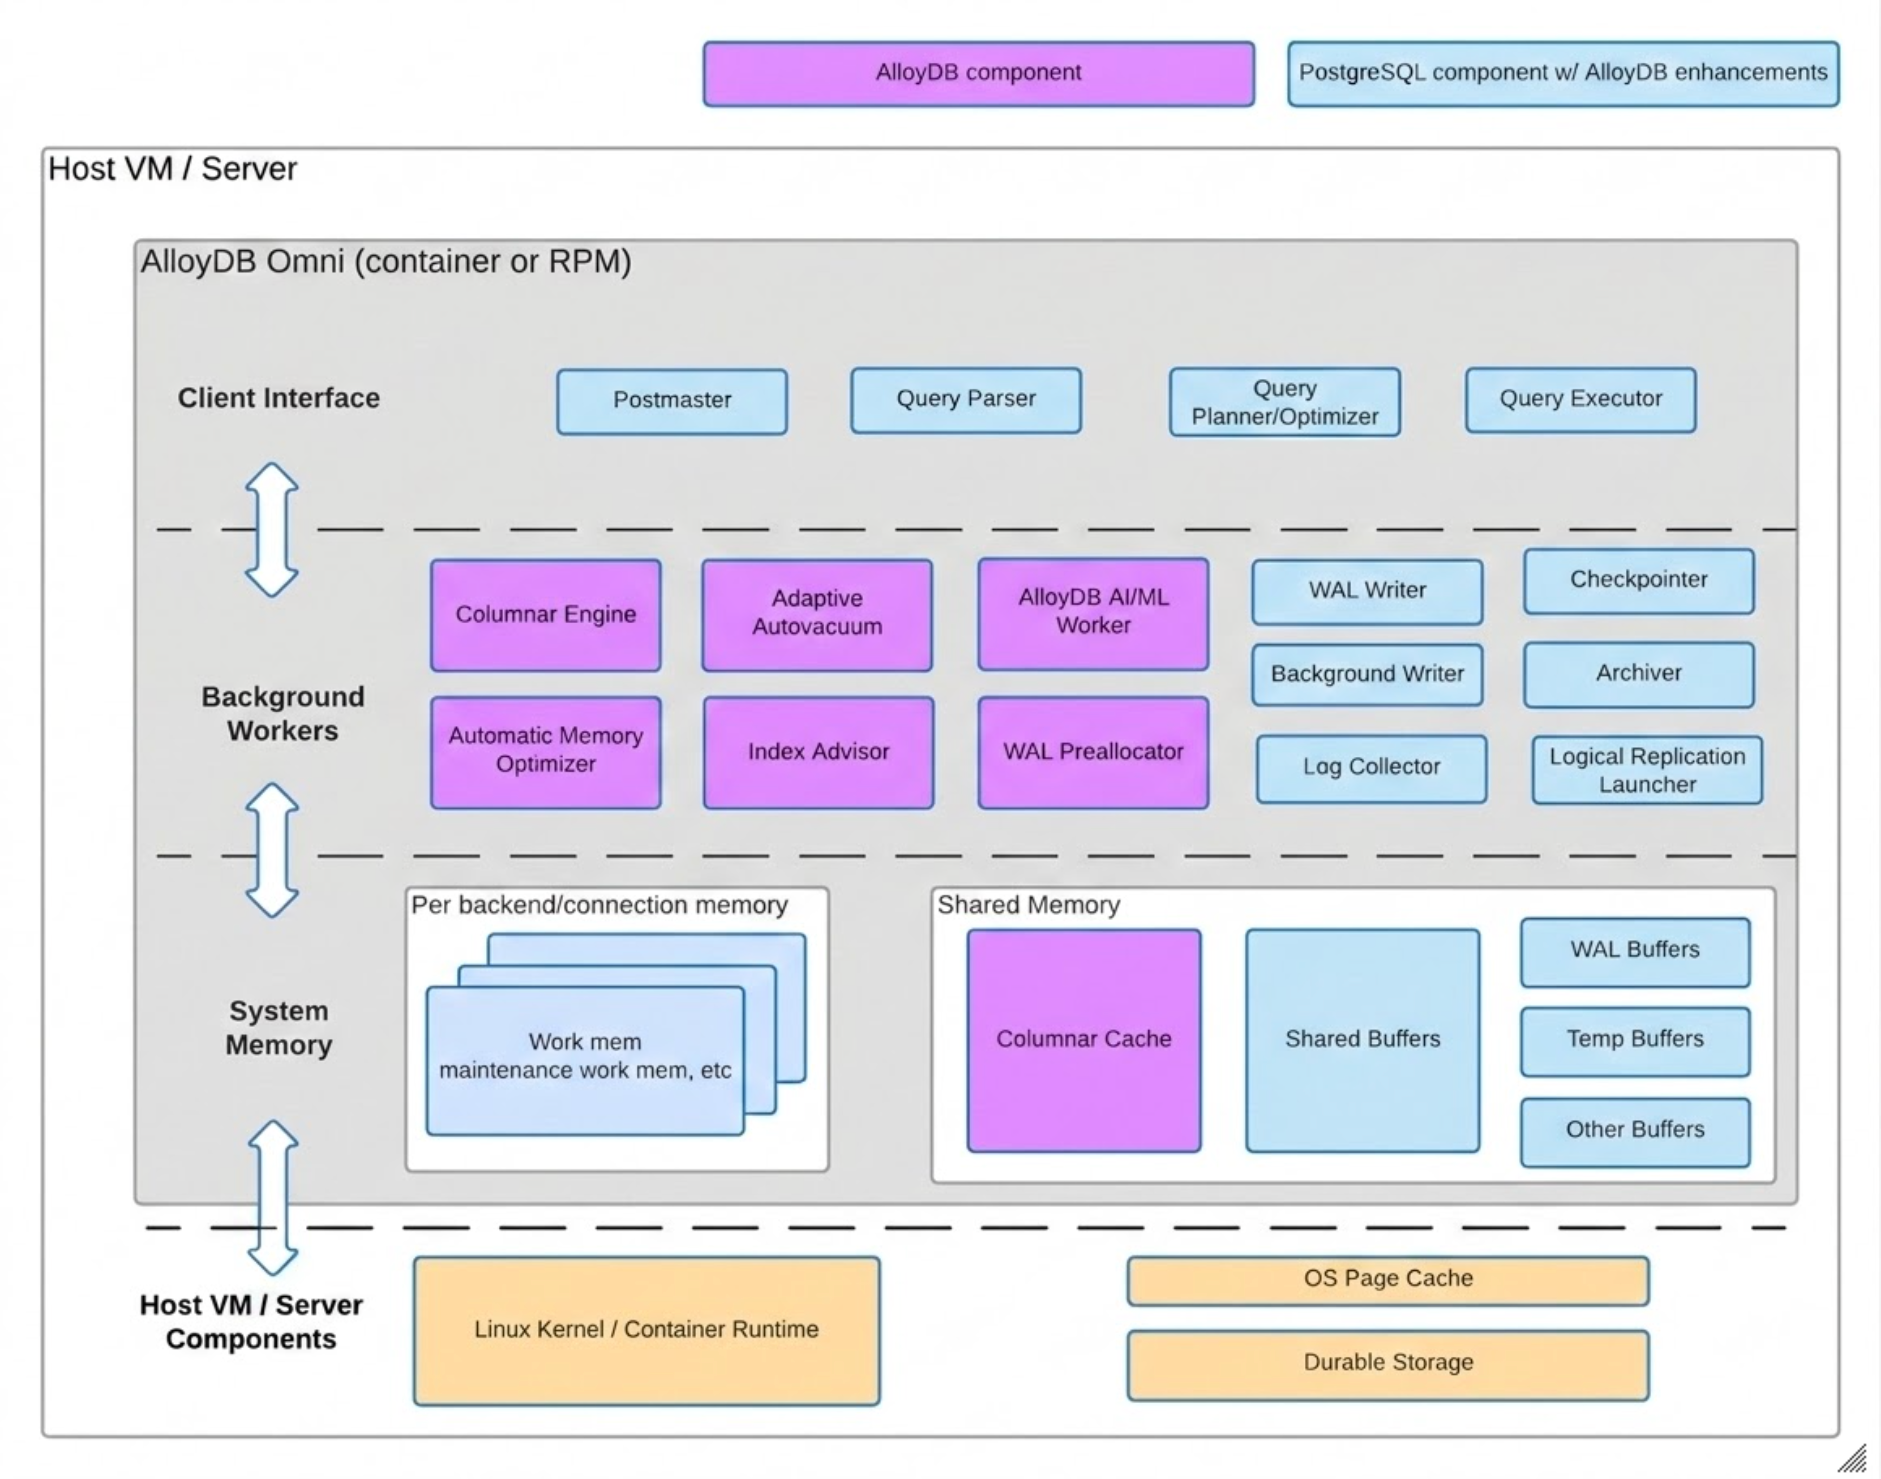
O AlloyDB Omni consiste em dois conjuntos de componentes de arquitetura: componentes do PostgreSQL com melhorias do AlloyDB Omni e componentes específicos do AlloyDB Omni.
O diagrama a seguir mostra os dois conjuntos de componentes, incluindo a camada de infraestrutura em que os componentes residem e os recursos de cada componente.
Armazenamento de dados
O AlloyDB Omni armazena dados em páginas de tamanho fixo que são armazenadas no sistema de arquivos subjacente. Quando uma consulta precisa acessar dados, o AlloyDB Omni primeiro verifica o pool de buffers. Se as páginas que contêm os dados necessários não forem encontradas no pool de buffers, o AlloyDB Omni lerá as páginas necessárias no sistema de arquivos.
Acessar dados do pool de buffers é significativamente mais rápido do que ler do sistema de arquivos. Maximizar o tamanho do pool de buffers para os dados que um aplicativo acessa é um fator importante. Se quiser, adicione uma camada de cache ultrarrápida para melhorar ainda mais o desempenho das consultas.
Gerenciamento de recursos
O AlloyDB Omni usa o gerenciamento automático de memória dinâmica para permitir que o pool de buffers aumente e diminua dinamicamente dentro dos limites configurados, dependendo das demandas de memória do sistema. Portanto, não é necessário ajustar o tamanho do pool de buffers. Ao diagnosticar problemas de desempenho, primeiro considere métricas como a taxa de ocorrência do pool de buffer e a taxa de leitura para determinar se o aplicativo está se beneficiando do pool de buffer. Caso contrário, isso indica que o conjunto de dados do aplicativo não cabe no pool de buffers, e você pode considerar o redimensionamento para uma máquina maior com mais memória.
Os processos de recuperação, filtragem, agregação, classificação e projeção de dados exigem recursos de CPU no servidor de banco de dados. Para reduzir a quantidade de recursos de CPU necessários para esse processo, minimize a quantidade de dados a serem manipulados. Monitore a utilização da CPU no servidor de banco de dados para garantir que a utilização em estado estável seja de cerca de 70%. Esse valor deixa espaço suficiente no servidor para picos de utilização ou mudanças nos padrões de acesso ao longo do tempo. A execução com uma utilização mais próxima de 100% gera sobrecarga devido à programação de processos e à alternância de contexto, além de poder criar gargalos em outras partes do sistema. A alta utilização da CPU é outra métrica importante a ser usada ao tomar decisões sobre as especificações da máquina.
As operações de entrada/saída por segundo (IOPS) são um fator importante no desempenho de aplicativos de banco de dados, medindo quantas operações de entrada ou saída por segundo o dispositivo de armazenamento subjacente pode fornecer ao banco de dados. Para evitar exceder os limites de IOPS do armazenamento do banco de dados, minimize as leituras e gravações no armazenamento. Maximize a quantidade de dados que cabe no pool de buffers ou na camada de cache.
Mecanismo colunar
O mecanismo colunar integrado acelera o processamento de consultas analíticas que normalmente envolvem verificações completas de tabelas, mesclagens complexas e agregações.
Armazenamento de colunas na memória: contém dados de tabelas e visualizações materializadas para colunas selecionadas em um formato orientado a colunas. Por padrão, o armazenamento de colunas consome 30% da memória disponível. Para alterar a quantidade de memória utilizável pelo armazenamento de colunas, defina o parâmetro
google_columnar_engine.memory_size_in_mbnopostgresql.confusado pela instância do AlloyDB Omni.Planejador de consultas e mecanismo de execução colunares: oferece suporte ao uso do armazenamento colunar em consultas.
Para mais informações, consulte Sobre o mecanismo colunar do AlloyDB para PostgreSQL.
Gerenciamento automático de memória
O gerenciador de memória automático monitora e otimiza continuamente o consumo de memória em toda uma instância do AlloyDB Omni. Quando você executa suas cargas de trabalho, esse módulo ajusta o tamanho do cache do buffer compartilhado com base na pressão de memória.
Por padrão, o gerenciador de memória automático define o limite superior como 80%
da memória do sistema e aloca 10% da memória do sistema para o cache de buffer compartilhado.
Para mudar o limite máximo do tamanho do cache de buffer compartilhado, defina o
parâmetro shared_buffers no postgresql.conf usado pela
instância do AlloyDB Omni.
Vácuo automático adaptativo
O autovacuum adaptável analisa as operações com base na carga de trabalho do banco de dados e ajusta automaticamente a frequência da limpeza. Esse ajuste automático ajuda o banco de dados a manter o desempenho ideal, mesmo quando a carga de trabalho muda, sem interferência do processo de vacuum.
O vácuo automático adaptável usa os seguintes fatores para determinar a frequência e a intensidade das operações de vácuo:
- Tamanho do banco de dados
- Número de tuplas inativas no banco de dados
- Idade dos dados no banco de dados
- Número de transações por segundo em relação à velocidade estimada do VACUUM
- Uso dos recursos
Worker de IA/ML
No AlloyDB Omni, o worker em segundo plano de IA/ML fornece os recursos necessários para chamar modelos de IA da Vertex AI diretamente do banco de dados. O worker de IA/ML é executado como um processo chamado omni ml worker.
A UI da Web
A UI da Web opcional é um console da Web autogerenciado que oferece observabilidade das instâncias do banco de dados.
Essa interface mapeia painéis gráficos para recursos personalizados, como o mecanismo colunar e as integrações de endpoints de modelo, que os visualizadores típicos de código aberto do PostgreSQL não conseguem rastrear.
Conclua as seguintes configurações opcionais para instalar e se conectar à UI da Web:
- Instalar usando contêineres
- Instalar usando o orquestrador de contêineres
- Instalar usando RPM
- Instalar usando o orquestrador RPM
Plano de controle do orquestrador
A opção de implantação do orquestrador de RPM usa um gerenciador de clusters centralizado para automatizar as operações em todo o cluster, incluindo inicialização e failover.
Interfaces de gerenciamento
A opção de implantação do orquestrador de RPM oferece um utilitário de linha de comando
(alloydbctl) e papéis do Ansible para gerenciar um ou mais clusters em grande escala.
Otimização de desempenho
A opção de implantação do orquestrador de RPM inclui suporte integrado ao PgBouncer para pooling de conexões e ao HAProxy para balanceamento de carga em endpoints de leitura e gravação e somente leitura.
A seguir
Comece a usar as seguintes opções de implantação do AlloyDB Omni:
Saiba como instalar e se conectar à UI da Web:
Gerenciar assinaturas do AlloyDB Omni no console do Google Cloud .