


AlloyDB Omni es un paquete de software de base de datos descargable que te permite implementar una versión optimizada de AlloyDB para PostgreSQL en entornos de procesamiento que administras. AlloyDB Omni y el servicio de AlloyDB completamente administrado en Google Cloud comparten los mismos componentes principales. AlloyDB usa una capa de almacenamiento desagregada nativa de la nube, mientras que AlloyDB Omni se implementa en el almacenamiento que elijas.
La portabilidad de AlloyDB Omni te permite ejecutarlo en muchos entornos, incluidos los siguientes:
- Tus centros de datos privados
- Cualquier nube pública
- Su laptop
- Instancias de VM basadas en la nube
AlloyDB Omni ofrece varias mejoras, además de PostgreSQL estándar, que admiten escalabilidad, disponibilidad, confiabilidad, rendimiento, IA y lenguaje natural. Para obtener más información, consulta Adiciones de AlloyDB Omni a PostgreSQL estándar.
Casos de uso de AlloyDB Omni
AlloyDB Omni es ideal para las siguientes situaciones:
- Necesitas una versión escalable y de alto rendimiento de PostgreSQL que debes ejecutar de forma local debido a requisitos normativos o de soberanía de los datos.
- Necesitas una base de datos que siga funcionando incluso cuando esté desconectada de Internet.
- Quieres migrar desde una base de datos heredada sin comprometerte con un servicio en la nube completamente administrado, como AlloyDB para PostgreSQL.
Características clave
- Un servidor de base de datos 100% compatible con PostgreSQL.
- Compatibilidad con AlloyDB AI, que te ayuda a crear aplicaciones de IA generativa de nivel empresarial con tus datos operativos.
- Integraciones en el ecosistema de la IA, Google Cloud lo que incluye Vertex AI Model Garden y herramientas de IA generativa de código abierto.
Compatibilidad con las funciones de piloto automático de AlloyDB para PostgreSQL en Google Cloud , que permite que AlloyDB Omni se autoadministre y se ajuste automáticamente.
Por ejemplo, AlloyDB Omni admite la administración automática de la memoria y la limpieza automática adaptable de los datos inactivos.
El motor de columnas de AlloyDB Omni, que conserva los datos relevantes en un formato de columnas en la memoria para obtener consultas analíticas, informes y cargas de trabajo de procesamiento híbrido transaccional y analítico (HTAP) más rápidos.
La interfaz de usuario web de AlloyDB Omni, que permite la supervisión gráfica de la telemetría y las auditorías de configuración de tus clústeres autoadministrados.
En las pruebas de rendimiento, las cargas de trabajo transaccionales en AlloyDB Omni son más de 2 veces más rápidas y las consultas analíticas son hasta 100 veces más rápidas que en PostgreSQL estándar.
Opciones de implementación de AlloyDB Omni
En la consola de Google Cloud , puedes explorar las opciones de implementación, acceder a los recursos de aprendizaje y administrar las licencias directamente desde la página de destino de AlloyDB Omni:
La página de destino de la consola tiene dos pestañas principales:
- Opciones de implementación: Proporciona rutas de acceso y guías personalizadas para instalar AlloyDB Omni en diferentes entornos de infraestructura, junto con acceso a codelabs y demostraciones de IA.
- Suscripciones: Centraliza la administración de licencias para las implementaciones de producción. Puedes calcular y comprar licencias según el recuento total de CPU virtuales, escalar las CPU virtuales, ver los costos y administrar los descuentos por compromiso.
Puedes instalar AlloyDB Omni con una de las siguientes opciones de implementación:
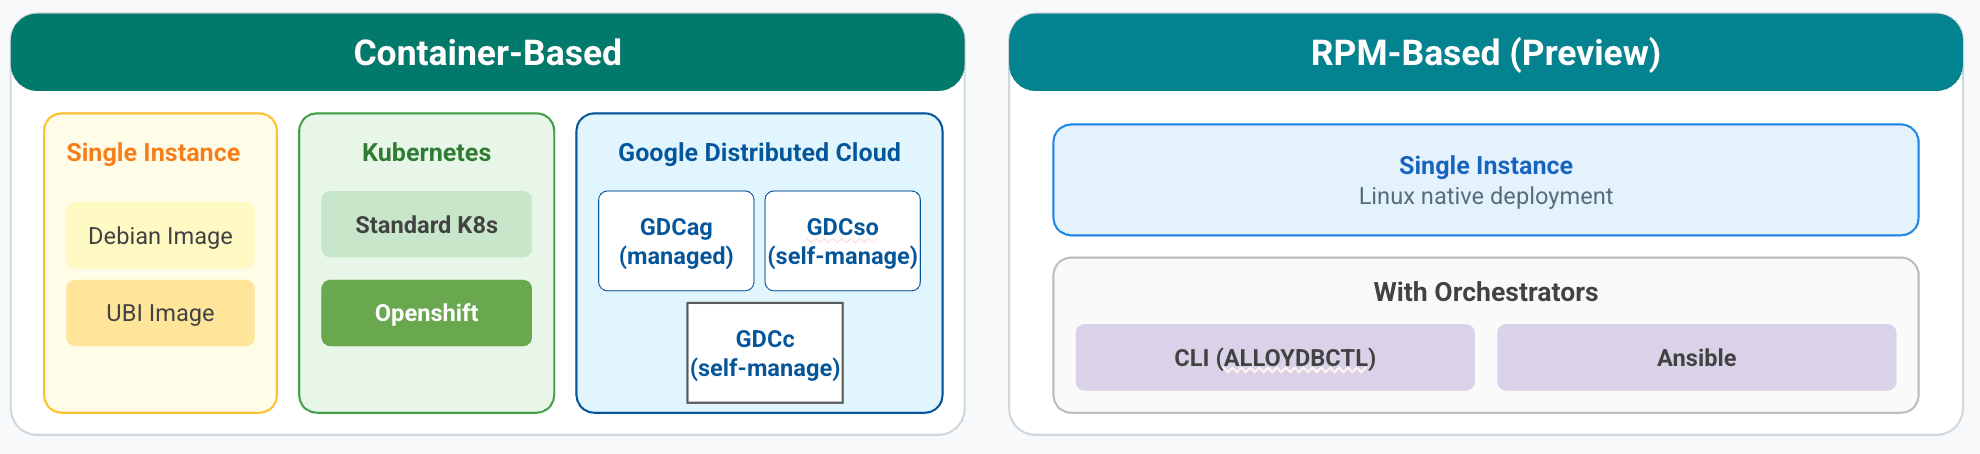
AlloyDB Omni con contenedores: un contenedor de base de datos independiente. Ejecuta AlloyDB Omni en un sistema Linux con almacenamiento SSD y al menos 8 GB de memoria por CPU.
AlloyDB Omni con el organizador de contenedores: es parte de un contenedor en un entorno de Kubernetes. El operador de Kubernetes de AlloyDB Omni es una extensión de la API de Kubernetes que te permite ejecutar AlloyDB Omni en la mayoría de los entornos de Kubernetes compatibles con CNCF.
El operador de AlloyDB Omni simplifica las operaciones básicas de la base de datos, lo que te permite automatizar las implementaciones de disponibilidad única o alta disponibilidad (HA) y las operaciones del día 2, como la copia de seguridad, el restablecimiento, la conmutación por error y la configuración de la recuperación ante desastres (DR) entre regiones.
AlloyDB Omni con RPM: Es un paquete independiente que se ejecuta directamente en una VM o en un equipo físico. AlloyDB Omni con RPM se ejecuta como un conjunto de componentes de software integrados directamente en el sistema operativo host. Usa el sistema de archivos estándar de Linux para el almacenamiento, lo que te permite usar tu infraestructura de almacenamiento y tus prácticas de administración existentes.
AlloyDB Omni con el organizador RPM: una implementación de Red Hat Package Manager (RPM) para VMs o servidores físicos. Esta opción incluye una plataforma de organización que automatiza la implementación y la administración en entornos que no son de Kubernetes. Extiende la flexibilidad similar a la de la nube a la infraestructura que elijas, sin necesidad de capas de creación de contenedores como Docker.
Tus aplicaciones se conectan a tu base de datos de AlloyDB Omni y se comunican con ella, así como se conectan a un servidor de base de datos de PostgreSQL estándar y se comunican con él. El control de acceso de los usuarios también se basa en los estándares de PostgreSQL.
Puedes configurar el comportamiento de la base de datos de AlloyDB Omni con marcas de base de datos, incluidos el registro, la limpieza y el motor de columnas. Para obtener más información, consulta Opciones de descarga e instalación de AlloyDB Omni disponibles.
AlloyDB Omni como contenedor
Google distribuye AlloyDB Omni como un contenedor que puedes ejecutar con entornos de ejecución de contenedores, como Docker y Podman. También puedes implementar contenedores de AlloyDB Omni en un entorno de Kubernetes con muchas operaciones básicas automatizadas.
Desde el punto de vista operativo, los contenedores ofrecen las siguientes ventajas:
- Administración de dependencias transparente: Todas las dependencias necesarias se agrupan en el contenedor y Google las prueba para garantizar que sean totalmente compatibles con AlloyDB Omni.
- Portabilidad: puedes esperar que AlloyDB Omni funcione de manera coherente en todos los entornos.
- Aislamiento de seguridad: Eliges a qué tiene acceso el contenedor de AlloyDB Omni en la máquina anfitrión.
- Administración de recursos: puedes definir la cantidad de recursos de procesamiento que deseas que use el contenedor de AlloyDB Omni.
- Aplicación de parches y actualizaciones sin interrupciones: Para aplicar un parche a un contenedor, reemplaza la imagen existente por una nueva.
AlloyDB Omni en un entorno de RHEL
AlloyDB Omni proporciona dos opciones de implementación para un entorno de RHEL, que dependen de tus requisitos de automatización y escalamiento.
AlloyDB Omni con RPM
La opción de implementación de RPM es una instalación independiente de Red Hat Package Manager (RPM) diseñada para entornos en los que deseas una base de datos de AlloyDB Omni sin contenedores. Esta opción admite RHEL 9 y Rocky Linux 9.
- Integración directa en el SO: Se ejecuta como un conjunto de componentes de software integrados directamente en el sistema operativo (SO) host.
- Almacenamiento existente: usa el sistema de archivos estándar de Linux (ext4 y xfs), que admite la infraestructura de almacenamiento y las prácticas de administración existentes.
- Simplicidad: Es ideal para configuraciones de instancia única en las que se requiere una integración profunda con el SO host, sin capas de organización adicionales.
El organizador de RPM
La opción de implementación del organizador de RPM usa los mismos paquetes de RPM que AlloyDB Omni con RPM, pero agrega una plataforma de organización para automatizar la administración en entornos que no son de Kubernetes.
- Flexibilidad similar a la de la nube: extiende la automatización a la infraestructura local, lo que permite controlar el arranque, la conmutación por error y la administración del ciclo de vida.
- Frameworks de automatización: Se integra con herramientas populares, como Ansible, lo que permite que los equipos usen conjuntos de habilidades existentes. También puedes usar herramientas de línea de comandos diseñadas para un propósito específico.
- Funciones empresariales: Diseñadas específicamente para admitir la alta disponibilidad (HA) y la recuperación ante desastres (DR) a través de un administrador de clústeres centralizado.
Copia de seguridad de datos y recuperación ante desastres
AlloyDB Omni cuenta con un sistema de copia de seguridad y recuperación continuas que te permite crear un clúster de base de datos nuevo basado en cualquier momento dentro de un período de retención ajustable. Esto te permite recuperarte de accidentes de pérdida de datos.
Además, AlloyDB Omni puede crear y almacenar copias de seguridad completas de los datos de tu clúster de base de datos, ya sea a pedido o de forma periódica. En cualquier momento, puedes restablecer desde una copia de seguridad a un clúster de bases de datos de AlloyDB Omni que contenga todos los datos del clúster de bases de datos original en el momento en que se creó la copia de seguridad.
Como método adicional de recuperación ante desastres, puedes lograr la replicación entre centros de datos creando clústeres de bases de datos secundarios en centros de datos independientes. AlloyDB Omni transmite datos de forma asíncrona desde un clúster de base de datos principal designado a cada uno de sus clústeres secundarios. Cuando sea necesario, puedes ascender un clúster de base de datos secundario a un clúster de base de datos principal de AlloyDB Omni.
Componentes de AlloyDB Omni
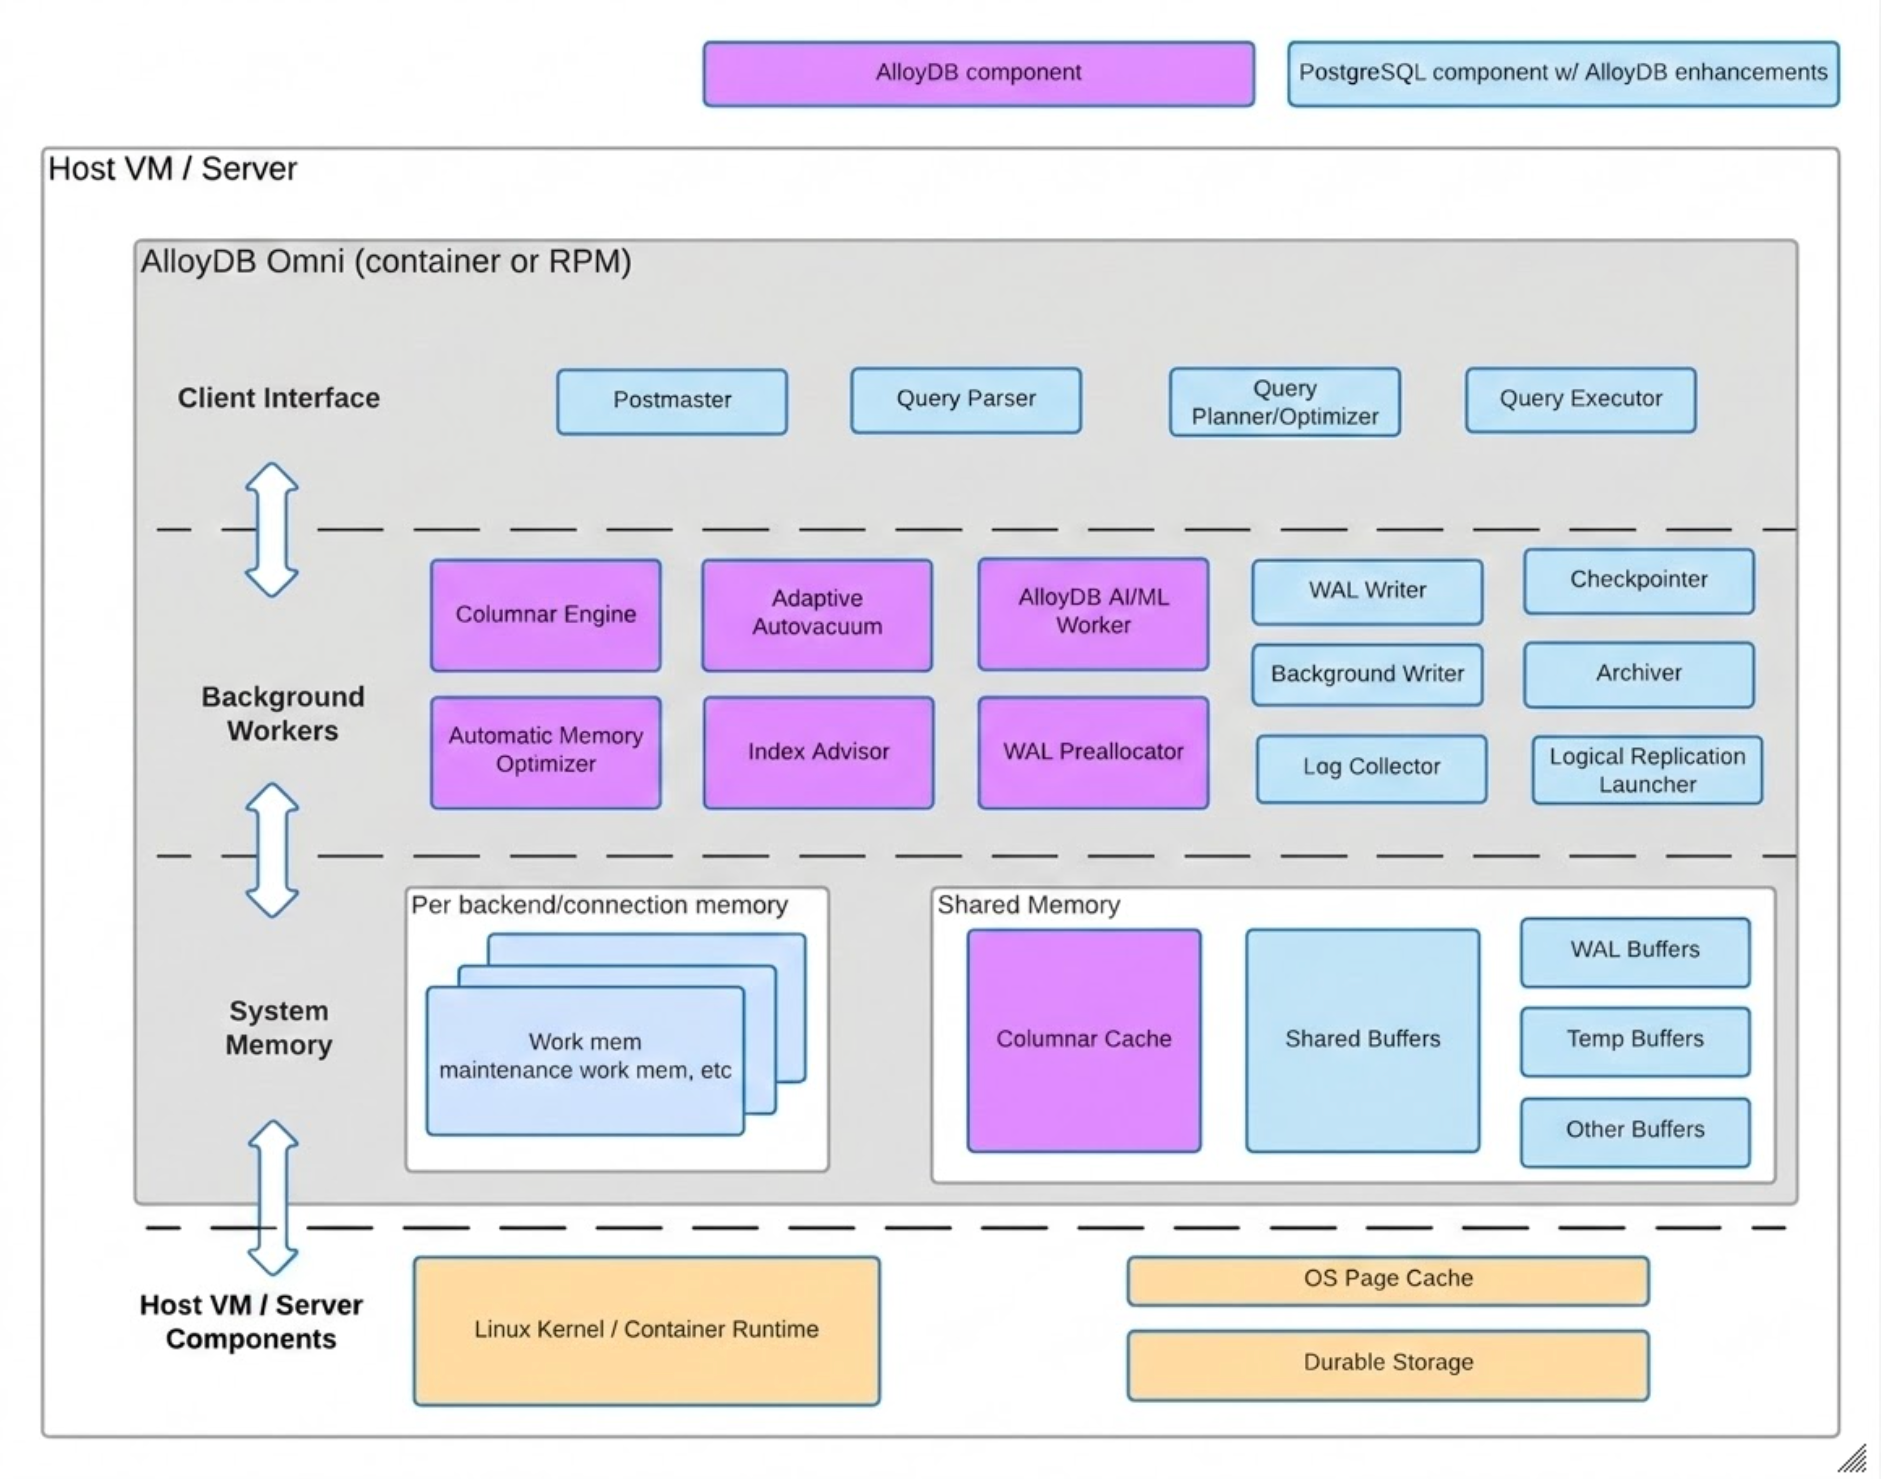
AlloyDB Omni consta de dos conjuntos de componentes de arquitectura: componentes de PostgreSQL con mejoras de AlloyDB Omni y componentes específicos de AlloyDB Omni.
En el siguiente diagrama, se muestran ambos conjuntos de componentes, incluida la capa de infraestructura en la que residen los componentes y las funciones de cada componente.
Almacenamiento de datos
AlloyDB Omni almacena datos en páginas de tamaño fijo que se guardan en el sistema de archivos subyacente. Cuando una consulta necesita acceder a los datos, AlloyDB Omni primero verifica el grupo de búferes. Si las páginas que contienen los datos requeridos no se encuentran en el grupo de búferes, AlloyDB Omni lee las páginas requeridas del sistema de archivos.
Acceder a los datos desde el grupo de búferes es mucho más rápido que leer desde el sistema de archivos. Maximizar el tamaño del grupo de búferes para los datos a los que accede una aplicación es un factor importante. De manera opcional, puedes agregar una capa de almacenamiento en caché ultrarrápida para mejorar aún más el rendimiento de las consultas.
Administración de recursos
AlloyDB Omni usa la administración automática de la memoria dinámica para permitir que el grupo de búferes crezca y se reduzca de forma dinámica dentro de los límites configurados según las demandas de memoria del sistema. Por lo tanto, no es necesario ajustar el tamaño del grupo de búferes. Cuando diagnostiques problemas de rendimiento, primero considera métricas como la tasa de aciertos del grupo de búferes y la tasa de lectura para determinar si tu aplicación se beneficia del grupo de búferes. De lo contrario, significa que el conjunto de datos de la aplicación no cabe en el grupo de búferes, por lo que deberías considerar cambiar el tamaño a una máquina más grande con más memoria.
Los procesos de recuperación, filtrado, agregación, ordenamiento y proyección de datos requieren recursos de CPU en el servidor de la base de datos. Para reducir la cantidad de recursos de CPU necesarios para este proceso, minimiza la cantidad de datos que se manipularán. Supervisa el uso de CPU en el servidor de la base de datos para asegurarte de que el uso en estado estable sea de alrededor del 70%. Esta cantidad deja suficiente margen en el servidor para los picos de uso o los cambios en los patrones de acceso con el tiempo. Ejecutar con un uso cercano al 100% genera sobrecarga debido a la planificación de procesos y el cambio de contexto, y puede crear cuellos de botella en otras partes del sistema. El uso de CPU alto es otra métrica clave que se debe usar cuando se toman decisiones sobre las especificaciones de la máquina.
Las operaciones de entrada y salida por segundo (IOPS) son un factor importante en el rendimiento de las aplicaciones de bases de datos, ya que miden cuántas operaciones de entrada o salida por segundo puede entregar el dispositivo de almacenamiento subyacente a la base de datos. Para evitar exceder los límites de IOPS del almacenamiento de la base de datos, minimiza las lecturas y escrituras en el almacenamiento. Maximiza la cantidad de datos que caben en el grupo de búferes o en la capa de caché.
Motor de columnas
El motor de columnas integrado acelera el procesamiento de consultas analíticas que, por lo general, implica análisis de tablas completos, uniones complejas y agregaciones.
Almacén de columnas en memoria: contiene datos de tablas y vistas materializadas para las columnas seleccionadas en un formato orientado a columnas. De forma predeterminada, el almacén de columnas consume el 30% de la memoria disponible. Para cambiar la cantidad de memoria que puede usar el almacén de columnas, establece el parámetro
google_columnar_engine.memory_size_in_mben elpostgresql.confque usa tu instancia de AlloyDB Omni.Motor de ejecución y plan de consultas en columnas: admite el uso del almacén de columnas en las consultas.
Para obtener más información, consulta Acerca del motor de columnas de AlloyDB para PostgreSQL.
Administración automática de la memoria
El administrador automático de la memoria supervisa y optimiza de forma continua el consumo de memoria en toda una instancia de AlloyDB Omni. Cuando ejecutas tus cargas de trabajo, este módulo ajusta el tamaño de la caché del búfer compartido según la presión de la memoria.
De forma predeterminada, el administrador automático de memoria establece el límite superior en el 80%
de la memoria del sistema y asigna el 10% de la memoria del sistema para la caché de búfer compartido.
Para cambiar el límite superior del tamaño de la caché del búfer compartido, establece el
parámetro shared_buffers en el postgresql.conf que usa tu
instancia de AlloyDB Omni.
Limpieza automática adaptable
La limpieza automática adaptable analiza las operaciones en función de la carga de trabajo de la base de datos y ajusta automáticamente la frecuencia de la limpieza. Este ajuste automático ayuda a la base de datos a mantener un rendimiento óptimo, incluso cuando cambia la carga de trabajo, sin interferencias del proceso de limpieza.
La limpieza automática adaptable usa los siguientes factores para determinar la frecuencia y la intensidad de las operaciones de limpieza:
- Tamaño de la base de datos
- Cantidad de tuplas inactivas en la base de datos
- Antigüedad de los datos en la base de datos
- Cantidad de transacciones por segundo en comparación con la velocidad de vacuum estimada
- Uso de recursos
Trabajador de IA/AA
En AlloyDB Omni, el trabajador en segundo plano de IA/AA proporciona las capacidades necesarias para llamar a los modelos de IA de Vertex AI directamente desde la base de datos. El trabajador de IA/AA se ejecuta como un proceso llamado omni ml worker.
La IU web
La IU web opcional es una consola web autoadministrada que te brinda observabilidad de tus instancias de base de datos.
Esta interfaz asigna paneles gráficos para funciones personalizadas, como las integraciones de extremos de modelos y motores de columnas, que los visualizadores típicos de PostgreSQL de código abierto no pueden seguir.
Completa los siguientes pasos opcionales para instalar la IU web y conectarte a ella:
- Instala con contenedores
- Instala con el organizador de contenedores
- Instala con RPM
- Instala con el organizador de RPM
Plano de control del organizador
La opción de implementación del organizador de RPM usa un administrador de clústeres centralizado para automatizar las operaciones en todo el clúster, incluidos el inicio y la conmutación por error.
Interfaces de administración
La opción de implementación del organizador de RPM proporciona una utilidad de línea de comandos
(alloydbctl) y roles de Ansible para que puedas administrar uno o más clústeres a gran escala.
Optimización del rendimiento
La opción de implementación del organizador de RPM incluye compatibilidad integrada con PgBouncer para la agrupación de conexiones y HAProxy para el balanceo de cargas en extremos de lectura y escritura, y de solo lectura.
¿Qué sigue?
Comienza a usar las siguientes opciones de implementación de AlloyDB Omni:
Obtén información para instalar la IU web y conectarte a ella:
Administra las suscripciones a AlloyDB Omni en la consola de Google Cloud .