


AlloyDB Omni ist ein herunterladbares Datenbanksoftwarepaket, mit dem Sie eine optimierte Version von AlloyDB for PostgreSQL in von Ihnen verwalteten Computing-Umgebungen bereitstellen können. AlloyDB Omni und der vollständig verwaltete AlloyDB-Dienst in Google Cloudverwenden dieselben Kernkomponenten. AlloyDB verwendet eine cloudnative disaggregierte Speicherebene, während AlloyDB Omni auf dem Speicher Ihrer Wahl bereitgestellt wird.
Dank der Portabilität von AlloyDB Omni können Sie es in vielen Umgebungen ausführen, darunter:
- Ihre privaten Rechenzentren
- Beliebige öffentliche Cloud
- Dein Laptop
- Cloudbasierte VM-Instanzen
AlloyDB Omni bietet zusätzlich zu Standard-PostgreSQL mehrere Verbesserungen, die Skalierbarkeit, Verfügbarkeit, Zuverlässigkeit, Leistung, KI und natürliche Sprache unterstützen. Weitere Informationen finden Sie unter AlloyDB Omni-Ergänzungen für Standard-PostgreSQL.
Anwendungsfälle für AlloyDB Omni
AlloyDB Omni eignet sich gut für die folgenden Szenarien:
- Sie benötigen eine skalierbare, leistungsstarke Version von PostgreSQL, die Sie aufgrund von gesetzlichen oder Datenhoheitsanforderungen lokal ausführen müssen.
- Sie benötigen eine Datenbank, die auch dann weiter ausgeführt wird, wenn sie vom Internet getrennt ist.
- Sie möchten von einer Legacy-Datenbank migrieren, ohne sich an einen vollständig verwalteten Clouddienst wie AlloyDB for PostgreSQL zu binden.
Wichtige Features
- Ein zu 100% PostgreSQL-kompatibler Datenbankserver.
- Unterstützung für AlloyDB AI, mit der Sie mithilfe Ihrer Betriebsdaten generative KI-Anwendungen auf Unternehmensniveau erstellen können.
- Integrationen in das KI-Ökosystem von Google Cloud , einschließlich Vertex AI Model Garden und Open-Source-Tools für generative KI.
Unterstützung für Autopilot-Funktionen von AlloyDB for PostgreSQL inGoogle Cloud , mit denen AlloyDB Omni sich selbst verwalten und optimieren kann.
AlloyDB Omni unterstützt beispielsweise die automatische Speicherverwaltung und die adaptive automatische Bereinigung veralteter Daten.
Die spaltenbasierte AlloyDB Omni-Engine, die relevante Daten in einem speicherinternen Spaltenformat speichert, um die Leistung von analytischen Abfragen, Berichten sowie Arbeitslasten von hybriden transaktionsorientierten und analytischen Verarbeitungen (HTAP) zu verbessern.
Die AlloyDB Omni-Web-Benutzeroberfläche, die grafisches Telemetrie-Monitoring und Konfigurationsprüfungen für Ihre selbstverwalteten Cluster ermöglicht.
In Leistungstests sind Transaktionsarbeitslasten in AlloyDB Omni mehr als doppelt so schnell und analytische Abfragen bis zu 100-mal schneller als in Standard-PostgreSQL.
Bereitstellungsoptionen für AlloyDB Omni
In der Google Cloud Console können Sie Bereitstellungsoptionen erkunden, auf Lernressourcen zugreifen und Lizenzen direkt über die Landingpage AlloyDB Omni verwalten:
Die Landingpage der Konsole enthält zwei Haupttabs:
- Bereitstellungsoptionen: Bietet maßgeschneiderte Pfade und Anleitungen für die Installation von AlloyDB Omni in verschiedenen Infrastrukturumgebungen sowie Zugriff auf Codelabs und KI-Demos.
- Abos: Zentralisiert die Lizenzverwaltung für Produktionsbereitstellungen. Sie können Lizenzen basierend auf der Gesamtzahl der vCPUs berechnen und erwerben, vCPUs skalieren, Kosten ansehen und Rabatte für zugesicherte Nutzung verwalten.
Sie können AlloyDB Omni mit einer der folgenden Bereitstellungsoptionen installieren:
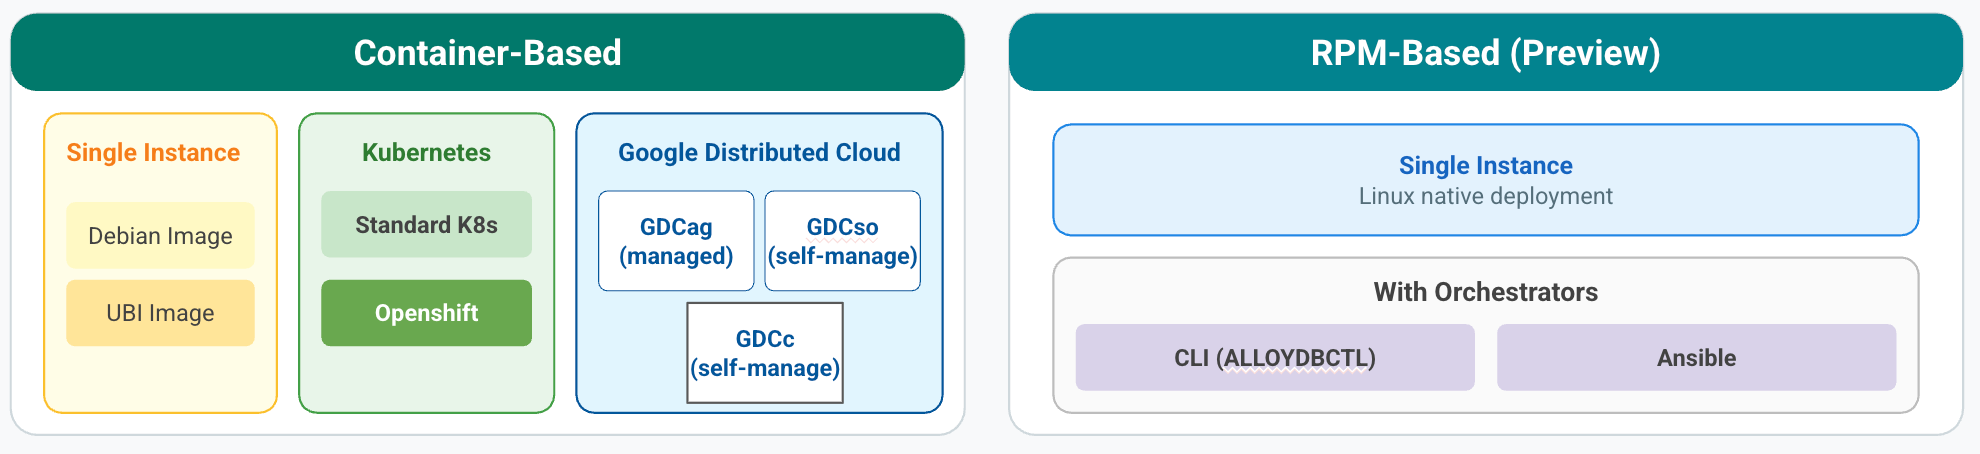
AlloyDB Omni mit Containern: ein eigenständiger Datenbankcontainer. Führen Sie AlloyDB Omni auf einem Linux-System mit SSD-Speicher und mindestens 8 GB Arbeitsspeicher pro CPU aus.
AlloyDB Omni mit dem Container-Orchestrator: Teil eines Containers in einer Kubernetes-Umgebung. Der AlloyDB Omni Kubernetes-Operator ist eine Erweiterung der Kubernetes API, mit der Sie AlloyDB Omni in den meisten CNCF-kompatiblen Kubernetes-Umgebungen ausführen können.
Der AlloyDB Omni-Operator vereinfacht grundlegende Datenbankvorgänge, sodass Sie Bereitstellungen mit einer einzelnen Instanz oder Hochverfügbarkeit (HA) sowie Day-2-Vorgänge wie Sicherung, Wiederherstellung, Failover und die Einrichtung von regionenübergreifender Notfallwiederherstellung (DR) automatisieren können.
AlloyDB Omni mit RPM: Ein eigenständiges Paket, das direkt auf einer VM oder Bare-Metal-Hardware ausgeführt wird. AlloyDB Omni mit RPM wird als eine Reihe integrierter Softwarekomponenten direkt auf dem Host-Betriebssystem ausgeführt. Für die Speicherung wird das Standard-Linux-Dateisystem verwendet, sodass Sie Ihre vorhandene Speicherinfrastruktur und Verwaltungsmethoden nutzen können.
AlloyDB Omni mit dem RPM-Orchestrator: Eine RPM-Bereitstellung (Red Hat Package Manager) für VMs oder Bare-Metal-Server. Diese Option umfasst eine Orchestrierungsplattform, die die Bereitstellung und Verwaltung in Nicht-Kubernetes-Umgebungen automatisiert. Sie bietet cloudähnliche Flexibilität für die Infrastruktur Ihrer Wahl, ohne dass Containerisierungsebenen wie Docker erforderlich sind.
Ihre Anwendungen stellen eine Verbindung zu Ihrer AlloyDB Omni-Datenbank her und kommunizieren mit ihr, so wie Anwendungen eine Verbindung zu einem Standard-PostgreSQL-Datenbankserver herstellen und mit ihm kommunizieren. Die Nutzerzugriffssteuerung basiert ebenfalls auf PostgreSQL-Standards.
Sie können das Verhalten der AlloyDB Omni-Datenbank mit Datenbank-Flags konfigurieren, einschließlich Logging, Vacuuming und der spaltenbasierten Engine. Weitere Informationen finden Sie unter Verfügbare Download- und Installationsoptionen für AlloyDB Omni.
AlloyDB Omni als Container
Google stellt AlloyDB Omni als Container bereit, den Sie mit Containerlaufzeiten wie Docker und Podman ausführen können. Sie können AlloyDB Omni-Container auch in einer Kubernetes-Umgebung bereitstellen, in der viele grundlegende Vorgänge automatisiert sind.
Aus betrieblicher Sicht bieten Container die folgenden Vorteile:
- Transparentes Abhängigkeitsmanagement: Alle erforderlichen Abhängigkeiten sind im Container gebündelt und werden von Google getestet, um sicherzustellen, dass sie vollständig mit AlloyDB Omni kompatibel sind.
- Übertragbarkeit: AlloyDB Omni funktioniert in allen Umgebungen einheitlich.
- Sicherheitsisolation: Sie wählen aus, worauf der AlloyDB Omni-Container auf dem Hostcomputer zugreifen kann.
- Ressourcenverwaltung: Sie können die Menge an Rechenressourcen definieren, die der AlloyDB Omni-Container verwenden soll.
- Nahtloses Patchen und Upgrades: Wenn Sie einen Container patchen möchten, ersetzen Sie das vorhandene Image durch ein neues.
AlloyDB Omni in einer RHEL-Umgebung
AlloyDB Omni bietet zwei Bereitstellungsoptionen für eine RHEL-Umgebung, die von Ihren Automatisierungs- und Skalierungsanforderungen abhängen.
AlloyDB Omni mit RPM
Die RPM-Bereitstellungsoption ist eine eigenständige RPM-Installation (Red Hat Package Manager) für Umgebungen, in denen Sie eine nicht containerisierte AlloyDB Omni-Datenbank verwenden möchten. Diese Option unterstützt RHEL 9 und Rocky Linux 9.
- Direkte Betriebssystemintegration: Wird als eine Reihe integrierter Softwarekomponenten direkt auf dem Hostbetriebssystem ausgeführt.
- Vorhandener Speicher: Verwendet das Linux-Standarddateisystem (ext4 und xfs), das die vorhandene Speicherinfrastruktur und Verwaltungspraktiken unterstützt.
- Einfachheit: Gut geeignet für Setups mit einer einzelnen Instanz, bei denen eine tiefe Integration in das Host-Betriebssystem erforderlich ist, ohne zusätzliche Orchestrierungsebenen.
Der RPM-Orchestrator
Bei der Bereitstellungsoption mit dem RPM-Orchestrator werden dieselben RPM-Pakete wie bei AlloyDB Omni mit RPM verwendet. Es wird jedoch eine Orchestrierungsplattform hinzugefügt, um die Verwaltung in Nicht-Kubernetes-Umgebungen zu automatisieren.
- Cloud-ähnliche Flexibilität: Erweitert die Automatisierung auf die lokale Infrastruktur und übernimmt Bootstrapping, Failover und Lebenszyklusverwaltung.
- Automatisierungs-Frameworks: Lässt sich in gängige Tools wie Ansible einbinden, sodass Teams vorhandene Fähigkeiten nutzen können. Sie können auch speziell entwickelte Befehlszeilentools verwenden.
- Enterprise-Features: Speziell für die Unterstützung von Hochverfügbarkeit (HA) und Notfallwiederherstellung (DR) über einen zentralen Cluster-Manager entwickelt.
Datensicherung und Wiederherstellung im Notfall
AlloyDB Omni bietet ein System für die kontinuierliche Sicherung und Wiederherstellung, mit dem Sie einen neuen Datenbankcluster basierend auf einem beliebigen Zeitpunkt innerhalb einer anpassbaren Aufbewahrungsdauer erstellen können. So können Sie Datenverluste rückgängig machen.
Darüber hinaus kann AlloyDB Omni vollständige Sicherungen der Daten Ihres Datenbankclusters erstellen und speichern, entweder on demand oder nach einem regelmäßigen Zeitplan. Sie können jederzeit eine Sicherung in einem AlloyDB Omni-Datenbankcluster wiederherstellen, der alle Daten aus dem ursprünglichen Datenbankcluster zum Zeitpunkt der Erstellung der Sicherung enthält.
Als weitere Methode zur Notfallwiederherstellung können Sie eine rechenzentrumsübergreifende Replikation erreichen, indem Sie sekundäre Datenbankcluster in separaten Rechenzentren erstellen. AlloyDB Omni streamt Daten asynchron von einem festgelegten primären Datenbankcluster an jeden seiner sekundären Cluster. Bei Bedarf können Sie einen sekundären Datenbankcluster zu einem primären AlloyDB Omni-Datenbankcluster hochstufen.
AlloyDB Omni-Komponenten
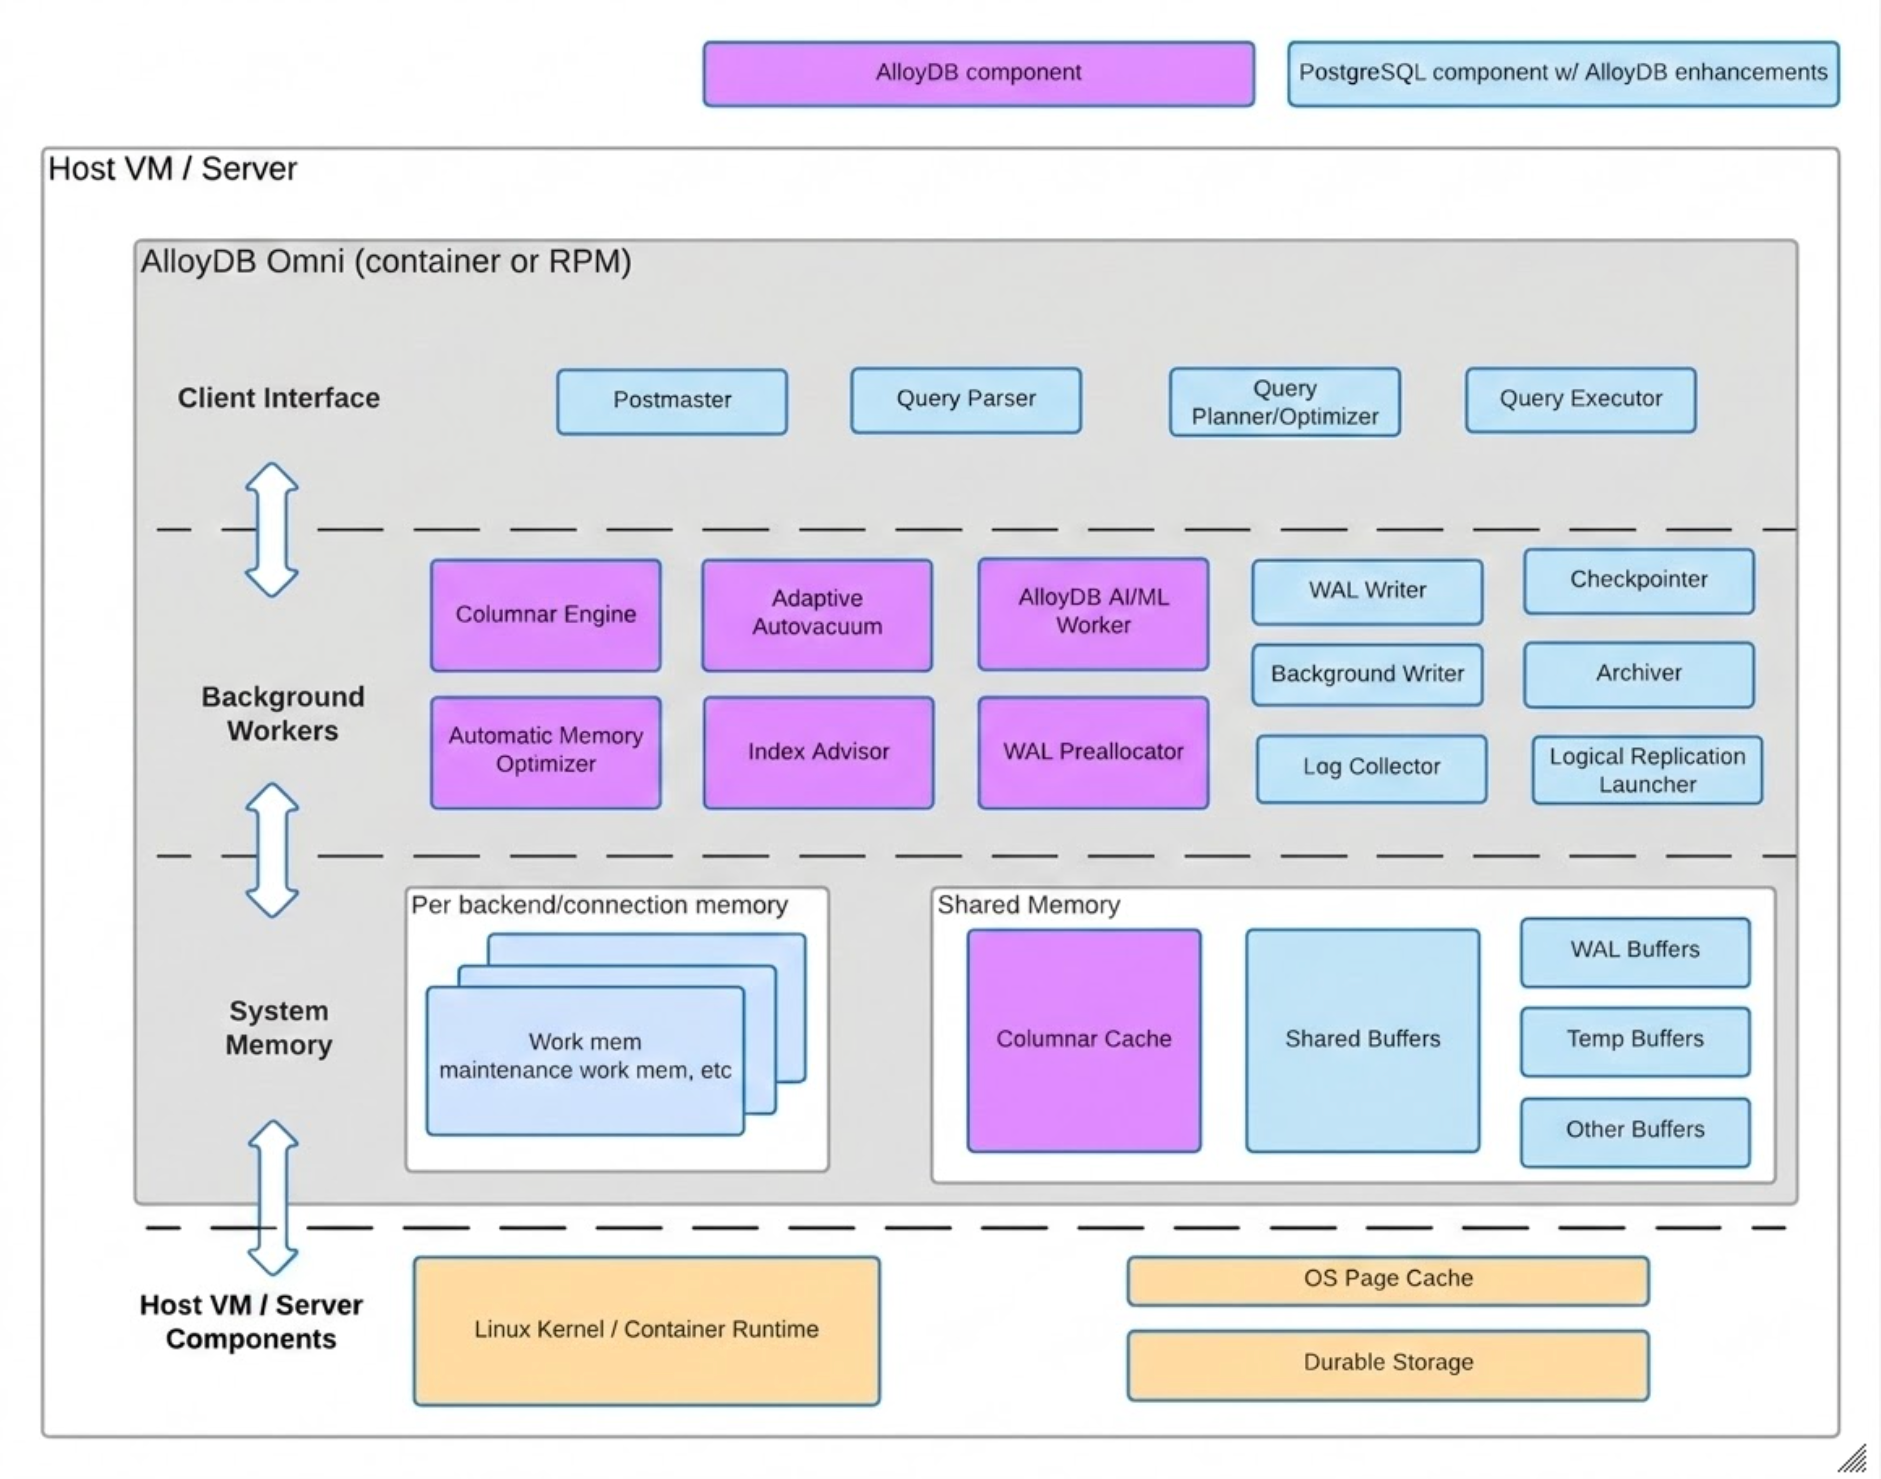
AlloyDB Omni besteht aus zwei Gruppen von Architekturkomponenten: PostgreSQL-Komponenten mit AlloyDB Omni-Erweiterungen und AlloyDB Omni-spezifischen Komponenten.
Das folgende Diagramm zeigt beide Komponentensätze, einschließlich der Infrastrukturebene, in der sich die Komponenten befinden, und der Features für jede Komponente.
Datenspeicher
AlloyDB Omni speichert Daten in Seiten mit fester Größe, die im zugrunde liegenden Dateisystem gespeichert werden. Wenn eine Abfrage auf Daten zugreifen muss, prüft AlloyDB Omni zuerst den Zwischenspeicherpool. Wenn die Seiten mit den erforderlichen Daten nicht im Pufferpool gefunden werden, liest AlloyDB Omni die erforderlichen Seiten aus dem Dateisystem.
Der Zugriff auf Daten aus dem Zwischenspeicherpool ist deutlich schneller als das Lesen aus dem Dateisystem. Die Maximierung der Pufferpoolgröße für die Daten, auf die eine Anwendung zugreift, ist ein wichtiger Faktor. Optional können Sie eine ultraschnelle Cache-Ebene hinzufügen, um die Abfrageleistung weiter zu verbessern.
Ressourcenverwaltung
AlloyDB Omni verwendet eine automatische dynamische Speicherverwaltung, damit der Pufferpool je nach Speicherbedarf des Systems innerhalb der konfigurierten Grenzen dynamisch wachsen und schrumpfen kann. Daher ist es nicht erforderlich, die Größe des Pufferpools anzupassen. Wenn Sie Leistungsprobleme diagnostizieren, sollten Sie zuerst Messwerte wie die Trefferrate des Zwischenspeicherpools und die Leserate berücksichtigen, um festzustellen, ob Ihre Anwendung vom Zwischenspeicherpool profitiert. Wenn nicht, bedeutet dies, dass das Dataset der Anwendung nicht in den Zwischenspeicherpool passt. Sie sollten dann die Größe auf eine größere Maschine mit mehr Arbeitsspeicher ändern.
Das Abrufen, Filtern, Aggregieren, Sortieren und Projizieren von Daten erfordert CPU-Ressourcen auf dem Datenbankserver. Wenn Sie die für diesen Prozess erforderlichen CPU-Ressourcen reduzieren möchten, minimieren Sie die Menge der zu bearbeitenden Daten. Überwachen Sie die CPU-Auslastung auf dem Datenbankserver, um sicherzustellen, dass die Auslastung im stabilen Zustand bei etwa 70 % liegt. Dieser Betrag lässt auf dem Server genügend Spielraum für Nutzungsspitzen oder Änderungen der Zugriffsmuster im Laufe der Zeit. Eine Auslastung von fast 100% führt zu Mehraufwand durch Prozessplanung und Kontextwechsel und kann zu Engpässen in anderen Teilen des Systems führen. Eine hohe CPU-Auslastung ist ein weiterer wichtiger Messwert, der bei Entscheidungen über Maschinenspezifikationen herangezogen werden sollte.
Eingabe-/Ausgabevorgänge pro Sekunde (IOPS) sind ein wichtiger Faktor für die Leistung von Datenbankanwendungen. Sie geben an, wie viele Eingabe- oder Ausgabevorgänge pro Sekunde das zugrunde liegende Speichergerät an die Datenbank liefern kann. Um die IOPS-Limits des Datenbankspeichers nicht zu überschreiten, sollten Sie die Lese- und Schreibvorgänge im Speicher minimieren. Maximieren Sie die Datenmenge, die in den Zwischenspeicherpool oder in die Cache-Ebene passt.
Spaltenbasierte Engine
Die integrierte spaltenbasierte Engine beschleunigt die Verarbeitung analytischer Abfragen, die in der Regel vollständige Tabellenscans, komplexe Joins und Aggregate umfassen.
In-Memory-Spaltenspeicher: Enthält Tabellendaten und Daten in der materialisierten Ansicht für ausgewählte Spalten in einem spaltenorientierten Format. Standardmäßig verbraucht der Spaltenspeicher 30% des verfügbaren Arbeitsspeichers. Wenn Sie die Menge des vom Spaltenspeicher nutzbaren Arbeitsspeichers ändern möchten, legen Sie den Parameter
google_columnar_engine.memory_size_in_mbin der von Ihrer AlloyDB Omni-Instanz verwendetenpostgresql.conffest.Spaltenbasierter Abfrageplaner und Ausführungs-Engine: Unterstützt die Verwendung des Spaltenspeichers in Abfragen.
Weitere Informationen finden Sie unter Spaltenbasierte Engine von AlloyDB for PostgreSQL.
Automatische Speicherverwaltung
Der automatische Speichermanager überwacht und optimiert kontinuierlich den Speicherverbrauch einer gesamten AlloyDB Omni-Instanz. Wenn Sie Ihre Arbeitslasten ausführen, passt dieses Modul die Größe des gemeinsamen Zwischenspeichers an die Speicherauslastung an.
Standardmäßig legt die automatische Speicherverwaltung das obere Limit auf 80 % des Systemspeichers fest und weist 10% des Systemspeichers für den gemeinsamen Zwischenspeicher zu.
Wenn Sie die Obergrenze für die Größe des gemeinsamen Zwischenspeichers ändern möchten, legen Sie den Parameter shared_buffers in der postgresql.conf fest, die von Ihrer AlloyDB Omni-Instanz verwendet wird.
Adaptives Autovacuum
Das adaptive Autovakuum analysiert Vorgänge basierend auf der Datenbankarbeitslast und passt die Häufigkeit des Vakuumierens automatisch an. Durch diese automatische Anpassung kann die Datenbank auch bei sich ändernden Arbeitslasten eine optimale Leistung aufrechterhalten, ohne dass der Vacuum-Prozess beeinträchtigt wird.
Die adaptive automatische Bereinigung verwendet die folgenden Faktoren, um die Häufigkeit und Intensität von Bereinigungsvorgängen zu bestimmen:
- Größe der Datenbank
- Anzahl der inaktiven Tupel in der Datenbank
- Alter der Daten in der Datenbank
- Anzahl der Transaktionen pro Sekunde im Vergleich zur geschätzten Vacuum-Geschwindigkeit
- Ressourcennutzung
KI/ML-Worker
In AlloyDB Omni bietet der KI/ML-Hintergrund-Worker die erforderlichen Funktionen, um Vertex AI-Modelle direkt aus der Datenbank aufzurufen. Der KI/ML-Worker wird als Prozess mit dem Namen omni ml worker ausgeführt.
Die Web-UI
Die optionale Web-UI ist eine selbstverwaltete Webkonsole, die Ihnen Einblick in Ihre Datenbankinstanzen bietet.
Diese Oberfläche bildet grafische Dashboards für benutzerdefinierte Funktionen ab, z. B. die spaltenbasierte Engine und Modellendpunkt-Integrationen, die von typischen Open-Source-PostgreSQL-Visualisierern nicht erfasst werden können.
Führen Sie die folgenden optionalen Schritte aus, um die Web-UI zu installieren und eine Verbindung zu ihr herzustellen:
- Mit Containern installieren
- Mit dem Container-Orchestrator installieren
- Mit RPM installieren
- Mit dem RPM-Orchestrator installieren
Orchestrator-Steuerungsebene
Bei der RPM-Orchestrator-Bereitstellungsoption wird ein zentraler Cluster-Manager verwendet, um clusterweite Vorgänge wie Bootstrapping und Failover zu automatisieren.
Verwaltungsoberflächen
Die RPM-Orchestrator-Bereitstellungsoption bietet ein Befehlszeilen-Dienstprogramm (alloydbctl) und Ansible-Rollen, mit denen Sie einen oder mehrere Cluster in großem Umfang verwalten können.
Leistungsoptimierung
Die RPM-Orchestrator-Bereitstellungsoption umfasst integrierte Unterstützung für PgBouncer für Verbindungs-Pooling und HAProxy für Load Balancing über Lese-/Schreib- und Lesezugriff-Endpunkte hinweg.
Nächste Schritte
Erste Schritte mit den folgenden AlloyDB Omni-Bereitstellungsoptionen:
So installieren Sie die Web-UI und stellen eine Verbindung her: