


Garantir a confiabilidade e a qualidade da configuração de alta disponibilidade do Patroni é crucial para manter as operações contínuas do banco de dados e minimizar o tempo de inatividade. Esta página fornece um guia completo para testar seu cluster do Patroni, abrangendo vários cenários de falha, consistência de replicação e mecanismos de failover.
Testar a configuração do Patroni
Conecte-se a qualquer uma das instâncias do Patroni (
alloydb-patroni1,alloydb-patroni2oualloydb-patroni3) e navegue até a pasta do Patroni do AlloyDB Omni.cd /alloydb/
Inspecione os registros do Patroni.
docker compose logs alloydbomni-patroni
As últimas entradas devem refletir informações sobre o nó do Patroni. Você vai ver algo semelhante ao seguinte.
alloydbomni-patroni        | 2024-06-12 15:10:29,020 INFO: no action. I am (patroni1), the leader with the lock
alloydbomni-patroni        | 2024-06-12 15:10:39,010 INFO: no action. I am (patroni1), the leader with the lock
alloydbomni-patroni        | 2024-06-12 15:10:49,007 INFO: no action. I am (patroni1), the leader with the lock
Conecte-se a qualquer instância que execute o Linux e tenha conectividade de rede com sua instância principal do Patroni,
alloydb-patroni1, e receba informações sobre a instância. Talvez seja necessário instalar a ferramentajqexecutandosudo apt-get install jq -y.curl -s http://alloydb-patroni1:8008/patroni | jq .
Você verá algo semelhante ao seguinte.
{
  "state": "running",
  "postmaster_start_time": "2024-05-16 14:12:30.031673+00:00",
  "role": "master",
  "server_version": 150005,
  "xlog": {
    "location": 83886408
  },
  "timeline": 1,
  "replication": [
    {
      "usename": "alloydbreplica",
      "application_name": "patroni2",
      "client_addr": "10.172.0.40",
      "state": "streaming",
      "sync_state": "async",
      "sync_priority": 0
    },
    {
      "usename": "alloydbreplica",
      "application_name": "patroni3",
      "client_addr": "10.172.0.41",
      "state": "streaming",
      "sync_state": "async",
      "sync_priority": 0
    }
  ],
  "dcs_last_seen": 1715870011,
  "database_system_identifier": "7369600155531440151",
  "patroni": {
    "version": "3.3.0",
    "scope": "my-patroni-cluster",
    "name": "patroni1"
  }
}
Chamar o endpoint de API HTTP do Patroni em um nó do Patroni expõe vários detalhes sobre o estado e a configuração daquela instância específica do PostgreSQL gerenciada pelo Patroni, incluindo informações de estado do cluster, linha do tempo, informações do WAL e verificações de integridade que indicam se os nós e o cluster estão funcionando corretamente.
Testar a configuração do HAProxy
Em uma máquina com um navegador e conectividade de rede com o nó do HAProxy, acesse o seguinte endereço:
http://haproxy:7000. Como alternativa, use o endereço IP externo da instância do HAProxy em vez do nome do host.Você verá algo semelhante à captura de tela a seguir.
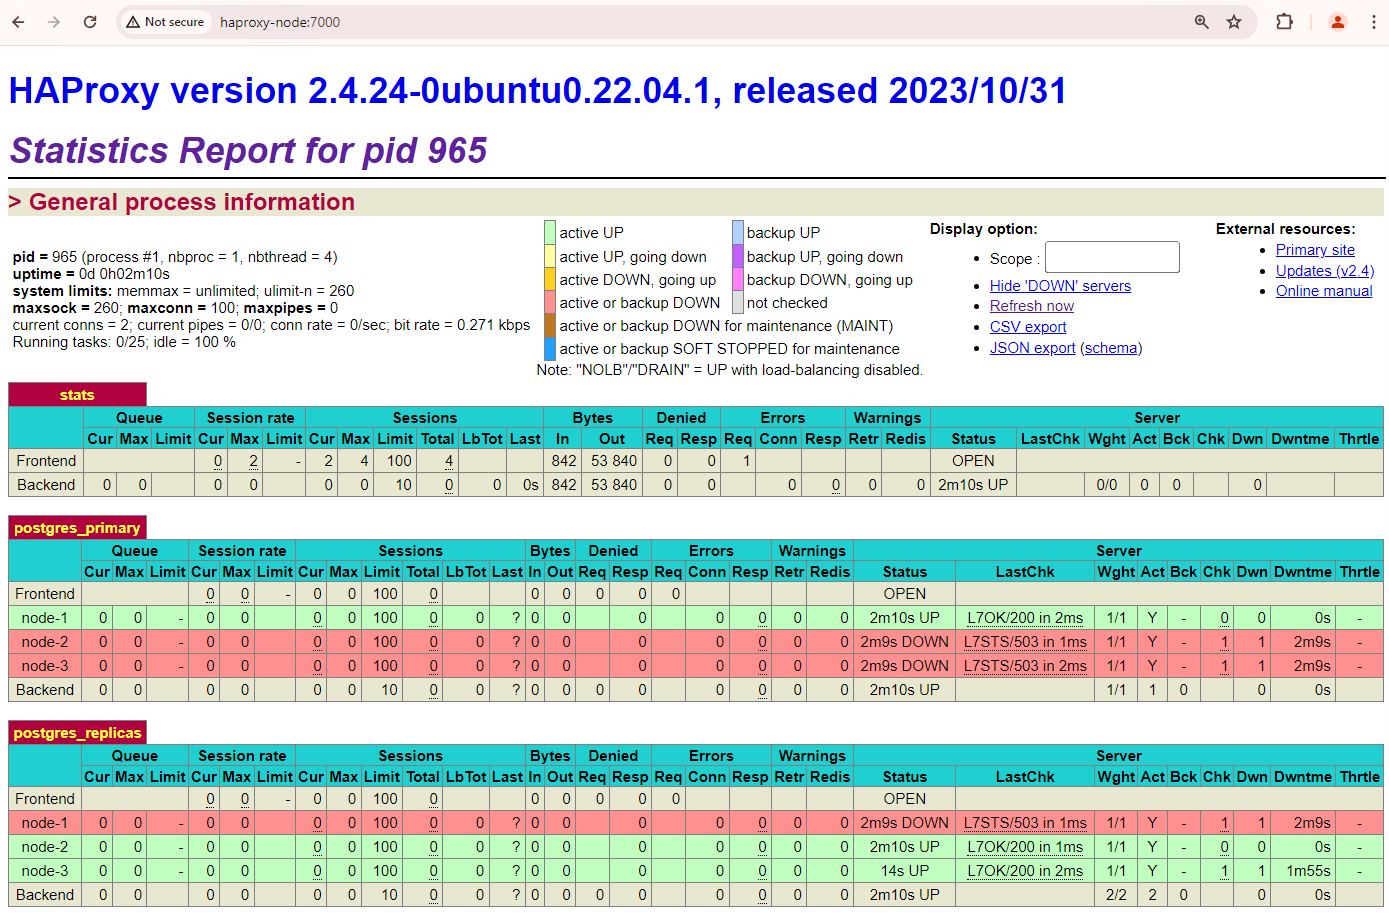
Figura 1. Página de status do HAProxy mostrando o status de integridade e a latência dos nós do Patroni.
No painel do HAProxy, é possível ver o status de integridade e a latência do nó principal do Patroni,
patroni1, e das duas réplicas,patroni2epatroni3.É possível realizar consultas para verificar as estatísticas de replicação no cluster. Em um cliente como o pgAdmin, conecte-se ao servidor de banco de dados principal pelo HAProxy e execute a consulta a seguir.
SELECT
      pid, usename, application_name, client_addr, state, sync_state
FROM
      pg_stat_replication;
Você verá algo semelhante ao diagrama a seguir, mostrando que
patroni2epatroni3estão sendo transmitidos depatroni1.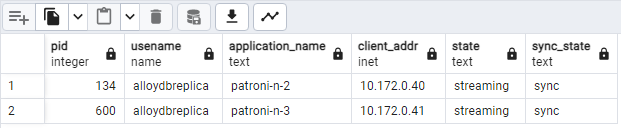
Figura 2.Saída de pg_stat_replication mostrando o estado de replicação dos nós do Patroni.
Testar o failover automático
Nesta seção, no cluster de três nós, simulamos uma interrupção no nó principal interrompendo o contêiner do Patroni em execução anexado. É possível interromper o serviço Patroni no primário para simular uma interrupção ou aplicar algumas regras de firewall para interromper a comunicação com esse nó.
Na instância principal do Patroni, navegue até a pasta do Patroni do AlloyDB Omni.
cd /alloydb/
Interrompa o contêiner.
docker compose down
O resultado será semelhante ao seguinte: Isso deve validar que o contêiner e a rede foram interrompidos.
[+] Running 2/2
✔ Container alloydb-patroni            Removed
✔ Network alloydbomni-patroni_default  Removed
Atualize o painel do HAProxy e veja como o failover ocorre.
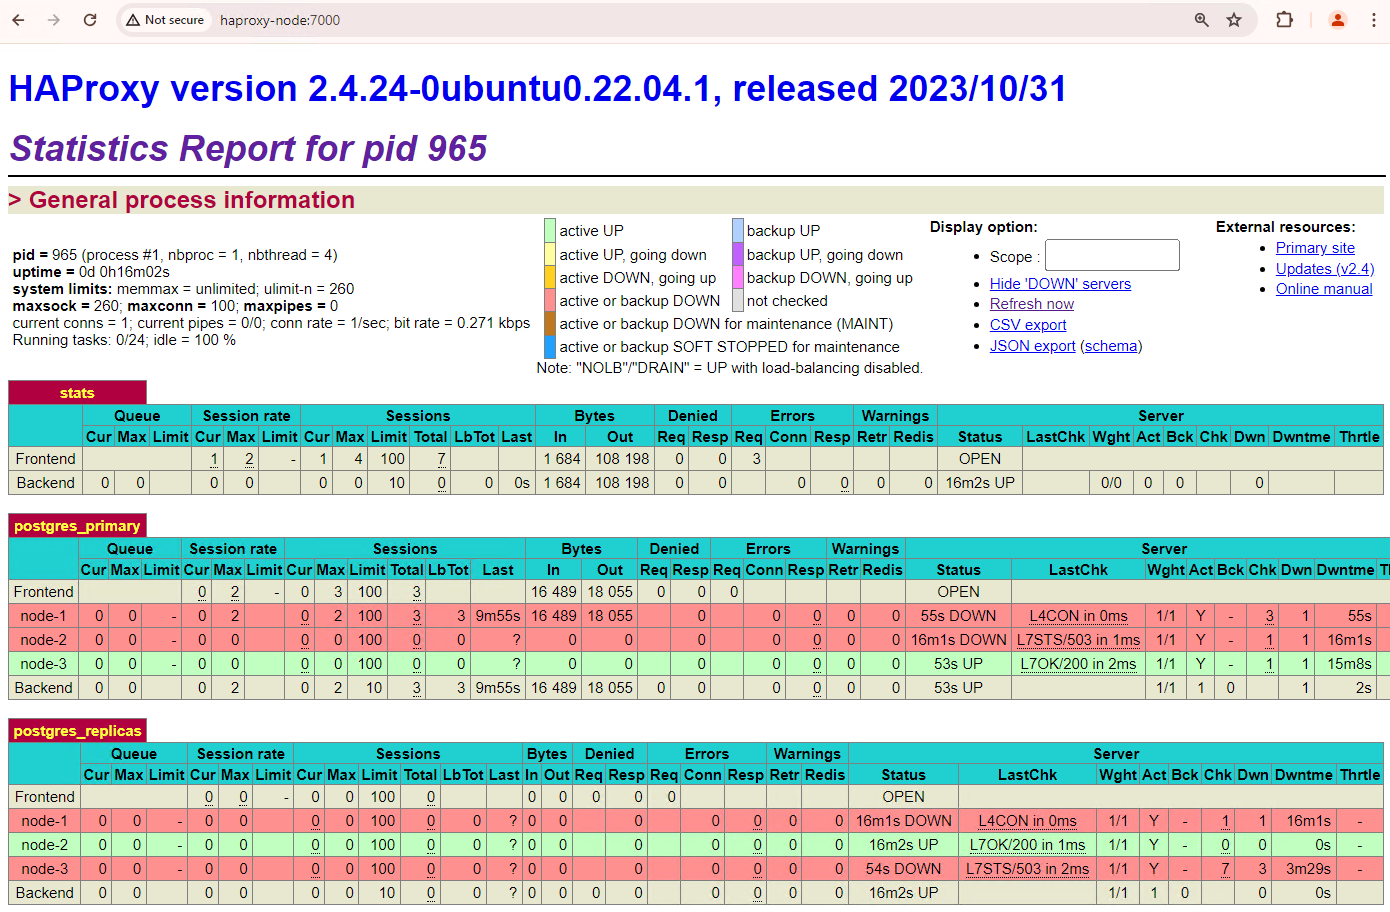
Figura 3. Painel do HAProxy mostrando o failover do nó principal para o nó em espera.
A instância
patroni3se tornou a nova principal, epatroni2é a única réplica restante. A instância principal anterior,patroni1, está inativa e as verificações de integridade falham.O Patroni executa e gerencia o failover por meio de uma combinação de monitoramento, consenso e orquestração automatizada. Assim que o nó principal não renova a concessão dentro de um tempo limite especificado ou se relata uma falha, os outros nós no cluster reconhecem essa condição por meio do sistema de consenso. Os nós restantes se coordenam para selecionar a réplica mais adequada para ser promovida como a nova primária. Depois que uma réplica candidata é selecionada, o Patroni promove esse nó para primário aplicando as mudanças necessárias, como atualizar a configuração do PostgreSQL e reproduzir todos os registros WAL pendentes. Em seguida, o novo nó principal atualiza o sistema de consenso com o status dele, e as outras réplicas se reconfiguram para seguir o novo principal, incluindo a troca da origem de replicação e, possivelmente, a atualização com novas transações. O HAProxy detecta o novo primário e redireciona as conexões do cliente de acordo, garantindo o mínimo de interrupção.
Em um cliente como o pgAdmin, conecte-se ao servidor de banco de dados pelo HAProxy e verifique as estatísticas de replicação no cluster após o failover.
SELECT
      pid, usename, application_name, client_addr, state, sync_state
FROM
      pg_stat_replication;
Você verá algo semelhante ao diagrama a seguir, mostrando que apenas
patroni2está sendo transmitido agora.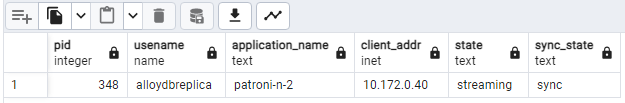
Figura 4.Saída pg_stat_replication mostrando o estado de replicação dos nós do Patroni após o failover.
Seu cluster de três nós pode sobreviver a mais uma interrupção. Se você interromper o nó primário atual,
patroni3, outro failover vai ocorrer.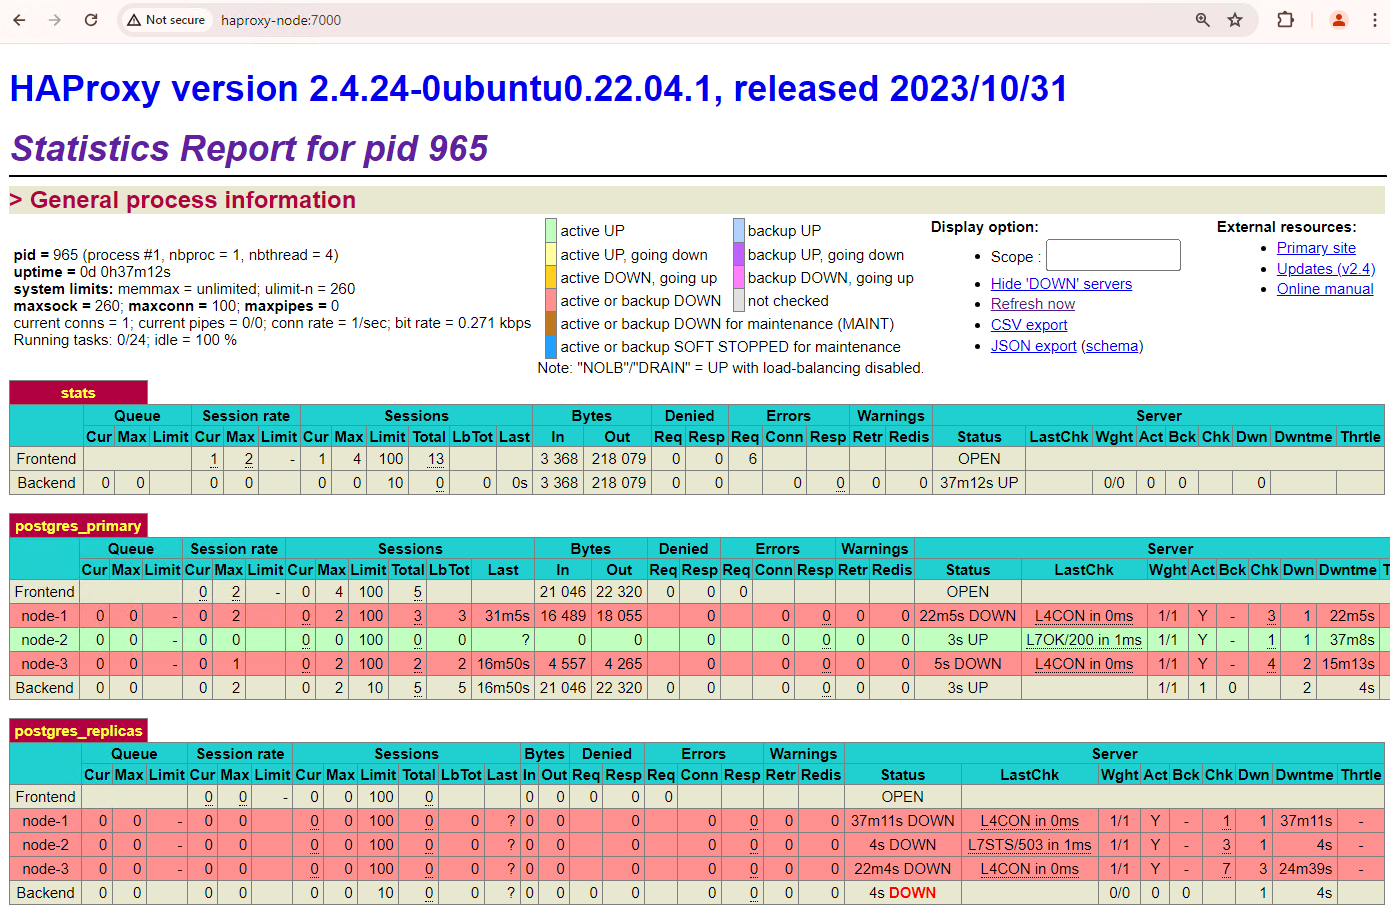
Figura 5. Painel do HAProxy mostrando o failover do nó principal,
patroni3, para o nó de espera,patroni2.
Considerações sobre substitutos
O fallback é o processo de restabelecer o antigo nó de origem após um failover. O fallback automático geralmente não é recomendado em um cluster de banco de dados de alta disponibilidade devido a várias preocupações críticas, como recuperação incompleta, risco de cenários de split-brain e atraso de replicação.
No cluster do Patroni, se você ativar os dois nós com que simulou uma interrupção, eles vão voltar ao cluster como réplicas em espera.
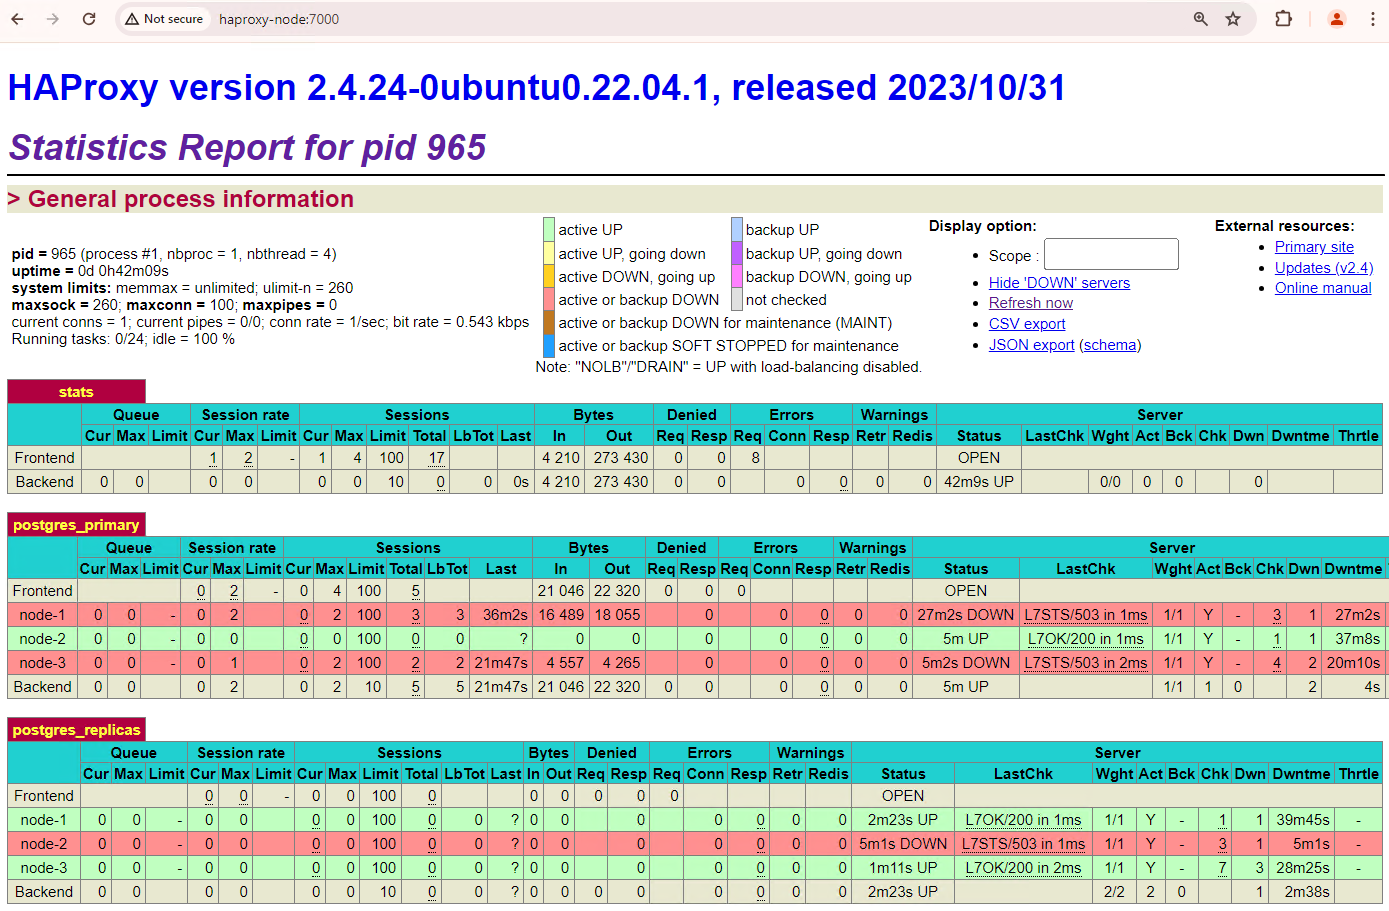
Figura 6. Painel do HAProxy mostrando a restauração de patroni1 e
patroni3 como nós de espera.
Agora, patroni1 e patroni3 estão sendo replicados da instância principal atual
patroni2.
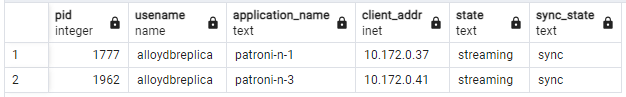
Figura 7.Saída pg_stat_replication mostrando o estado de replicação dos nós do Patroni após o fallback.
Se você quiser voltar manualmente para o primário inicial, use a interface de linha de comando patronictl. Ao optar pelo fallback manual, você garante um processo de recuperação mais confiável, consistente e totalmente verificado, mantendo a integridade e a disponibilidade dos seus sistemas de banco de dados.