


如要偵測及分析查詢效能瓶頸、檢查查詢計畫,以及追蹤 AlloyDB for PostgreSQL 執行個體中的高延遲要求,可以使用查詢洞察資訊主頁。如需這項功能的總覽,請參閱「查詢洞察總覽」。
您可以使用 Gemini Cloud Assist 監控 AlloyDB 資源及排解相關問題。詳情請參閱「使用 Gemini 輔助功能監控及排解問題」。
事前準備
如果您或其他使用者需要查看查詢計畫或執行端對端追蹤,必須具備特定的 Identity and Access Management (IAM) 權限。您可以建立自訂角色,並在其中新增必要的 IAM 權限。接著,您可以將這個角色新增至每個使用查詢洞察排解問題的使用者帳戶。請參閱「建立自訂角色」。
自訂角色必須具備下列 IAM 權限:cloudtrace.traces.get。
開啟查詢洞察資訊主頁
如要開啟查詢洞察資訊主頁,請按照下列步驟操作:
- 在叢集和執行個體清單中,按一下執行個體。
- 在叢集「總覽」頁面的指標圖表下方,按一下「前往『查詢洞察』,深入瞭解查詢和效能」,或選取左側導覽面板中的「查詢洞察」分頁標籤。
在後續頁面中,您可以使用下列選項篩選結果:
- 執行個體選取器。可讓您選取叢集中的主要執行個體或讀取集區執行個體。根據預設,系統會選取主要執行個體。顯示的詳細資料是所有連結的讀取集區執行個體及其節點的匯總資料。
- 資料庫。篩選特定資料庫或所有資料庫的查詢負載。
- 使用者。篩選特定使用者帳戶的查詢負載。
- 用戶端位址。篩選來自特定 IP 位址的查詢負載。
- 日期範圍。依時間範圍 (例如小時、日、週或自訂範圍) 篩選查詢負載。
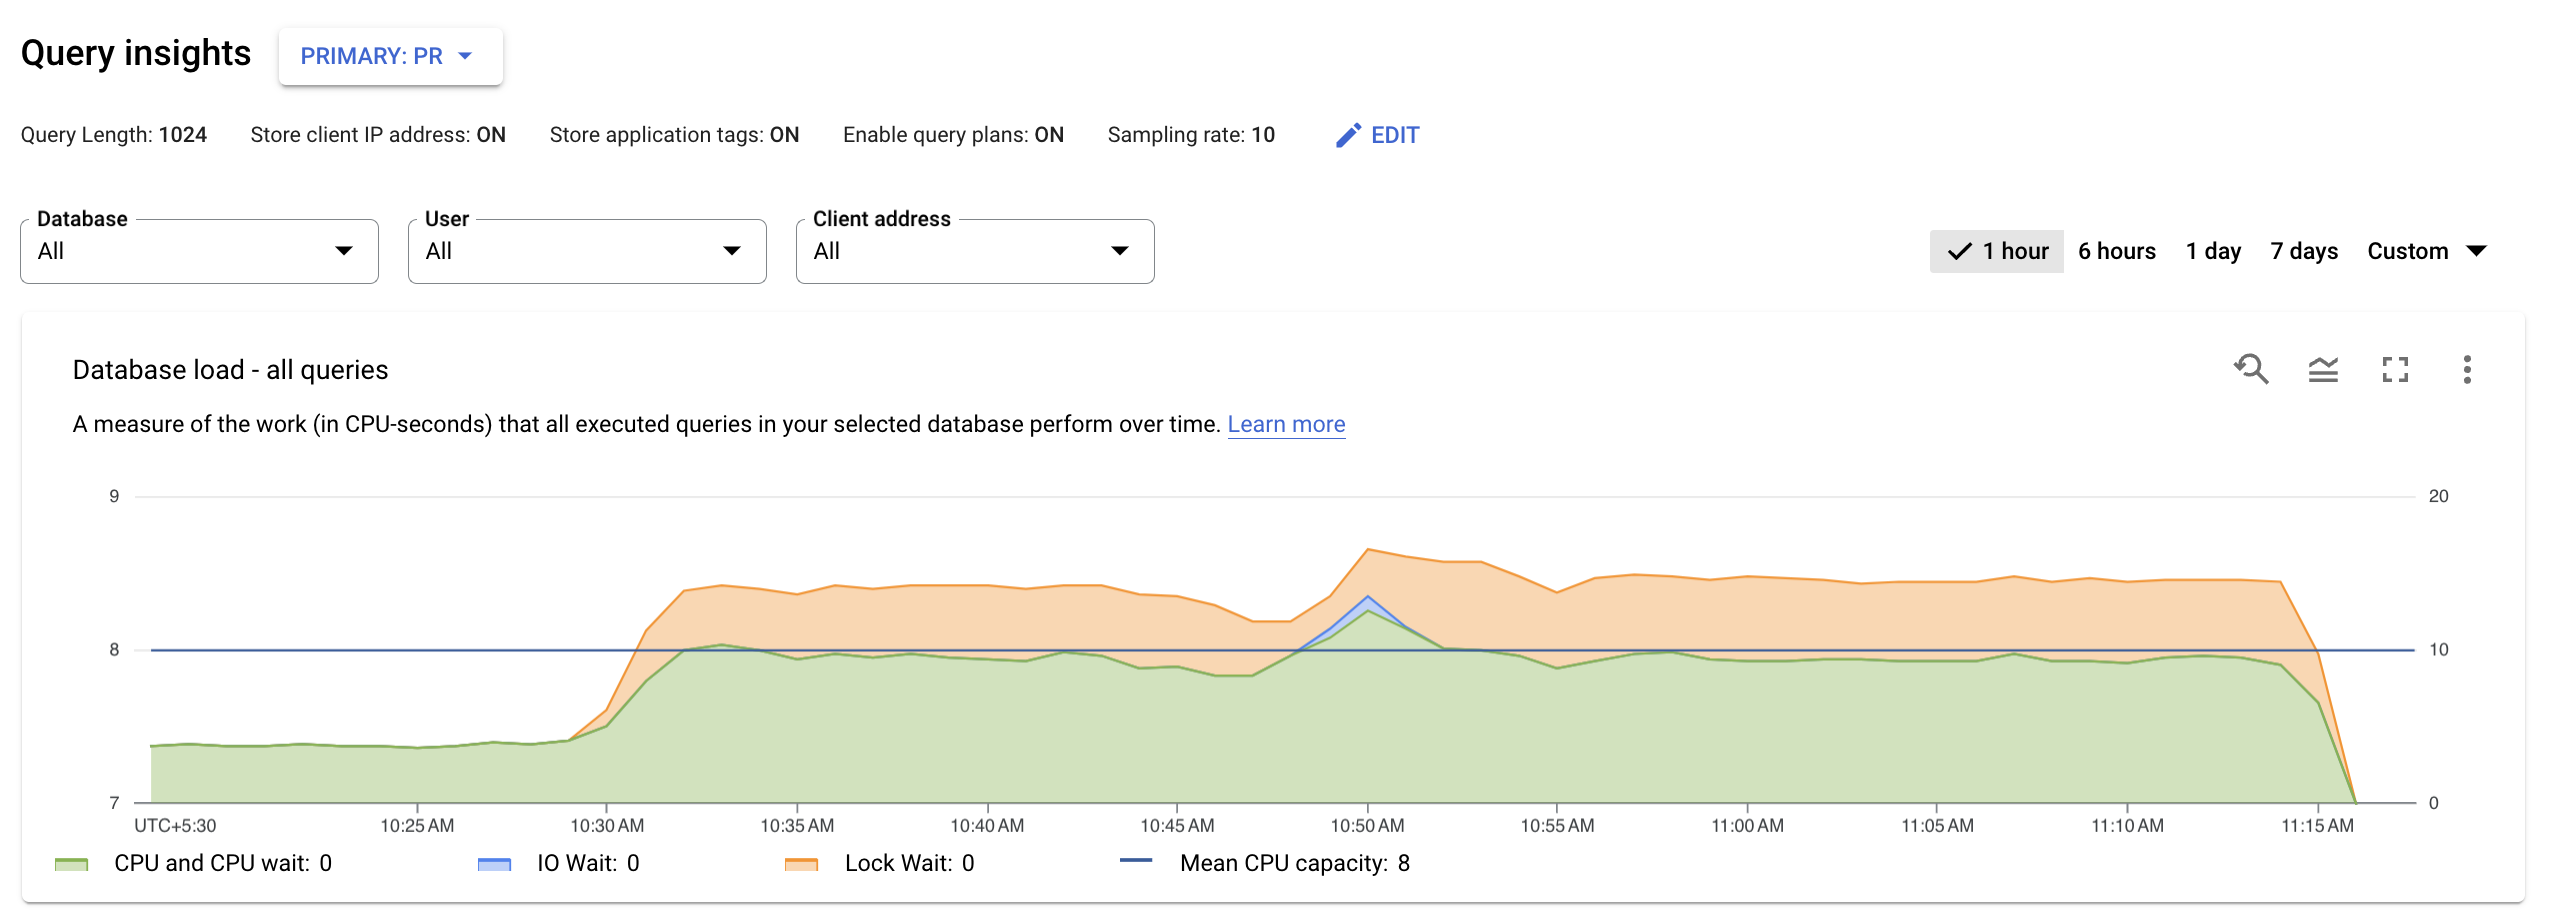
編輯查詢洞察設定
AlloyDB 執行個體預設會啟用查詢洞察。您可以編輯預設的查詢洞察設定。
如要編輯 AlloyDB 執行個體的查詢洞察設定,請按照下列步驟操作:
控制台
前往 Google Cloud 控制台的「Clusters」(叢集) 頁面。
在「Resource Name」(資源名稱) 欄中,按一下叢集。
按一下左側導覽面板中的「查詢洞察」。
從「Query insights」(查詢洞察) 清單中選取「Primary」(主要) 或「Read pool」(讀取集區),然後按一下「Edit」(編輯)。
編輯「Query insights」(查詢洞察) 欄位:
如要變更 AlloyDB 分析查詢長度的預設限制 (1024 個位元組),請在「Query lengths」(查詢長度) 欄位中輸入 256 到 4500 之間的數字。
編輯這個欄位後,執行個體會重新啟動。
注意:查詢長度上限越高,所需記憶體就越多。
如要自訂查詢洞察特徵集,請調整下列選項:
「Query plan sampling」(查詢計畫取樣):勾選這個核取方塊,即可透過圖表查看用來完成查詢取樣的作業。取樣率會決定 AlloyDB 每分鐘可為執行個體每個節點取樣的查詢數量上限。
在「Maximum sampling rate」(取樣率上限) 欄位中,輸入 1 到 20 之間的數字。取樣率預設為 5。如要停用取樣功能,請取消勾選「Query plan sampling」(查詢計畫取樣) 核取方塊。
儲存用戶端 IP 位址:勾選這個核取方塊,即可瞭解查詢來源,並將這項資訊分組來執行指標。
儲存應用程式標記:勾選這個核取方塊,即可瞭解哪些已標記的應用程式正在發出要求,並將這些資訊分組,據此計算指標。如要進一步瞭解應用程式標記,請參閱規格。
按一下「更新執行個體」。
gcloud
如要使用 Google Cloud CLI 指令,為 AlloyDB 執行個體啟用查詢洞察功能,請按照下列步驟操作:
- 安裝 Google Cloud CLI。
- 執行下列指令,初始化 gcloud CLI:
gcloud init
如果您使用的是本機殼層,請為使用者帳戶建立本機驗證憑證:
gcloud auth application-default login
如果您使用的是 Cloud Shell,則不必執行這項操作。
詳情請參閱「為本機開發環境設定驗證機制」。
範例如下:
gcloud alloydb instances update INSTANCE \
--cluster=CLUSTER \
--project=PROJECT \
--region=REGION \
--insights-config-query-string-length=QUERY_LENGTH \
--insights-config-query-plans-per-minute=QUERY_PLANS \
--insights-config-record-application-tags \
--insights-config-record-client-address
更改下列內容:
INSTANCE:要更新的執行個體 IDCLUSTER:執行個體叢集的 IDPROJECT:叢集專案的 IDREGION:叢集所在的區域,例如us-central1QUERY_LENGTH:查詢長度,介於 256 到 4500 之間QUERY_PLANS:每分鐘要設定的查詢計畫數量。
此外,請使用下列一或多個選用旗標:
--insights-config-query-string-length:將預設查詢長度限制設為指定值,範圍介於 256 到 4500 個位元組。預設查詢長度為 1024 個位元組。查詢越長,越適合用於分析查詢,但所需記憶體也越多。變更查詢長度後,您必須重新啟動執行個體。您仍可為超過長度限制的查詢新增標記。--insights-config-query-plans-per-minute:根據預設,執行個體的所有資料庫每分鐘最多可擷取 5 個已執行的查詢計畫樣本。請將這個值變更為介於 1 至 20 之間的數字。如要停用取樣功能,請輸入 0。提高取樣率或許可以產生更多資料點,但也有可能增加效能負擔。--insights-config-record-client-address:儲存查詢來源的用戶端 IP 位址,並協助您將資料分組,以便執行指標分析。查詢來自多個主機。查看用戶端 IP 位址查詢圖表,有助於找出問題來源。如果不想儲存用戶端 IP 位址,請使用--no-insights-config-record-client-address。--insights-config-record-application-tags:儲存應用程式標記,協助您判斷哪些 API 和模型檢視控制器 (MVC) 路徑正在發出要求,並將資料分組,據此計算指標。這個選項會要求您使用一組特定標記來註解查詢。如果不想儲存應用程式標記,請使用--no-insights-config-record-application-tags。
Terraform
如要使用 Terraform 設定查詢洞察,請使用 google_alloydb_instance 資源。
範例如下:
  query_insights_config {
    query_string_length = QUERY_STRING_LENGTH_VALUE
    record_application_tags = RECORD_APPLICATION_TAG_VALUE
    record_client_address = RECORD_CLIENT_ADDRESS_VALUE
    query_plans_per_minute = QUERY_PLANS_PER_MINUTE_VALUE5
  }
更改下列內容:
QUERY_STRING_LENGTH_VALUE:查詢字串長度。預設值為1024。256 到 4500 之間的任何整數都有效。RECORD_APPLICATION_TAG_VALUE:執行個體的記錄應用程式標記。預設值為true。RECORD_CLIENT_ADDRESS_VALUE:記錄執行個體的用戶端位址。預設值為true。QUERY_PLANS_PER_MINUTE_VALUE:洞察功能每分鐘為所有查詢擷取的查詢執行計畫數量。預設值為5。介於 0 到 20 之間的任何整數都有效。如要瞭解如何套用或移除 Terraform 設定,請參閱「基本 Terraform 指令」。
新增查詢洞察設定後,執行個體設定範例應如下所示:
resource "google_alloydb_instance" "instance_name" {
provider = "google-beta"
cluster       = google_alloydb_cluster.default.name
instance_id   = "instance_id"
instance_type = "PRIMARY"

machine_config {
 cpu_count = 8
}

query_insights_config {
query_string_length = 1024
record_application_tags = false
record_client_address = false
query_plans_per_minute = 5
}

depends_on = [google_alloydb_instance.default]
}
REST v1
這個範例會設定 AlloyDB 執行個體的可觀測性設定。如需這項呼叫的完整參數清單,請參閱「方法:projects.locations.clusters.instances.patch」。
如要調整查詢洞察設定,請視需要修改選填欄位。如需這項呼叫的完整欄位清單,請參閱 QueryInsightsInstanceConfig。
使用任何要求資料之前,請先替換下列項目:
CLUSTER_ID:您建立的叢集 ID。開頭須為小寫英文字母,且只能使用小寫英文字母、數字和連字號。PROJECT_ID:要放置叢集的專案 ID。LOCATION_ID:叢集區域的 ID。INSTANCE_ID:要建立的主要執行個體名稱。
如要修改執行個體設定,請使用下列 PATCH 要求:
PATCH https://alloydb.googleapis.com/v1beta/{instance.name=projects/PROJECT_ID/locations/LOCATION_ID/clusters/CLUSTER_ID/instances/INSTANCE_ID?updateMask=observabilityConfig.enabled}
設定所有觀測能力欄位的要求 JSON 主體如下所示:
{
  "queryStringLength": integer,
  "recordApplicationTags": boolean,
  "recordClientAddress": boolean,
  "queryPlansPerMinute": integer
}
改善查詢效能
查詢洞察功能會對 AlloyDB 查詢進行疑難排解,找出效能問題。查詢洞察資訊主頁會根據您選取的因素顯示查詢負載。查詢負載是指在所選日期範圍內,執行個體中所有查詢的總工作量。
查詢洞察功能可協助您偵測及分析查詢效能問題。如要使用查詢洞察排解查詢問題,請按照下列步驟操作:
查看所有查詢的資料庫負載
頂層查詢洞察資訊主頁會使用篩選後的資料,顯示「Database load — all top queries」(資料庫負載 - 所有熱門查詢) 圖表。資料庫查詢負載是指所選資料庫中執行的查詢,在一段時間內執行的工作量 (以 CPU 秒數為單位)。每項執行中的查詢都會使用或等待 CPU 資源、IO 資源或鎖定資源。資料庫查詢負載是指在指定時間範圍內,所有查詢完成所需時間與實際經過時間的比率。
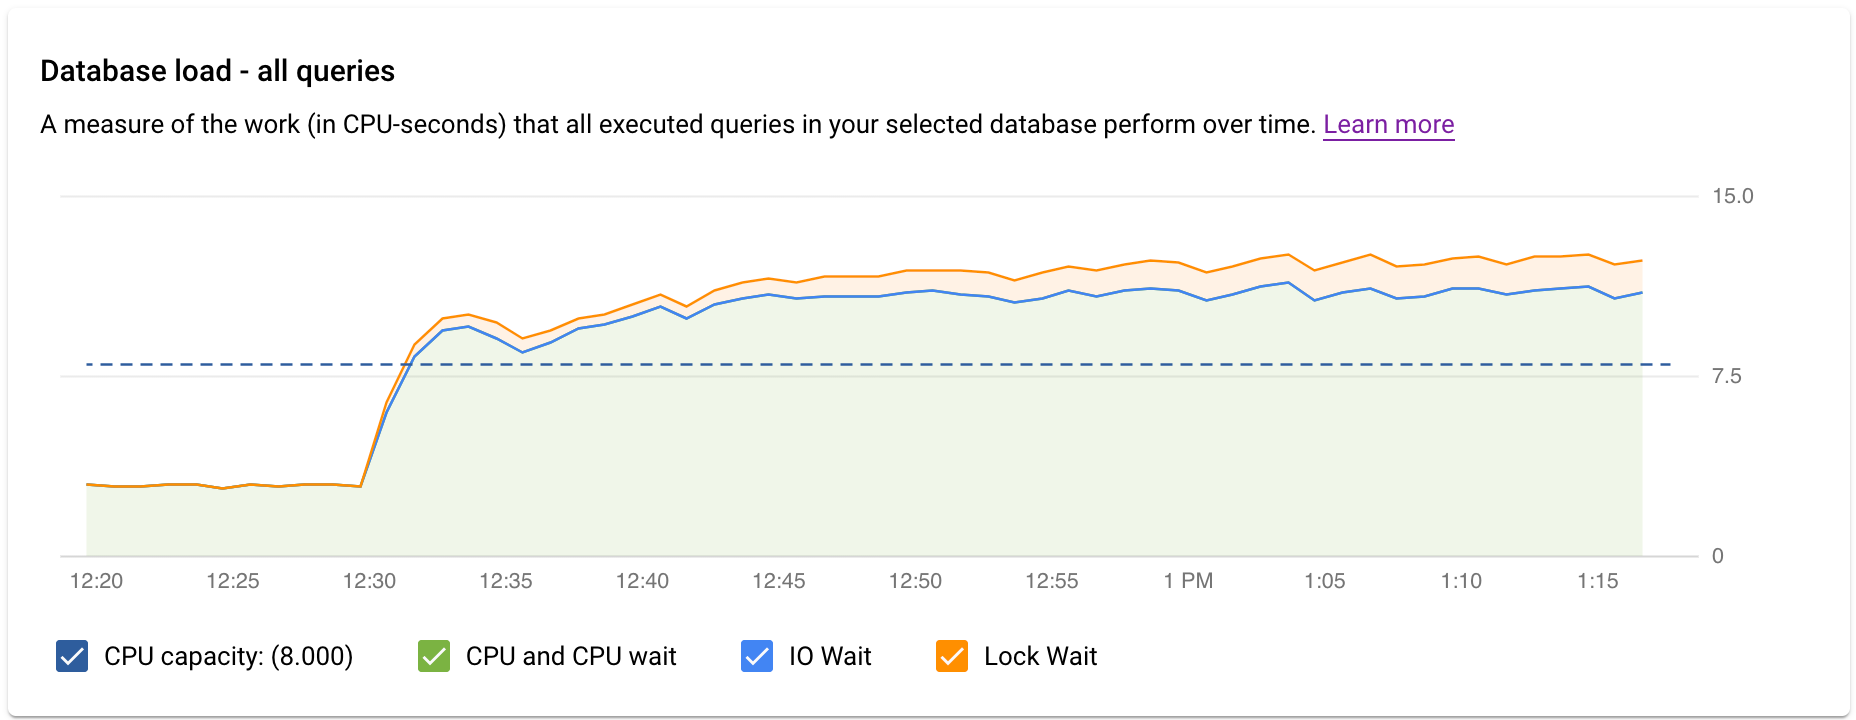
圖表中的彩色線條代表查詢負載,分為四個類別:
- CPU 容量:執行個體可用的 CPU 數量。
CPU 和 CPU 等待:查詢處於活動狀態的時間與實際經過時間的比率。IO 和鎖定等待不會封鎖處於有效狀態的查詢。這項指標可能代表查詢正在使用 CPU,或是在其他程序使用 CPU 時,等待 Linux 排程器排定執行查詢的伺服器程序。
注意:CPU 負載會同時考量執行階段,以及等待 Linux 排程器排定執行中伺服器程序的時間。因此,CPU 負載可能會超過核心上限。
IO 等待:查詢等待 IO 的時間與實際經過時間的比率。IO 等待包括讀取 IO 等待和寫入 IO 等待。請參閱 PostgreSQL 事件資料表。如要查看 IO 等待資訊的細目,請前往 Cloud Monitoring。詳情請參閱「指標圖表」。
鎖定等待:查詢等待鎖定的時間與實際經過時間的比率。包括鎖定等待、LwLock 等待和緩衝區固定鎖定等待。如要查看鎖定等待資訊的細目,請前往 Cloud Monitoring。詳情請參閱「指標圖表」。
接著,請查看圖表並使用篩選選項,回答下列問題:
- 查詢負載是否過高?圖表是否隨著時間推移而出現高峰或上升?如果沒有看到高負載,表示問題不在查詢。
- 負載過高的情況持續多久了?只有現在偏高嗎?還是長期偏高?使用範圍選取功能選取不同的時間範圍,找出問題發生的時間長度。您也可以放大檢視查詢負載出現尖峰的時間範圍。最多可縮小至一週的時間軸。
- 高負載的原因為何?您可以選取選項,查看 CPU 容量、CPU 和 CPU 等待、鎖定等待或 IO 等待。每個選項的圖表顏色都不同,方便您查看哪個選項的負載最高。圖表中的深藍色線條代表系統的最大 CPU 容量。您可以比較查詢負載與 CPU 系統容量上限。這項比較有助於瞭解執行個體的 CPU 資源是否即將用盡。
- 哪個資料庫正在承受負載?從「Databases」(資料庫) 下拉式選單中選取不同資料庫,找出負載最高的資料庫。
- 特定使用者或 IP 位址是否造成較高負載?從下拉式選單中選取不同的使用者和地址,比較哪些使用者和地址造成較高的負載。
篩選資料庫負載
在「Queries and tags」(查詢和標記) 區段中,您可以篩選或排序所選查詢或 SQL 查詢標記的查詢負載。
依查詢篩選
「QUERIES」(查詢) 資料表會概略說明造成最多查詢負載的查詢。表格會顯示在查詢洞察資訊主頁上,所選時間範圍和選項的所有正規化查詢。
根據預設,表格會依所選時間範圍內的總執行時間排序查詢。
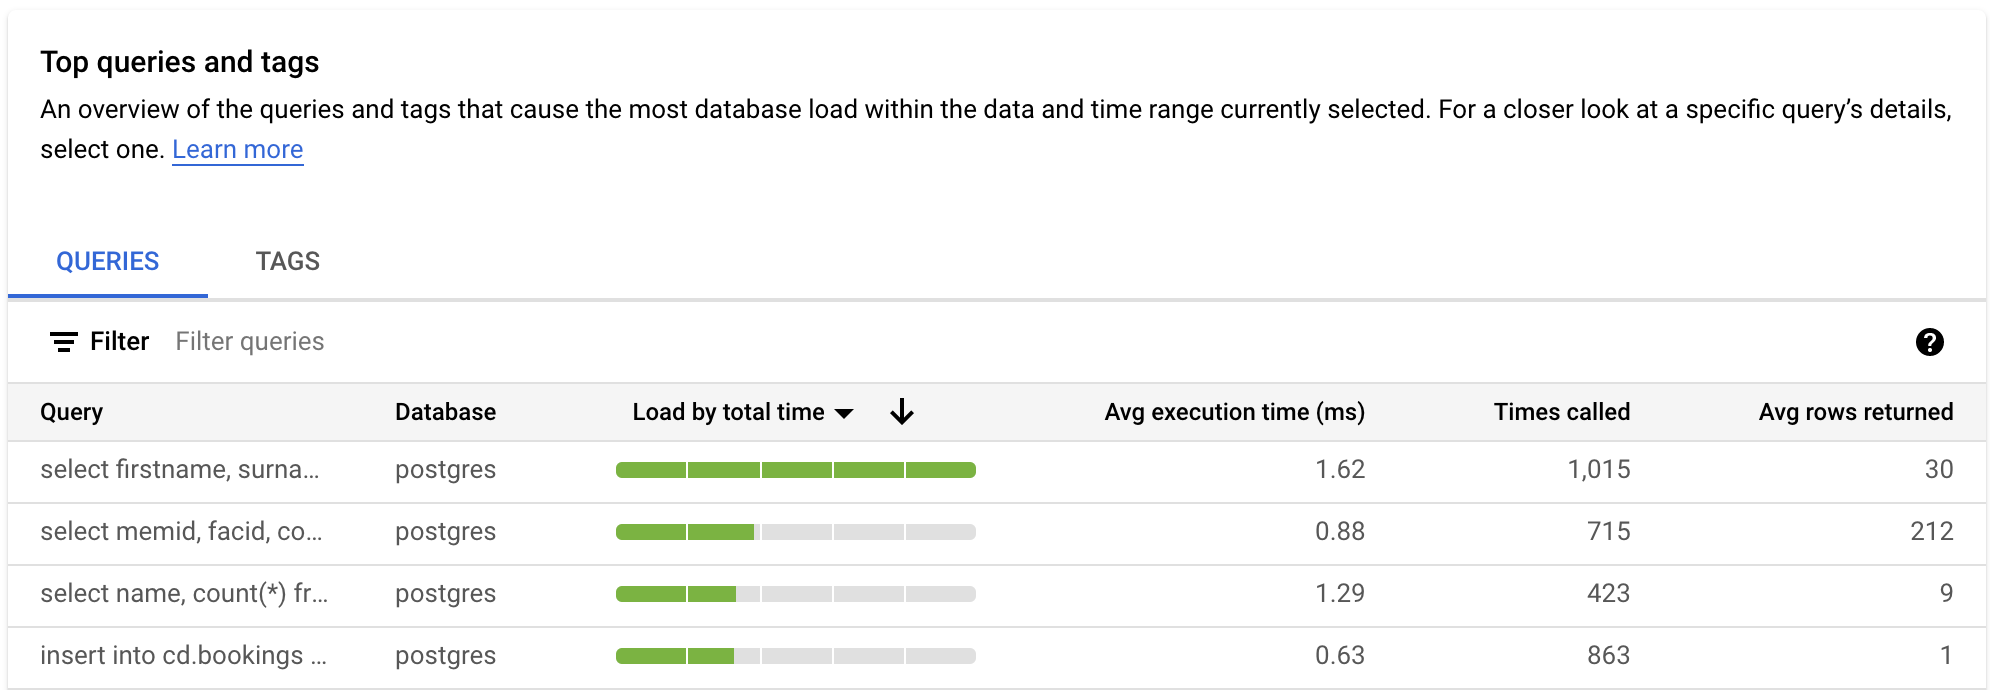
如要篩選表格,請從「篩選查詢」中選取屬性。如要排序表格,請選取資料欄標題。表格會顯示下列屬性:
查詢字串。正規化查詢字串。根據預設,查詢洞察只會顯示查詢字串中的 1024 個字元。
標示為
UTILITY COMMAND的查詢通常包含BEGIN、COMMIT和EXPLAIN指令或包裝函式指令。資料庫。執行查詢的資料庫。
負載 (根據總時間)/負載 (根據 CPU 時間)/負載 (根據 IO 等待時間)/負載 (根據鎖定等待時間)。這些選項可讓您篩選特定查詢,找出每個選項的最大負載。
平均執行時間 (毫秒)。所有平行 worker 完成查詢的所有子任務所需總時間。詳情請參閱「平均執行時間和時間長度」。
呼叫次數。應用程式呼叫查詢的次數。
平均擷取的資料列數:查詢擷取的平均資料列數。
查詢洞察會顯示正規化查詢,也就是以 $1、$2 等取代常值常數值。例如:
UPDATE
  "demo_customer"
SET
  "customer_id" = $1::uuid,
  "name" = $2,
  "address" = $3,
  "rating" = $4,
  "balance" = $5,
  "current_city" = $6,
  "current_location" = $7
WHERE
  "demo_customer"."id" = $8
系統會忽略常數值,以便查詢洞察匯總類似的查詢,並移除常數可能顯示的任何 PII 資訊。
依查詢標記篩選
如要排解應用程式問題,請先在 SQL 查詢中新增標記。
查詢洞察提供以應用程式為中心的監控功能,可診斷使用 ORM 建構的應用程式效能問題。
如果您負責整個應用程式堆疊,查詢洞察可從應用程式檢視畫面提供查詢監控功能。查詢標記可協助您找出較高層級建構中的問題,例如使用商業邏輯、微服務或其他建構。您可以依據商業邏輯標記查詢,例如使用付款、庫存、商業分析或運送標記。接著,您可以找出各種商業邏輯建立的查詢負載。舉例來說,您可能會發現非預期的事件,例如下午 1 點時,業務分析標記出現高峰。或者,您可能會發現某項付款服務的費用,比前一週出現非預期的成長。
查詢負載標記會依時間細分所選標記的查詢負載。
為計算「標記的資料庫負載」,查詢洞察會使用每個查詢耗費的時間,並套用您選取的標記。查詢洞察會使用實際時間,計算分鐘邊界處的完成時間。
在查詢洞察資訊主頁,選取「標記」即可查看標記表格。「TAGS」(代碼) 表格會依據總時間的總負載量排序代碼。

如要排序表格,請從「篩選查詢」中選取屬性,或按一下欄標題。表格會顯示下列屬性:
- Action、Controller、Framework、Route、Application、DB Driver。您在查詢中新增的每個屬性都會顯示為一欄。如要依標記篩選,至少須新增其中一項屬性。
- 負載 (根據總時間)/負載 (根據 CPU 時間)/負載 (根據 IO 等待時間)/負載 (根據鎖定等待時間)。這些選項可讓您篩選特定查詢,找出每個選項的最大負載。
- 平均執行時間 (毫秒)。所有平行 worker 完成查詢的所有子任務所需總時間。詳情請參閱「平均執行時間和時間長度」。
- 呼叫次數。應用程式呼叫查詢的次數。
- 平均擷取的資料列數:查詢擷取的平均資料列數。
- 資料庫。執行查詢的資料庫。
檢查特定查詢或標記
如要判斷查詢或標記是否為問題的根本原因,請分別在「查詢」分頁或「標記」分頁中執行下列操作:
- 點選「負載 (根據總時間)」標題,依遞減順序排列清單。
- 按一下負載最高且耗時最長的查詢或標記。
資訊主頁隨即開啟,顯示所選查詢或標記的詳細資料。
如果選取查詢,系統會顯示所選查詢的總覽:
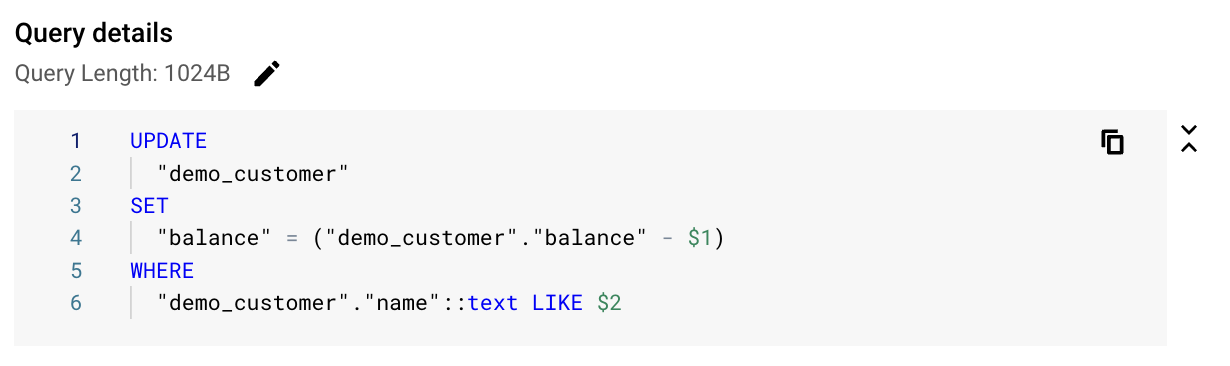
如果選取標記,系統會顯示所選標記的總覽。
檢查特定查詢或標記的負載
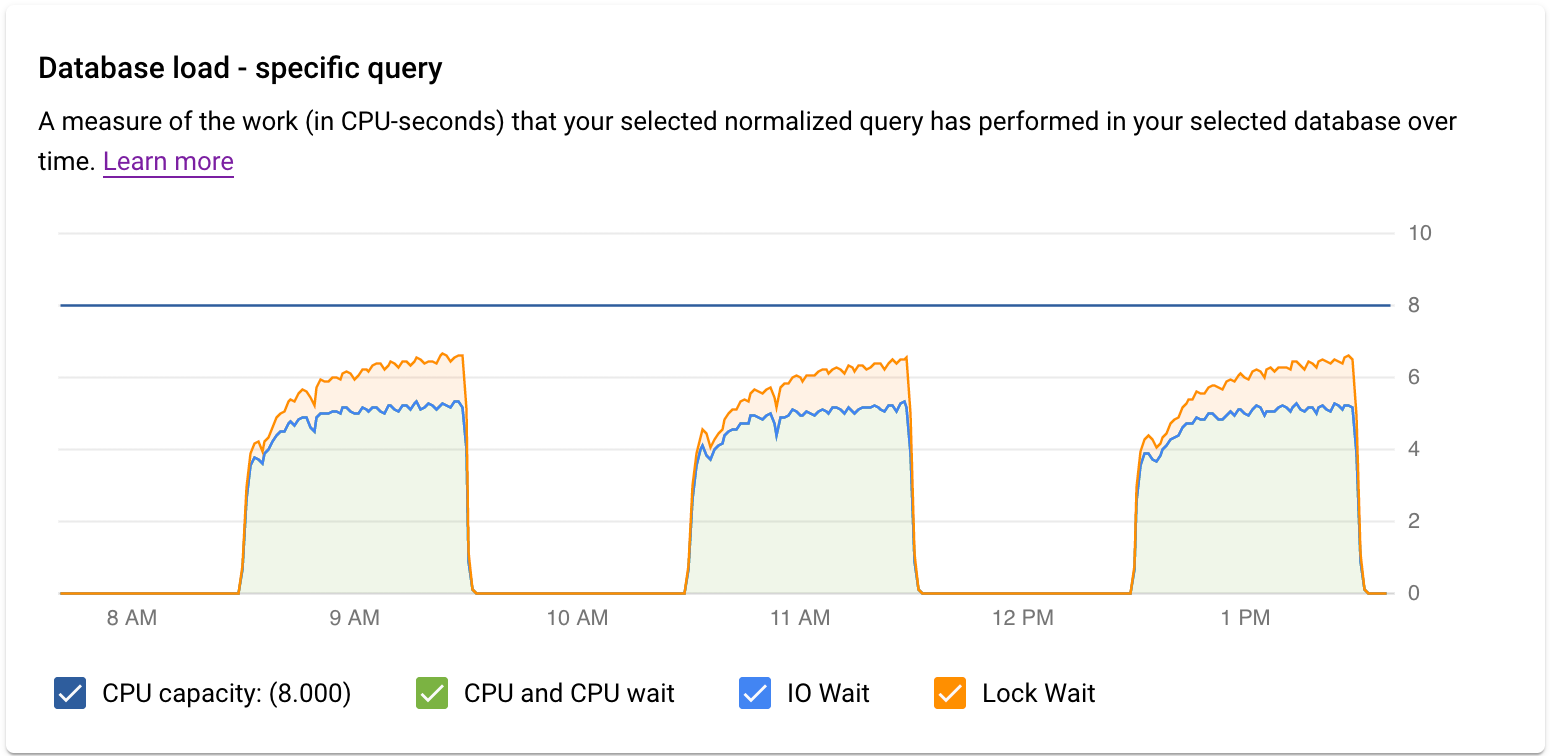
「Database load — specific query」(資料庫負載 - 特定查詢) 圖表會顯示所選正規化查詢在所選查詢中執行的工作量 (以 CPU 秒數為單位)。為了計算負載,系統會使用正規化查詢在分鐘邊界完成所需的時間,以及實際時間。表格頂端會顯示正規化查詢的前 1024 個字元 (為匯總和 PII 考量,已移除常值)。與查詢總數圖表一樣,您可以依「Database」(資料庫)、「User」(使用者)和「Client Address」(用戶端位址) 篩選特定查詢的負載。查詢負載分為「CPU capacity」(CPU 容量)、「CPU and CPU Wait」(CPU 和 CPU 等待)、「IO Wait」(IO 等待)和「Lock Wait」(鎖定等待)。
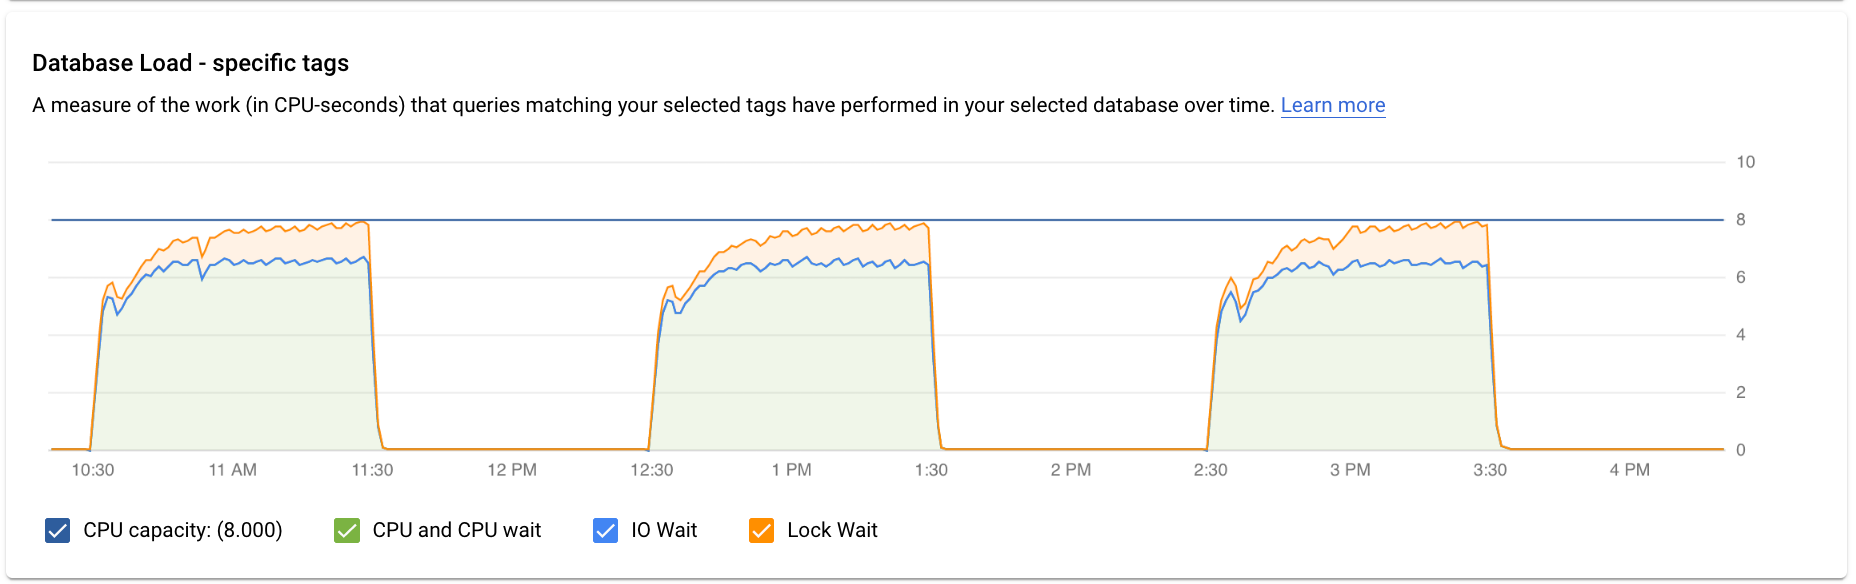
「Database load — specific tags」(資料庫負載 - 特定標記) 圖表會顯示與所選標記相符的查詢,在所選資料庫中執行的工作量 (以 CPU 秒數為單位) 隨時間變化的趨勢。與查詢總數圖表一樣,您可以依「Database」(資料庫)、「User」(使用者)和「Client Address」(用戶端位址) 篩選特定標記的負載。
檢查延遲時間
您可以使用「Latency」(延遲時間) 圖表,查看查詢或標記的延遲時間。「延遲時間」是指正規化查詢完成所需的時間 (以實際經過時間計算)。延遲時間資訊主頁會顯示第 50、95 和 99 個百分位數的延遲時間,以便找出離群值行為。
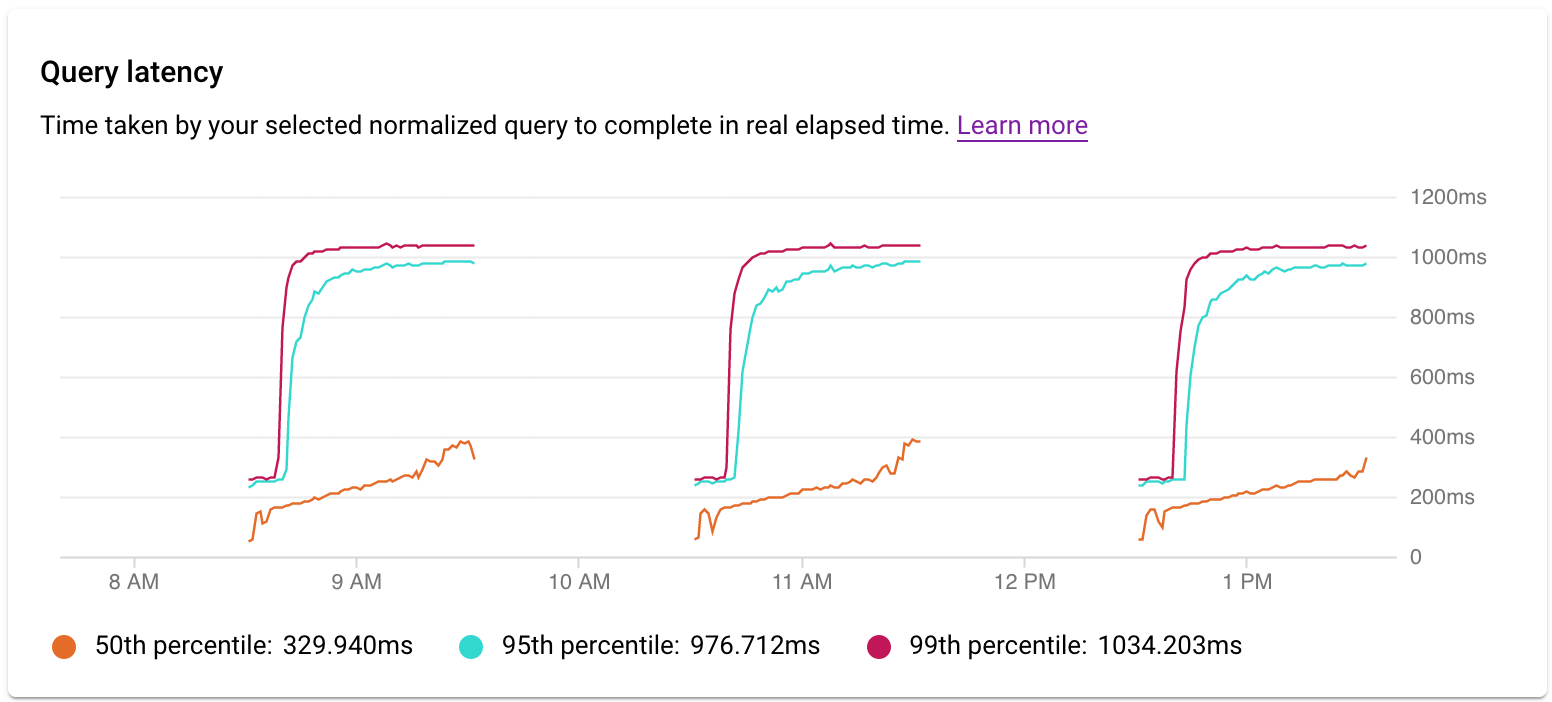
平行查詢的延遲時間是以實際時間測量,即使查詢負載可能較高,因為多個核心用於執行部分查詢。
請查看下列項目,嘗試縮小問題範圍:
- 高負載的原因為何?選取選項,查看 CPU 容量、CPU 和 CPU 等待、鎖定等待或 IO 等待。
- 負載過高的情況持續多久了?只有現在偏高嗎?還是長期偏高?變更日期範圍,找出負載開始效能不佳的日期和時間。
- 延遲時間是否突然增加?您可以變更時間範圍,研究正規化查詢的歷來延遲時間。
找出負載最高的區域和時間後,可以進一步深入分析。
檢查叢集的延遲時間
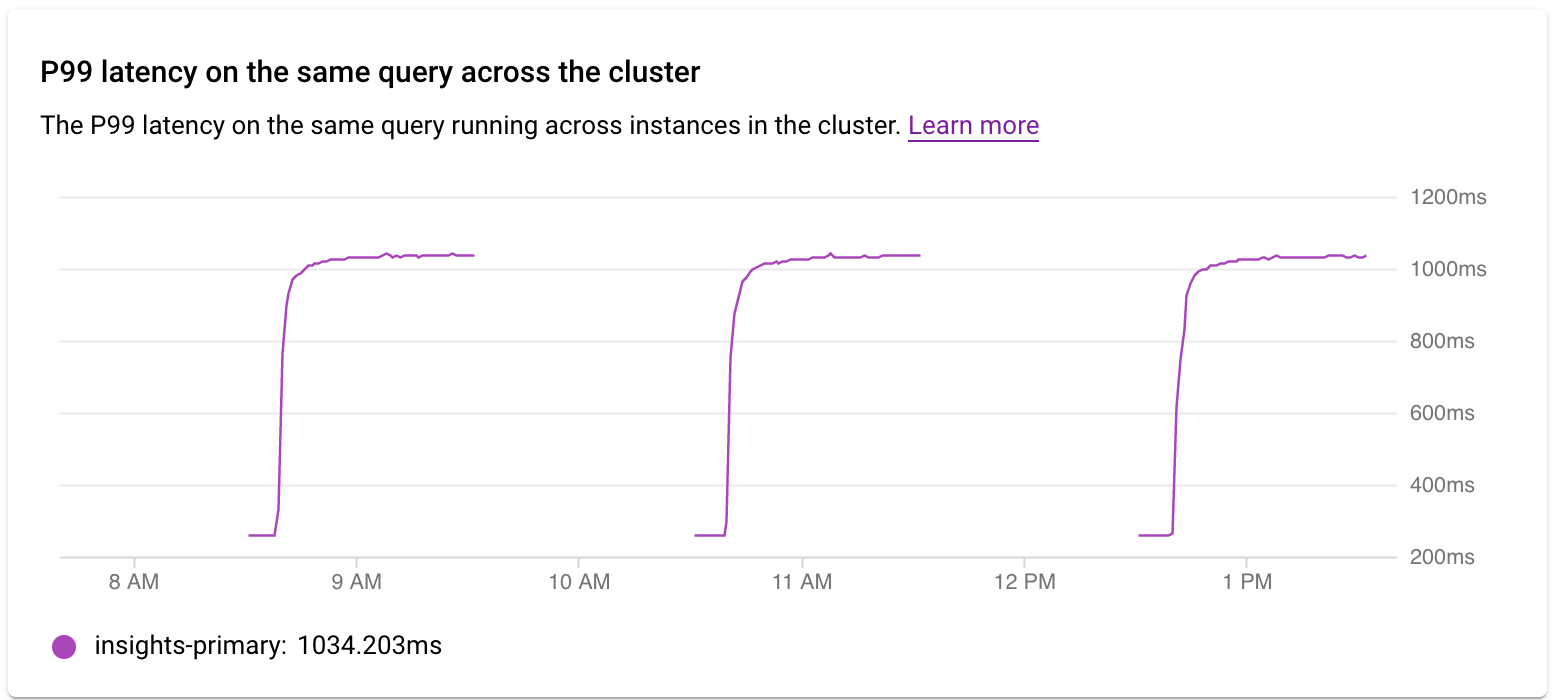
您可以使用「P99 latency on the same query across the cluster」(叢集內相同查詢第 99 個百分位數的延遲時間) 圖表,檢查叢集內執行個體中查詢或標記的 P99 延遲時間。
檢查取樣查詢計畫中的作業
查詢計畫會擷取查詢樣本,並將其拆解為個別作業。說明及分析查詢中的每項作業。「Query plan samples」(查詢計畫範例) 圖表會顯示在特定時間執行的所有查詢計畫,以及各項計畫的執行時間。
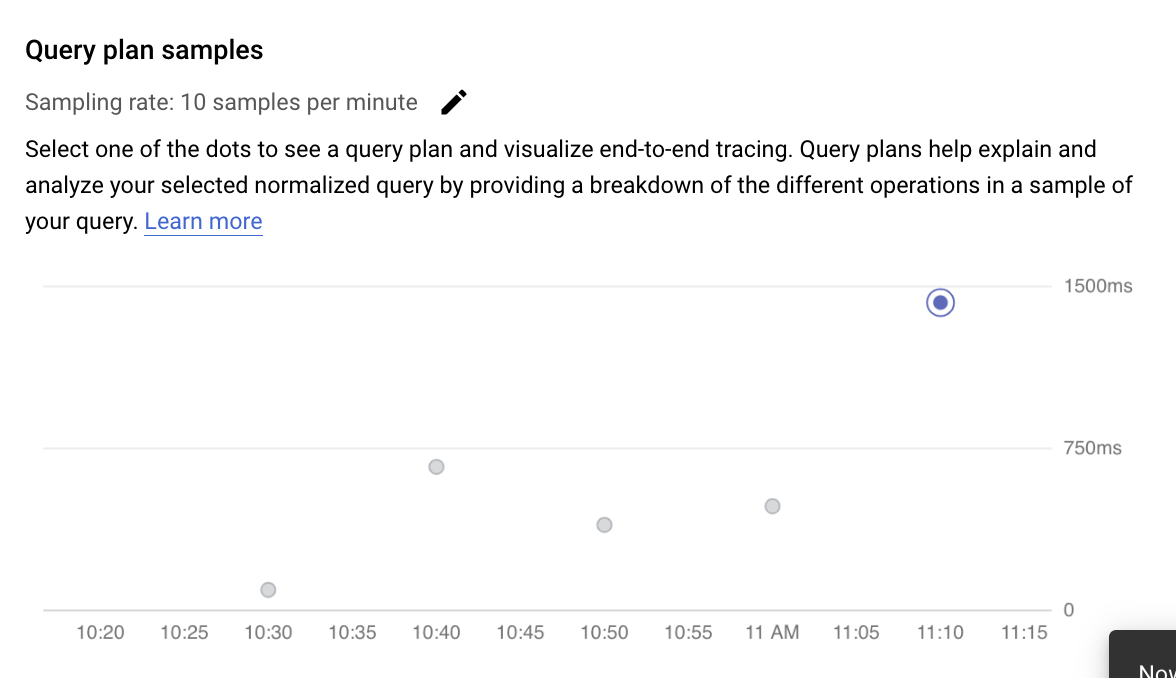
如要查看查詢計畫範例的詳細資料,請按一下「Sample query plans」(查詢計畫範例) 圖表上的圓點。您可以查看大多數 (但非全部) 查詢的已執行範例查詢計畫。請注意,AlloyDB for PostgreSQL 會自動取樣查詢。查詢執行次數越多,就越有可能被取樣。如需查看更多查詢計畫範例,請按照編輯查詢洞察設定的說明,提高取樣率上限。
查看查詢計畫的展開詳細資料時,您會看到該計畫中所有作業的模型。每項作業都會顯示延遲時間、傳回的資料列和費用。選取作業後,即可查看更多詳細資料,例如共用命中區塊、結構定義類型、實際迴圈、計畫資料列等。
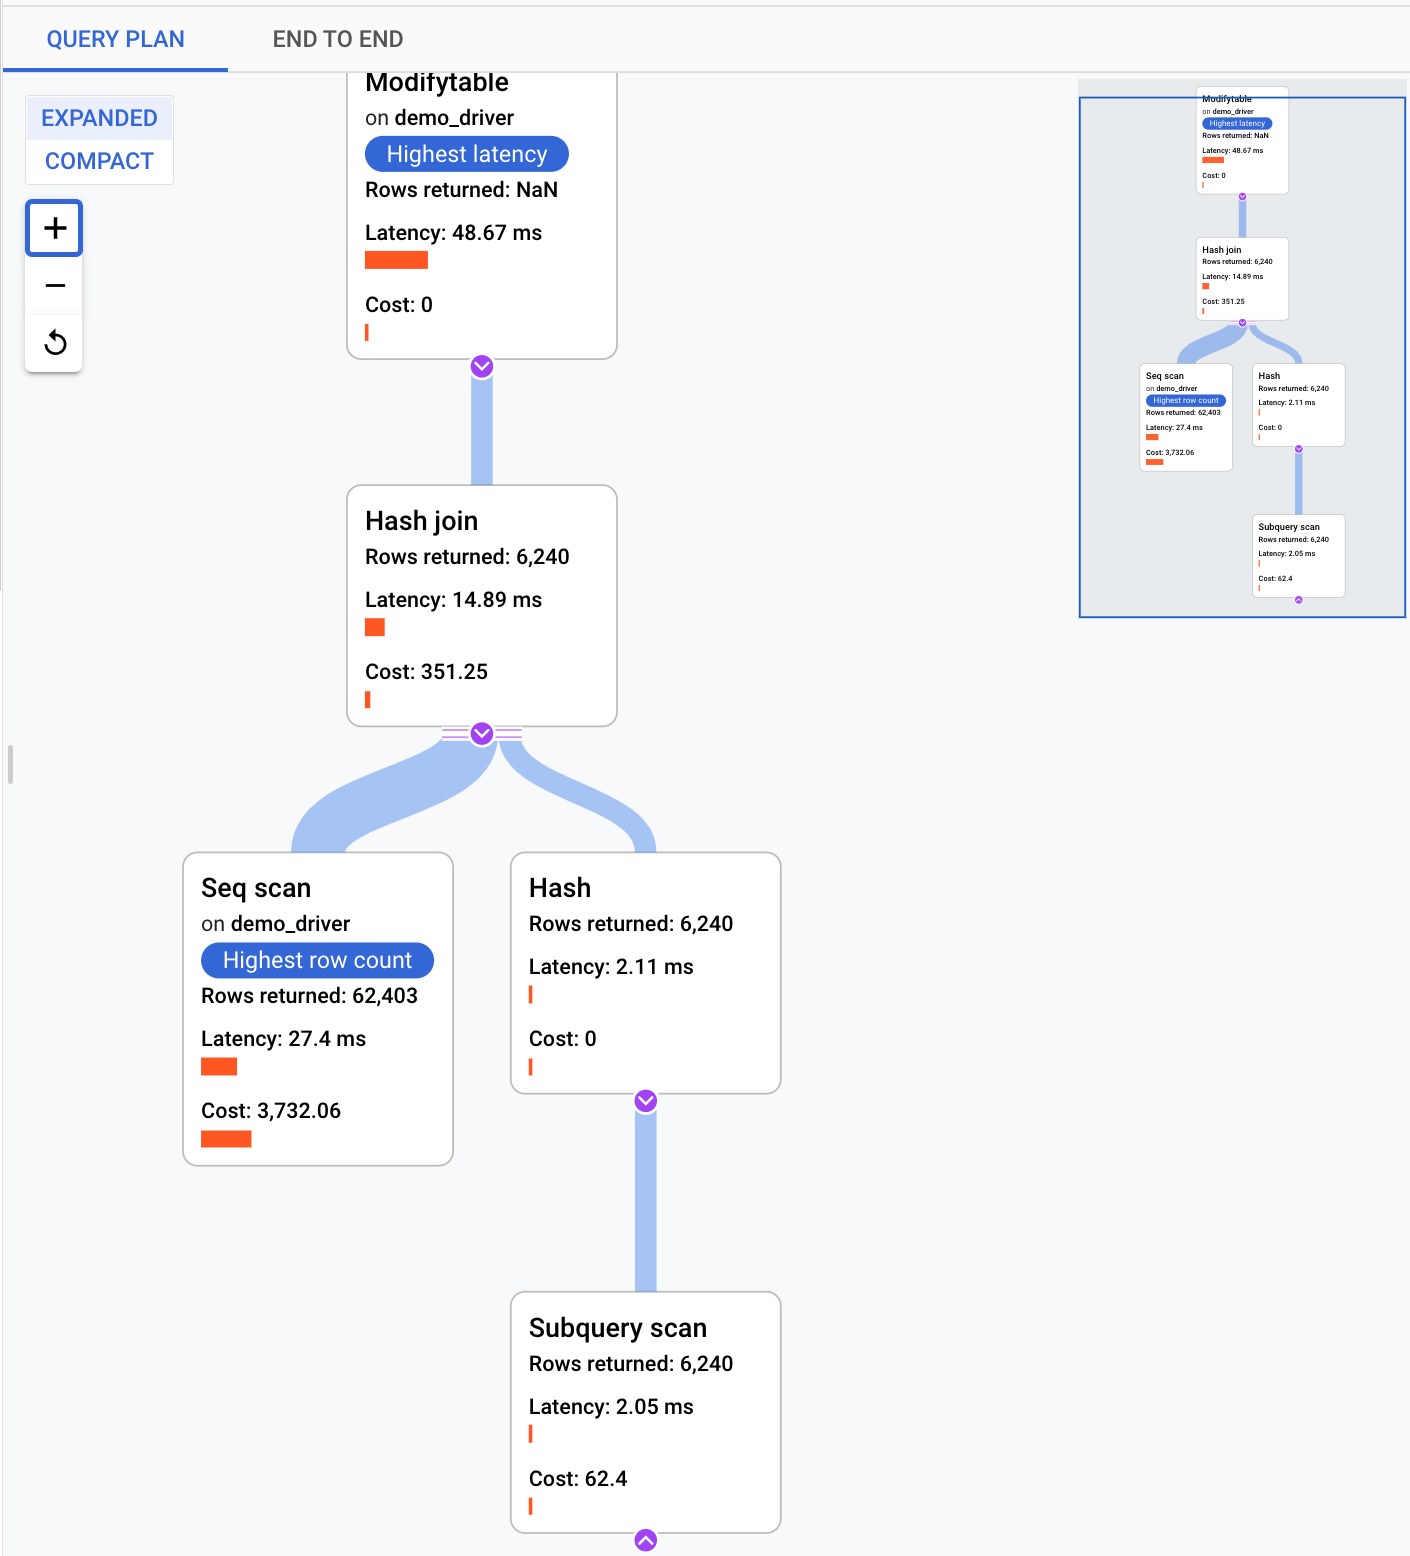
請試著透過下列問題縮小問題範圍:
- 資源消耗量為何?
- 與其他查詢有何關聯?
- 用量是否會隨時間變化?
檢查範例查詢產生的追蹤記錄
除了查看範例查詢計畫,您也可以使用查詢洞察,查看範例查詢的內容相關端對端應用程式追蹤記錄。這項追蹤記錄會顯示特定要求的資料庫活動,協助您找出有問題的查詢來源。此外,應用程式在要求期間傳送至 Cloud Logging 的記錄項目會連結至追蹤記錄,有助於您進行調查。
如要查看情境追蹤記錄,請按照下列步驟操作:
在「Sample Query」(範例查詢) 窗格中,按一下「End-to-end Trace」(端對端追蹤記錄) 分頁標籤。這個分頁會顯示甘特圖,詳細列出查詢產生的追蹤記錄中,個別作業的記錄 (即「span」)。
如要查看各個 span 的詳細資料 (例如屬性和中繼資料),請按一下該 span。
您也可以在「Trace Explorer」頁面查看追蹤記錄。如要這麼做,請按一下「View in Cloud Trace」(在 Cloud Trace 中查看)。如要進一步瞭解如何使用「Trace Explorer」頁面探索追蹤記錄資料,請參閱「尋找及探索追蹤記錄」。
為 SQL 查詢新增標記
標記 SQL 查詢可簡化應用程式疑難排解程序。您可以使用 sqlcommenter,透過物件關聯對應 (ORM) 自動或手動將標記新增至 SQL 查詢。
搭配使用 sqlcommenter 與 ORM
如果使用 ORM 而非直接編寫 SQL 查詢,您可能找不到導致效能問題的應用程式程式碼。您可能也難以分析應用程式程式碼對查詢效能的影響。為解決這個痛點,查詢洞察提供名為 sqlcommenter 的開放原始碼程式庫,這是一種 ORM 檢測程式庫。這個程式庫適合使用 ORM 的開發人員和管理員,可用於偵測哪些應用程式程式碼導致效能問題。
如果您同時使用 ORM 和 sqlcommenter,系統會自動建立標記,您不必變更或新增應用程式的自訂程式碼。
您可以在應用程式伺服器上安裝 sqlcommenter。檢測程式庫可讓與 MVC 架構相關的應用程式資訊,以 SQL 註解的形式與查詢一起傳播至資料庫。資料庫會擷取這些標記,並開始依標記記錄及匯總統計資料,這些資料與依正規化查詢匯總的統計資料互不相關。查詢洞察會顯示標記,方便您瞭解哪個應用程式造成查詢負載。這項資訊有助於找出造成效能問題的應用程式程式碼。
查看 SQL 資料庫記錄中的結果時,會顯示如下:
SELECT * from USERS /*action='run+this',
controller='foo%3',
traceparent='00-01',
tracestate='rojo%2'*/
支援的標記包括控制器名稱、路徑、框架和動作。
sqlcommenter 中的 ORM 組合支援多種程式設計語言:
| Python |
|
| Java |
|
| 小茹 |
|
| Node.js |
|
如要進一步瞭解 sqlcommenter,以及如何在 ORM 架構中使用 sqlcommenter,請參閱 GitHub 中的 sqlcommenter 說明文件。
使用 sqlcommenter 手動新增標記
如果您未使用 ORM,則必須手動將 sqlcommenter 標記新增至 SQL 查詢。在查詢中,您必須在每個 SQL 陳述式中加入註解,其中包含序列化的鍵/值組合。請至少使用下列其中一個鍵:
action=''controller=''framework=''route=''application=''db driver=''
查詢洞察會捨棄所有其他鍵。如要瞭解正確的 SQL 註解格式,請參閱 sqlcommenter 說明文件。
執行時間和時長
查詢洞察提供「平均執行時間 (毫秒)」指標,可回報所有平行 worker 完成查詢的所有子任務總時間。這項指標可協助您找出並最佳化會產生最高 CPU 負擔的查詢,進而最佳化資料庫的匯總資源使用率。
如要查看經過時間,您可以在 psql 用戶端上執行 \timing 指令,測量查詢時間長度。這項指標會測量從收到查詢到 PostgreSQL 伺服器傳送回應之間經過的時間。這項指標可協助您分析特定查詢耗時過長的原因,並決定是否要最佳化查詢,加快執行速度。
如果查詢是由單一工作以單一執行緒完成,則時間長度和平均執行時間會維持不變。
啟用 AlloyDB 適用的進階查詢洞察功能
AlloyDB 的進階查詢洞察功能資訊主頁已整合至標準查詢洞察資訊主頁。如要進一步瞭解如何啟用進階查詢洞察功能,請參閱「使用進階查詢洞察功能提升查詢效能」。
後續步驟
- 查詢洞察總覽
- 使用 AlloyDB 的進階查詢洞察功能,提高查詢效能
- AlloyDB 指標
- SQL Commenter 網誌:Sqlcommenter 簡介:開放原始碼 ORM 自動檢測程式庫
- How-to 網誌:使用 Sqlcommenter 啟用查詢標記