


AlloyDB for PostgreSQL 是與 PostgreSQL 相容的全代管資料庫服務。這項服務結合 Google 打造的資料庫引擎與雲端式多節點架構,可為要求最嚴苛的應用程式提供企業級效能、可靠性和可用性。
AlloyDB 的用途
AlloyDB 是可擴充的替代方案,可取代自行管理的標準 PostgreSQL。如果想減少管理基礎架構的時間,並將更多時間用於建構應用程式,請使用 AlloyDB。
AlloyDB 專為要求嚴苛的工作負載而設計,包括:
- 混合型交易與數據分析處理 (HTAP):對即時交易資料執行複雜的分析查詢,不會影響效能或可用性。
- 低延遲 AI 應用程式:使用 AlloyDB AI 建構生成式 AI 應用程式,將向量搜尋和機器學習模型叫用功能直接整合至資料庫引擎,不必進行高延遲的外部資料遷移作業。
- 企業級重要業務工作負載:部署需要最高效能、可靠性和可用性的應用程式,並由跨多個可用性區域的分離式運算和儲存架構提供支援。
AlloyDB 提供的功能
AlloyDB 提供多項服務,您不必自行建構及維護。您可以專注於資料,讓 AlloyDB 處理下列作業:
- 備份:透過隨選和自動排定的備份,以及可復原至特定時間點的持續復原系統,保護資料。
- 高可用性:透過位於不同可用區的備援節點,確保服務不中斷,並在節點之間自動容錯移轉。
- 資源管理:系統會視需要自動分配及釋出記憶體和儲存空間,提升效能和效率。
- 查詢最佳化:使用索引建議工具建議結構定義改善項目,並透過資料欄引擎加快分析查詢,提升資料庫效能。
- 安全性與加密:使用 Google-owned and Google-managed encryption keys 或客戶自行管理的加密金鑰 (CMEK) 保護靜態資料,並透過整合式 Identity and Access Management (IAM) 管理存取權。
資料庫管理
AlloyDB 會管理資料庫的基礎架構,例如自動備份、安全性修補程式和資源分配。不過,AlloyDB 並非獨立的資料庫管理工具。您仍需要管理工具,才能管理資料庫中的結構定義、資料和使用者。
您可以使用下列工具連線及管理資料庫:
- AlloyDB Studio:直接內建於 Google Cloud 控制台的網頁式工具,可讓您透過互動式 SQL 介面探索及管理資料。
- PostgreSQL 用戶端:AlloyDB 與 PostgreSQL 完全相容,因此您可以使用標準管理用戶端和指令列工具 (例如 psql 和 pgAdmin) 處理資料庫。
AlloyDB 定價
AlloyDB 採用「按用量收費」的計費模式,也就是根據您使用的資源計費。AlloyDB 定價會因設定而異,並取決於下列因素:
- 執行個體資源:為主要和讀取集區執行個體選取的機型 (vCPU 數量和 RAM 容量)。
- 儲存空間:叢集彈性儲存層中儲存的資料量。
- 網路:執行個體的網路輸出流量。
詳情請參閱「AlloyDB for PostgreSQL 定價」。
AlloyDB 的運作方式
應用程式會使用標準 PostgreSQL 通訊協定連線至 AlloyDB 執行個體。
AlloyDB 採用分散式架構和資源階層,可大幅提升可用性和效能。
與標準 PostgreSQL 的架構差異
傳統 PostgreSQL 會將處理查詢的資料庫引擎,與儲存空間結合在同一部伺服器上。AlloyDB 採用分散式架構,運算和儲存層各自獨立,可分別調整資源配置。
- 運算:處理查詢的虛擬機器或節點。
- 儲存空間:雲端原生分散式儲存引擎,可將資料保存在多個可用區,並隨著資料量增加自動擴充。
AlloyDB 資源階層
AlloyDB 將資源分為三個層級:叢集、執行個體和節點。
下圖說明 AlloyDB 資源階層,其中包含一個叢集,內有一個主要執行個體和多個負載平衡的讀取集區執行個體:
- 叢集:頂層資源,是區域內資料庫、記錄和其他中繼資料的邏輯容器。您可以在同一個專案和區域中建立多個叢集。
- 執行個體:叢集包含一或多個執行個體。執行個體會為應用程式提供連線點。
- 節點:執行個體由一或多個節點提供。節點是專門用來執行資料庫引擎的虛擬機器 (VM)。
什麼是 AlloyDB 執行個體?
AlloyDB 執行個體是資料庫的存取點。每個執行個體在虛擬私有雲 (VPC) 網路中都有私人靜態 IP 位址。應用程式向這個 IP 位址傳送查詢時,執行個體會將要求轉送至基礎節點處理。
AlloyDB 使用兩種執行個體:
主要執行個體:提供資料的讀取和寫入權限。每個叢集都只有一個主要執行個體。主要執行個體可以是高可用性 (HA) 或基本執行個體。
高可用性:包含兩個節點 (一個使用中節點和一個待命節點),位於不同可用區,可自動容錯移轉。
基本執行個體:包含單一節點,適用於不需要高可用性的非正式環境。基本執行個體只有一個節點,沒有待命節點。詳情請參閱「使用基本執行個體降低成本」。
讀取集區執行個體:提供唯讀存取權,可調度工作負載資源。您可以新增一或多個讀取集區執行個體,每個執行個體在叢集中最多可包含 20 個節點。AlloyDB 會自動在讀取集區中的節點之間平衡要求負載。
主要功能與特色
AlloyDB 與標準 PostgreSQL 安裝作業有許多不同之處,除了先前所述的多節點架構固有的垂直和水平擴充優勢外,以下各節將深入探討 AlloyDB 的主要功能。
自動調整的資料庫功能
為每個 AlloyDB 節點提供支援的資料庫引擎與 PostgreSQL 完全相容,具備多項功能,可持續分析執行個體處理的查詢結構和頻率,並根據這項資訊建議結構定義改善措施,或自動套用最佳化設定:
索引建議工具可協助您根據使用模式,找出使用新索引最佳化資料庫結構定義的機會。
資料欄引擎會以資料欄格式將資料儲存在記憶體中,加快數據分析查詢的效能。AlloyDB 就能視需要使用進階處理技術,有效率地掃描大量資料表資料。
PostgreSQL 過時資料自動清理功能的自動調整變化版本,會自動調整清理相關參數,以最適合工作負載的形式運作。
自動記憶體和儲存空間管理系統會利用 AlloyDB 運作的 Google 建構雲端式環境,視需要持續分配及釋出記憶體和儲存空間,讓叢集以最佳效能和資源效率運作。
高可用性
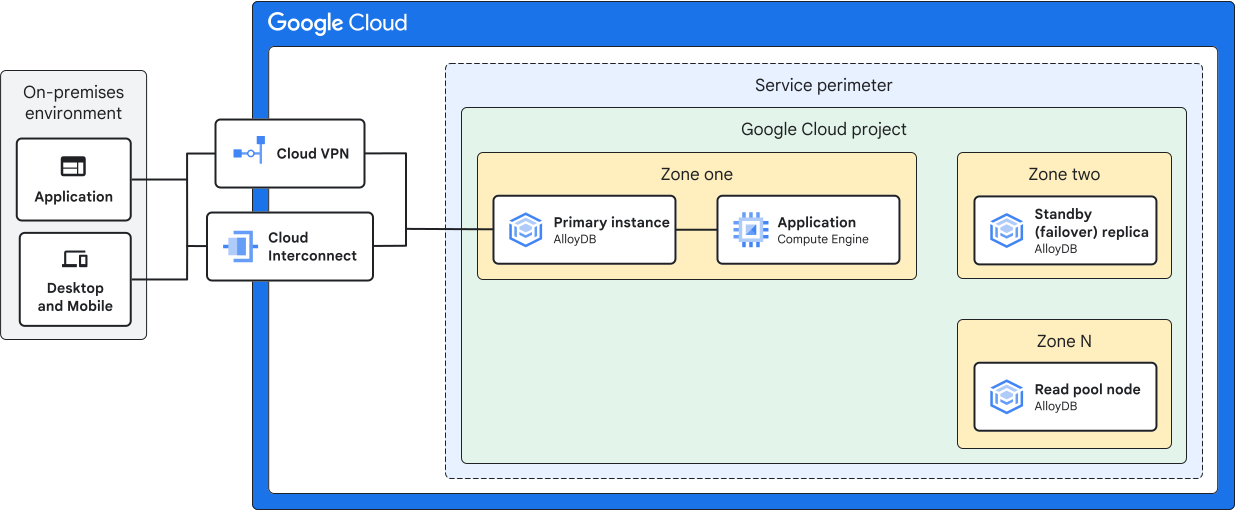
根據預設,AlloyDB 叢集會透過主要執行個體的備援節點 (位於兩個不同可用區) 提供高可用性 (HA),並具備自動容錯移轉功能。
如果叢集在非正式環境中運作,且不需要高可用性,則可改用基本的單一可用區主要執行個體。
新增包含至少兩個節點的讀取集區執行個體,可進一步建立負載平衡、多可用區、高可用性的資料存取點。所有讀取集區執行個體都會獨立於主要執行個體運作。
如要進一步瞭解特定區域的注意事項,請參閱「地理位置與區域」一文。
資料備份與災害復原
AlloyDB 具備持續備份與復原系統,可讓您根據可調整保留期限內的任何時間點建立新叢集。這樣一來,您就能在資料遺失時快速復原。
此外,AlloyDB 還能視需要或定期建立及儲存叢集資料的完整備份。您隨時可以透過備份還原至新的 AlloyDB 叢集,其中包含備份建立時原始叢集的所有資料。
詳情請參閱「關於備份」。
如要進一步進行災難復原,您可以在不同的 Google Cloud區域建立次要叢集,藉此進行跨區域複製。AlloyDB 會以非同步方式,將資料從指定的主要叢集串流至各個次要叢集。您隨時可以將次要叢集升級為主要叢集,或執行跨區域容錯移轉 (預先發布版),在服務中斷期間自動維護複製拓撲。
詳情請參閱「關於跨區域複製」。
安全性和存取控管
您可以設定叢集,要求使用安全的 AlloyDB Auth Proxy 連線,該 Proxy 會使用 IAM 控管存取權。詳情請參閱「授權」。
AlloyDB 使用標準 PostgreSQL 使用者角色系統進行驗證,並導入 AlloyDB 專屬的幾個額外角色。詳情請參閱「管理 AlloyDB 使用者角色」。
加密
AlloyDB 預設會使用 Google-owned and Google-managed encryption keys保護所有靜態資料。如果需要使用您提供的金鑰加密資料,可以在建立叢集時指定客戶自行管理的加密金鑰 (CMEK)。AlloyDB 接著會使用 CMEK 金鑰,加密寫入該叢集的所有資料。
CMEK 也適用於備份。建立隨選備份、設定備份排程或從備份還原時,可以指定 CMEK 金鑰。
詳情請參閱「關於 CMEK」。
維護與更新
在 AlloyDB 叢集的生命週期中,可能會發生兩種更新:
- 系統更新:Google 會定期執行系統更新,確保基礎硬體和軟體可靠、安全,並發揮最佳效能。這些更新包括安全性修補程式、作業系統升級,以及 PostgreSQL 伺服器次要版本更新。
- 設定更新:您手動對叢集或執行個體進行的變更,以因應工作負載需求變化。例如調整執行個體的 vCPU 和記憶體數量,或修改資料庫旗標。
AlloyDB 維護作業不會中斷服務。具體做法是準備好替代伺服器,並在準備就緒時快速與使用中的伺服器交換。在這項程序中,主要執行個體的停機時間通常不到一秒,讀取集區則會持續可用。資料庫的所有有效連線都會暫時中斷,但您在整個過程中仍可正常使用資料庫。
如要加快套用旗標更新,即使停機時間較長也沒關係,可以使用 FORCE_APPLY 更新模式。
AlloyDB AI
AlloyDB AI 將一套 AI 和機器學習功能直接整合至 AlloyDB 資料庫。過去,建構 AI 應用程式需要複雜的資料管道和 ETL 程序,才能將資料從作業資料庫移至專門的 AI/機器學習平台。這種方法會帶來一些挑戰,例如資料移轉導致延遲時間增加、管理不同系統導致作業負擔增加,以及重複儲存。AlloyDB AI 直接將 AI 功能整合至資料庫,因此不需要大量移動外部資料。
為協助開發 AI 應用程式,AlloyDB AI 提供下列擴充功能:
vector(專為 AlloyDB AI 自訂的pgvector版本):儲存及建立向量嵌入索引,用於語意搜尋。支援執行混合型查詢和相似度搜尋。如要開始使用向量搜尋,請參閱「執行向量搜尋」。alloydb_scann:採用 ScaNN 演算法,實作高效率的最鄰近索引,提供高效能的近似最鄰近搜尋。詳情請參閱「建立 ScaNN 索引」。google_ml_integration:提供 AI 函式的存取權,可從 AlloyDB 叫用機器學習模型,執行生成嵌入、語意排名、AI 篩選器和彙整,以及文字生成和摘要等工作。模型端點管理功能可讓您註冊及叫用 AI 模型,包括 OpenAI 或 Anthropic 的外部模型。詳情請參閱「註冊模型端點」和「使用 AI 運算子評估語意查詢」。alloydb_ai_nl:可讓您使用自然語言與資料庫互動。應用程式開發人員可運用這項功能,根據使用者提出的自然語言問題,生成準確且安全的 SQL 查詢,讓不熟悉 SQL 的使用者也能存取資料。詳情請參閱「自然語言總覽」。
如需 AlloyDB AI 功能的用途清單,請參閱「建構生成式 AI 應用程式」。
擴充功能支援
AlloyDB 支援多種熱門的 PostgreSQL 擴充功能。如需完整清單,請參閱「支援的資料庫擴充功能」。
自行託管的替代方案:AlloyDB Omni
除了在 Google Cloud中執行 AlloyDB,您也可以選擇 Google 提供的 AlloyDB Omni。這個精簡、可下載的 AlloyDB 版本,可讓您在自己的 Linux 運算環境中執行強大的資料庫引擎,無論環境位於何處。
如要在Google Cloud 控制台中探索部署選項、程式碼實驗室及管理訂閱項目,請前往 AlloyDB Omni 控制台頁面。
詳情請參閱「AlloyDB Omni 總覽」。