


O AlloyDB para PostgreSQL é um serviço de banco de dados totalmente gerenciado e compatível com o PostgreSQL. Ele combina um mecanismo de banco de dados criado pelo Google com uma arquitetura de vários nós baseada na nuvem para oferecer desempenho, confiabilidade e disponibilidade de nível empresarial para seus aplicativos mais exigentes.
Casos de uso do AlloyDB
O AlloyDB oferece uma alternativa escalonável ao PostgreSQL padrão autogerenciado. Use o AlloyDB se quiser passar menos tempo gerenciando a infraestrutura e mais tempo criando aplicativos.
O AlloyDB foi projetado para cargas de trabalho exigentes, incluindo:
- Processamento transacional e analítico híbrido (HTAP): execute consultas analíticas complexas nos seus dados transacionais ativos sem afetar o desempenho ou a disponibilidade.
- Aplicativos de IA de baixa latência: crie aplicativos de IA generativa usando a IA do AlloyDB, que integra a pesquisa vetorial e a invocação de modelos de machine learning diretamente no mecanismo de banco de dados, eliminando a necessidade de movimentação de dados externos de alta latência.
- Cargas de trabalho essenciais de nível empresarial: implante aplicativos que exigem os mais altos níveis de desempenho, confiabilidade e disponibilidade, com o suporte de uma arquitetura desagregada de computação e armazenamento que abrange várias zonas de disponibilidade.
O que o AlloyDB oferece
O AlloyDB oferece muitos serviços para que você não precise criá-los e mantê-los por conta própria. Você pode se concentrar nos dados e deixar que o AlloyDB lide com as seguintes operações:
- Backups: proteja seus dados com backups programados automatizados e sob demanda, além de um sistema de recuperação contínua que permite a recuperação pontual.
- Alta disponibilidade: garanta a continuidade do serviço com nós redundantes localizados em diferentes zonas, com failover automático entre eles.
- Gerenciamento de recursos: otimize o desempenho e a eficiência com sistemas que alocam e liberam automaticamente memória e armazenamento conforme necessário.
- Otimização de consultas: melhore o desempenho do banco de dados usando um consultor de índice que sugere melhorias de esquema e um mecanismo colunar que acelera as consultas analíticas.
- Segurança e criptografia: proteja dados em repouso usando Google-owned and Google-managed encryption keys ou chaves de criptografia gerenciadas pelo cliente (CMEK) e gerencie o acesso usando o Identity and Access Management (IAM) integrado.
Administração de banco de dados
O AlloyDB gerencia a infraestrutura do banco de dados, como backups automatizados, patches de segurança e alocação de recursos. No entanto, o AlloyDB não é uma ferramenta independente de administração de banco de dados. Você ainda precisa de ferramentas administrativas para gerenciar os esquemas, os dados e os usuários nos bancos de dados.
Use as seguintes ferramentas para se conectar e gerenciar seus bancos de dados:
- AlloyDB Studio: uma ferramenta baseada na Web integrada diretamente ao console do Google Cloud que permite analisar e gerenciar seus dados usando uma interface SQL interativa.
- Clientes PostgreSQL: como o AlloyDB é totalmente compatível com o PostgreSQL, é possível usar clientes administrativos padrão e ferramentas de linha de comando, como psql e pgAdmin, para trabalhar com seu banco de dados.
Preços do AlloyDB
O AlloyDB usa um modelo de preço por consumo, ou seja, você recebe cobranças pelos recursos que usa. Os preços do AlloyDB variam de acordo com as definições de configuração e dependem dos seguintes fatores:
- Recursos da instância: o tipo de máquina (número de vCPUs e quantidade de RAM) selecionado para as instâncias primárias e de pool de leitura.
- Armazenamento: a quantidade de dados armazenados na camada de armazenamento flexível do cluster.
- Rede: a quantidade de tráfego de saída de rede das suas instâncias.
Para mais informações, consulte Preços do AlloyDB para PostgreSQL.
Como o AlloyDB funciona
Um aplicativo se conecta a instâncias do AlloyDB usando protocolos padrão do PostgreSQL.
Nos bastidores, o AlloyDB usa uma arquitetura desagregada e uma hierarquia de recursos projetada para maximizar a disponibilidade e o desempenho.
Diferença de arquitetura em relação ao PostgreSQL padrão
O PostgreSQL tradicional combina o mecanismo de banco de dados que processa consultas com o armazenamento no mesmo servidor. O AlloyDB usa uma arquitetura desagregada, em que as camadas de computação e armazenamento são separadas e escalonadas de forma independente.
- Computação: máquinas virtuais ou nós que processam suas consultas.
- Armazenamento: um mecanismo de armazenamento distribuído e nativo da nuvem que mantém seus dados em várias zonas de disponibilidade e é escalonado automaticamente à medida que seus dados aumentam.
Hierarquia de recursos do AlloyDB
O AlloyDB organiza os recursos em três níveis: clusters, instâncias e nós.
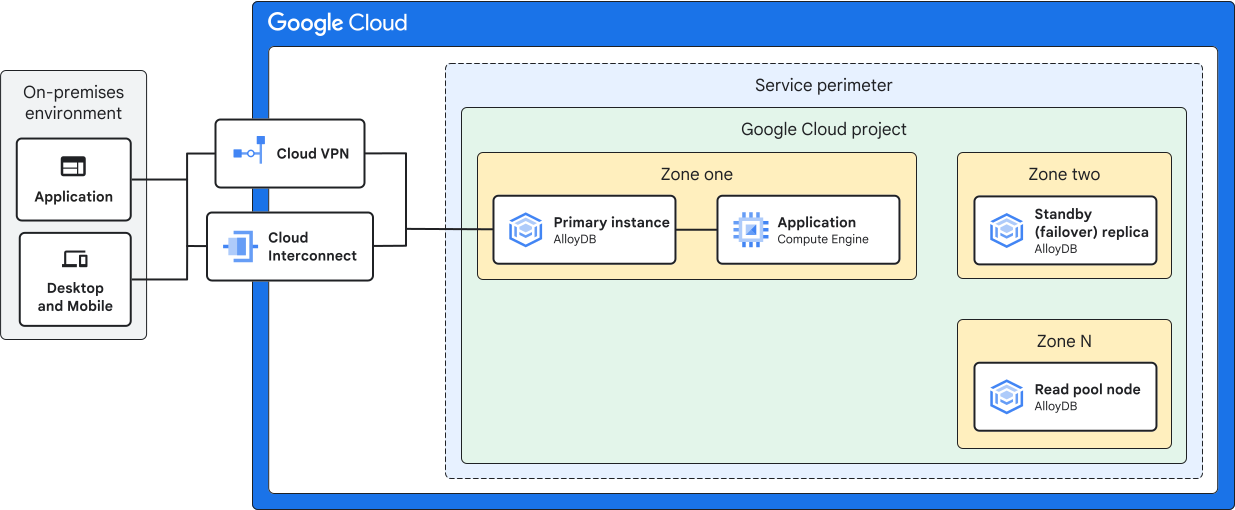
O diagrama a seguir ilustra a hierarquia de recursos do AlloyDB, com um cluster escalonado com uma instância primária e várias instâncias de pool de leitura com balanceamento de carga:
- Cluster: um recurso de nível superior que atua como um contêiner lógico para seus bancos de dados, registros e outros metadados em uma região. É possível criar vários clusters no mesmo projeto e região.
- Instância: um cluster contém uma ou mais instâncias. Uma instância fornece o ponto de conexão para seus aplicativos.
- Nó: uma instância é alimentada por um ou mais nós. Um nó é uma máquina virtual (VM) dedicada à execução do mecanismo de banco de dados.
O que é uma instância do AlloyDB?
Uma instância do AlloyDB é o ponto de acesso do seu banco de dados. Cada instância tem um endereço IP estático e particular na sua rede de nuvem privada virtual (VPC). Quando o aplicativo envia uma consulta para esse endereço IP, a instância encaminha a solicitação aos nós subjacentes para processamento.
O AlloyDB usa dois tipos de instâncias:
Instância principal: fornece acesso de leitura e gravação aos seus dados. Cada cluster tem exatamente uma instância principal. Uma instância principal pode ser de alta disponibilidade (HA) ou básica.
Alta disponibilidade: contém dois nós, um ativo e um em espera, localizados em zonas diferentes para failover automático.
Instância básica: contém um único nó para ambientes que não são de produção e não exigem alta disponibilidade. Uma instância básica tem apenas um nó, sem nó em espera. Para mais informações, consulte Reduzir custos usando instâncias básicas.
Instância do pool de leitura: fornece acesso somente leitura para escalonar suas cargas de trabalho. É possível adicionar uma ou mais instâncias de pool de leitura, cada uma com até 20 nós no total em todo o cluster. O AlloyDB faz o balanceamento de carga das solicitações automaticamente entre os nós em um pool de leitura.
Principais recursos
O AlloyDB se diferencia de uma instalação padrão do PostgreSQL de várias maneiras, além das vantagens de escalonamento vertical e horizontal inerentes à arquitetura de vários nós descrita anteriormente. As seções a seguir analisam os principais recursos do AlloyDB.
Recursos de banco de dados automáticos e adaptáveis
O mecanismo de banco de dados totalmente compatível com o PostgreSQL que alimenta cada nó do AlloyDB tem vários recursos que analisam continuamente a estrutura e a frequência das consultas que as instâncias processam, usando essas informações para sugerir melhorias de esquema ou aplicar otimizações automaticamente:
Um consultor de índice ajuda você a encontrar oportunidades para otimizar o esquema do banco de dados usando novos índices com base nos seus padrões de uso.
Um mecanismo colunar pode acelerar o desempenho de consultas analíticas armazenando dados na memória em um formato colunar. Isso permite que o AlloyDB use técnicas de processamento avançadas para verificar com eficiência uma grande quantidade de dados de tabela quando necessário.
Uma variação adaptável do recurso de autovacuum de dados desatualizados do PostgreSQL ajusta automaticamente os parâmetros relacionados ao vacuum para se adequar melhor ao formato da sua carga de trabalho.
Os sistemas de gerenciamento automático de memória e armazenamento aproveitam o ambiente baseado na nuvem criado pelo Google em que o AlloyDB é executado, alocando e liberando continuamente memória e armazenamento conforme necessário para manter o cluster em execução com desempenho e eficiência de recursos ideais.
Alta disponibilidade
Por padrão, um cluster do AlloyDB oferece alta disponibilidade (HA, na sigla em inglês) por meio dos nós redundantes da instância primária, localizados em duas zonas diferentes, com failover automático.
Os clusters que operam em ambientes de não produção que não exigem alta disponibilidade podem, opcionalmente, usar instâncias primárias básicas de zona única.
Adicionar instâncias de pool de leitura com pelo menos dois nós cria mais pontos de acesso de alta disponibilidade, multizonais e com balanceamento de carga para seus dados. Todas as instâncias do pool de leitura são executadas de maneira independente da instância principal.
Para mais informações sobre considerações específicas de cada região, consulte Geografia e regiões.
Backup de dados e recuperação de desastres
O AlloyDB conta com um sistema de backup e recuperação contínuos que permite criar um novo cluster com base em qualquer momento dentro de um período de armazenamento ajustável. Isso permite que você se recupere rapidamente de acidentes de perda de dados.
Além disso, o AlloyDB pode criar e armazenar backups completos dos dados do cluster, sob demanda ou em uma programação regular. A qualquer momento, é possível restaurar um backup em um novo cluster do AlloyDB que contenha todos os dados do cluster original no momento da criação do backup.
Para mais informações, consulte Sobre backups.
Como outro método de recuperação de desastres, é possível realizar a replicação entre regiões criando clusters secundários em regiões separadas do Google Cloud. O AlloyDB transmite dados de maneira assíncrona de um cluster principal designado para cada um dos clusters secundários. A qualquer momento, é possível promover um cluster secundário a um cluster primário ou realizar um failover entre regiões (pré-lançamento) para manter automaticamente sua topologia de replicação durante uma interrupção.
Para mais informações, consulte Sobre a replicação entre regiões.
Segurança e controle de acesso
É possível configurar um cluster para exigir conexão com o proxy de autenticação seguro do AlloyDB, que usa o IAM para controle de acesso. Para mais informações, consulte Autorização.
O AlloyDB usa o sistema padrão de função do usuário do PostgreSQL para autenticação, introduzindo alguns papéis adicionais específicos do AlloyDB. Para mais informações, consulte Gerenciar papéis de usuário do AlloyDB.
Criptografia
O AlloyDB protege todos os dados em repouso usando Google-owned and Google-managed encryption keys por padrão. Se você precisar criptografar seus dados usando uma chave fornecida por você, especifique uma chave de criptografia gerenciada pelo cliente (CMEK) ao criar um cluster. Em seguida, o AlloyDB usa a chave CMEK para criptografar todos os dados gravados nesse cluster.
A CMEK também se aplica a backups. É possível especificar uma chave CMEK ao criar um backup sob demanda, configurar uma programação de backup ou restaurar um backup.
Para mais informações, acesse Sobre CMEK.
Manutenção e atualizações
Durante a vida útil de um cluster do AlloyDB, dois tipos de atualizações podem ocorrer:
- Atualizações do sistema: o Google realiza atualizações periódicas do sistema para garantir que o hardware e o software subjacentes sejam confiáveis, seguros e tenham o desempenho ideal. Essas atualizações incluem patches de segurança, upgrades do sistema operacional e atualizações de versões secundárias do servidor PostgreSQL.
- Atualizações de configuração: são mudanças que você faz manualmente no cluster ou nas instâncias para atender às demandas de carga de trabalho em constante mudança. Por exemplo, redimensionar a vCPU e a contagem de memória de uma instância ou modificar as flags de banco de dados.
As operações de manutenção do AlloyDB são projetadas para não causar interrupções. Para isso, prepare servidores de substituição e troque-os rapidamente pelos servidores ativos quando estiverem prontos. Durante esse processo, as instâncias primárias geralmente têm menos de um segundo de inatividade, enquanto os pools de leitura permanecem disponíveis continuamente. Todas as conexões ativas com o banco de dados são interrompidas momentaneamente, mas você pode continuar usando o banco de dados normalmente durante o processo.
Para aplicar uma atualização de flag mais rapidamente, mesmo que isso cause um tempo de inatividade maior, use o modo de atualização FORCE_APPLY.
IA do AlloyDB
A IA do AlloyDB integra um conjunto de recursos de IA e ML diretamente ao seu banco de dados do AlloyDB. Antes, a criação de aplicativos de IA exigia pipelines de dados complexos e processos de ETL para mover dados de bancos de dados operacionais para plataformas especializadas de IA/ML. Esse método levou a desafios como aumento da latência da transferência de dados, maior overhead operacional do gerenciamento de diferentes sistemas e armazenamento duplicado. Ao integrar recursos de IA diretamente ao banco de dados, a IA do AlloyDB elimina a necessidade de movimentação extensiva de dados externos.
Para facilitar o desenvolvimento de aplicativos de IA, a IA do AlloyDB oferece as seguintes extensões:
vector(uma versão dopgvectorpersonalizada para a IA do AlloyDB): armazena e indexa embeddings de vetor para pesquisa semântica. Oferece suporte à execução de consultas híbridas e pesquisas de similaridade. Para começar a usar a pesquisa vetorial, consulte Fazer uma pesquisa vetorial.alloydb_scann: fornece pesquisa de vizinho mais próximo aproximado de alto desempenho implementando um índice de vizinho mais próximo altamente eficiente com tecnologia do algoritmo ScaNN. Para mais informações, consulte Criar um índice ScaNN.google_ml_integration: fornece acesso às funções de IA, que permitem a invocação de modelos de ML do AlloyDB para tarefas como geração de embeddings, classificação semântica, filtros e mesclagens baseados em IA, além de geração e resumo de texto. O gerenciamento de endpoints de modelo permite o registro e a invocação de modelos de IA, incluindo modelos externos da OpenAI ou da Anthropic. Para mais informações, consulte Registrar um endpoint de modelo e Avaliar consultas semânticas com operadores de IA.alloydb_ai_nl: permite interagir com o banco de dados usando linguagem natural. Ele permite que os desenvolvedores de aplicativos gerem consultas SQL precisas e seguras em resposta a perguntas em linguagem natural dos usuários finais, permitindo que usuários que não conhecem SQL acessem dados. Para mais informações, consulte Visão geral da linguagem natural.
Para ver uma lista de casos de uso dos recursos da IA do AlloyDB, consulte Criar aplicativos de IA generativa.
Suporte a extensões
O AlloyDB é compatível com várias extensões conhecidas do PostgreSQL. Para ver a lista completa, consulte Extensões de banco de dados compatíveis.
Uma alternativa auto-hospedada: AlloyDB Omni
Como alternativa à execução do AlloyDB no Google Cloud, o Google oferece o AlloyDB Omni. Essa edição simplificada e para download do AlloyDB permite que você execute o poderoso mecanismo de banco de dados no seu próprio ambiente de computação baseado em Linux, onde quer que ele esteja.
Para conhecer as opções de implantação, os codelabs e gerenciar assinaturas no console doGoogle Cloud , acesse a página do console do AlloyDB Omni.
Para mais informações, consulte a Visão geral do AlloyDB Omni.