


Mit der Vektorsuche in AlloyDB for PostgreSQL können Sie semantisch ähnliche Einträge finden, indem Sie Vektoreinbettungen in Ihrer Datenbank speichern und abfragen. In dieser Anleitung richten Sie eine Datenbanktabelle ein, laden Beispielvektoreinbettungen, erstellen einen ScaNN-Index und führen Vektorähnlichkeitsabfragen mit der Google Cloud Console aus. Die Beispiele in dieser Anleitung dienen nur zu Demonstrationszwecken.
Informationen dazu, wie Sie mit der gefilterten Vektorsuche Ihre Ähnlichkeitssuchen verfeinern können, finden Sie unter Gefilterte Vektorsuche in AlloyDB for PostgreSQL.
Informationen zum Ausführen einer Vektorsuche mit Einbettungen der Gemini Enterprise Agent Platform finden Sie unter Erste Schritte mit Vektoreinbettungen in AlloyDB AI.
Ziele
- Erstellen Sie einen AlloyDB-Cluster und eine primäre Instanz.
- Verbindung zur Datenbank herstellen und erforderliche Erweiterungen installieren
- Erstellen Sie eine
product- und eineproduct inventory-Tabelle. - Daten in die Tabellen
productundproduct inventoryeinfügen und eine einfache Vektorsuche durchführen - Erstellen Sie einen ScaNN-Index für die Tabelle „products“.
- Führen Sie eine einfache Vektorsuche durch.
- Komplexe Vektorsuche mit einem Filter und einem Join ausführen
Kosten
In diesem Dokument verwenden Sie die folgenden kostenpflichtigen Komponenten von Google Cloud:
Mit dem Preisrechner können Sie eine Kostenschätzung für Ihre voraussichtliche Nutzung vornehmen.
Nach Abschluss der in diesem Dokument beschriebenen Aufgaben können Sie weitere Kosten vermeiden, indem Sie die erstellten Ressourcen löschen. Weitere Informationen finden Sie unter Bereinigen.
Hinweis
Abrechnung und erforderliche APIs aktivieren
Rufen Sie in der Google Cloud Console die Seite Cluster auf.
Die Abrechnung für Ihr Google Cloud Projekt muss aktiviert sein.
Aktivieren Sie die Cloud APIs, die zum Erstellen von AlloyDB for PostgreSQL und zum Herstellen einer Verbindung erforderlich sind.
- Klicken Sie im Schritt Projekt bestätigen auf Weiter, um den Namen des Projekts zu bestätigen, an dem Sie Änderungen vornehmen möchten.
Klicken Sie im Schritt APIs aktivieren auf Aktivieren, um Folgendes zu aktivieren:
- AlloyDB API
- Compute Engine API
- Service Networking API
- Agent Platform API
AlloyDB-Cluster und primäre Instanz erstellen
Rufen Sie in der Google Cloud Console die Seite Cluster auf.
Klicken Sie auf Cluster erstellen.
Geben Sie unter Cluster-ID
my-clusterein.Geben Sie ein Passwort ein. Notieren Sie sich dieses Passwort, da Sie es in dieser Anleitung verwenden.
Wählen Sie eine Region aus, z. B.
us-central1 (Iowa).Wählen Sie das Standardnetzwerk aus.
Wenn Sie eine Verbindung für privaten Zugriff haben, fahren Sie mit dem nächsten Schritt fort. Andernfalls klicken Sie auf Verbindung einrichten und gehen Sie so vor:
- Klicken Sie unter IP-Bereich zuweisen auf Automatisch zugewiesenen IP-Bereich verwenden.
- Klicken Sie auf Weiter und dann auf Verbindung erstellen.
Wählen Sie unter Zonale Verfügbarkeit die Option Einzelne Zone aus.
Wählen Sie den Maschinentyp
2 vCPU,16 GBaus.Wählen Sie unter Konnektivität die Option Öffentliche IP-Adresse aktivieren aus.
Klicken Sie auf Cluster erstellen. Es kann einige Minuten dauern, bis AlloyDB den Cluster erstellt und auf der Übersichtsseite des primären Clusters anzeigt.
Maximieren Sie unter Instanzen in Ihrem Cluster den Bereich Konnektivität. Notieren Sie sich den Verbindungs-URI, da Sie ihn in dieser Anleitung verwenden.
Der Verbindungs-URI hat das Format
projects/PROJECT_ID/locations/REGION_ID/clusters/my-cluster/instances/my-cluster-primary.
Dem AlloyDB-Dienst-Agent die Nutzerberechtigung für die Agent Platform gewähren
Damit AlloyDB die Texteinbettungsmodelle der Agent Platform verwenden kann, müssen Sie dem AlloyDB-Dienst-Agent für das Projekt, in dem sich Ihr Cluster und Ihre Instanz befinden, Nutzerberechtigungen für die Agent Platform hinzufügen.
Weitere Informationen zum Hinzufügen der Berechtigungen finden Sie unter AlloyDB-Dienst-Agent die Nutzerberechtigung für die Agent-Plattform gewähren.
Verbindung zur Datenbank über einen Webbrowser herstellen
Rufen Sie in der Google Cloud Console die Seite Cluster auf.
Klicken Sie in der Spalte Ressourcenname auf den Namen Ihres Clusters,
my-cluster.Klicken Sie im Navigationsbereich auf AlloyDB Studio.
Gehen Sie auf der Seite In AlloyDB Studio anmelden so vor:
- Wählen Sie die Datenbank
postgresaus. - Wählen Sie den Nutzer
postgresaus. - Geben Sie das Passwort ein, das Sie unter Cluster und primäre Instanz erstellen erstellt haben.
- Klicken Sie auf Authentifizieren. Im Bereich Explorer wird eine Liste der Objekte in der Datenbank
postgresangezeigt.
- Wählen Sie die Datenbank
Öffnen Sie einen neuen Tab, indem Sie auf + Neuer SQL-Editor-Tab oder + Neuer Tab klicken.
Erforderliche Erweiterungen installieren
Führen Sie die folgende Abfrage aus, um die Erweiterungen vector und alloydb_scann zu installieren:
  CREATE EXTENSION IF NOT EXISTS vector;
  CREATE EXTENSION IF NOT EXISTS alloydb_scann;
Produkt- und Produktinventardaten einfügen und eine einfache Vektorsuche durchführen
Führen Sie die folgende Anweisung aus, um eine
product-Tabelle zu erstellen, die Folgendes tut:- Speichert grundlegende Produktinformationen.
- Enthält eine
embedding-Vektorspalte, die einen Einbettungsvektor für eine Produktbeschreibung jedes Produkts berechnet und speichert.
  CREATE TABLE product (
    id INT PRIMARY KEY,
    name VARCHAR(255) NOT NULL,
    description TEXT,
    category VARCHAR(255),
    color VARCHAR(255),
    embedding vector(768) GENERATED ALWAYS AS (embedding('text-embedding-005', description)) STORED
  );
Bei Bedarf können Sie den Log-Explorer verwenden, um Logs aufzurufen und Fehler zu beheben.
Führen Sie die folgende Abfrage aus, um eine
product_inventory-Tabelle zu erstellen, in der Informationen zum verfügbaren Inventar und den entsprechenden Preisen gespeichert werden. Die Tabellenproduct_inventoryundproductwerden in diesem Tutorial verwendet, um komplexe Vektorsuchanfragen auszuführen.CREATE TABLE product_inventory ( id INT PRIMARY KEY, product_id INT REFERENCES product(id), inventory INT, price DECIMAL(10,2) );Führen Sie die folgende Abfrage aus, um Produktdaten in die Tabelle
producteinzufügen:INSERT INTO product (id, name, description,category, color) VALUES (1, 'Stuffed Elephant', 'Soft plush elephant with floppy ears.', 'Plush Toys', 'Gray'), (2, 'Remote Control Airplane', 'Easy-to-fly remote control airplane.', 'Vehicles', 'Red'), (3, 'Wooden Train Set', 'Classic wooden train set with tracks and trains.', 'Vehicles', 'Multicolor'), (4, 'Kids Tool Set', 'Toy tool set with realistic tools.', 'Pretend Play', 'Multicolor'), (5, 'Play Food Set', 'Set of realistic play food items.', 'Pretend Play', 'Multicolor'), (6, 'Magnetic Tiles', 'Set of colorful magnetic tiles for building.', 'Construction Toys', 'Multicolor'), (7, 'Kids Microscope', 'Microscope for kids with different magnification levels.', 'Educational Toys', 'White'), (8, 'Telescope for Kids', 'Telescope designed for kids to explore the night sky.', 'Educational Toys', 'Blue'), (9, 'Coding Robot', 'Robot that teaches kids basic coding concepts.', 'Educational Toys', 'White'), (10, 'Kids Camera', 'Durable camera for kids to take pictures and videos.', 'Electronics', 'Pink'), (11, 'Walkie Talkies', 'Set of walkie talkies for kids to communicate.', 'Electronics', 'Blue'), (12, 'Karaoke Machine', 'Karaoke machine with built-in microphone and speaker.', 'Electronics', 'Black'), (13, 'Kids Drum Set', 'Drum set designed for kids with adjustable height.', 'Musical Instruments', 'Blue'), (14, 'Kids Guitar', 'Acoustic guitar for kids with nylon strings.', 'Musical Instruments', 'Brown'), (15, 'Kids Keyboard', 'Electronic keyboard with different instrument sounds.', 'Musical Instruments', 'Black'), (16, 'Art Easel', 'Double-sided art easel with chalkboard and whiteboard.', 'Arts & Crafts', 'White'), (17, 'Finger Paints', 'Set of non-toxic finger paints for kids.', 'Arts & Crafts', 'Multicolor'), (18, 'Modeling Clay', 'Set of colorful modeling clay.', 'Arts & Crafts', 'Multicolor'), (19, 'Watercolor Paint Set', 'Watercolor paint set with brushes and palette.', 'Arts & Crafts', 'Multicolor'), (20, 'Beading Kit', 'Kit for making bracelets and necklaces with beads.', 'Arts & Crafts', 'Multicolor'), (21, '3D Puzzle', '3D puzzle of a famous landmark.', 'Puzzles', 'Multicolor'), (22, 'Race Car Track Set', 'Race car track set with cars and accessories.', 'Vehicles', 'Multicolor'), (23, 'RC Monster Truck', 'Remote control monster truck with oversized tires.', 'Vehicles', 'Green'), (24, 'Train Track Expansion Set', 'Expansion set for wooden train tracks.', 'Vehicles', 'Multicolor');Optional: Führen Sie die folgende Abfrage aus, um zu prüfen, ob die Daten in die Tabelle
producteingefügt wurden:SELECT * FROM product;Führen Sie die folgende Abfrage aus, um Inventardaten in die Tabelle
product_inventoryeinzufügen:INSERT INTO product_inventory (id, product_id, inventory, price) VALUES (1, 1, 9, 13.09), (2, 2, 40, 79.82), (3, 3, 34, 52.49), (4, 4, 9, 12.03), (5, 5, 36, 71.29), (6, 6, 10, 51.49), (7, 7, 7, 37.35), (8, 8, 6, 10.87), (9, 9, 7, 42.47), (10, 10, 3, 24.35), (11, 11, 4, 10.20), (12, 12, 47, 74.57), (13, 13, 5, 28.54), (14, 14, 11, 25.58), (15, 15, 21, 69.84), (16, 16, 6, 47.73), (17, 17, 26, 81.00), (18, 18, 11, 91.60), (19, 19, 8, 78.53), (20, 20, 43, 84.33), (21, 21, 46, 90.01), (22, 22, 6, 49.82), (23, 23, 37, 50.20), (24, 24, 27, 99.27);Führen Sie die folgende Vektorsuchanfrage aus, um Produkte zu finden, die dem Wort
musicähneln. Das bedeutet, dass das Ergebnis Produkte enthält, die für die Anfrage relevant sind, obwohl das Wortmusicnicht explizit in der Produktbeschreibung erwähnt wird:SELECT * FROM product ORDER BY embedding <=> embedding('text-embedding-005', 'music')::vector LIMIT 3;Das Ergebnis der Abfrage sieht so aus:
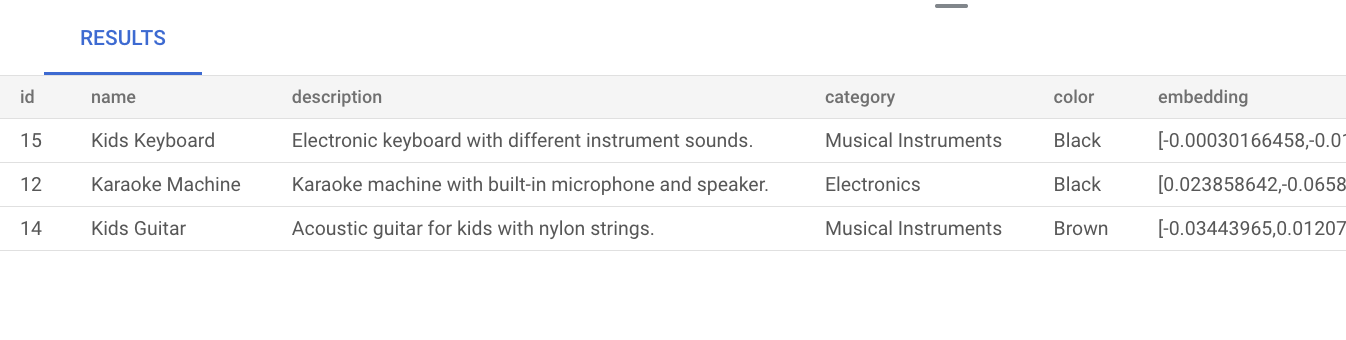
Bei einer einfachen Vektorsuche ohne Indexerstellung wird die exakte Suche nach dem nächsten Nachbarn (KNN) verwendet, die einen effizienten Recall bietet. Bei großen Datenmengen kann die Verwendung von KNN die Leistung beeinträchtigen. Für eine bessere Abfrageleistung empfehlen wir, den ScaNN-Index für die ANN-Suche (Approximate Nearest Neighbor) zu verwenden, die einen hohen Recall bei niedrigen Latenzen bietet.
Ohne Indexerstellung verwendet AlloyDB standardmäßig die exakte Suche nach dem nächsten Nachbarn (KNN).
Weitere Informationen zur Verwendung von ScaNN im großen Maßstab finden Sie unter Erste Schritte mit Vektoreinbettungen in AlloyDB AI.
Manuell abgestimmten ScaNN-Index für die Produkttabelle erstellen
Führen Sie die folgende Abfrage aus, um einen product_index-ScaNN-Index für die Tabelle product zu erstellen:
CREATE INDEX product_index ON product
USING scann (embedding cosine)
WITH (mode='MANUAL', num_leaves=4);
Weitere Informationen zum Erstellen eines ScaNN-Index finden Sie unter ScaNN-Index erstellen.
Vektorsuche ausführen
Führen Sie die folgende Vektorsuchanfrage aus, um Produkte zu finden, die der Anfrage in natürlicher Sprache music ähneln. Obwohl das Wort music nicht in der Produktbeschreibung enthalten ist, werden im Ergebnis Produkte angezeigt, die für die Abfrage relevant sind:
SET LOCAL scann.num_leaves_to_search = 2;
SELECT * FROM product
ORDER BY embedding <=> embedding('text-embedding-005', 'music')::vector
LIMIT 3;
Die Abfrageergebnisse sehen so aus:
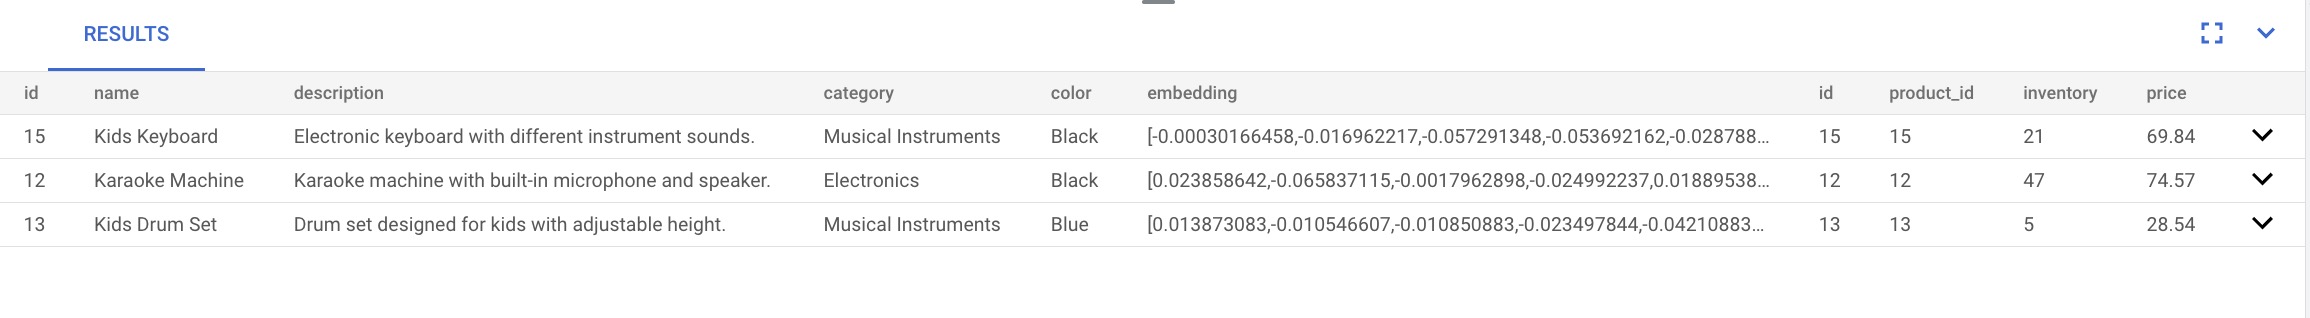
Der Suchparameter scann.num_leaves_to_search steuert die Anzahl der Blattknoten, die bei einer Ähnlichkeitssuche durchsucht werden. Die Parameterwerte num_leaves und scann.num_leaves_to_search tragen dazu bei, ein ausgewogenes Verhältnis zwischen Leistung und Recall zu erzielen.
Vektorsuche mit einem Filter und einem Join ausführen
Sie können gefilterte Vektorsuchabfragen auch dann effizient ausführen, wenn Sie den ScaNN-Index verwenden. Führen Sie die folgende komplexe Vektorsuchanfrage aus, die relevante Ergebnisse zurückgibt, die die Abfragebedingungen erfüllen, auch mit Filtern:
SET LOCAL scann.num_leaves_to_search = 2;

SELECT * FROM product p
JOIN product_inventory pi ON p.id = pi.product_id
WHERE pi.price < 80.00
ORDER BY embedding <=> embedding('text-embedding-005', 'music')::vector
LIMIT 3;
Gefilterte Vektorsuche beschleunigen
Sie können den Content Store der spaltenbasierten Engine verwenden, um die Leistung von Vektorähnlichkeitssuchen, insbesondere von KNN-Suchen (K-Nearest Neighbor), zu verbessern, wenn sie mit einer hochselektiven Prädikatfilterung kombiniert werden, z. B. mit LIKE in Datenbanken. In diesem Abschnitt verwenden Sie die Erweiterung vector und die AlloyDB-Erweiterung google_columnar_engine.
Weitere Informationen zur Funktionsweise der spaltenbasierten Engine finden Sie unter Spaltenbasierte Engine von AlloyDB.
Die Leistungsverbesserungen ergeben sich aus der integrierten Effizienz der spaltenbasierten Engine beim Scannen großer Datasets und beim Anwenden von Filtern, z. B. LIKE-Prädikaten, sowie aus der Fähigkeit, Zeilen mithilfe von Vektorunterstützung vorzufiltern. Diese Funktion reduziert die Anzahl der Datensubsets, die für nachfolgende KNN-Vektordistanzberechnungen erforderlich sind, und hilft, komplexe analytische Abfragen mit Standardfilterung und Vektorsuche zu optimieren.
Der Spaltenspeicher bietet zwei Optionen zum Verwalten seiner Inhalte:
- Spaltenspeicherinhalte automatisch verwalten: Neue AlloyDB-Instanzen verwenden standardmäßig die automatische Spaltenformatierung. Alternativ können Sie die Funktion zur automatischen Spaltenformatierung manuell ausführen.
- Spaltenspeicherinhalte manuell verwalten: Wenn Sie die Spalten im Spaltenspeicher für Ihre Arbeitslast manuell verwalten müssen, können Sie die automatische Spaltenformatierung deaktivieren.
So vergleichen Sie die Ausführungszeit einer KNN-Vektorsuche, die nach einem LIKE-Prädikat gefiltert wurde, vor und nach der Aktivierung der spaltenbasierten Engine:
Aktivieren Sie die Erweiterung
vector, um Vektordatentypen und -vorgänge zu unterstützen. Führen Sie die folgenden Anweisungen aus, um eine Beispieltabelle (items) mit einer ID, einer Textbeschreibung und einer Spalte für eine 512-dimensionale Vektoreinbettung zu erstellen.CREATE EXTENSION IF NOT EXISTS vector; CREATE TABLE items ( id SERIAL PRIMARY KEY, description TEXT, embedding VECTOR(512) );Führen Sie die folgenden Anweisungen aus, um 1 Million Zeilen in die Beispieltabelle
itemseinzufügen.-- Simplified example of inserting matching (~0.1%) and non-matching data INSERT INTO items (description, embedding) SELECT CASE WHEN g % 1000 = 0 THEN 'product_' || md5(random()::text) || '_common' -- ~0.1% match ELSE 'generic_item_' || g || '_' || md5(random()::text) -- ~99.9% don't match END, random_vector(512) -- Assumes random_vector function exists FROM generate_series(1, 999999) g;Messen Sie die Referenzleistung der Vektorähnlichkeitssuche ohne die spaltenbasierte Engine.
SELECT id, description, embedding <-> '[...]' AS distance
FROM items
WHERE description LIKE '%product_%_common%'
ORDER BY embedding <-> '[...]'
LIMIT 100;
Aktivieren Sie die spaltenbasierte Engine und die Vektorunterstützung, indem Sie den folgenden Befehl in der Google Cloud CLI ausführen. Wenn Sie die gcloud CLI verwenden möchten, können Sie die gcloud CLI installieren und initialisieren.
gcloud alloydb instances update INSTANCE_ID \
    --cluster=CLUSTER_ID \
    --region=REGION_ID \
    --project=PROJECT_ID \
    --database-flags=google_columnar_engine.enabled=on,google_columnar_engine.enable_vector_support=on
Ersetzen Sie Folgendes:
INSTANCE_ID: die ID der Instanz.CLUSTER_ID: die ID des Clusters.REGION_ID: die Region, in der sich der Cluster befindet.PROJECT_ID: die ID des Projekts, in dem sich der Cluster befindet.
Fügen Sie die Tabelle
itemszur spaltenbasierten Engine hinzu:SELECT google_columnar_engine_add('items');Leistung der Vektorähnlichkeitssuche mit der spaltenbasierten Engine messen Sie führen die Abfrage noch einmal aus, die Sie zuvor zur Messung der Baseline-Leistung ausgeführt haben.
SELECT id, description, embedding <-> '[...]' AS distance
FROM items
WHERE description LIKE '%product_%_common%'
ORDER BY embedding <-> '[...]'
LIMIT 100;
Führen Sie den folgenden Befehl aus, um zu prüfen, ob die Abfrage mit der spaltenorientierten Engine ausgeführt wurde:
explain (analyze) SELECT id, description, embedding <-> '[...]' AS distance
FROM items
WHERE description LIKE '%product_%_common%'
ORDER BY embedding <-> '[...]'
LIMIT 100;
Bereinigen
Rufen Sie in der Google Cloud Console die Seite Cluster auf.
Klicken Sie in der Spalte Ressourcenname auf den Namen Ihres Clusters,
my-cluster.Klicken Sie auf delete Cluster löschen.
Geben Sie unter Cluster „my-cluster“ löschen
my-clusterein, um zu bestätigen, dass Sie den Cluster löschen möchten.Klicken Sie auf Löschen.
Wenn Sie beim Erstellen eines Clusters eine private Verbindung erstellt haben, rufen Sie in der Google Cloud Console die Seite „Netzwerk“ auf und klicken Sie auf VPC-Netzwerk löschen.
Nächste Schritte
- Anwendungsfälle für die Vektorsuche in der Praxis
- Erste Schritte mit Vektoreinbettungen in AlloyDB AI
- Generative KI-Anwendungen mit AlloyDB AI erstellen
- ScaNN-Index erstellen
- ScaNN-Indexe optimieren
- Informationen zum Erstellen eines intelligenten Einkaufsassistenten mit AlloyDB, pgvector und Modellendpunktverwaltung
- Vektorsuche mit der spaltenbasierten Engine beschleunigen