


PostgreSQL용 AlloyDB의 최적화된 함수를 사용하면 더 작고 빠른 프록시 모델을 사용하여 AI 함수를 사용하는 대부분의 SQL 쿼리를 처리할 수 있으며, 필요한 경우에만 더 큰 대규모 언어 모델 (LLM)로 대체할 수 있습니다. 이 접근 방식은 행별 분류 또는 필터링 작업을 위한 원격 LLM 호출을 최소화하여 운영 비용을 줄이고 쿼리 응답성을 개선합니다.
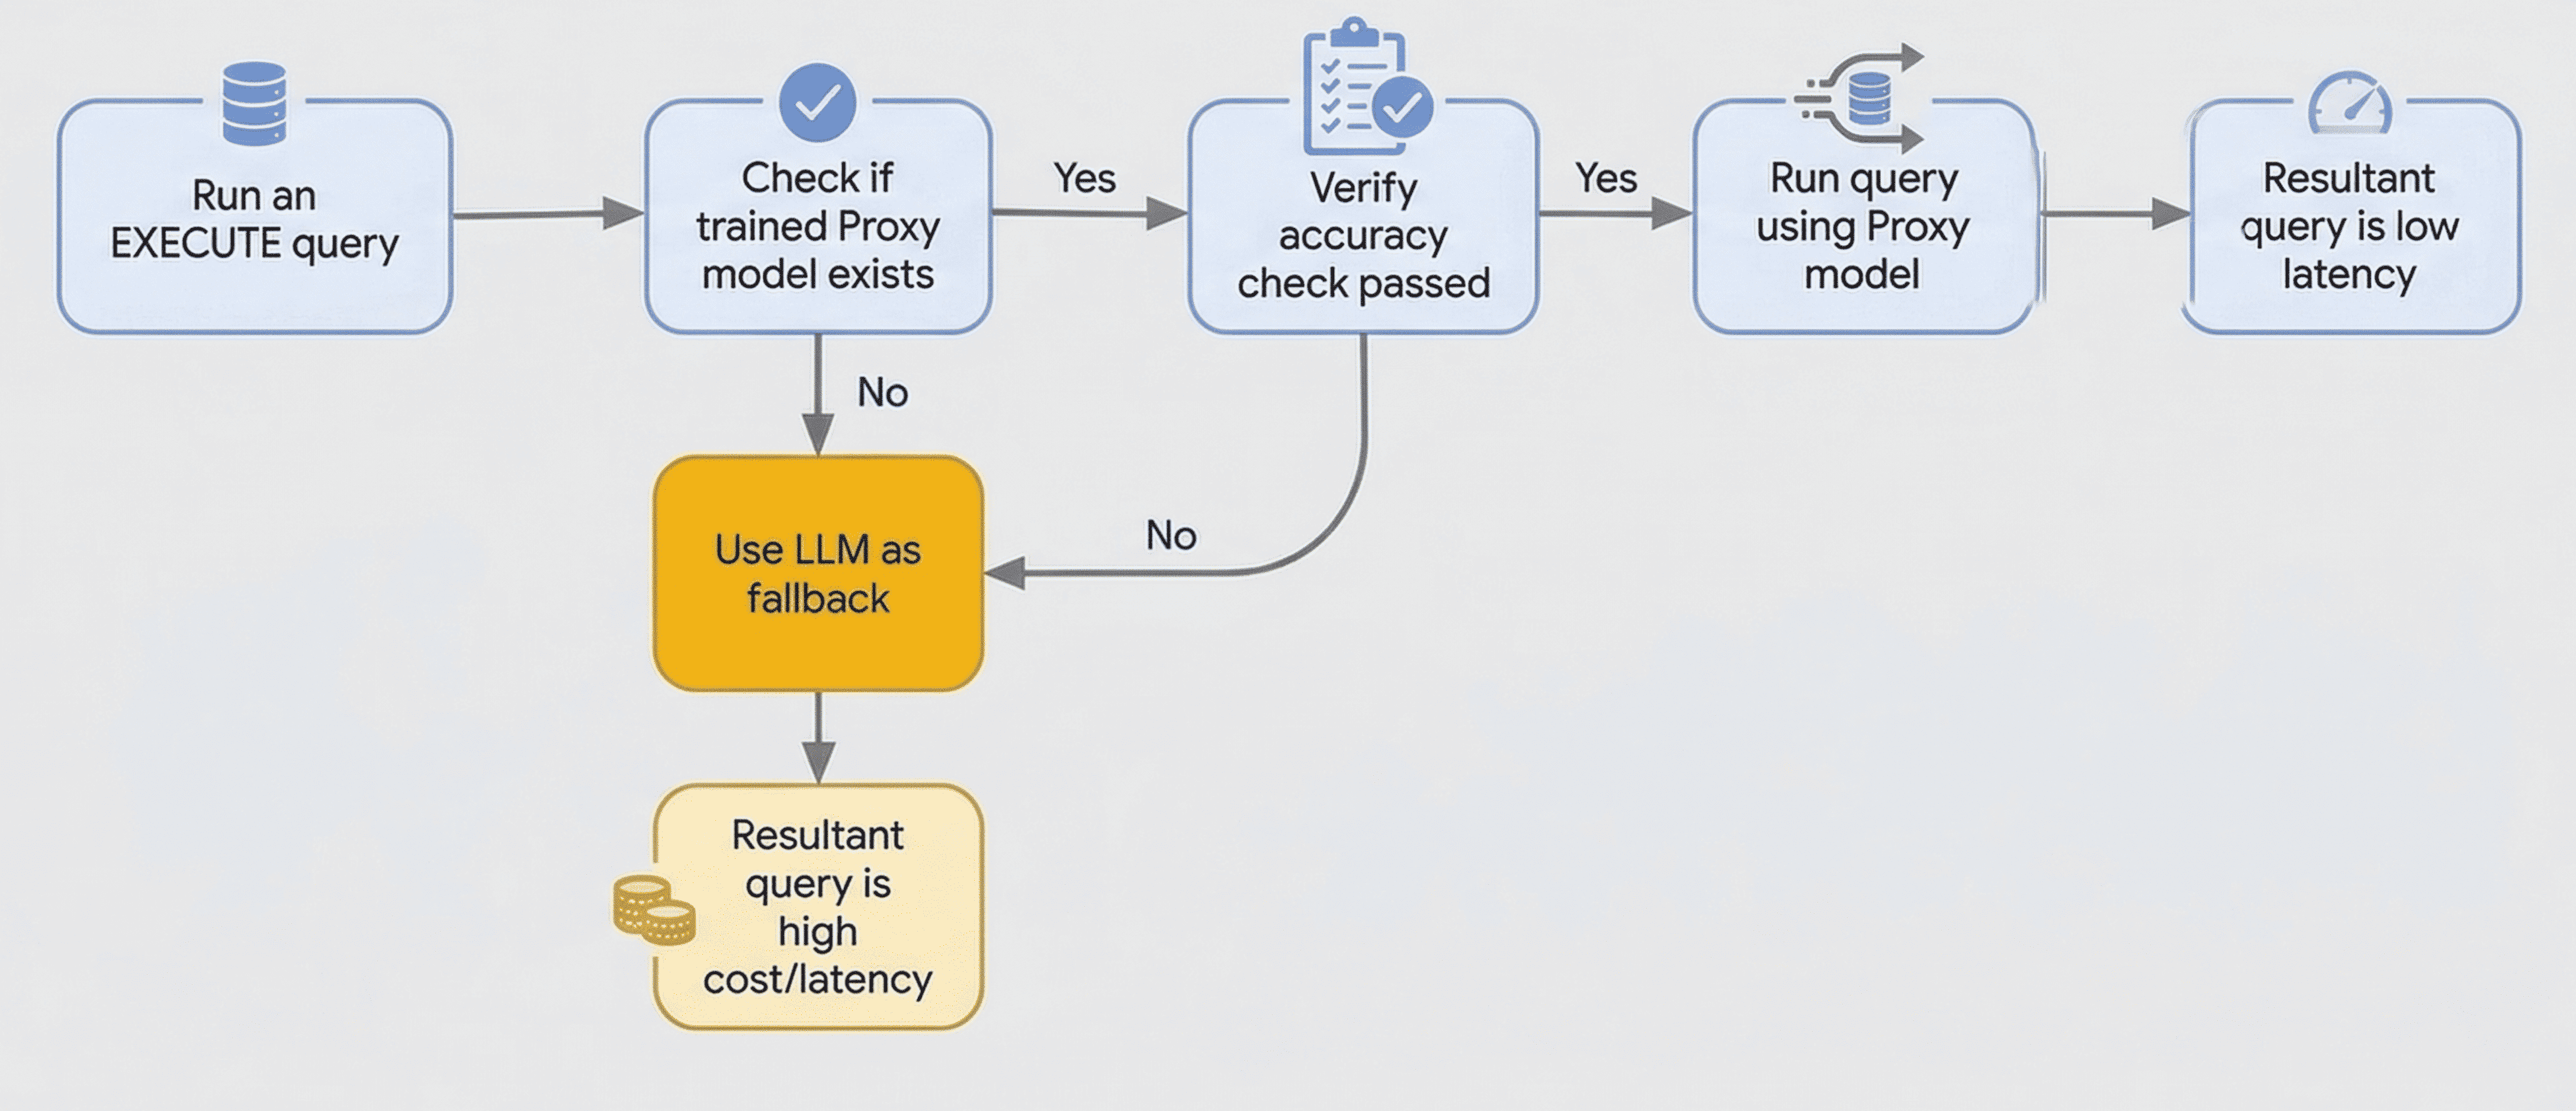
ai.if()와 같은 AlloyDB AI 함수는 대규모 언어 모델 (LLM)에 대한 원격 호출로 인해 지연 시간이 길어질 수 있습니다. 최적화된 함수는 로컬에서 학습된 더 작은 프록시 모델을 사용하여 쿼리를 처리함으로써 이 지연 시간 문제를 해결합니다. 이러한 모델은 LLM의 출력을 정보 소스로 사용하여 데이터 샘플을 학습합니다.
정확성 검사는 LLM을 사용하여 행 샘플에서 런타임에 수행됩니다. 이 검사를 수행하기 위해 AlloyDB는 LLM을 사용하여 샘플 행의 라벨을 생성하고 이를 프록시 모델의 예측과 비교하여 정확성을 확인합니다. 정확성 검사에 실패하면 쿼리는 LLM을 사용하도록 대체됩니다.
최적화된 함수를 사용하면 AlloyDB는 다음을 수행합니다.
- 프록시 모델 학습: AlloyDB는 데이터 샘플에서 경량 프록시 모델을 학습시킵니다. 이는
ai.if()함수와 함께PREPARE문을 사용하여 최적화된 쿼리에 대해 모델을 학습시킬 때 백그라운드에서 발생합니다. - 쿼리 실행:
EXECUTE문을 사용하면 AlloyDB는 학습된 프록시 모델을 사용하여 로컬에서 쿼리를 처리합니다. - LLM으로 대체: 모델의 정확성이 낮거나 AlloyDB에서 모델을 찾을 수 없는 경우 AlloyDB는 자동으로 LLM을 사용하도록 대체합니다.
시작하기 전에
최적화된 함수를 사용하기 전에 다음을 수행합니다.
postgres사용자 또는 데이터가 있는 테이블에 액세스할 수 있는 사용자로 psql을 사용하여 데이터베이스에 연결하거나 AlloyDB Studio에 연결합니다.google_ml_integration확장 프로그램이 설치되어 있고 버전 1.5.8 이상에서 사용할 수 있는지 확인합니다.SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration'; extversion ------------ 1.5.8 (1 row)Gemini Enterprise Agent Platform과 호환되도록 AlloyDB를 구성합니다. 자세한 내용은 데이터베이스를 Agent Platform과 통합을 참조하세요.
다음 데이터베이스 플래그가 사용 설정되어 있는지 확인합니다. 자세한 내용은 인스턴스의 데이터베이스 플래그 구성을 참조하세요.
google_ml_integration.enable_model_supportgoogle_ml_integration.enable_ai_query_enginegoogle_ml_integration.enable_cost_optimized_ai_functions
쿼리하려는 테이블의 임베딩을 생성합니다. 자세한 내용은 테이블의 자동 임베딩 생성 및 관리를 참조하세요.
다음 사항을 고려하세요.
- 소스 데이터 열은
TEXT또는VARCHAR유형이어야 합니다. - 최적화된 AI 함수에 입력을 제공하는 임베딩 열은
REAL[]또는VECTOR유형이어야 합니다. - 최적화된 함수는 Agent Platform 생성 모델을 사용할 수 있는 리전에서만 사용할 수 있습니다. 사용 가능한 리전 목록은 배포 및 엔드포인트를 참조하세요.
- 소스 데이터 열은
최적화된 함수 사용
최적화된 함수를 사용하려면 ai.if() 함수와 함께 PREPARE 및 EXECUTE 문을 사용합니다. 다음은 최적화된 함수를 사용하는 방법의 예시입니다.
restaurant_reviews테이블을 만듭니다. 소스 데이터를 보유하는review열은TEXT유형이고 쿼리에 사용되는review_embedding열은VECTOR(768)유형입니다.CREATE TABLE restaurant_reviews ( id SERIAL, name VARCHAR(64), city VARCHAR(64), review TEXT, review_embedding VECTOR(768) );ai.if()함수와 함께PREPARE문을 사용하여 쿼리가 최적화된 함수를 사용해야 함을 나타냅니다. 이 문은 백그라운드에서 모델의 비동기 학습을 트리거합니다.모델은 다음 조건에서만 학습됩니다.
- 쿼리에
ai.if()함수가 정확히 하나 있습니다. ai.if()이(가) 서브 쿼리 내에 있지 않습니다.
PREPARE positive_reviews_query AS SELECT r.name, r.city FROM restaurant_reviews r WHERE ai.if('Is the following a positive review? Review: ' || r.review, r.review_embedding) GROUP BY r.name, r.city HAVING COUNT(*) > 500;- 쿼리에
EXECUTE문을 사용하여 쿼리를 실행합니다.PREPARE문은 현재 세션에만 적용되므로 동일한 연결에서EXECUTE문을 실행해야 합니다.EXECUTE positive_reviews_query;conn2=> SELECT r.name, r.city FROM restaurant_reviews r WHERE ai.if('Is the following a positive review? Review: ' || r.review, r.review_embedding) GROUP BY r.name, r.city HAVING COUNT(*) > 500;다음 조건 중 하나라도 충족되면 학습된 프록시 모델이 사용되지 않습니다.
ai.if()에서 참조하는 콘텐츠 또는 임베딩 열이 변경됩니다. 두 열 모두 동일한 테이블에 속해야 합니다.- 콘텐츠 열에 제공된 프롬프트가 변경됩니다.
- 쿼리 구조가 변경되어
query_id가 달라집니다. - 쿼리가 시작될 때 정확성 검사 기준점을 충족하지 못합니다.
이러한 경우 쿼리는 LLM을 사용하도록 대체되고 AlloyDB는 경고를 반환합니다.
(선택사항) 모델 학습 중에도 정확도 검사가 수행되므로 전체 데이터베이스 환경에 대한 정확도 검증을 사용 중지하려면 다음 명령어를 실행합니다.
ALTER DATABASE DATABASE_NAME SET google_ml_integration.proxy_models_enable_accuracy_check = off;DATABASE_NAME을 데이터베이스 이름으로 바꿉니다.
프록시 모델 재학습
기본 테이블 데이터가 크게 변경되면 PREPARE 문을 다시 실행하여 프록시 모델을 다시 학습시킬 수 있습니다. 쿼리를 다시 준비하면 새 학습 요청을 시작하여 기존 프록시 모델을 대체합니다.
제한사항
소스 콘텐츠 열, 임베딩 열 또는 ai.if() 함수에 제공된 프롬프트를 변경하는 경우 새 PREPARE 문을 실행해야 합니다.
AlloyDB는 프롬프트와 입력 데이터의 고유한 조합의 동작을 근사화하도록 최적화된 함수를 학습시킵니다.