


Puedes reducir los costos operativos y mejorar la capacidad de respuesta de las consultas con funciones de IA optimizadas en AlloyDB para PostgreSQL. Las funciones IA optimizadas minimizan el uso de modelos de lenguaje grandes (LLM) para las tareas de clasificación o filtrado fila por fila, ya que procesan la mayoría de tus consultas con un modelo de proxy más pequeño y rápido, y recurren a un LLM más grande solo cuando es necesario.
Las funciones de AlloyDB AI, como ai.if(), pueden tener una latencia alta debido a las llamadas remotas a los LLM. Las funciones optimizadas abordan este problema de latencia con modelos de proxy más pequeños y entrenados de forma local (como los modelos de regresión logística) para procesar tus consultas. Estos modelos se entrenan con una muestra de tus datos y usan el resultado del LLM
como fuente de información.
Puedes configurar las verificaciones de exactitud para que se realicen en el entorno de ejecución con la marca
google_ml_integration.proxy_models_enable_accuracy_check,
que se establece en off de forma predeterminada. Las verificaciones de exactitud evalúan una muestra de
filas de la consulta con el LLM de referencia para garantizar que la exactitud cumpla con el
umbral definido por la
marca
google_ml_integration.proxy_models_f1_score_threshold. Si la verificación de exactitud falla, la consulta recurre al uso del LLM (o
arroja un error si el resguardo está inhabilitado).
Flujo de trabajo optimizado de las funciones de IA
Cuando usas una función IA optimizada y estableces la marca google_ml_integration.proxy_models_enable_accuracy_check
en true, AlloyDB hace lo siguiente.
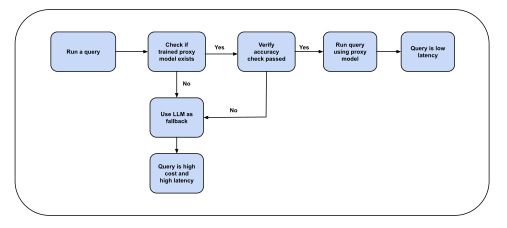
Programación del entrenamiento: Cuando ejecutas una consulta que contiene la función
ai.if()en una tabla, AlloyDB programa automáticamente el entrenamiento de un modelo de proxy ligero en segundo plano.Resguardo al LLM: Mientras se entrena el modelo de proxy o si no hay un modelo de proxy disponible, AlloyDB recurre al LLM remoto para evaluar la consulta (a menos que el resguardo esté inhabilitado).
Ejecuta consultas optimizadas: Después de entrenar el modelo, AlloyDB usa el modelo de proxy entrenado para procesar las consultas posteriores de forma local, lo que acelera el rendimiento.
En el siguiente diagrama, se muestra el flujo lógico para procesar consultas con funciones de IA optimizadas:
Antes de comenzar
Antes de usar las funciones de IA optimizadas, haz lo siguiente:
- Conéctate a tu base de datos con psql. También puedes
conectarte con AlloyDB Studio como el usuario
postgreso como un usuario que tenga acceso a la tabla en la que residen los datos. Verifica que esté instalada la versión 1.6.3 o posterior de la extensión
google_ml_integration.SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration';El resultado es similar a lo siguiente:
 extversion
------------
 1.6.3
(1 row)
Si la extensión no está instalada o es anterior a la versión 1.6.3, actualízala:
CREATE EXTENSION IF NOT EXISTS google_ml_integration;
ALTER EXTENSION google_ml_integration UPDATE;
Configurar AlloyDB para que funcione con Gemini Enterprise Agent Platform Para obtener más información, consulta Cómo realizar la integración en Agent Platform.
Verifica que las siguientes marcas de base de datos a nivel de instancia estén habilitadas. Para obtener más información, consulta Marcas de base de datos compatibles, Marcas de base de datos para funciones IA optimizadas y Configura las marcas de base de datos de una instancia.
Revisa las marcas de base de datos de validación de resguardo y exactitud, que puedes configurar a nivel de la sesión o de la base de datos con SQL (
SEToALTER DATABASE):google_ml_integration.proxy_models_enable_llm_fallback: Controla si una consulta recurre a un LLM remoto si un modelo de proxy no está disponible. Esta marca se establece enonde forma predeterminada. Cuando se establece enoff, la base de datos arroja un error en lugar de recurrir al LLM remoto.google_ml_integration.proxy_models_enable_accuracy_check: Habilita las verificaciones de exactitud del entorno de ejecución con respecto al LLM de referencia. Esta marca se establece enoffde forma predeterminada.
Revisa las marcas de base de datos de reentrenamiento periódico:
google_ml_integration.proxy_models_retraining_interval_minutes: Controla la frecuencia del trabajo de reentrenamiento en segundo plano en minutos. El valor predeterminado es1440(24 horas). Si lo configuras en0, se inhabilita el reentrenamiento periódico.google_ml_integration.proxy_models_retraining_batch_size: Controla la cantidad de modelos que se vuelven a entrenar en una sola iteración (el valor predeterminado es1).
Para AlloyDB Omni, verifica que las siguientes extensiones estén cargadas en
shared_preload_libraries:google_job_schedulergoogle_ml_integration
Genera incorporaciones para la tabla que deseas consultar. Para obtener más información, consulta Genera y administra embeddings de vectores automáticos para tablas grandes.
Ten en cuenta los siguientes requisitos:
- La columna de datos de origen debe ser del tipo
TEXToVARCHAR. - La columna de embedding que proporciona la entrada a la función IA optimizada debe ser del tipo
REAL[]oVECTOR. - Las funciones IA optimizadas solo están disponibles en las regiones en las que están disponibles los modelos generativos de Agent Platform. Para obtener una lista de las regiones disponibles, consulta Implementaciones y extremos.
- La columna de datos de origen debe ser del tipo
Ejecuta una consulta optimizada
Sigue este ejemplo para ejecutar una sentencia SELECT estándar con la función
ai.if():
Crea una tabla de
restaurant_reviews. La columnareviewque contiene los datos de origen es de tipoTEXT, y la columnareview_embeddingque se usa para las consultas es de tipoVECTOR(768).CREATE TABLE restaurant_reviews ( id SERIAL, name VARCHAR(64), city VARCHAR(64), review TEXT, review_embedding VECTOR(768) );Genera embeddings de vectores para los datos de origen con el procedimiento
ai.initialize_embeddings():CALL ai.initialize_embeddings( model_id => 'text-embedding-005', table_name => 'restaurant_reviews', content_column => 'review', embedding_column => 'review_embedding' );La generación de embeddings es necesaria porque las funciones IA optimizadas dependen de los embeddings de vectores como entradas de atributos para entrenar y evaluar el modelo de proxy ligero. En lugar de enviar texto sin procesar a un LLM remoto para cada fila, el modelo de proxy realiza una inferencia local rápida directamente en las representaciones vectoriales. Si no se generan embeddings, AlloyDB no puede entrenar el modelo de proxy y recurre a evaluar todas las filas con el LLM remoto.
Ten en cuenta los siguientes requisitos de incorporación:
- El resultado
ai.if()se evalúa comoNULLsi la columna de incorporación contiene valoresNULL. Tanto el entrenamiento como la inferencia del modelo requieren embeddings válidos. - La función
ai.if()arroja un error si las dimensiones de incorporación de la consulta no coinciden con las dimensiones almacenadas en el modelo de proxy entrenado.
Para obtener más información sobre las opciones de embedding y las actualizaciones incrementales, consulta Genera y administra embeddings de vectores automáticos para tablas grandes.
- El resultado
Ejecuta una sentencia
SELECTcon la funciónai.if(). Esta consulta programa automáticamente el entrenamiento de un modelo proxy para funciones IA optimizadas en segundo plano:SELECT r.name, r.city FROM restaurant_reviews r WHERE ai.if('Is the following a positive review? Review: ' || r.review, r.review_embedding, 'gemini-3.5-flash-lite') GROUP BY r.name, r.city HAVING COUNT(*) > 500;La primera ejecución de la consulta activa el entrenamiento de forma asíncrona. Mientras se entrena el modelo de proxy, si la marca
google_ml_integration.proxy_models_enable_llm_fallbackse establece enon(el valor predeterminado), AlloyDB vuelve a evaluar la consulta con el LLM remoto y devuelve una advertencia de que la función de IA optimizada aún no está disponible. Sigoogle_ml_integration.proxy_models_enable_llm_fallbackse establece enoff, la consulta devuelve un error en lugar de recurrir a la alternativa.Las consultas posteriores que coinciden con la misma expresión de contenido (
content_expr), la columna de incorporación y la tabla usan el modelo de proxy entrenado para la aceleración. Actualizar los valores de las filas, borrar filas o agregar datos a la tabla no hace que AlloyDB recurra al LLM. El modelo de proxy sigue procesando los datos de forma local, y la desviación de datos se aborda con un reentrenamiento periódico en segundo plano.Los modelos de proxy se identifican de forma única por el tipo de función, el OID de la tabla, la expresión de contenido y la columna de incorporación (
func_type,table_oid,content_expr,embedding_column). Con esta arquitectura, puedes compartir modelos en diferentes consultas en SQL, siempre y cuando las entradas aai.if()permanezcan sin cambios.AlloyDB no usa el modelo de proxy existente y, en su lugar, inicia el entrenamiento en segundo plano para un nuevo modelo de proxy y recurre al LLM remoto (sujeto a la marca
google_ml_integration.proxy_models_enable_llm_fallback), en las siguientes situaciones:- La expresión
CONTENTdentro deai.if()cambia (por ejemplo, se modifica la cadena de instrucción o la expresión de columna concatenada). - El nombre de
EMBEDDING_COLUMNdentro deai.if()cambia. - Cambia el parámetro
llm_model_id. - Si las verificaciones de exactitud del entorno de ejecución están habilitadas y el modelo de proxy falla la verificación de exactitud al comienzo de la consulta.
- La expresión
Entrenamiento en línea y bloqueo de la ejecución
AlloyDB admite un flujo de trabajo de entrenamiento en línea para funciones
optimizadas, controlado por la
marca de base de datos google_ml_integration.proxy_models_enable_online_training. De forma predeterminada, esta
marca se establece en off.
Cuando se habilita esta marca y se ejecuta una función ai.if() sin entrenamiento, la
consulta activa el proceso de entrenamiento y usa la ejecución de bloqueo. La
consulta inicial bloquea de forma activa y espera a que finalice el entrenamiento de modelos de proxy en segundo plano
antes de continuar. Esto garantiza que la consulta use el modelo de proxy optimizado
de inmediato, lo que evita los costos de inferencia de LLM remotos en la ejecución inicial.
La duración máxima que la consulta bloquea y espera a que se complete el entrenamiento en línea
se controla con la
marca google_ml_integration.proxy_models_training_wait_timeout (en segundos,
el valor predeterminado es 60). Si el entrenamiento no se completa dentro de este intervalo, la consulta
se agota o recurre a un resguardo según la configuración de resguardo.
Para habilitar el entrenamiento en línea, sigue estos pasos:
-- Enable online training (blocking execution)
SET google_ml_integration.proxy_models_enable_online_training = on;

-- Set the maximum wait timeout in seconds (default is 60)
SET google_ml_integration.proxy_models_training_wait_timeout = 30;
Configura el resguardo de LLM remoto
De forma predeterminada, se habilita el resguardo al LLM remoto. Si un modelo de proxy no está entrenado, se está entrenando o falla en las verificaciones de exactitud, la consulta recurre al LLM remoto y genera costos estándar de la API de Agent Platform.
Puedes configurar el comportamiento de resguardo con la
marca de base de datos google_ml_integration.proxy_models_enable_llm_fallback:
Cuando el resguardo está habilitado (
on, predeterminado): Si el modelo proxy no está disponible, AlloyDB evalúa la consulta con el LLM remoto y devuelve una advertencia:WARNING: Optimized AI Function is unavailable. Expect reduced performance.Cuando el resguardo está inhabilitado (
off): Si el modelo de proxy no está disponible o falla la validación de exactitud, la consulta genera un error de inmediato en lugar de llamar al LLM remoto:ERROR: Optimized AI Function: Optimized model fallback to LLM prevented by GUC google_ml_integration.proxy_models_enable_llm_fallback
Para inhabilitar el resguardo de LLM en la sesión actual, haz lo siguiente:
SET google_ml_integration.proxy_models_enable_llm_fallback = off;
Para inhabilitar el resguardo de LLM en toda la base de datos, haz lo siguiente:
ALTER DATABASE DATABASE_NAME SET google_ml_integration.proxy_models_enable_llm_fallback = off;
Reemplaza DATABASE_NAME por el nombre de tu base de datos.
Configura las verificaciones de exactitud del entorno de ejecución
Las verificaciones de exactitud del entorno de ejecución evalúan una muestra de filas de la consulta con el LLM remoto para garantizar que el modelo de proxy cumpla con los requisitos de exactitud de referencia antes de la ejecución.
Las verificaciones de exactitud se controlan con la
marca de base de datos google_ml_integration.proxy_models_enable_accuracy_check
(inhabilitada de forma predeterminada).
Para habilitar las verificaciones de precisión en la sesión actual, sigue estos pasos:
SET google_ml_integration.proxy_models_enable_accuracy_check = on;
Para inhabilitar las verificaciones de precisión de la sesión actual, sigue estos pasos:
SET google_ml_integration.proxy_models_enable_accuracy_check = off;
Para habilitar las verificaciones de precisión en toda la base de datos, sigue estos pasos:
ALTER DATABASE DATABASE_NAME SET google_ml_integration.proxy_models_enable_accuracy_check = on;
Visualiza los modelos de proxy existentes
Para inspeccionar los modelos de proxy existentes, verificar su estado de entrenamiento y revisar sus
metadatos, consulta la vista google_ml.optimized_functions_view (o su
alias en el esquema ai, ai.optimized_functions_view):
sql
SELECT * FROM ai.optimized_functions_view;
Para obtener descripciones de las columnas de esta vista, consulta Vista ai.optimized_functions_view.
Puedes filtrar esta vista por table_name o status para verificar si un modelo completó
el entrenamiento (READY) o para identificar los valores exactos de content_expr y
embedding_column necesarios para el reentrenamiento manual.
Vuelve a entrenar y administra modelos de proxy
Los modelos de proxy se entrenan con los datos presentes en tu tabla en el momento del entrenamiento inicial. Si se agregan datos más recientes a la tabla, o si se modifican o borran filas, el modelo de proxy puede quedar obsoleto con el tiempo. Para mantener la exactitud a medida que cambian los datos, los modelos de proxy se pueden volver a entrenar automáticamente de forma periódica en segundo plano o de forma manual a pedido.
Reentrenamiento periódico en segundo plano
En las instancias con 32 o más CPUs virtuales con parámetros de configuración predeterminados, AlloyDB puede volver a entrenar los modelos de proxy de forma periódica en segundo plano.
El reentrenamiento periódico se controla con las siguientes marcas de base de datos:
google_ml_integration.proxy_models_retraining_interval_minutes: Controla la frecuencia del trabajo de reentrenamiento en segundo plano en minutos. El valor predeterminado es1440(24 horas). Si se establece en0, se inhabilita el reentrenamiento periódico.google_ml_integration.proxy_models_retraining_batch_size: Controla la cantidad de modelos que se vuelven a entrenar en una sola iteración (el valor predeterminado es1).
Reentrenamiento manual
Puedes volver a entrenar de forma manual los modelos de proxy con las funciones del esquema ai (o
sus equivalentes en el esquema google_ml).
Vuelve a entrenar todos los modelos de una tabla
Para volver a entrenar todos los modelos de proxy asociados con una tabla específica o un subconjunto filtrado de modelos para una tabla, llama a ai.retrain_optimized_models():
SELECT ai.retrain_optimized_models(
  table_name => 'restaurant_reviews',
  embedding_column => 'review_embedding', -- Optional
  content_expr => '(''Is the following a positive review? Review: ''::text || review)', -- Optional
  llm_model_id => 'LLM_MODEL_ID' -- Optional
);
Para obtener descripciones de los parámetros, consulta la función ai.retrain_optimized_models().
Vuelve a entrenar un modelo específico por ID de modelo
Para volver a entrenar un modelo de proxy específico con su identificador de modelo único, llama a
ai.retrain_optimized_model() con el parámetro model_id:
SELECT ai.retrain_optimized_model(model_id => 'MODEL_ID');
Para obtener descripciones de los parámetros, consulta la función ai.retrain_optimized_model().
Vuelve a entrenar un modelo específico según los parámetros de entrenamiento de modelos
Para volver a entrenar un modelo de proxy específico con su nombre de tabla, expresión de contenido y
columna de incorporación, llama a ai.retrain_optimized_model():
SELECT ai.retrain_optimized_model(
  table_name => 'restaurant_reviews',
  embedding_column => 'review_embedding',
  content_expr => '(''Is the following a positive review? Review: ''::text || review)',
  llm_model_id => 'LLM_MODEL_ID' -- Optional
);
Para obtener descripciones de los parámetros, consulta la función ai.retrain_optimized_model().
Borra modelos de proxy
Puedes borrar modelos de proxy individuales o todos los modelos con las siguientes
funciones. Estas operaciones las debe realizar un usuario con privilegios
alloydbsuperuser
o con permisos otorgados por un administrador.
Para encontrar el model_id interno necesario para borrar un modelo de proxy específico, consulta
la tabla google_ml.proxy_models_expr_mapping:
SELECT model_id, table_oid::regclass, content_expr
FROM google_ml.proxy_models_expr_mapping;
-- Delete a specific proxy model
SELECT ai.delete_optimized_model('com_if_12345_67890');

-- Delete all proxy models and stop the background automated retraining job
CALL ai.delete_all_optimized_models();
Supervisar
Puedes supervisar los trabajos de entrenamiento de los trabajadores en segundo plano y verificar el estado operativo del modelo.
Verifica el estado y el historial del entrenamiento de modelos
Para verificar si un modelo de proxy completó el entrenamiento, falló o está en proceso de
volver a entrenarse, consulta ai.optimized_functions_view:
SELECT table_name, content_expr, status, last_trained_at, training_duration
FROM ai.optimized_functions_view;
La columna status indica el estado operativo actual del modelo y
proporciona los siguientes valores:
READY: El modelo de proxy completó el entrenamiento correctamente y está listo para acelerar las consultas entrantes.UNTRAINED: El modelo se registró o programó, pero el entrenamiento en segundo plano aún no finalizó. Si el entrenamiento inicial en segundo plano falla, el modelo permanece en el estadoUNTRAINEDy las consultas recurren al LLM remoto (o se produce un error si la recurrencia está inhabilitada).RETRAINING_IN_PROGRESS: El reentrenamiento en segundo plano está en curso.RETRAINING_FAILED: Falló la ejecución de reentrenamiento manual o en segundo plano más reciente. En la mayoría de las situaciones, si existen pesos de modelo previos al reentrenamiento, AlloyDB sigue usando esos pesos de modelo existentes para la inferencia. Si los pesos del modelo existentes no están disponibles (o si fallan las verificaciones de exactitud del entorno de ejecución), AlloyDB recurre a la evaluación de consultas con el LLM remoto (sujeto agoogle_ml_integration.proxy_models_enable_llm_fallback) hasta que el modelo se vuelva a entrenar correctamente.
Para obtener más información sobre todas las columnas disponibles en esta vista, consulta Visualiza los modelos de proxy existentes.
Limitaciones
- Las funciones IA optimizadas solo admiten la función
ai.if(). - No se admite el reentrenamiento automático periódico en segundo plano de los modelos de proxy en instancias de base de datos con menos de 32 CPUs virtuales.
- Seguridad a nivel de fila (RLS): Los modelos entrenados en tablas con políticas de seguridad a nivel de fila (RLS) pueden filtrar información de seguridad si se entrenan con los permisos de un usuario iniciador específico. El entrenamiento de modelos de proxy en tablas con políticas de RLS está inhabilitado.
- Modificaciones de entrada: Si modificas la columna de contenido de origen, la
columna de incorporación, la cadena de instrucción o el ID del modelo de LLM base proporcionado a
ai.if(), se omite el modelo de proxy existente y se inicia una nueva solicitud de entrenamiento en segundo plano para esa combinación. - Restricciones de SQL:
- La consulta debe contener una cláusula
FROMválida. - Todos los argumentos de la función IA deben originarse en el mismo alias de tabla.
- Incluye columnas en la expresión
ai.if()como columnas de origen para la incorporación. - No coloques la función
ai.if()dentro de una subconsulta ni de una expresión de tabla común (CTE).
- La consulta debe contener una cláusula