


Para executar consultas em tempo real de dados analíticos com seus dados operacionais
sem criar pipelines complexos, use a federação de lakehouse no
AlloyDB para PostgreSQL. Com a extensão bigquery_fdw, o AlloyDB
encaminha suas consultas para o BigQuery para acessar dados em tempo real e formatos abertos,
como o Apache Iceberg, por meio de tabelas externas do BigLake, eliminando a necessidade de
migrações complexas de ETL (extração, transformação e carregamento).
Benefícios da federação de lakehouse
A abordagem de federação de lakehouse oferece os seguintes benefícios:
- Zero ETL: consulte dados analíticos diretamente sem criar ou manter pipelines complexos.
- Sintaxe familiar: use a sintaxe padrão do PostgreSQL para consultar dados do BigQuery.
- Insights em tempo real: acesse dados atualizados junto com suas tabelas operacionais.
- Transferência de computação: use o mecanismo distribuído do BigQuery para tarefas pesadas com a otimização de pushdown.
- Acesso autorizado: para garantir que apenas contas de serviço autorizadas possam consultar dados externos, use o Identity and Access Management (IAM) para controle de acesso centralizado.
Casos de uso
A federação de lakehouse é compatível com os seguintes casos de uso comerciais e técnicos:
- Cargas de trabalho de processamento transacional e analítico híbrido (HTAP, na sigla em inglês): é possível consultar dados operacionais em tempo real no AlloyDB e dados históricos ou analíticos no BigQuery ou no Cloud Storage simultaneamente, sem afetar o desempenho transacional.
- Insights em tempo real sem pipelines frágeis: é possível evitar a latência e os modos de falha dos processos de ETL tradicionais. Acesse dados analíticos atualizados instantaneamente para tomar decisões de negócios com base nas informações mais recentes.
- Materialização de dados para Agentic Workflows: é possível materializar dados analíticos externos no AlloyDB para usar o mecanismo colunar e os recursos de IA do AlloyDB. Isso permite pesquisas vetoriais de alto desempenho, embeddings de machine learning e Agentic Workflows avançados com IA nos seus dados federados.
Arquitetura e fluxo de dados
O diagrama a seguir mostra o fluxo de dados e as interações de componentes quando você usa a federação do lakehouse:
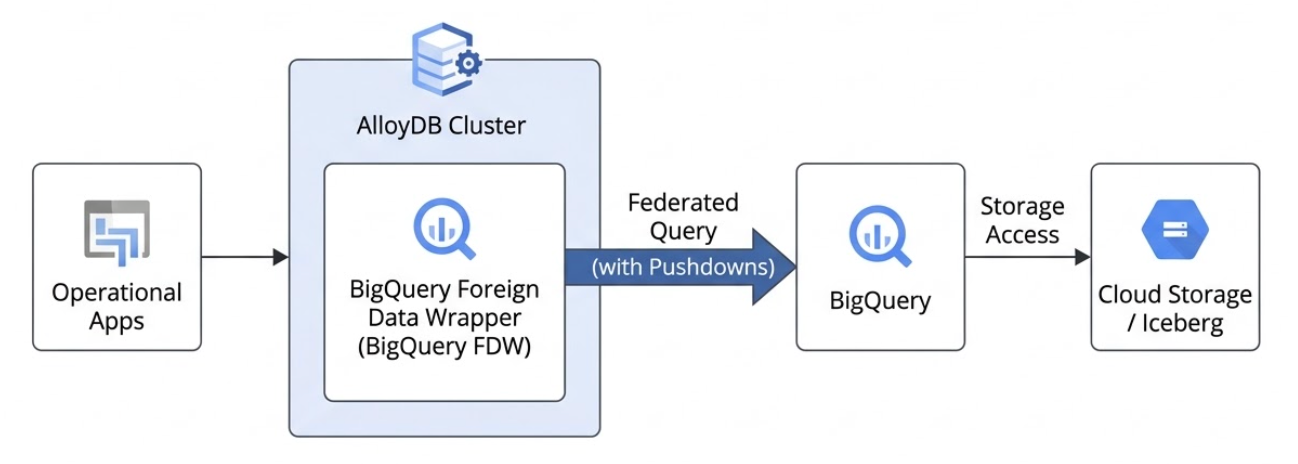
Veja a seguir o processo de fluxo de dados para a federação de lakehouse no AlloyDB:
- Envio de consulta: você envia uma consulta padrão do PostgreSQL para sua instância do AlloyDB.
- Planejamento e otimização de consultas: o planejador de consultas do AlloyDB identifica tabelas mapeadas para conjuntos de dados externos do BigQuery usando o wrapper de dados externos (FDW, na sigla em inglês) do BigQuery.
- Otimização de pushdown: o AlloyDB otimiza a consulta enviando filtros e agregações específicos diretamente para o BigQuery. Isso garante que a rede transfira apenas as linhas filtradas relevantes ou os resumos pré-agregados.
- Execução e recuperação: o BigQuery executa a parte dele da consulta, verificando diretamente o armazenamento integrado do BigQuery ou lendo as tabelas do Apache Iceberg armazenadas no Cloud Storage, e transmite o conjunto de dados resultante de volta para o AlloyDB.
- Processamento e resposta finais: o AlloyDB combina os dados externos com as tabelas operacionais locais, conclui o processamento de consultas restante e retorna o resultado final para o aplicativo.
Considerações sobre tipos de dados para consultas federadas
Quando você consulta uma tabela externa do BigQuery no
AlloyDB usando a federação do Lakehouse, o planejador de consultas do AlloyDB
interpreta os tipos de dados do BigQuery como tipos de dados correspondentes
do PostgreSQL. Entender esses mapeamentos é crucial para escrever
consultas corretas e para as definições de tabela externa usadas pela extensão
bigquery_fdw.
Se um tipo de dados do BigQuery não tiver um mapeamento direto ou exigir
processamento especial, talvez seja necessário usar funções CAST explícitas nas
consultas ou criar uma visualização no BigQuery que apresente os dados com
tipos compatíveis.
Para uma lista de tipos de dados compatíveis e os tipos correspondentes do PostgreSQL, consulte Mapeamentos de tipos de dados.
Segurança e controle de acesso
O acesso aos dados do BigQuery pelo AlloyDB é gerenciado pelo IAM. É necessário conceder papéis específicos do IAM à conta de serviço do cluster do AlloyDB para definir quais conjuntos de dados e tabelas podem ser consultados. Isso ajuda a garantir que as consultas federadas sigam as políticas de governança de dados centralizadas da sua organização sem comprometer a segurança. Para mais informações, consulte Papéis necessários.
Pushdown
É possível usar técnicas de pushdown de filtro e agregação, que aceleram as consultas e reduzem os custos ao filtrar ou resumir dados no BigQuery antes que eles sejam movidos ou processados pelo AlloyDB. Essa abordagem minimiza o tráfego de rede e o uso da memória, permitindo que você analise conjuntos de dados enormes de forma rápida e eficiente sem exceder os limites de recursos.
Pushdown de filtro
A filtragem de pushdown, também conhecida como pushdown de predicado, é uma técnica de otimização
que move a filtragem de dados o mais próximo possível da camada de armazenamento,
movendo os filtros de consulta (usando a cláusula WHERE) do
AlloyDB para o BigQuery.
Com o pushdown de filtro, é possível usar consultas SQL com uma cláusula WHERE para acessar um subconjunto
de dados da tabela remota. Esses dados também podem ser materializados em uma tabela local
ou anexados como uma partição local a uma tabela do PostgreSQL.
As operações compatíveis com o pushdown de filtro incluem:
- Operadores de comparação padrão:
=,<,>,<=,>=,<> - Operadores lógicos:
AND,OReNOT - Correspondência de padrões:
LIKEeNOT LIKE - Verificações de nulos:
IS NULLeIS NOT NULL
Pushdown de agregação
O pushdown de agregação é uma otimização avançada de banco de dados que realiza
cálculos, como SUM, COUNT, AVG ou GROUP BY, o mais
próximo possível da camada de armazenamento. Esse pushdown avalia as funções de resumo
diretamente no BigQuery, o que pode reduzir significativamente o número
de linhas retornadas ao AlloyDB.
As operações compatíveis com o pushdown de agregação incluem:
SUMCOUNTAVGMINMAX
Pushdown de limite
O pushdown de limite (que inclui o pushdown de OFFSET) é uma técnica de otimização que move as cláusulas LIMIT e OFFSET da consulta do AlloyDB para o BigQuery.
Isso permite que o BigQuery retorne apenas o subconjunto específico de linhas solicitado, o que reduz significativamente o tráfego de rede e a latência da consulta.
O pushdown de limite é aplicado automaticamente sempre que possível. Verifique se as seguintes condições são atendidas:
- A consulta não usa a opção
WITH TIESna cláusulaFETCH FIRST. - As expressões
LIMITeOFFSETsão constantes ou expressões básicas que podem ser avaliadas remotamente.
Custo e faturamento do BigQuery
O wrapper de dados externos do BigQuery depende do seguinte:
- Preços de computação do BigQuery
- Preços da API BigQuery Storage
Para mais informações, consulte Preços do BigQuery.
Projetos de ambiente de execução
No BigQuery, é possível armazenar seus dados em um projeto e executar as consultas em outro. O projeto que executa as consultas e acumula os custos de computação é conhecido como projeto de ambiente de execução (ou projeto de faturamento).
Separar o projeto de ambiente de execução do projeto de repositório de dados permite isolar os custos de computação em centros de custo específicos, gerenciar cotas de forma independente e controlar os gastos em diferentes cargas de trabalho sem mover os dados subjacentes.
Ao configurar o AlloyDB para acessar dados do BigQuery, é possível especificar um projeto de ambiente de execução no nível do servidor (aplicável a todas as tabelas externas associadas) ou no nível da tabela individual. Se você não especificar um projeto de ambiente de execução, o AlloyDB vai usar o projeto que possui os dados por padrão.
Limitações
O AlloyDB e o BigQuery podem usar agrupamentos padrão diferentes, o que pode resultar em resultados de ordenação de dados ou comparação de strings diferentes entre os dois sistemas. Por exemplo, a ordenação padrão do PostgreSQL nas versões 15, 16 e 17 pode lidar com a diferenciação de maiúsculas e minúsculas de maneira diferente durante a classificação em comparação com a ordenação padrão do BigQuery, que avalia estritamente as strings com base nos pontos de código Unicode.
Para qualquer parte de uma consulta executada remotamente no BigQuery, a reordenação segue as configurações do BigQuery. Para reduzir conflitos de ordenação, use a ordenação
C.UTF-8sem ICU no AlloyDB e a ordenação padrão (vazia) no BigQuery.As consultas que retornam uma grande quantidade de dados do BigQuery, após o pushdown, não são otimizadas.
Quando você cria uma tabela externa, o AlloyDB não valida ativamente a existência ou o esquema da tabela remota do BigQuery.
Se uma consulta federada exigir a leitura de uma grande quantidade de dados, por exemplo, se as reduções de filtro não puderem ser aplicadas, a consulta poderá falhar devido aos limites de tamanho de resposta da API BigQuery. Os limites máximos de tamanho de resposta do BigQuery ainda se aplicam. Para mais informações sobre esses limites, consulte Cotas e limites.
O PostgreSQL e o BigQuery lidam com precisão decimal, divisão e cálculos intermediários de maneira diferente. Essas diferenças podem resultar em variações de arredondamento, perda de precisão ou erros de estouro durante cálculos complexos. Para mais informações, consulte Tipos decimais e Operadores aritméticos.
O Database Migration Service não é compatível com a migração de tabelas externas criadas com a extensão
bigquery_fdw. Como solução alternativa, é possível excluir as tabelas externas do job de migração ou removê-las antes de iniciar a migração e, em seguida, recriá-las no cluster de destino do AlloyDB após a conclusão da migração.Ao consultar tabelas externas usando a extensão
bigquery_fdw, o BigQuery avalia as permissões de acesso a dados com base na conta de serviço do cluster do AlloyDB. Mesmo que os usuários do banco de dados façam login usando a autenticação do banco de dados do IAM, as permissões individuais de usuário do IAM não são verificadas nas tabelas remotas do BigQuery. Para mais informações, consulte Conceder ao AlloyDB acesso ao conjunto de dados do BigQuery.