


Pour exécuter efficacement des charges de travail d'intelligence artificielle (IA) ou de machine learning (ML), vous devez sélectionner à la fois un orchestrateur de charge de travail et une plate-forme de déploiement. Ces composants fonctionnent comme suit :
Un orchestrateur planifie et exécute vos jobs.
Une option de déploiement gère un orchestrateur.
Une fois que vous avez identifié l'infrastructure GPU (GPU en cluster ou GPU généraux) à utiliser pour exécuter vos charges de travail, suivez les conseils de ce document pour identifier l'orchestrateur et le déploiement qui conviennent le mieux à votre charge de travail et à votre niveau de gestion.
Pour consulter les types de machines GPU que vous pouvez utiliser pour exécuter vos charges de travail, consultez Machines GPU.
Comparer les orchestrateurs et les options de déploiement
AI Hypercomputer propose plusieurs orchestrateurs et options de déploiement pour vos instances de calcul. Ces options vont des clusters entièrement gérés qui vous permettent de vous concentrer sur vos charges de travail aux environnements autogérés qui offrent un contrôle précis sur la façon dont vous gérez et mettez à jour vos instances de calcul.
Le tableau suivant compare les orchestrateurs et les options de déploiement que vous pouvez utiliser lorsque vous exécutez des charges de travail d'IA :
| Produit | Outil d'orchestration | Complexité technique | Recommandations | Principal avantage |
|---|---|---|---|---|
| Cluster Director | Slurm | Faible | Chercheurs en IA, data scientists | Cycle de vie géré pour les clusters Slurm |
| Google Kubernetes Engine (GKE) | Kubernetes | Moyenne à élevée | Ingénieurs en ML, ingénieurs de plate-forme | Orchestration et scaling des conteneurs |
| Cluster Toolkit | Slurm, Kubernetes | Moyenne | Ingénieurs ML DevOps et de plate-forme | Plans d'infrastructure en tant que code validés |
| Compute Engine | Personnalisée / Aucune | Élevée | Architectes d'infrastructure | Contrôle précis de l'OS et du réseau |
Choisir un outil d'orchestration et une option de déploiement
Pour choisir un orchestrateur et une option de déploiement, utilisez l'organigramme suivant :
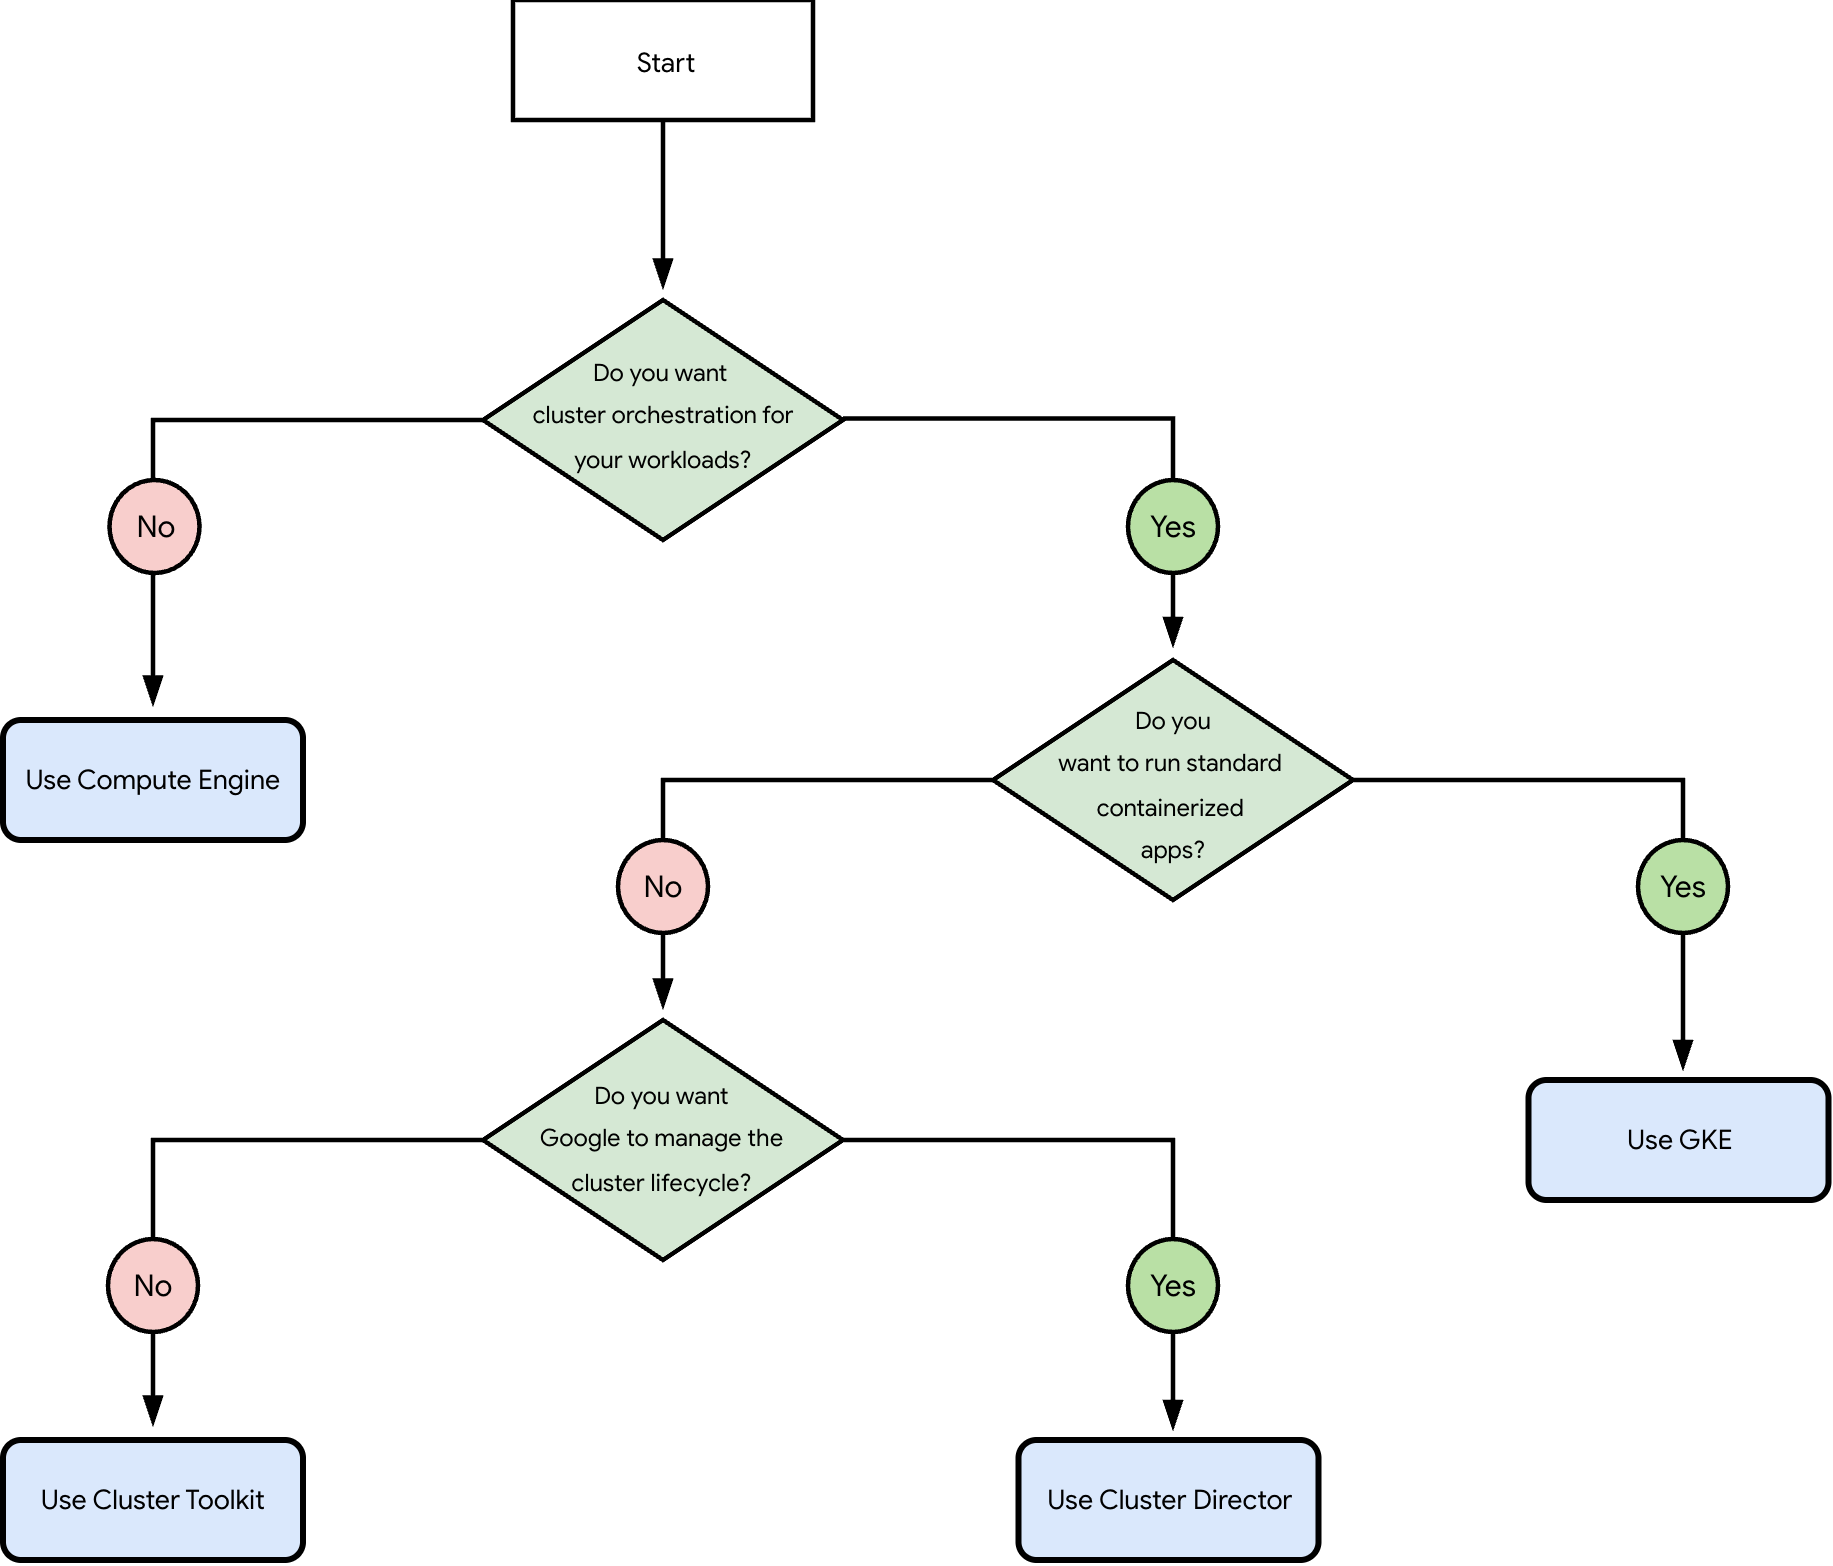
L'organigramme précédent pose les questions suivantes :
Souhaitez-vous orchestrer vos charges de travail dans des clusters ?
- Oui : passez à la question 2.
- Non : utilisez Compute Engine.
Souhaitez-vous exécuter des applications conteneurisées standards ?
- Oui : utilisez GKE.
- Non : passez à la question 3.
Voulez-vous que Google gère le cycle de vie du cluster ?
- Oui : utilisez Cluster Director.
- Non : utilisez Cluster Toolkit.
Orchestrateurs compatibles
Un orchestrateur automatise la gestion des clusters et élimine la nécessité de gérer chaque instance de calcul individuellement. Les outils d'orchestration tels que Slurm ou Kubernetes gèrent la mise en file d'attente des jobs, l'allocation des ressources et l'autoscaling.
Slurm : orchestrateur Open Source couramment utilisé pour les charges de travail d'IA, de ML et de HPC. Vous pouvez utiliser Slurm avec Cluster Toolkit ou Cluster Director.
Kubernetes : plate-forme d'orchestration de conteneurs Open Source. Vous pouvez déployer Kubernetes à l'aide de GKE directement ou via Cluster Toolkit.
Personnalisé ou aucun : utilisez Compute Engine si vous préférez un autre orchestrateur ou si vous souhaitez gérer vos instances de calcul sans orchestrateur. Cette option offre le plus haut niveau de contrôle, mais vous oblige à configurer, gérer et mettre à jour manuellement vos instances de calcul.
Plates-formes de déploiement compatibles
Une fois que vous avez identifié l'orchestrateur et l'option de déploiement recommandés pour votre cas d'utilisation, consultez leurs descriptions ci-dessous pour vérifier que leurs niveaux de gestion et leurs fonctionnalités répondent aux exigences de votre charge de travail.
Plates-formes gérées et automatisées
Si vous souhaitez éviter la surcharge liée à la gestion d'un cluster et vous concentrer plutôt sur l'exécution de vos charges de travail, utilisez l'une des plates-formes gérées suivantes :
Cluster Director : service entièrement géré qui automatise le cycle de vie des clusters Slurm. Utilisez Cluster Director pour simplifier la configuration de vos clusters Slurm. Cluster Director automatise le cycle de vie de vos clusters afin que vous puissiez vous concentrer sur l'exécution de vos charges de travail d'IA, de ML ou de HPC. Pour en savoir plus, consultez la présentation de Cluster Director.
GKE : environnement Kubernetes géré et optimisé pour les charges de travail d'IA et de ML. Utilisez GKE pour orchestrer les charges de travail conteneurisées, vous intégrer au matériel Compute Engine spécialisé et exploiter les fonctionnalités spécifiques à GKE, comme la planification sensible à la topologie (TAS, Topology Aware Scheduling). Pour en savoir plus, consultez la présentation de GKE.
Plates-formes semi-gérées et autogérées
Si vous avez besoin d'un contrôle précis sur le système d'exploitation, les configurations du noyau ou les versions des pilotes, utilisez une plate-forme semi-gérée ou autogérée :
Cluster Toolkit : un kit d'outils Open Source qui fournit des plans validés et personnalisables pour déployer des environnements d'IA et de ML reproductibles. Il offre une grande flexibilité et un contrôle élevé grâce aux principes d'Infrastructure as Code (IaC). Pour en savoir plus, consultez la présentation de Cluster Toolkit.
Compute Engine : service de calcul personnalisable qui offre un contrôle maximal pour créer des environnements personnalisés de A à Z. Bien qu'il ne s'agisse pas d'un orchestrateur autonome, Compute Engine sert de base aux utilisateurs qui préfèrent créer et gérer leurs propres piles personnalisées spécialisées. Pour en savoir plus, consultez la présentation de Compute Engine.
Étapes suivantes
- Pour obtenir de la capacité, consultez Options de consommation.
- Pour déployer votre cluster, consultez Présentation de la création de clusters.