


AI または ML のワークロードを効率的に実行するには、ワークロード オーケストレーターとデプロイ プラットフォームの両方を選択する必要があります。これらのコンポーネントは次のように機能します。
オーケストレーターはジョブをスケジュールして実行します。
デプロイ オプションはオーケストレーターを管理します。
ワークロードの実行に使用する GPU インフラストラクチャ(クラスタ化された GPU または汎用 GPU)を特定したら、このドキュメントのガイダンスに沿って、ワークロードと管理レベルに最適なオーケストレーターとデプロイを特定します。
ワークロードの実行に使用できる GPU マシンタイプを確認するには、GPU マシンをご覧ください。
オーケストレーターとデプロイ オプションを比較する
AI Hypercomputer には、コンピューティング インスタンス向けに複数のオーケストレーターとデプロイ オプションが用意されています。これらのオプションは、ワークロードに集中できるフルマネージド クラスタから、コンピューティング インスタンスのメンテナンスと更新方法をきめ細かく制御できるセルフマネージド環境まで多岐にわたります。
次の表に、AI ワークロードの実行時に使用できるオーケストレーターとデプロイ オプションを比較します。
| プロダクト | オーケストレーター | 技術的な複雑さ | 最適な用途 | 主なメリット |
|---|---|---|---|---|
| Cluster Director | Slurm | 低 | AI 研究者、データ サイエンティスト | Slurm クラスタのマネージド ライフサイクル |
| Google Kubernetes Engine(GKE) | Kubernetes | 中~高 | ML エンジニア、プラットフォーム エンジニア | コンテナのオーケストレーションとスケーリング |
| Cluster Toolkit | Slurm、Kubernetes | 中 | ML DevOps、プラットフォーム エンジニア | 検証済みの Infrastructure as Code ブループリント |
| Compute Engine | カスタム / なし | 高 | インフラストラクチャ アーキテクト | OS とネットワーキングをきめ細かく制御する |
オーケストレーターとデプロイ オプションを選択する
オーケストレーターとデプロイ オプションを選択するには、次のフローチャートを使用します。
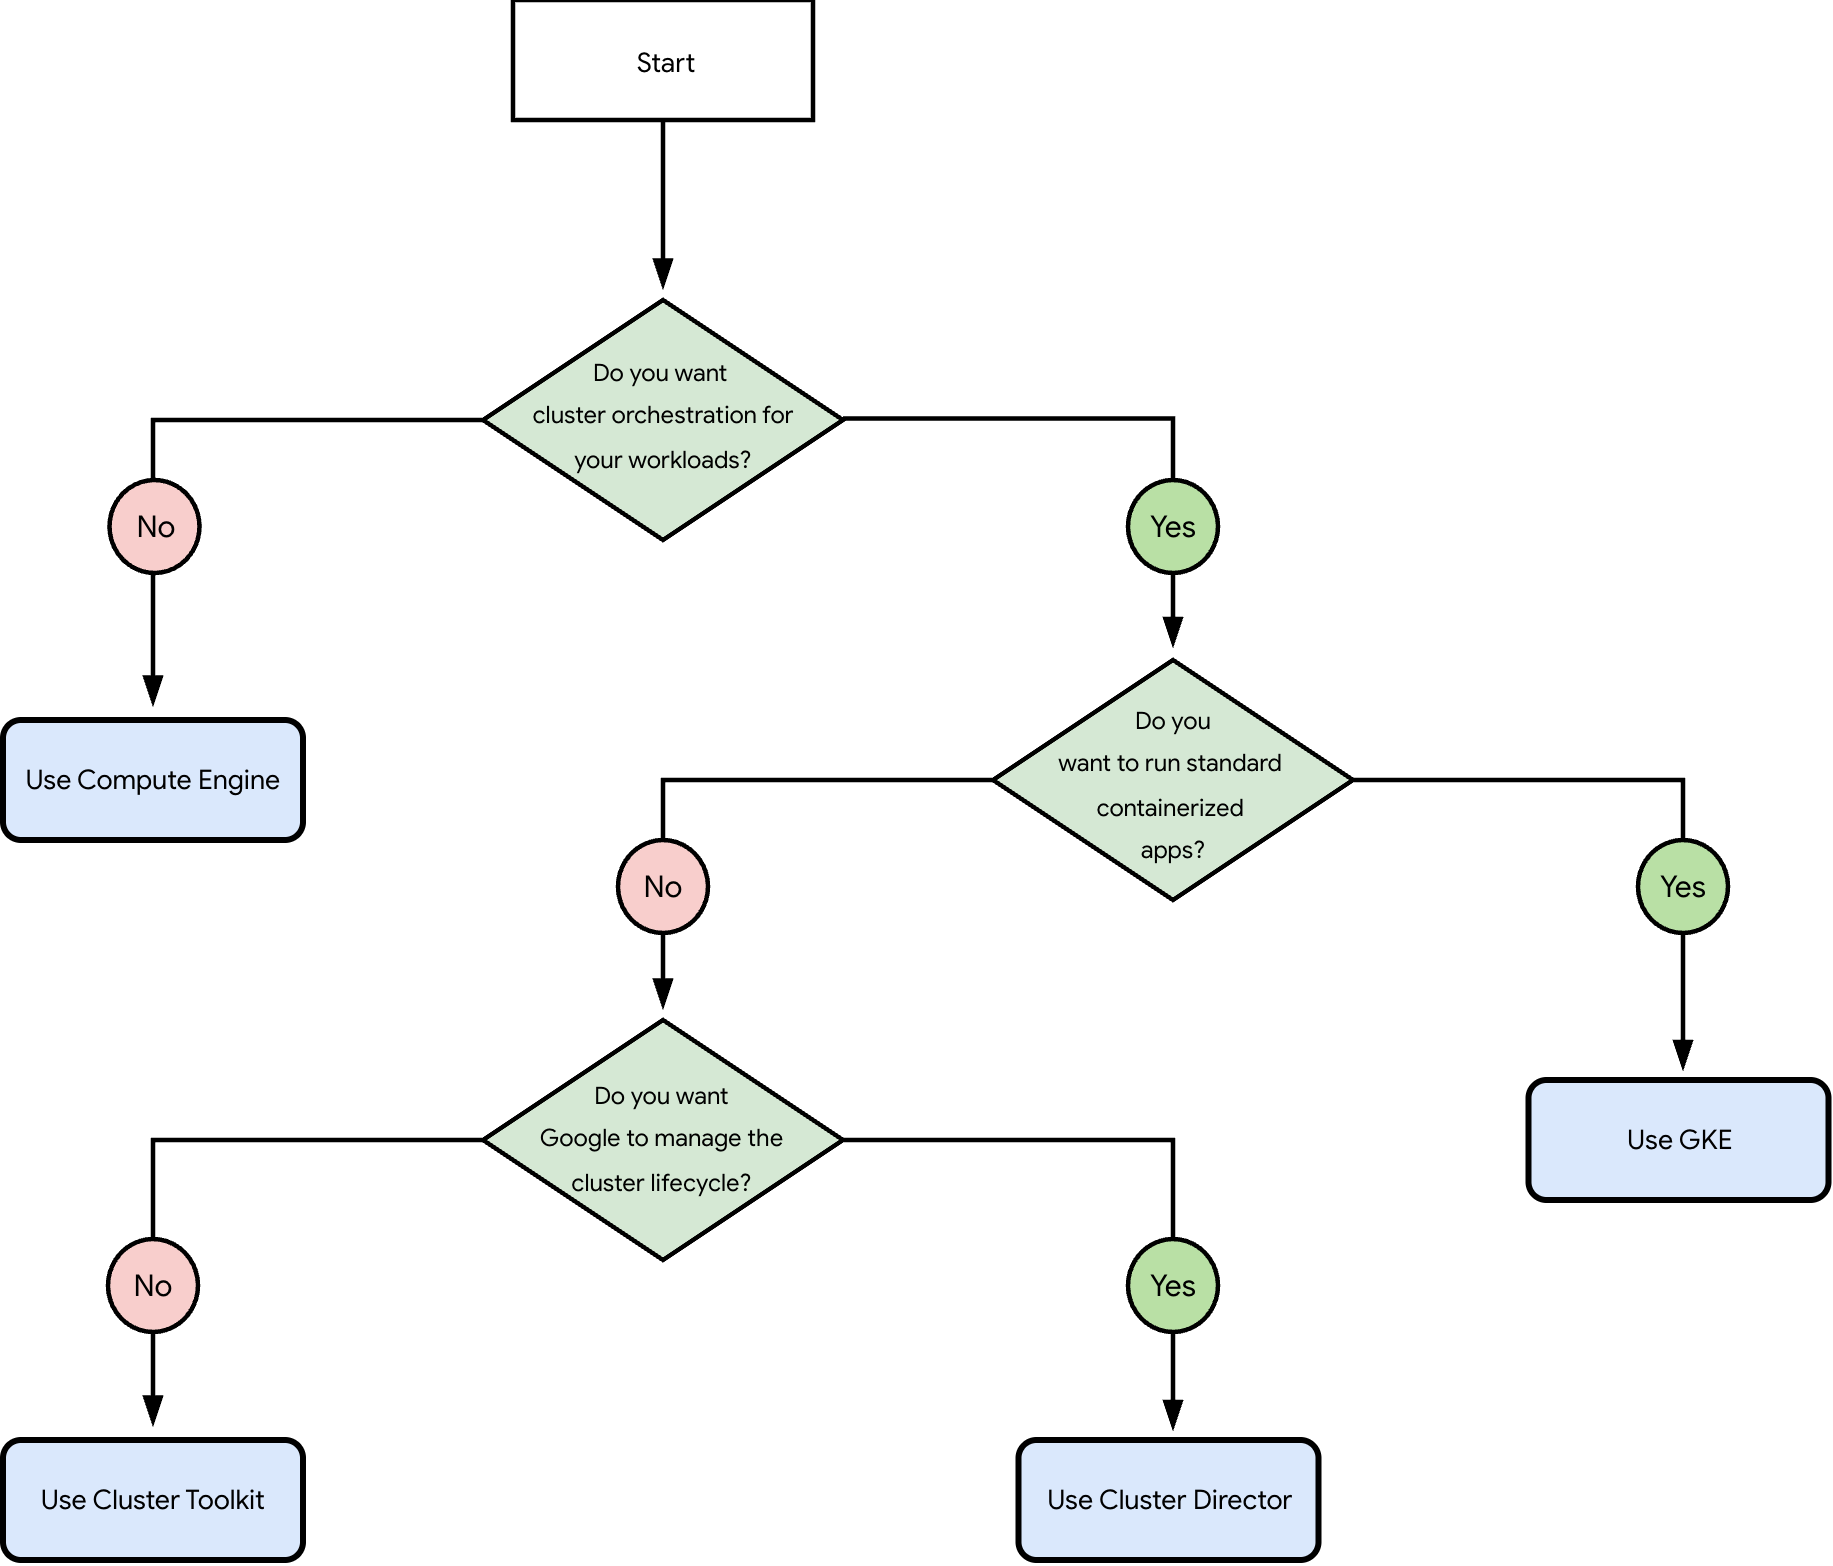
上のフローチャートでは、次の質問をします。
ワークロードのクラスタ オーケストレーションが必要ですか?
- はい: 質問 2 に進みます。
- いいえ: Compute Engine を使用します。
標準のコンテナ化されたアプリを実行しますか?
- はい: GKE を使用します。
- いいえ: 質問 3 に進みます。
クラスタのライフサイクルを Google に管理させますか?
- はい: Cluster Director を使用します。
- いいえ: Cluster Toolkit を使用します。
サポートされているオーケストレーター
オーケストレーターはクラスタ管理を自動化し、各コンピューティング インスタンスを個別に管理する必要をなくします。Slurm や Kubernetes などのオーケストレーターは、ジョブのキューイング、リソース割り当て、自動スケーリングを処理します。
Slurm: AI、ML、HPC ワークロードで一般的に使用されるオープンソースのオーケストレーター。Slurm は、Cluster Toolkit または Cluster Director で使用できます。
Kubernetes: オープンソース コンテナ オーケストレーション プラットフォーム。Kubernetes は、GKE を直接使用するか、Cluster Toolkit を使用してデプロイできます。
カスタムまたはなし: 別のオーケストレーターを使用する場合や、オーケストレーターなしでコンピューティング インスタンスを管理する場合は、Compute Engine を使用します。このオプションでは、最高レベルの制御が可能ですが、コンピューティング インスタンスを手動で設定、維持、更新する必要があります。
サポートされているデプロイ プラットフォーム
ユースケースに推奨されるオーケストレーターとデプロイ オプションを特定したら、以下の説明を確認して、管理レベルと機能がワークロードの要件を満たしていることを確認します。
マネージド プラットフォームと自動化されたプラットフォーム
クラスタの管理のオーバーヘッドを回避して、ワークロードの実行に集中したい場合は、次のいずれかのマネージド プラットフォームを使用します。
Cluster Director: Slurm クラスタのライフサイクルを自動化するフルマネージド サービス。Cluster Director を使用して、Slurm クラスタのセットアップと構成を簡素化します。Cluster Director はクラスタのライフサイクルを自動化するため、AI、ML、HPC のワークロードの実行に集中できます。詳細については、 Cluster Director の概要をご覧ください。
GKE: AI と ML のワークロード用に最適化されたマネージド Kubernetes 環境。GKE を使用して、コンテナ化されたワークロードをオーケストレートし、専用の Compute Engine ハードウェアと統合し、トポロジを認識したスケジューリング(TAS)などの GKE 固有の機能を活用します。詳細については、GKE の概要をご覧ください。
セミマネージド プラットフォームとセルフマネージド プラットフォーム
オペレーティング システム、カーネル構成、ドライバ バージョンをきめ細かく制御する必要がある場合は、半管理型またはセルフマネージド プラットフォームを使用します。
Cluster Toolkit: 再現可能な AI 環境と ML 環境をデプロイするための、検証済みのカスタマイズ可能なブループリントを提供するオープンソース ツールキット。Infrastructure as Code(IaC)の原則を使用して、高い柔軟性と制御を実現します。詳細については、Cluster Toolkit の概要をご覧ください。
Compute Engine: カスタム環境をゼロから構築するための最大限の制御を提供するカスタマイズ可能なコンピューティング サービス。Compute Engine はスタンドアロンのオーケストレーターではありませんが、独自の専門的なカスタム スタックを構築して管理したいユーザーにとって基盤となります。詳細については、Compute Engine の概要をご覧ください。
次のステップ
- 容量を取得するには、使用オプションをご覧ください。
- クラスタをデプロイするには、クラスタの作成の概要をご覧ください。