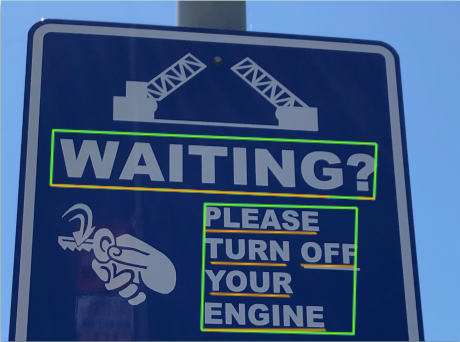
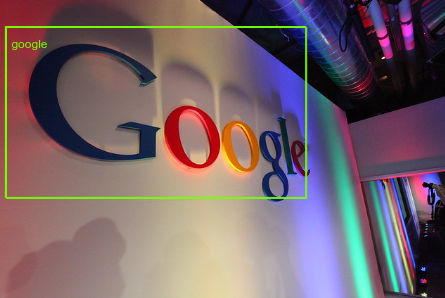
Oferece reconhecimento óptico de caracteres (OCR, na sigla em inglês) de uma imagem, reconhecimento de texto e
conversão para texto codificado por máquina. Identifica e extrai o texto UTF-8 em uma
imagem.
Imagens: otimizadas para áreas esparsas de texto em uma
imagem maior.
Resposta: retorna uma lista de palavras identificadas com o texto,
caixas delimitadoras e textAnnotations, bem como a hierarquia
estrutural do texto detectado pelo
OCR (fullTextAnnotation).
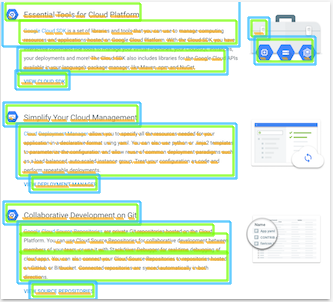
Reconhecimento óptico de caracteres (OCR, na sigla em inglês) de um arquivo (PDF/TIFF) ou
imagem de texto densa, reconhecimento de texto denso e
conversão para texto codificado por máquina.
Arquivos: otimizado para arquivos de documentos (PDF/TIFF).
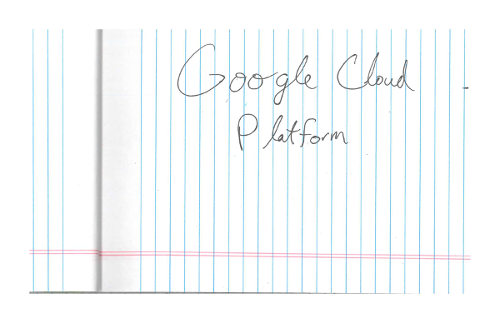
Imagens: otimizado para áreas de textodensas em uma imagem
(imagens que são documentos) e imagens que contêm texto escrito à mão.
Resposta: retorna a hierarquia estrutural do texto detectado pelo
OCR (fullTextAnnotation).
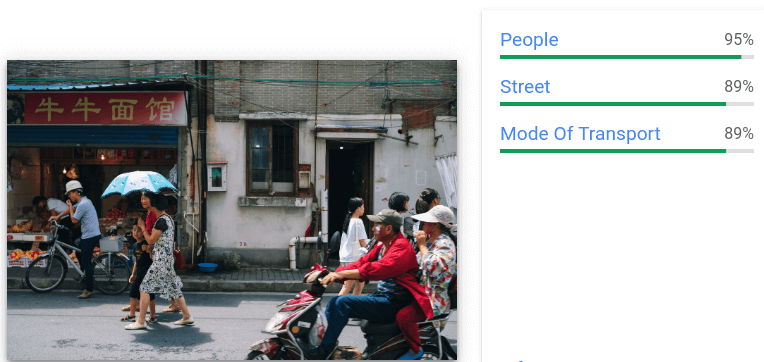
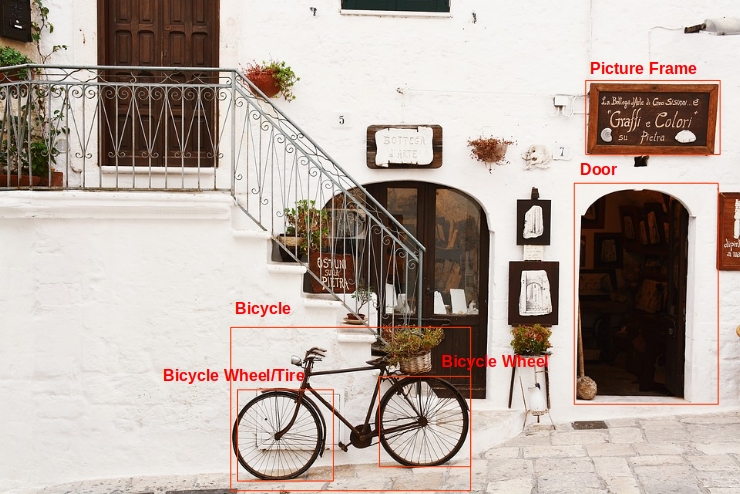
Fornece anotações gerais de rótulos e caixas delimitadoras para vários objetos
reconhecidos em uma única imagem.
Para cada objeto detectado, os seguintes elementos são retornados: uma descrição
textual, um índice de confiança e vértices normalizados [0,1] para
o polígono delimitador ao redor do objeto.
Fornece um polígono delimitador para a imagem cortada, um índice de confiança
e uma fração de importância desta região saliente em relação à
imagem original para cada solicitação.
É possível fornecer até 16 valores de proporção de imagem (largura:altura)
para uma única imagem.
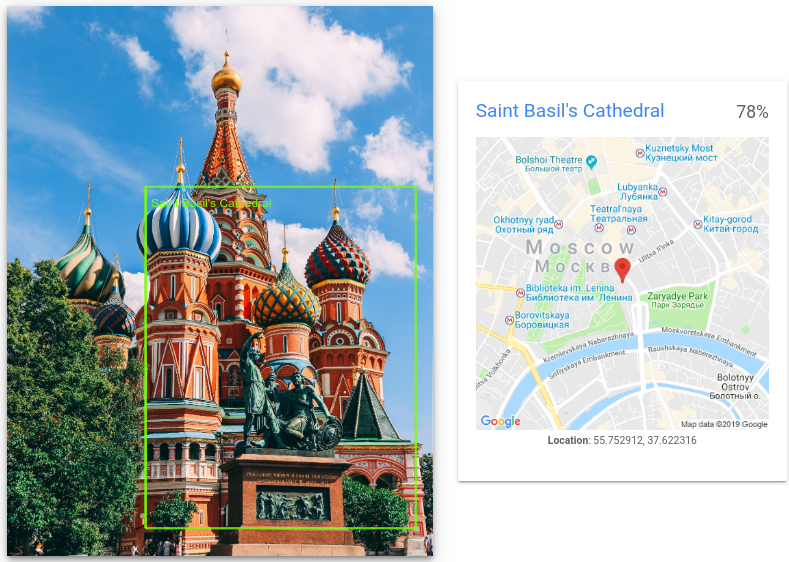
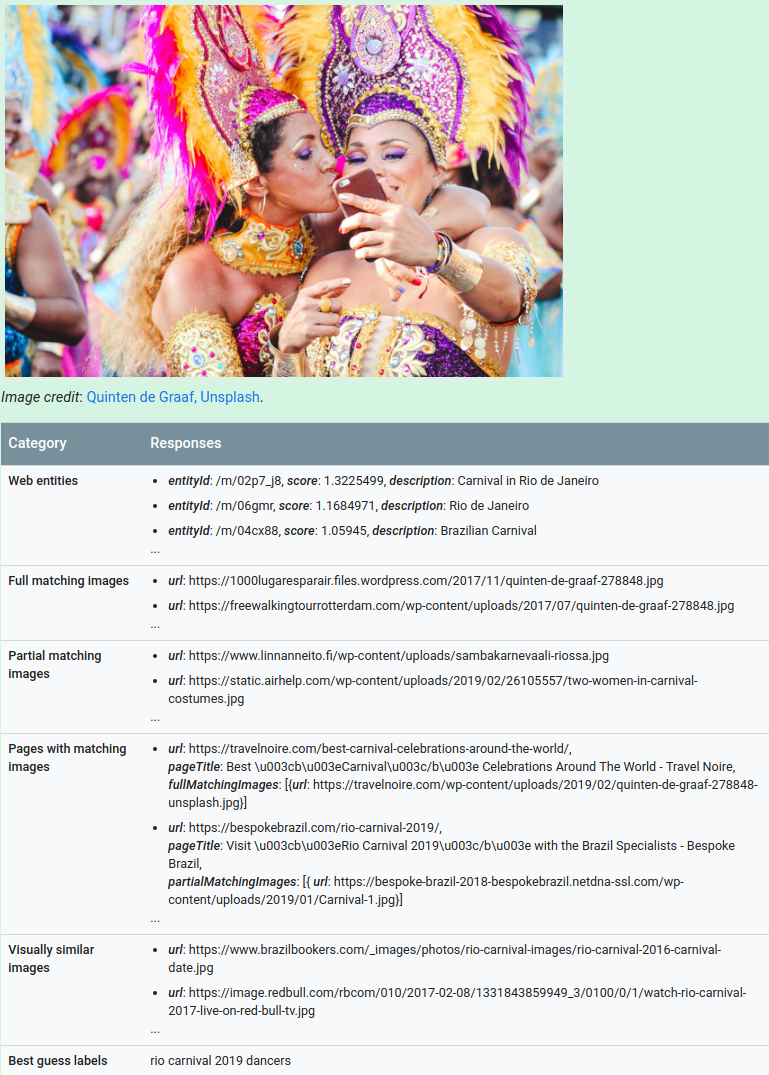
Fornece uma série de conteúdos da Web relacionados a uma imagem.
Retorna as seguintes informações:
Entidades da Web: entidades inferidas (rótulos/descrições) de
imagens semelhantes na Web
Imagens completamente correspondentes: uma lista de URLs de imagens totalmente correspondentes
de qualquer tamanho na Internet
Imagens parcialmente correspondentes: uma lista de URLs de
imagens que compartilham atributos de pontos chave, como uma versão cortada da imagem
original
Páginas com imagens correspondentes: uma lista de páginas da Web (identificadas pelo
URL, título da página e URL da imagem correspondente) com uma imagem que satisfaça
as condições descritas acima
Imagens visualmente semelhantes: uma lista de URLs de imagens que compartilham
alguns atributos com a imagem original
Melhor rótulo de sugestões: um palpite sobre o assunto da imagem
solicitada inferida de imagens semelhantes na Internet
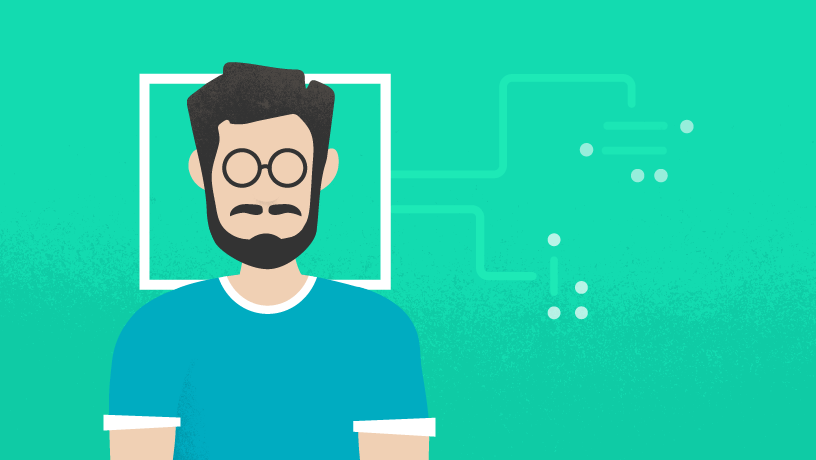
Localiza rostos com polígonos delimitantes
e identifica "pontos de referência" faciais específicos, como olhos, ouvidos, nariz, boca
etc., junto aos níveis de confiança correspondentes.
Retorna as classificações de probabilidade de propriedades gerais da imagem
(subexposta, desfocada, exibindo chapéus e afins).
As avaliações de probabilidade são expressas
como seis valores diferentes: UNKNOWN, VERY_UNLIKELY,
UNLIKELY, POSSIBLE, LIKELY ou
VERY_LIKELY.
[[["Fácil de entender","easyToUnderstand","thumb-up"],["Meu problema foi resolvido","solvedMyProblem","thumb-up"],["Outro","otherUp","thumb-up"]],[["Difícil de entender","hardToUnderstand","thumb-down"],["Informações incorretas ou exemplo de código","incorrectInformationOrSampleCode","thumb-down"],["Não contém as informações/amostras de que eu preciso","missingTheInformationSamplesINeed","thumb-down"],["Problema na tradução","translationIssue","thumb-down"],["Outro","otherDown","thumb-down"]],["Última atualização 2026-10-16 UTC."],[],[]]