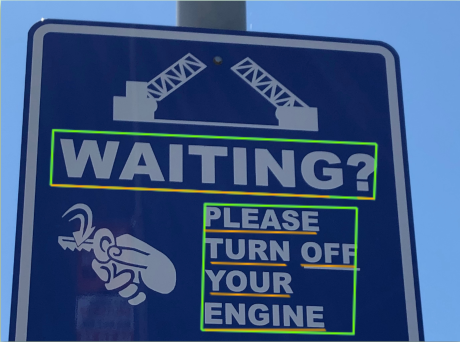
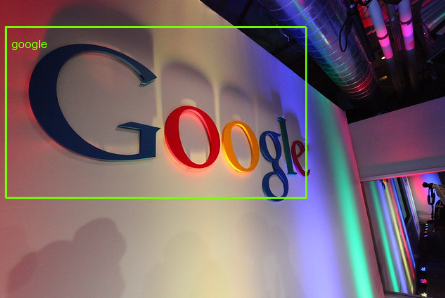
Riconoscimento ottico dei caratteri (OCR) per un'immagine; riconoscimento del testo e conversione in testo codificato automaticamente. Identifica ed estrae il testo UTF-8 in un'immagine.
Immagini: ottimizzate per aree di testo sparse all'interno di un'immagine più grande.
Risposta: restituisce un elenco di parole identificate con testo, riquadri di delimitazione e textAnnotations, nonché la gerarchia strutturale per il testo rilevato dall'OCR (fullTextAnnotation).
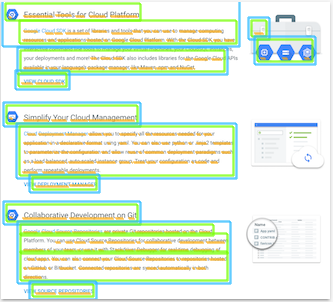
Riconoscimento ottico dei caratteri (OCR) per un file (PDF/TIFF) o un'immagine di testo denso; riconoscimento del testo denso e conversione in testo codificato automaticamente.
File: ottimizzato per i file di documenti (PDF/TIFF).
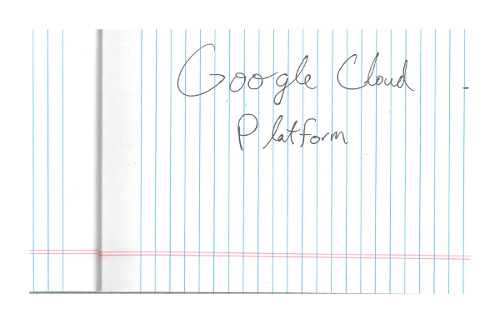
Immagini: ottimizzate per aree di testo dense in un'immagine (immagini che sono documenti) e immagini che contengono testo scritto a mano.
Risposta: restituisce la gerarchia strutturale del testo rilevato dall'OCR (fullTextAnnotation).
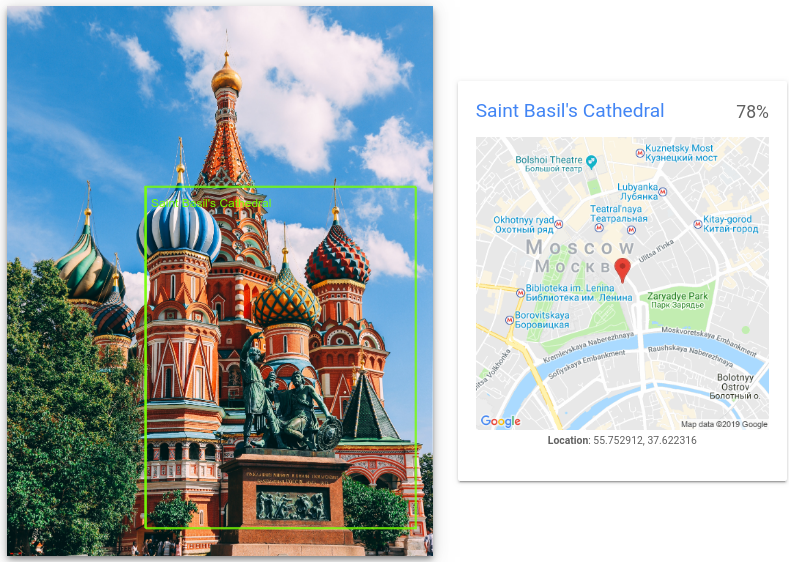
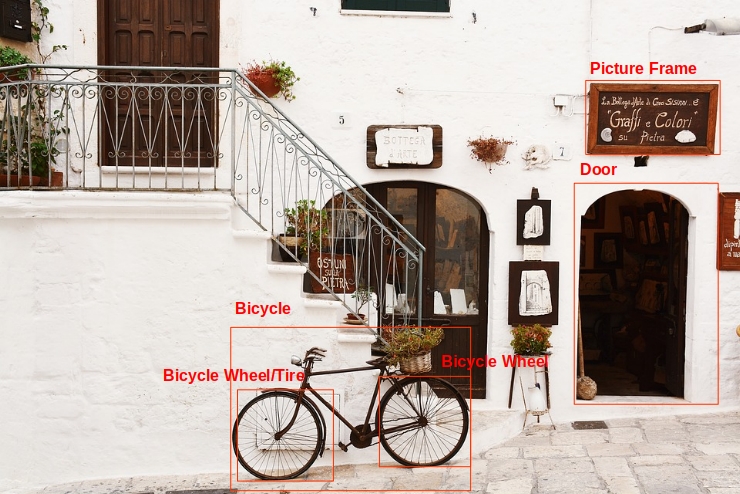
Fornisce annotazioni generali di etichette e riquadro di delimitazione per più oggetti riconosciuti in una singola immagine.
Per ogni oggetto rilevato vengono restituiti i seguenti elementi: una descrizione testuale, un punteggio di affidabilità e i vertici normalizzati [0,1] per il poligono di delimitazione intorno all'oggetto.
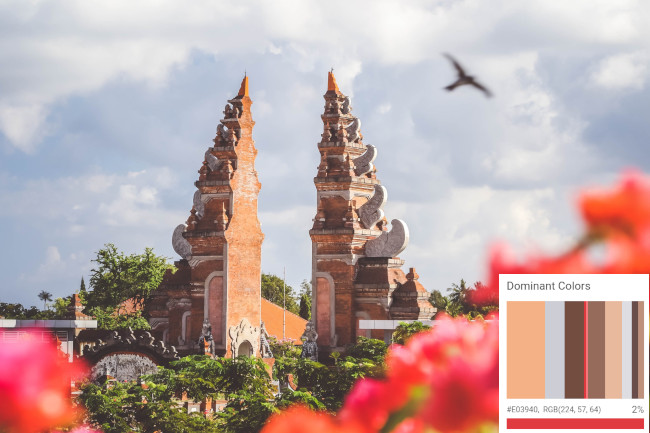
Fornisce un poligono di delimitazione per l'immagine ritagliata, un punteggio di affidabilità e una frazione di importanza di questa regione saliente rispetto all'immagine originale per ogni richiesta.
Puoi fornire fino a 16 valori di proporzioni (larghezza:altezza) per una singola immagine.
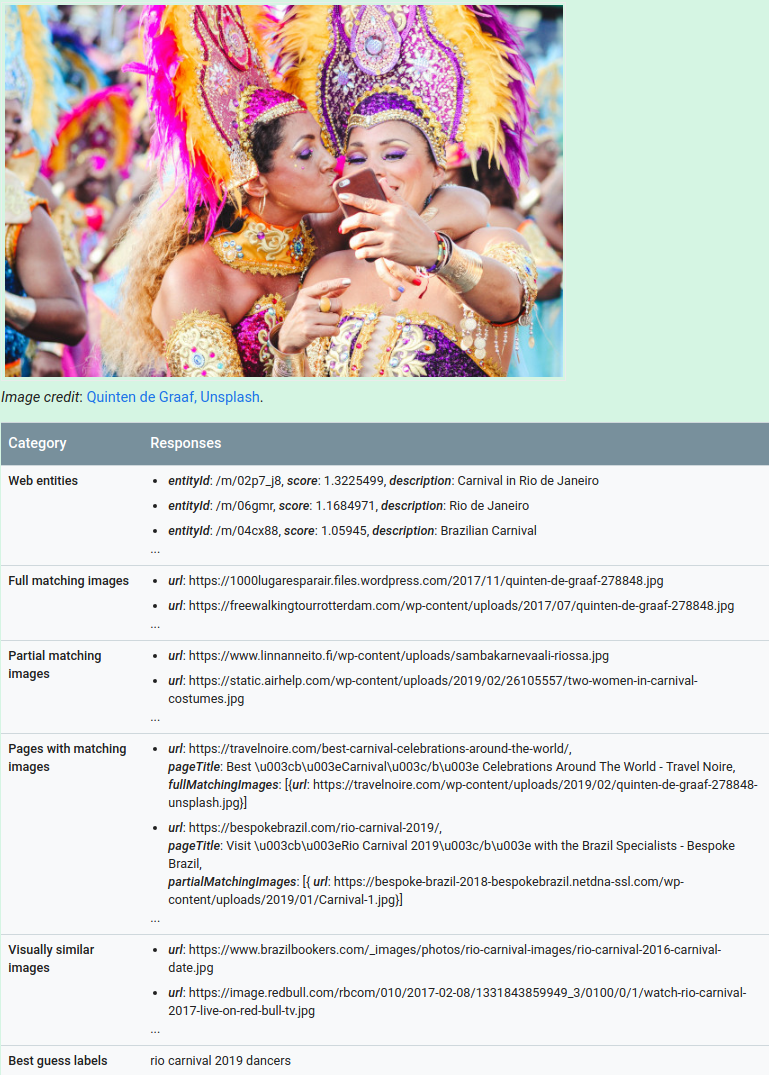
Fornisce una serie di contenuti web correlati a un'immagine.
Restituisce le seguenti informazioni:
Entità web: entità dedotte (etichette/descrizioni) da immagini simili sul web.
Immagini con corrispondenza completa: un elenco di URL per immagini con corrispondenza completa di qualsiasi dimensione su internet.
Immagini con corrispondenza parziale: un elenco di URL di immagini che condividono caratteristiche dei punti chiave, ad esempio una versione ritagliata dell'immagine originale.
Pagine con immagini corrispondenti: un elenco di pagine web (identificate dall'URL della pagina, dal titolo della pagina e dall'URL dell'immagine corrispondente) con un'immagine che soddisfa le condizioni descritte sopra.
Immagini visivamente simili: un elenco di URL per le immagini che condividono alcune caratteristiche con l'immagine originale.
Etichetta di ipotesi migliore: un'ipotesi migliore sull'argomento dell'immagine richiesta dedotta da immagini simili su internet.
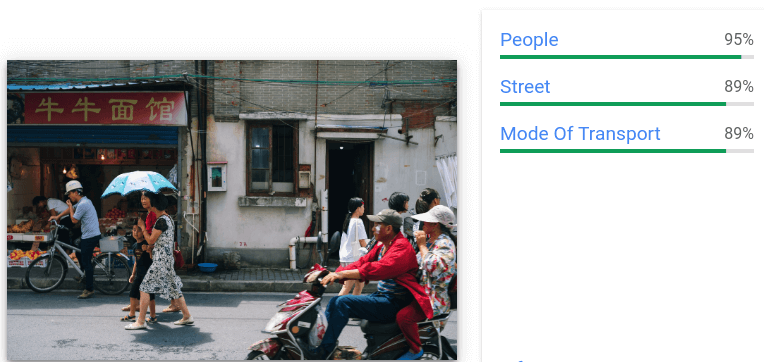
Individua i volti con poligoni di delimitazione e identifica "punti di riferimento" facciali specifici come occhi, orecchie, naso, bocca e così via, insieme ai relativi valori di affidabilità.
Restituisce le valutazioni della probabilità per le proprietà generali delle immagini (sottoesposte, sfocate, presenza di copricapo).
Le valutazioni della probabilità sono espresse
come 6 valori diversi: UNKNOWN, VERY_UNLIKELY,
UNLIKELY, POSSIBLE, LIKELY o
VERY_LIKELY.
[[["Facile da capire","easyToUnderstand","thumb-up"],["Il problema è stato risolto","solvedMyProblem","thumb-up"],["Altra","otherUp","thumb-up"]],[["Difficile da capire","hardToUnderstand","thumb-down"],["Informazioni o codice di esempio errati","incorrectInformationOrSampleCode","thumb-down"],["Mancano le informazioni o gli esempi di cui ho bisogno","missingTheInformationSamplesINeed","thumb-down"],["Problema di traduzione","translationIssue","thumb-down"],["Altra","otherDown","thumb-down"]],["Ultimo aggiornamento 2026-10-16 UTC."],[],[]]