

大規模言語モデル(LLM)の進化に伴い、「マシンごとに 1 つのモデル」というデプロイ パターンは、企業における LLM サービングの費用対効果の大きなボトルネックになりつつあります。LLM では、ピーク時の負荷を管理するために、8 個の H100 GPU ノード全体など、大量のハードウェア予約が必要になることがよくあります。しかし、標準的な運用では、これらの高価なリソースは十分に活用されないことが多く、総所有コスト(TCO)が高くなります。
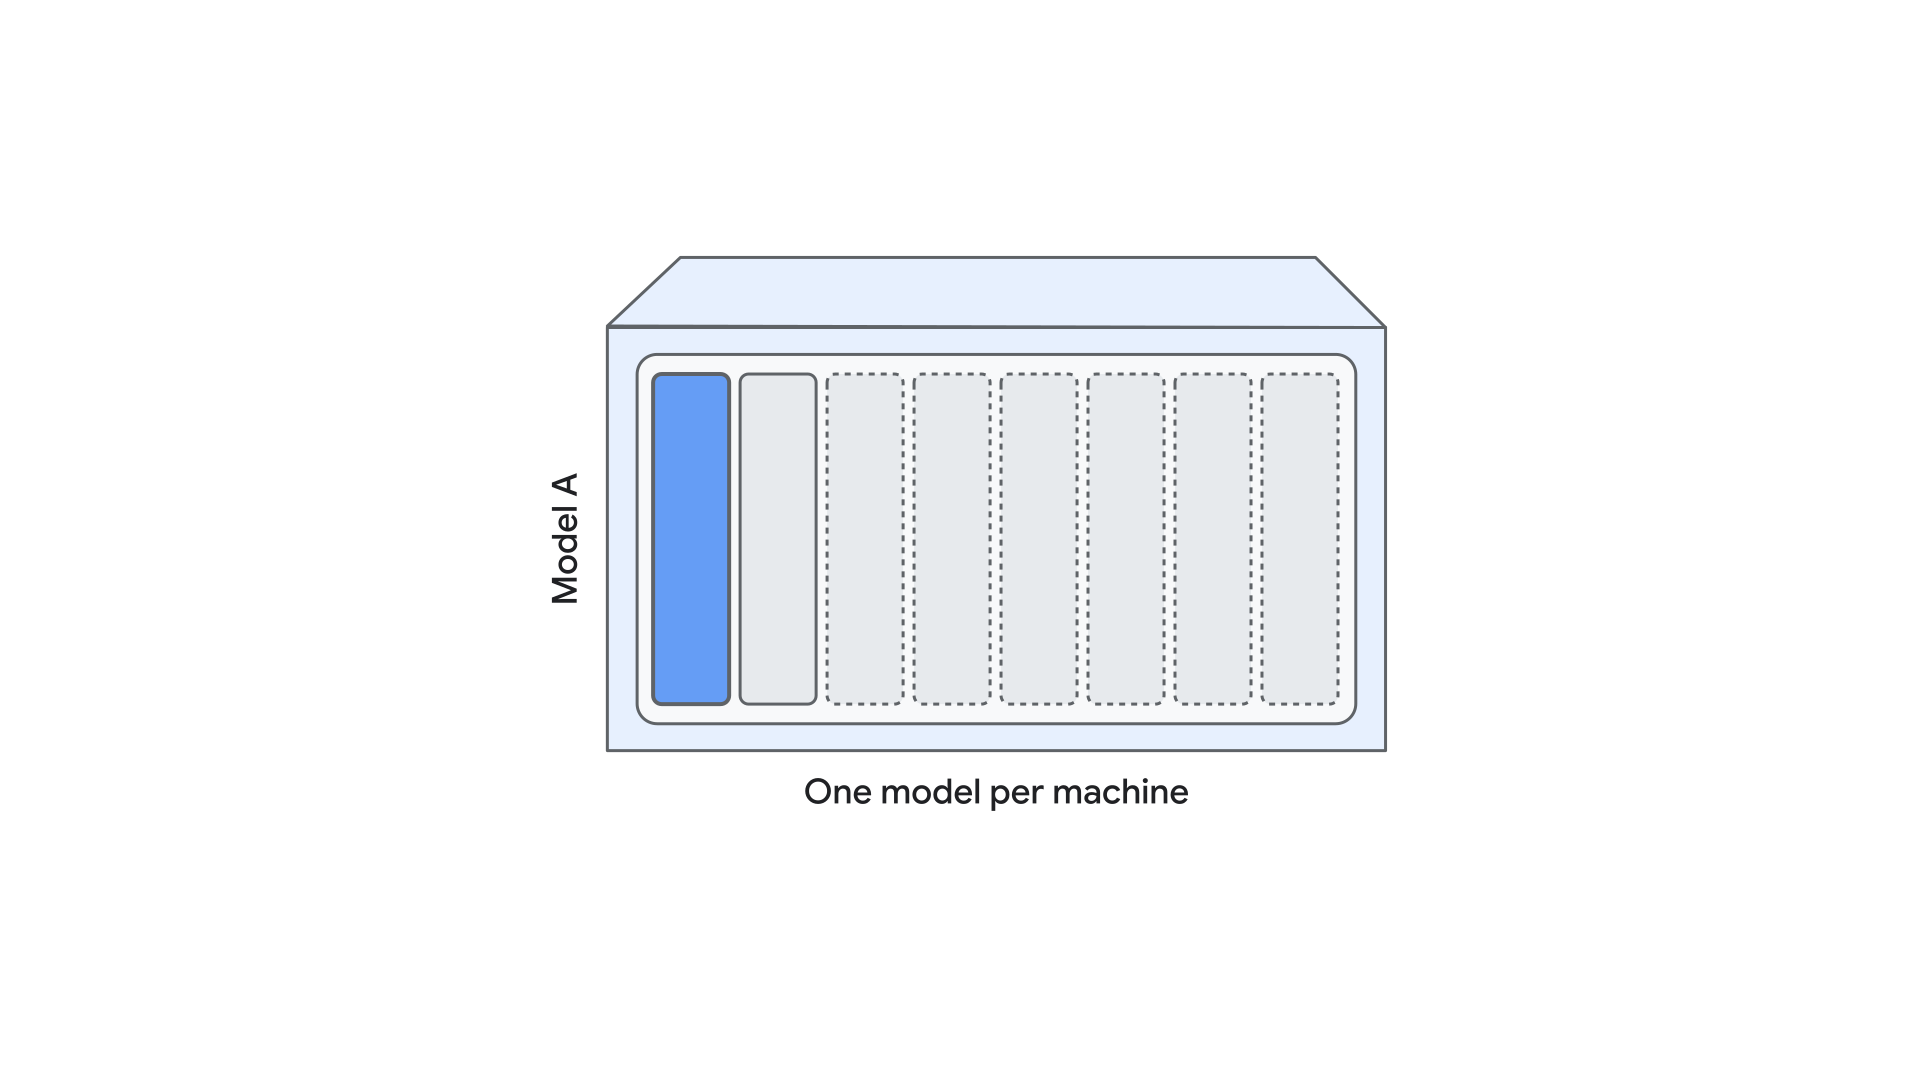
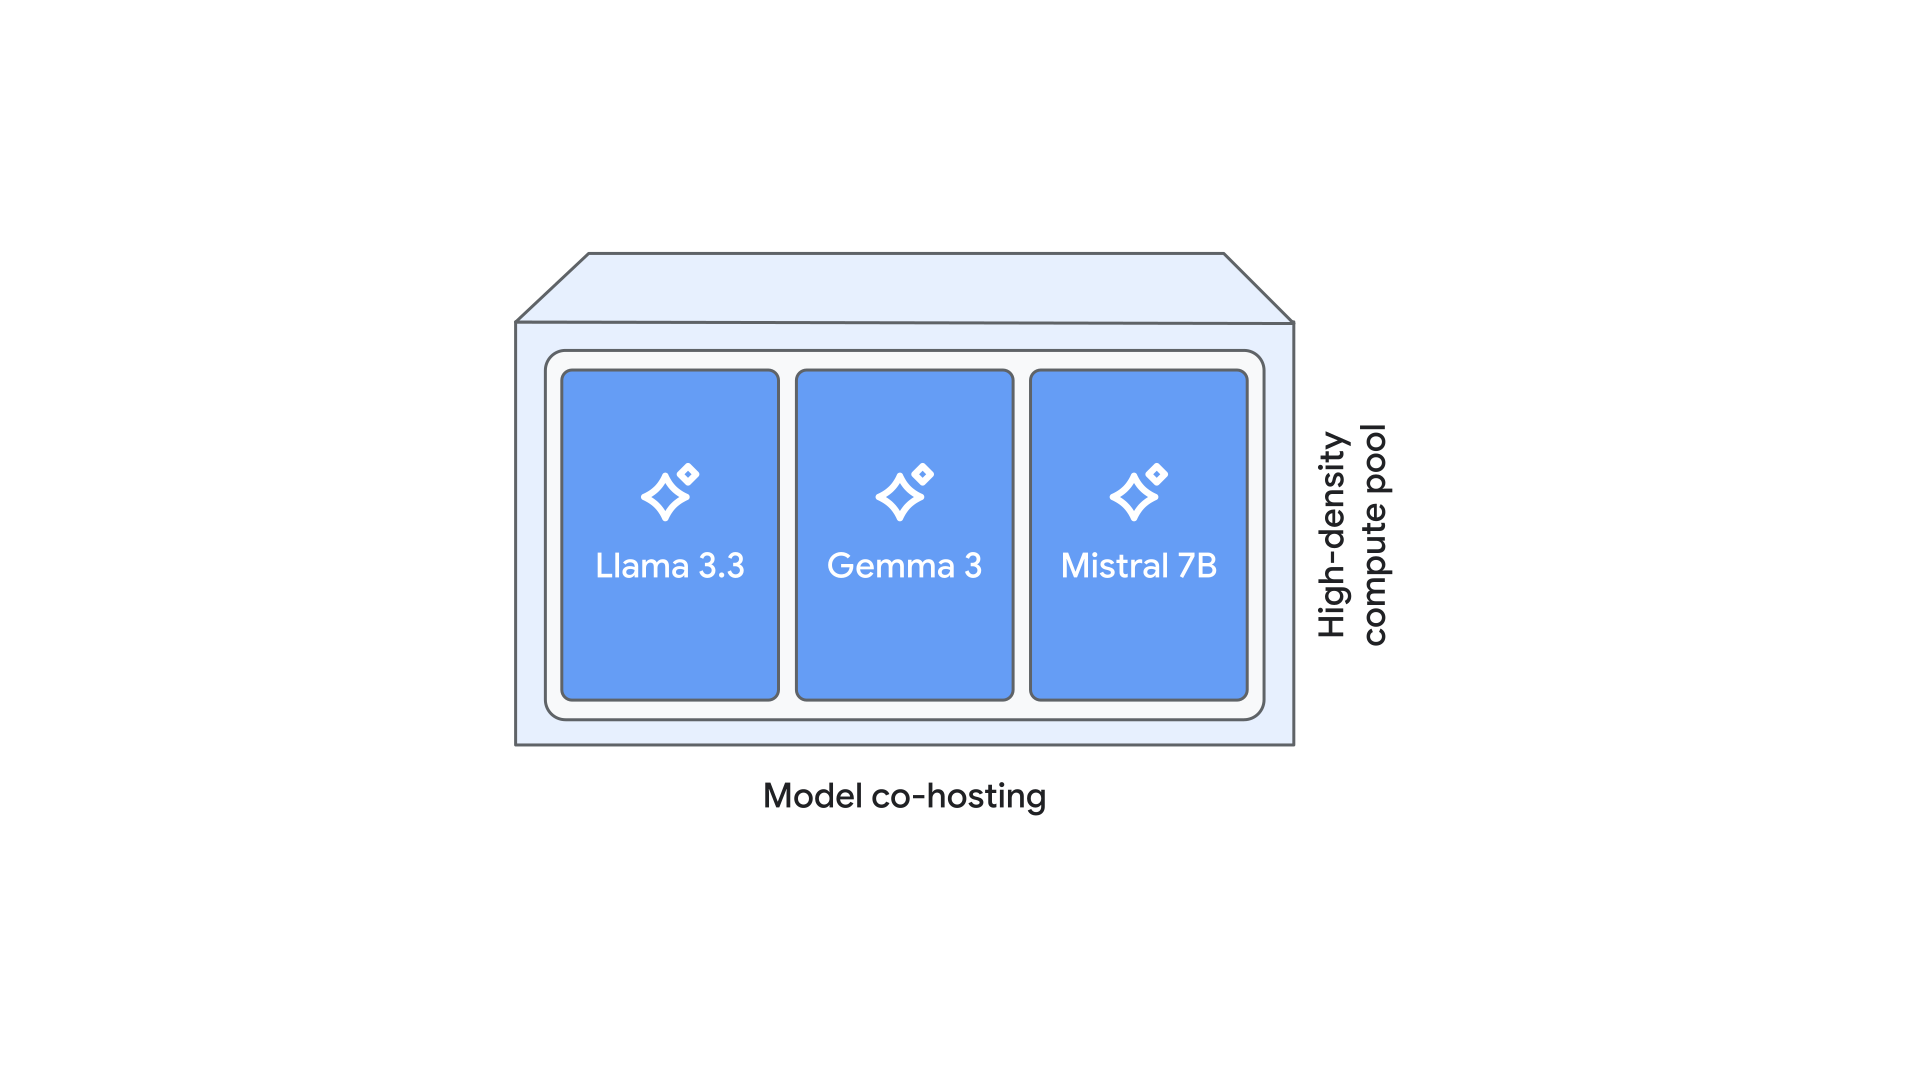
モデルの共同ホスティングは、複数のモデル インスタンスが同じ仮想マシンと GPU リソースを共有できるようにすることで、この効率性のギャップを解消します。これには、Llama 3.3 や Gemma 3 など、まったく異なるモデルも含まれます。Vertex AI Model Garden は、サブ GPU メモリ スライスとインテリジェントなリソース パーティショニングを利用して、静的なハードウェア予約を柔軟で高密度のコンピューティング プールに変換します。
この技術ブログでは、Vertex AI Engineering がモデルの共同ホスティングを本番環境対応のクラウド サービスに導入するプロセスについて詳しく説明しています。コンテナレベルの実装戦略、最適なサービング構成の特定、広範なマルチモデル ベンチマーク調査から得られた主な知見に関する Google の手法を共有し、LLM サービングの費用対効果を最大化できるようにします。
モデルの共同ホスティングについて: コンセプトとアーキテクチャ
モデルの共同ホスティングは、複数の大規模言語モデル(LLM)インスタンスまたは異なるモデル アーキテクチャが、単一の仮想マシン(VM)内で同じ物理ハードウェア リソースを共有できるようにする高密度サービング戦略です。1 つのモデルに VM または GPU 全体を割り当てる従来のデプロイモデルとは異なり、共同ホスティングでは、きめ細かいリソース パーティショニングを使用してハードウェアの ROI を最大化し、メモリとコンピューティング リソースの使用率を向上させます。
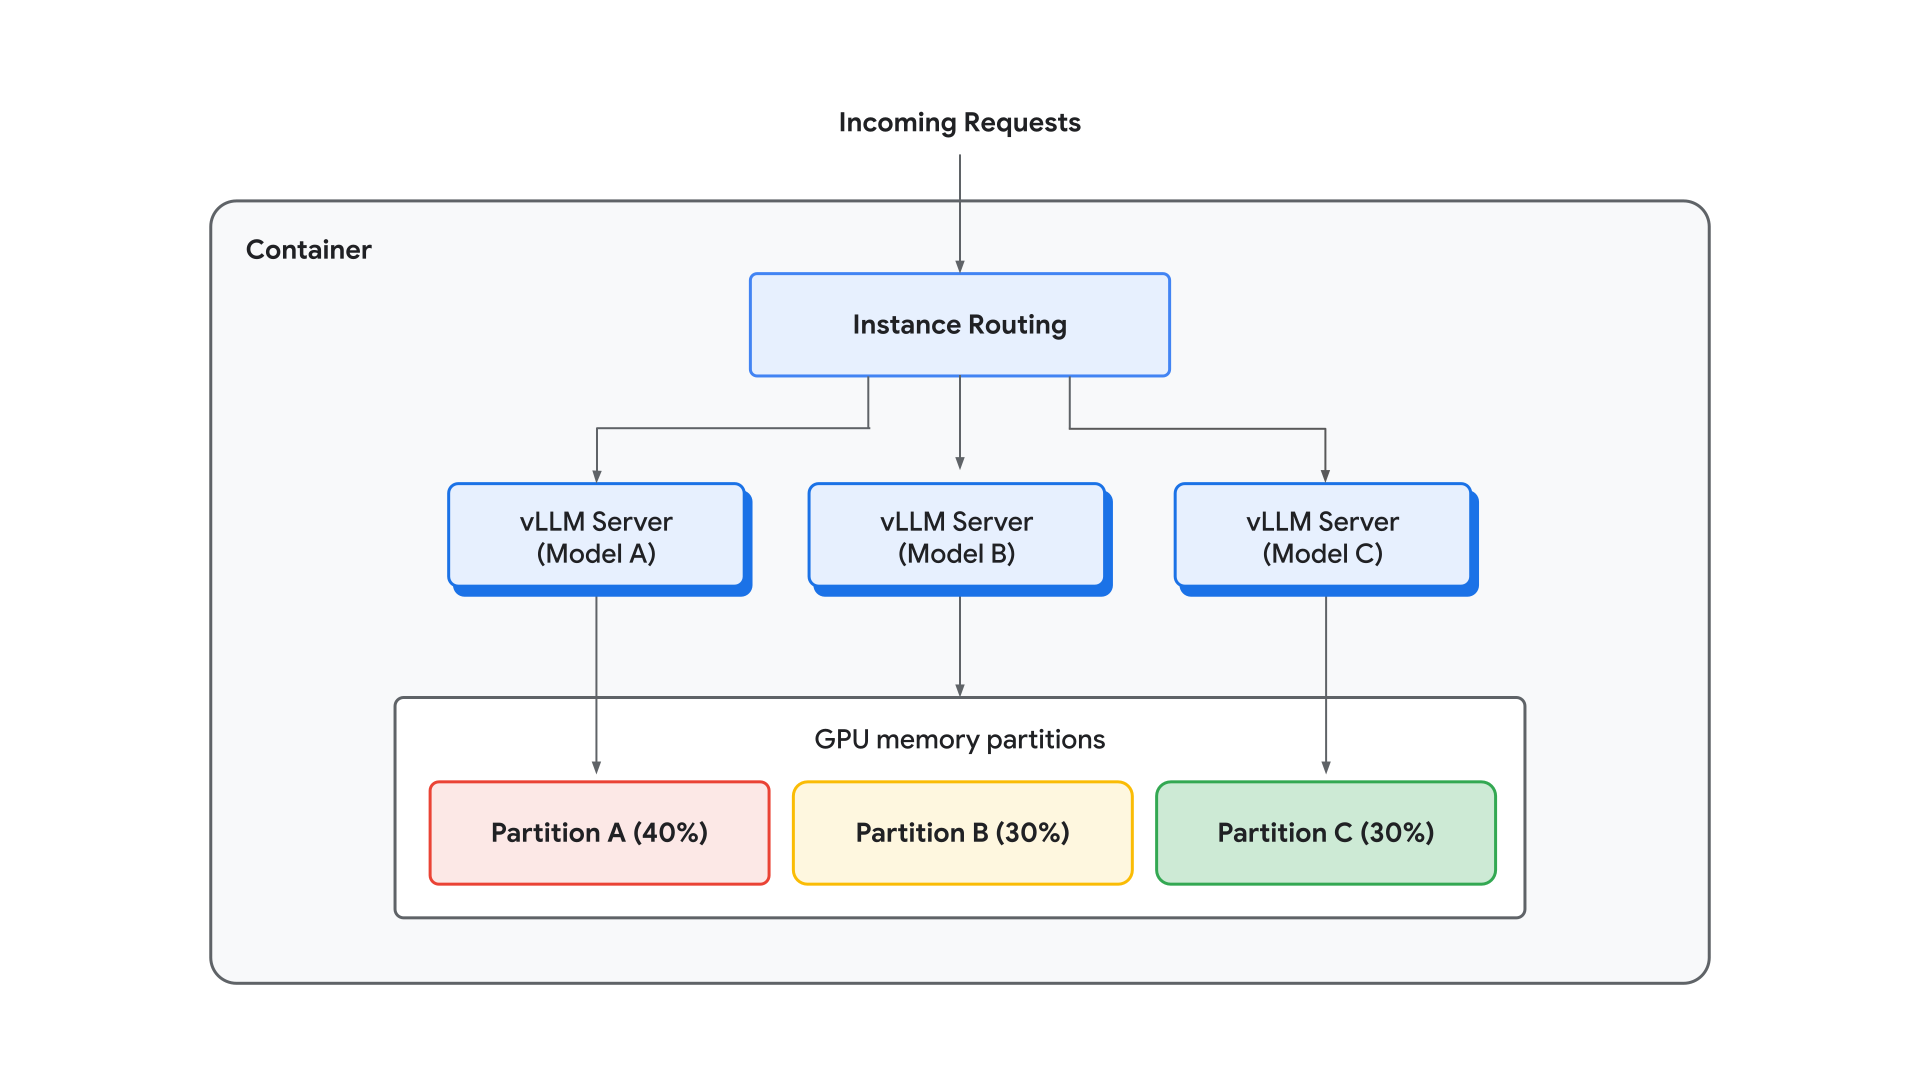
この実装では、独立した構成を持つ複数のモデルを同時に提供できるコンテナレベルのソリューションに焦点を当てています。このアーキテクチャは、1 つのコンテナ内に複数の独立したモデルサーバー インスタンスをデプロイすることから始まり、複数の統合された技術メカニズムを通じて動作します。これらの各インスタンスは、モデルサーバーの完全な独立したコピーとして機能します。これにより、仮想マシン全体でリクエストを同時に処理できます。このトラフィックを管理するために、コンテナ内にインスタンス ルーティング レイヤを実装し、受信リクエストをアクティブなインスタンス間で効率的に分散しました。
この設計では、各共同ホストモデルが専用のサービング構成を利用できるようにすることで、きめ細かい並列処理を実現します。この構成には、テンソル並列処理(TP)、パイプライン並列処理(PP)、特定の数のモデル インスタンスに固有の設定が含まれます。これを補完するのがリソース スライシングです。リソース スライシングでは、特定の GPU メモリ パーティション(モデルごとに 0.4 GPU メモリ パーティションなど)が各モデルに割り当てられます。これにより、重要なメモリリソースが不足することなく、多様なワークロードが同じアクセラレータ上で共存できます。このアーキテクチャ アプローチにより、完全な 8x H100 GPU ノードなどの静的なハードウェア予約が、大規模な推論モデルから低レイテンシの小規模なチャットモデルまで、多様なポートフォリオに対応できる柔軟なコンピューティング プールに変換されます。
プロトタイピングとベンチマーク調査
本番環境対応のオーケストレーターを開発する前に、モデルの共同ホスティングの理論的な効率を検証するため、包括的なベンチマーク調査を実施しました。このフェーズの目的は、vLLM のネイティブ並列処理を徹底的にテストし、モデルが同じシリコンを共有する場合の「干渉」の度合いを正確に定量化することでした。
並列処理の調査: 「クロスオーバー ポイント」を見つける
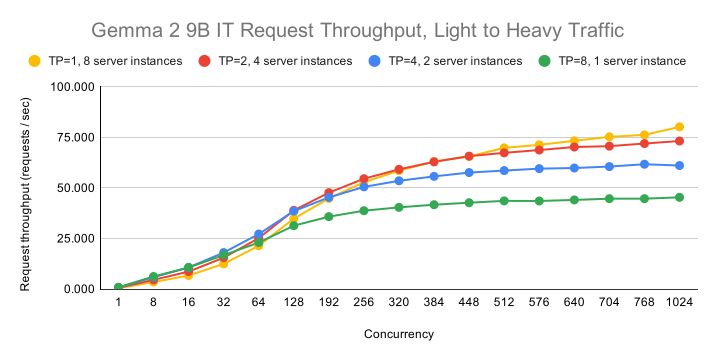
最初の分析では、vLLM のネイティブ Tensor Parallelism(TP)と、複数の vLLM サーバー インスタンスとしてのモデル インスタンスの Vertex 実装に焦点を当て、これらの戦略がさまざまなユーザー負荷とどのように相互作用するかを判断しました。最適な構成は同時実行に大きく依存することがわかりました。同時実行が少ない場合、高いテンソル並列処理(TP=8 など)を使用すると、利用可能なすべてのアクセラレータにレイヤを分散することで、個々のリクエストのレイテンシを最小限に抑えることができます。ただし、同時トラフィックが増加すると、ボトルネックがシフトします。高負荷条件下でスループットを最大化するには、最適な構成は TP=8 から TP=4、TP=2、最終的に TP=1 に移行し、同時に独立したモデル インスタンスの数を増やします。この移行により、低 TP 設定での GPU 間通信レイテンシの短縮によるメリットが、高 TP 実行の未加工の速度を上回る「クロスオーバー ポイント」が定義されます。以下に、Gemma 2 9B IT モデルのクロスオーバー ポイント グラフを示します。
最適なスケーリング: 単一モデル、マルチレプリカ
スケーラビリティの厳密なベースラインを確立するため、単一ノードで同じモデルの複数のインスタンスをサービングするベンチマークを実施しました。トラフィックが飽和状態(GPU あたり 2,048 個の同時リクエスト)の場合、8xH100 ノードで 8 つの独立した vLLM サーバー インスタンスを起動すると、単一 GPU のベースラインと比較して、レイテンシの低下がほぼゼロで、スループットが約 7.8 倍向上しました。
インフラストラクチャの比較: コンテナと Pod の共同スケジューリング
さらに、コンテナレベルのオーケストレーションを、ネイティブのインフラストラクチャ レベルのソリューション、特に Pod の共同スケジューリングと比較して評価しました。どちらのソリューションも、マルチレプリカ サービングで同等のパフォーマンスを発揮しましたが、最終的には、実用最小限の製品(MVP)にコンテナレベルのアプローチを選択しました。この決定は、コンテナレベルのソリューションが異種共同ホスティングに優れた柔軟性を提供し、デベロッパーが基盤となる Kubernetes スケジューリングの制約に縛られることなく、きめ細かくソフトウェア定義されたメモリ パーティションを使用して、異なるモデル アーキテクチャを並行して提供できるようにするために行われました。さらに、コンテナレベルのオーケストレーションにより、反復処理がはるかに高速になり、カスタマイズとイノベーションが容易になります。
干渉テスト: 異なるモデルの共同ホスティング
プロトタイピングの最後のマイルストーンは「干渉テスト」でした。このテストでは、Gemma-3n-E2B-it と Llama-3.1-8B-Instruct を同じ VM で共同ホストしました。各モデルに 0.4 の GPU メモリ パーティションを割り当てた場合、サービング パフォーマンスは単一モデルのベンチマークとほぼ同じでした。たとえば、Gemma-3n は、分離環境での 30.96 リクエストに対して、共同ホスト環境では 30.21 リクエストに達しました。これらの結果から、KV キャッシュの枯渇を防ぐためにメモリリソースが適切にパーティショニングされていれば、トラフィックが多い場合でも、共同ホストされたモデル間でコンピューティングの干渉がほとんどないことが確認できます。
MVP コンテナの実装
検証済みのベンチマークからプロダクション レディなシステムに移行するには、堅牢なコンテナ化されたオーケストレーターを構築する必要がありました。この開発フェーズでは、決定論的なリソース分離を確保しながら、複数のモデル ライフサイクルの複雑さを管理できる高レベルのソフトウェア レイヤの構築に重点を置きました。
モデルの共同ホスティング サーバーの設計
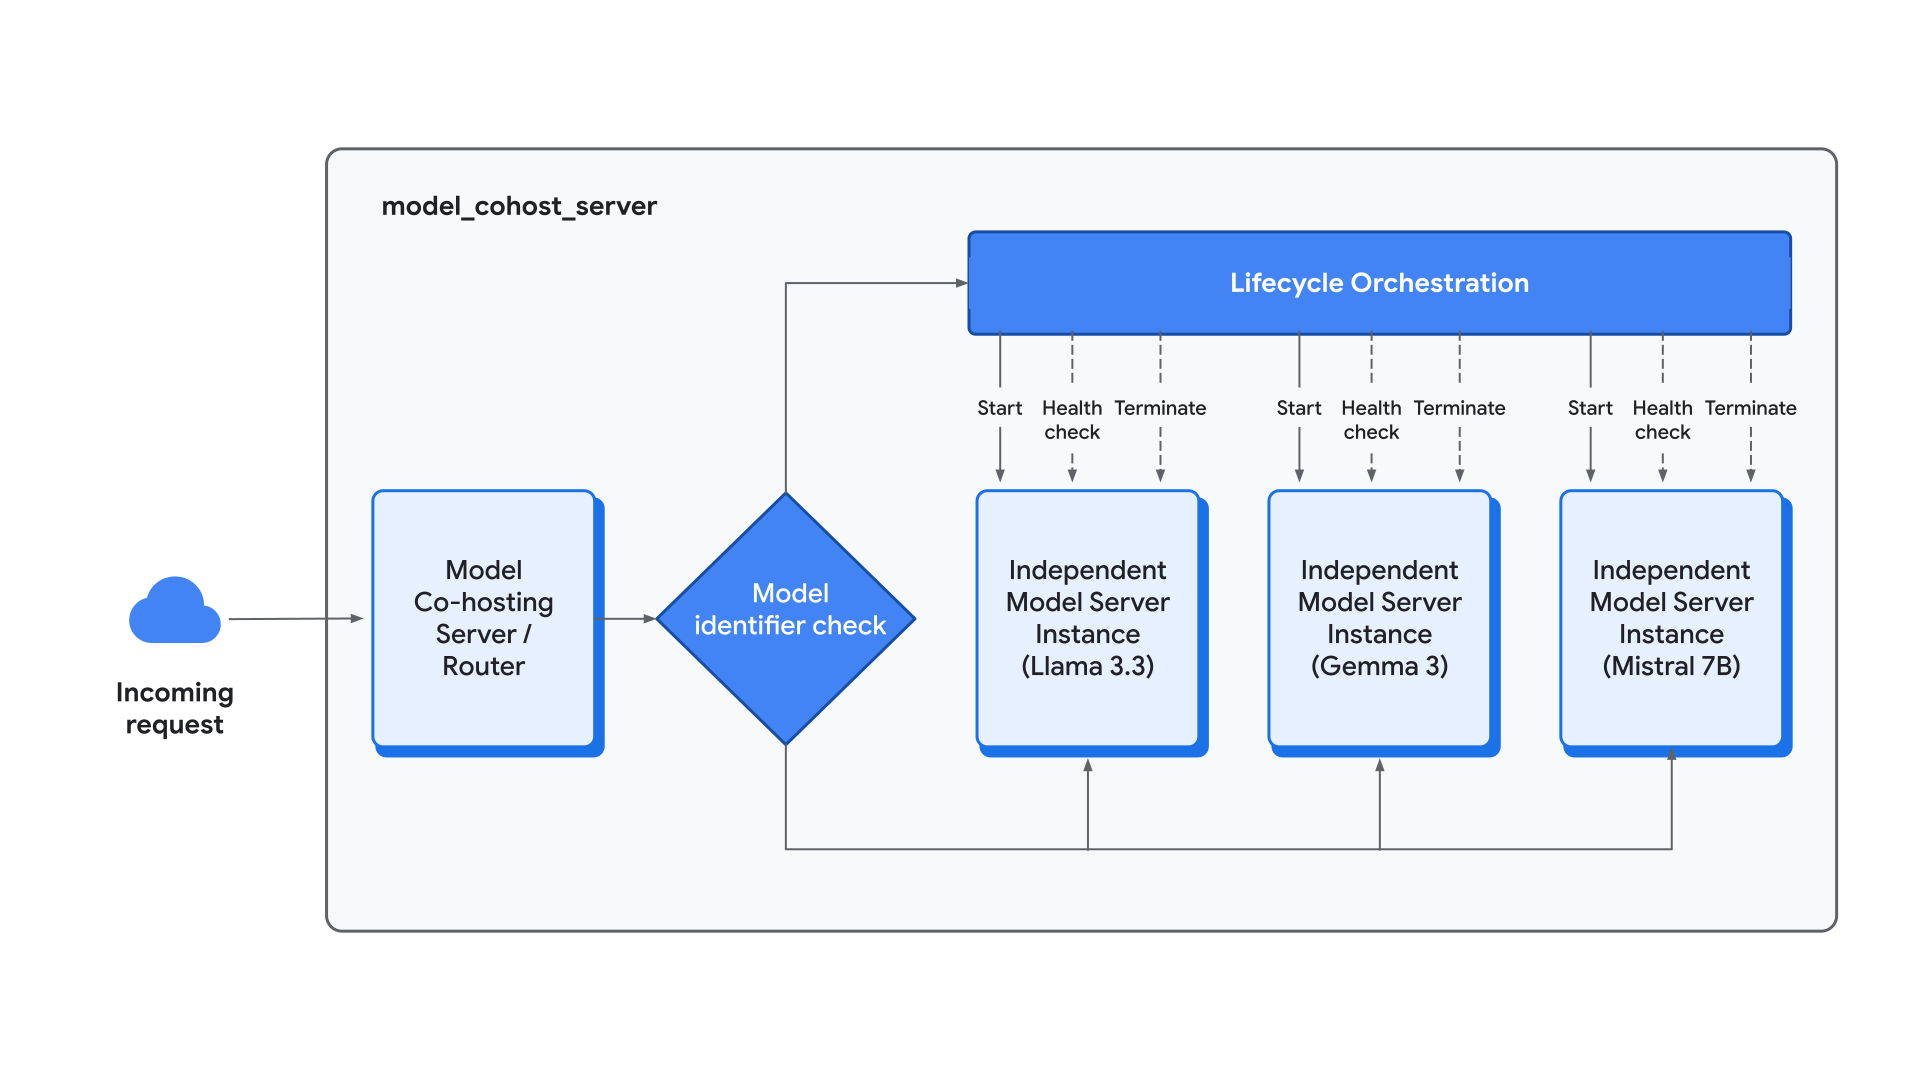
実装の中核となるのは、コンテナ内でマスター オーケストレーターとして機能するように設計されたカスタム エントリ ポイントである model_cohost_server です。このサーバーは、標準の単一プロセスモデルとは異なり、サブプロセス管理を実装しています。これにより、vLLM などの複数の独立したモデルサーバー インスタンスを、分離されたサブプロセスとして同時に実行できます。受信トラフィックを管理するために、オーケストレーターは高レベルのリクエスト ルーティングを使用します。--served-model-name などの引数を使用して一意のモデル ID でリクエストを識別し、対応する内部サーバー インスタンスに転送します。ルーティングに加えて、サーバーは包括的なライフサイクル オーケストレーションを提供し、すべての共同主催者インスタンスの初期化、ヘルス モニタリング、終了を管理します。この一元管理により、各サブプロセスの個別の運用境界を維持しながら、外部トラフィックに単一の統合エンドポイントを提供します。
GPU リソースのパーティショニング: 決定論的スライス
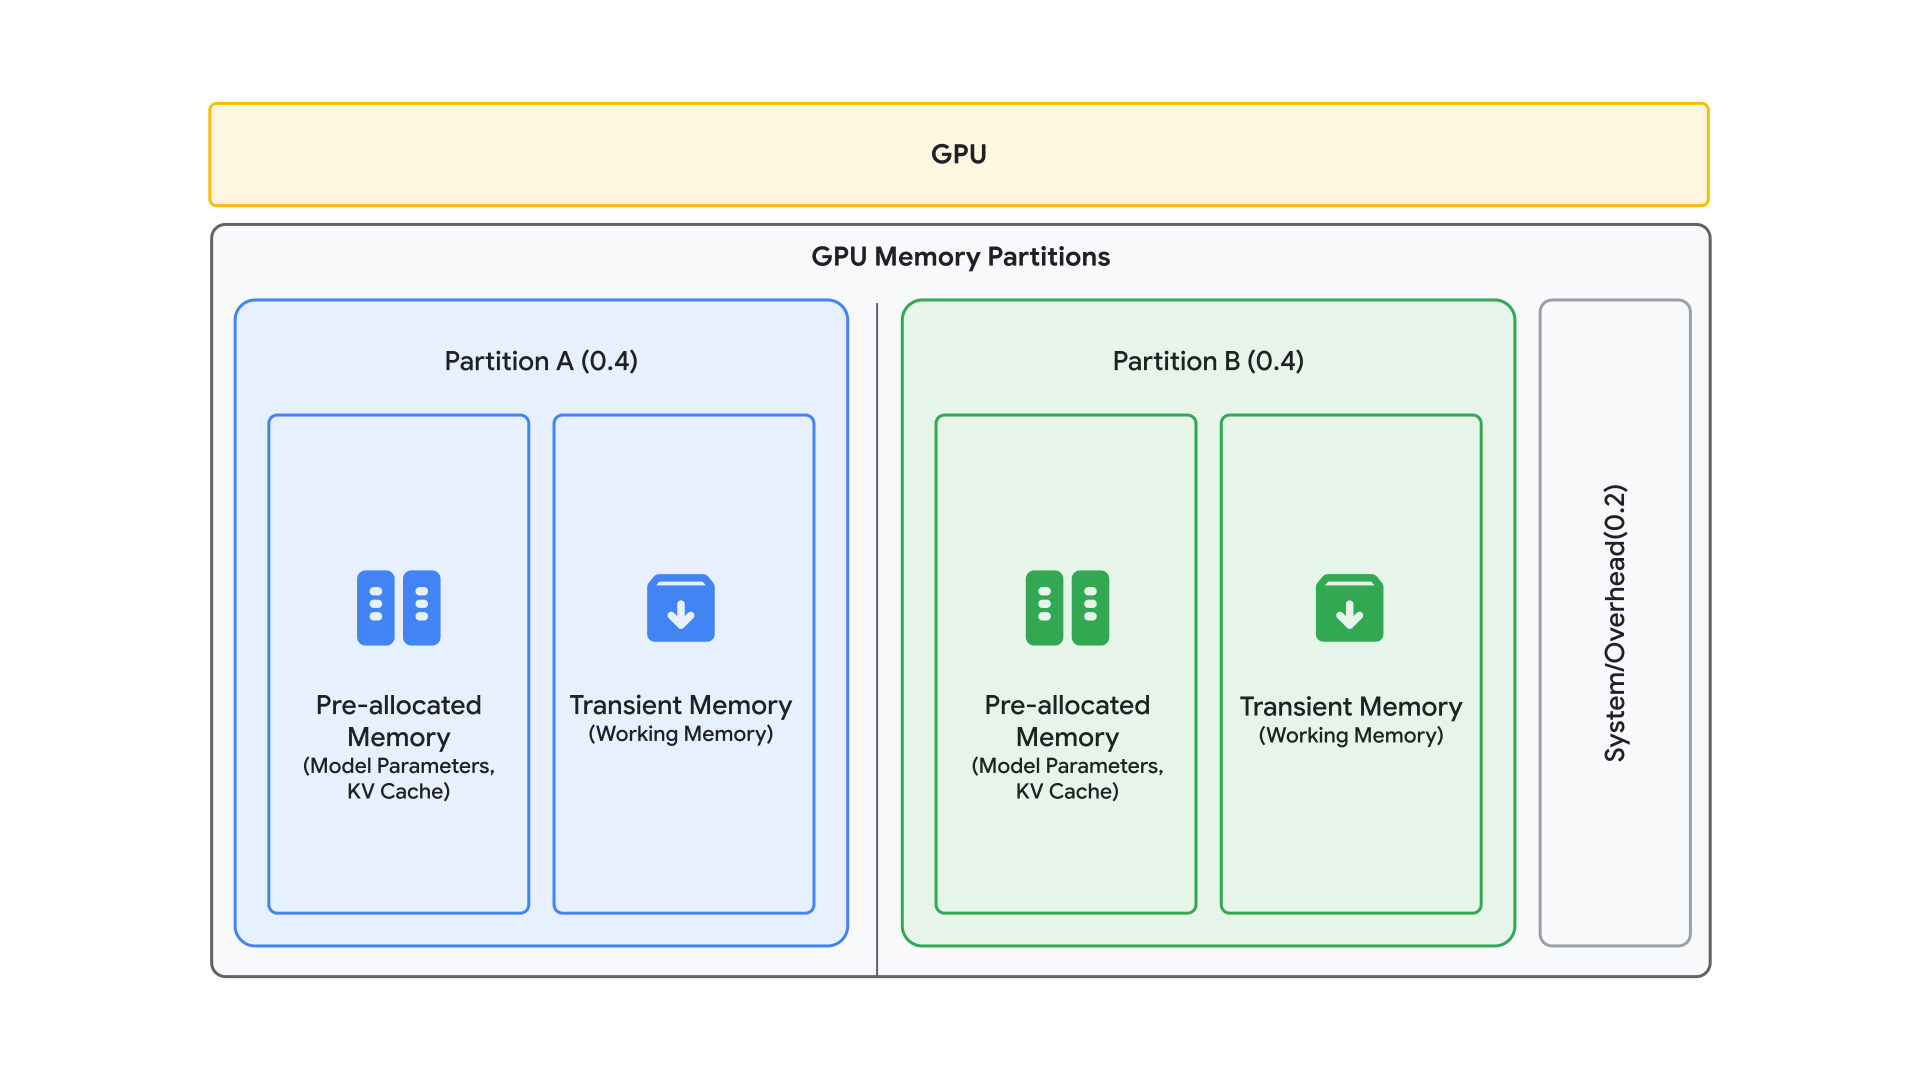
1 つのモデルのワークロードが、共同ホスト環境全体でメモリ不足(OOM)エラーを引き起こすリスクを排除するため、厳格なリソース スライシング メカニズムを実装しました。これは gpu-memory-partition 引数によって運用されます。これにより、デベロッパーは明示的なメモリ比率(0.4、0.4 など)を定義して、ノードの GPU メモリの合計の一定割合を個々のモデル インスタンスに予約できます。
この割り当てをガイドするために、「事前割り当てと一時的」メモリモデルを採用しています。このモデルでは、静的リソース要件と動的リソース要件を区別します。「事前割り当て」メモリは、モデルの重みと KV キャッシュに使用されるメモリで構成されます。モデルの重みに使用されるメモリ量は、モデルのパラメータ数と精度によって異なります。たとえば、BF16 の 8B パラメータ モデルには、約 16 GB の静的ストレージが必要です。KV キャッシュに使用されるメモリ量は、モデルのディメンション、精度、コンテキストの長さ、シーケンス数によって異なります。「一時」メモリは、中間計算と推論作業メモリで構成されます。gpu-memory-partition 引数は、「事前割り当て」メモリを考慮します。gpu-memory-partition の合計を 1.0 未満に設定して、「一時的な」メモリにバッファ領域を残すことをおすすめします。
製品化
Vertex AI を使用したモデルの共同ホスティングの製品化フェーズでは、単一モデルのマルチレプリカ構成とマルチモデル提供構成の両方で、シームレスで本番環境に対応した環境を確立することに専念しました。この移行により、経験的なベンチマーク結果が、簡素化されたデプロイ ワークフローと深く統合されたインフラストラクチャ サポート構造に効果的に変換されました。
デプロイ ワークフローの簡素化
高密度サービングの参入障壁を下げるため、既存の Vertex AI API とネイティブに統合されるカスタム コンテナ引数を使用して、共同ホスティング構成を標準化しました。8x H100 ノードなどのフルシェイプ仮想マシンの場合、ベンチマーク ユーティリティを開発して、特定のユースケースに最適なレシピをカスタマイズしました。これらのベンチマーク ユーティリティを使用すると、特定のパラメータ数とモデルの精度に基づいて、テンソル並列処理(TP)、パイプライン並列処理(PP)、モデル インスタンスの数を自動的にバランスさせる構成を見つけることができます。これは、堅牢な Deployment API サポートによって補完され、開発者は、正確な GPU メモリ パーティションを含むこれらのきめ細かいパラメータを標準の deployModel リクエスト内で直接指定してモデルをデプロイできます。
動的なマルチモデル サービング
技術的な取り組みにおける大きな進歩は、静的構成から動的サービング アーキテクチャへの移行でした。この機能は、トラフィック パターンが急速に変化する本番環境にとって重要です。コンテナを完全に再起動せずにモデルを読み込みまたはアンロードできることは、インフラストラクチャのアジリティと高可用性を維持するために不可欠です。
Dynamic Update API(update_models)
不変デプロイ固有の制限に対処するため、Vertex Model Garden vLLM モデル共同ホスティング コンテナ内に専用のモデル更新 API を実装しました。この API はホット リロードを容易にし、Google Cloud Storage(GCS)バケットに保存されている一元化された構成ファイルに基づいて、サーバーがホストされているモデルのポートフォリオをオンザフライで調整できるようにします。
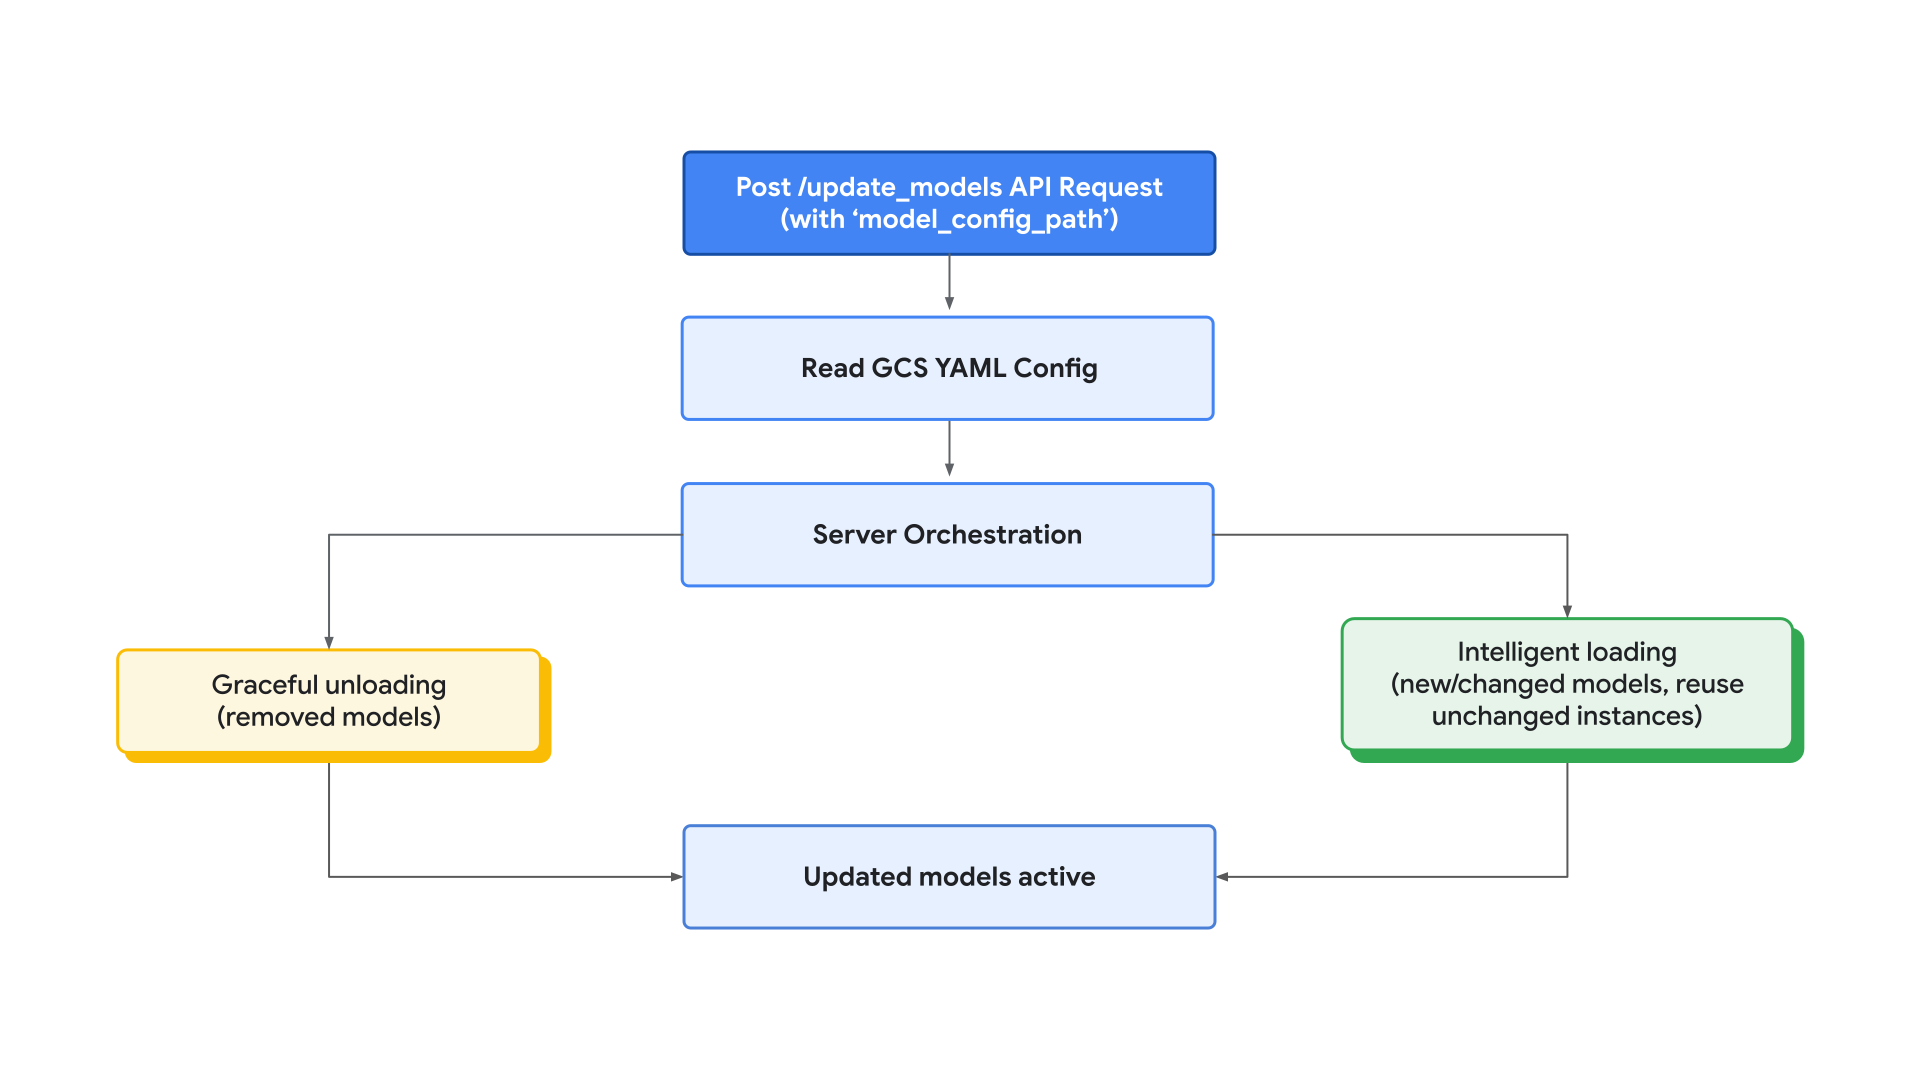
更新プロセスは、update_models エンドポイントへの POST リクエストを介して開始されます。このリクエストには、GCS YAML ファイルを指す model_config_path が含まれます。このリクエストを受信すると、サーバーは、ダウンタイムを最小限に抑えるように最適化された多段階のオーケストレーション シーケンスを実行します。
- グレースフル アンロード: システムは、新しい構成に存在しないモデルを特定し、最初にそのサブプロセスを終了して、GPU メモリとコンピューティング リソースをすぐに再利用します。
- インテリジェントな読み込みと再利用: サーバーは新しいモデル インスタンスを初期化します。重要なのは、モデルの並列処理設定(テンソル並列処理(TP)やパイプライン並列処理(PP)など)と割り当てられたメモリ パーティションが変更されない場合、オーケストレーターは既存の実行中のインスタンスを再利用することです。この最適化により、コストのかかる再初期化フェーズが回避され、構成の変更中にアクティブなサービスが中断されることがなくなります。
レイテンシとパフォーマンスの分析
これらの更新戦略の経験的分析により、動的なホット リロードは、大規模な LLM サービングに一般的に関連する「コールド スタート」ペナルティを大幅に軽減することが明らかになりました。
まとめ
Vertex AI を使用したモデルの共同ホスティングは、根本的なパラダイム シフトを表しています。つまり、ハードウェアを多用するモノリシックなデプロイから、流動的で効率的なサービング アーキテクチャへの移行です。「1 つの VM に 1 つのモデル」という標準から高密度コンピューティング プールモデルに移行することで、組織はパフォーマンス ベンチマークを維持(多くの場合、改善)しながら、総所有コスト(TCO)を大幅に削減できます。
Google のエンジニアリングの取り組みと広範なマルチモデル ベンチマーク調査により、このアーキテクチャに関する一連の明確な本番環境ガイドラインが確立されました。
- 万能な構成はありません。Google は、特定のユースケース(モデル、ハードウェア、トラフィック)に最適なサービング レシピを見つけることを推奨し、そのためのツールを構築しています。
- レプリカによるスループットのスケーリング。
- ハードウェアの境界を破り、よりきめ細かいレベルでメモリを分割することで、リソースの使用率を改善します。
共同ホスト アーキテクチャを正常に実装するには、次の技術ワークフローをおすすめします。
- 明示的なパーティショニング:
--gpu-memory-partitions引数を使用して、個々のモデルにメモリリソースを割り当てます。 - 反復ベンチマーク: 提供されているベンチマーク ユーティリティを使用して、ワークロードの特定の「同時実行クロスオーバー」ポイント(インスタンス数、TP、PP の「スイート スポット」構成)を特定します。
Google Cloud Model Garden での共同ホスティングの実装は、高密度 AI アプリケーションを構築するためのスケーラブルなブループリントとなります。デベロッパーは、これらの機能を試し、提供されているチュートリアル ノートブックを使用してベンチマークを再現し、特定のエンタープライズ要件に合わせてサービング構成を最適化することをおすすめします。
最後までお読みいただきありがとうございました
Vertex AI に関するご意見やご質問をお待ちしております。
謝辞
Google Cloud Vertex AI チームに心より感謝申し上げます。特に、このプロジェクト全体を通してリーダーシップとガイダンスを提供してくれた Bo Wu と Ting Yu、そして貴重な貢献をしてくれた Deborah He、Shawn Ma、Desmond Liu、Yang Pan、Surya K G Tangatur、Luis Rizo に感謝します。