

Dalam lanskap model bahasa besar (LLM) yang terus berkembang, pola deployment "satu model per mesin" menjadi bottleneck yang signifikan bagi efisiensi biaya penyajian LLM di perusahaan. LLM sering kali memerlukan reservasi hardware yang besar, seperti node GPU 8x H100 penuh, untuk mengelola beban puncak. Namun, selama operasi standar, resource yang mahal ini sering kali kurang dimanfaatkan, sehingga menyebabkan total biaya kepemilikan (TCO) yang tinggi.
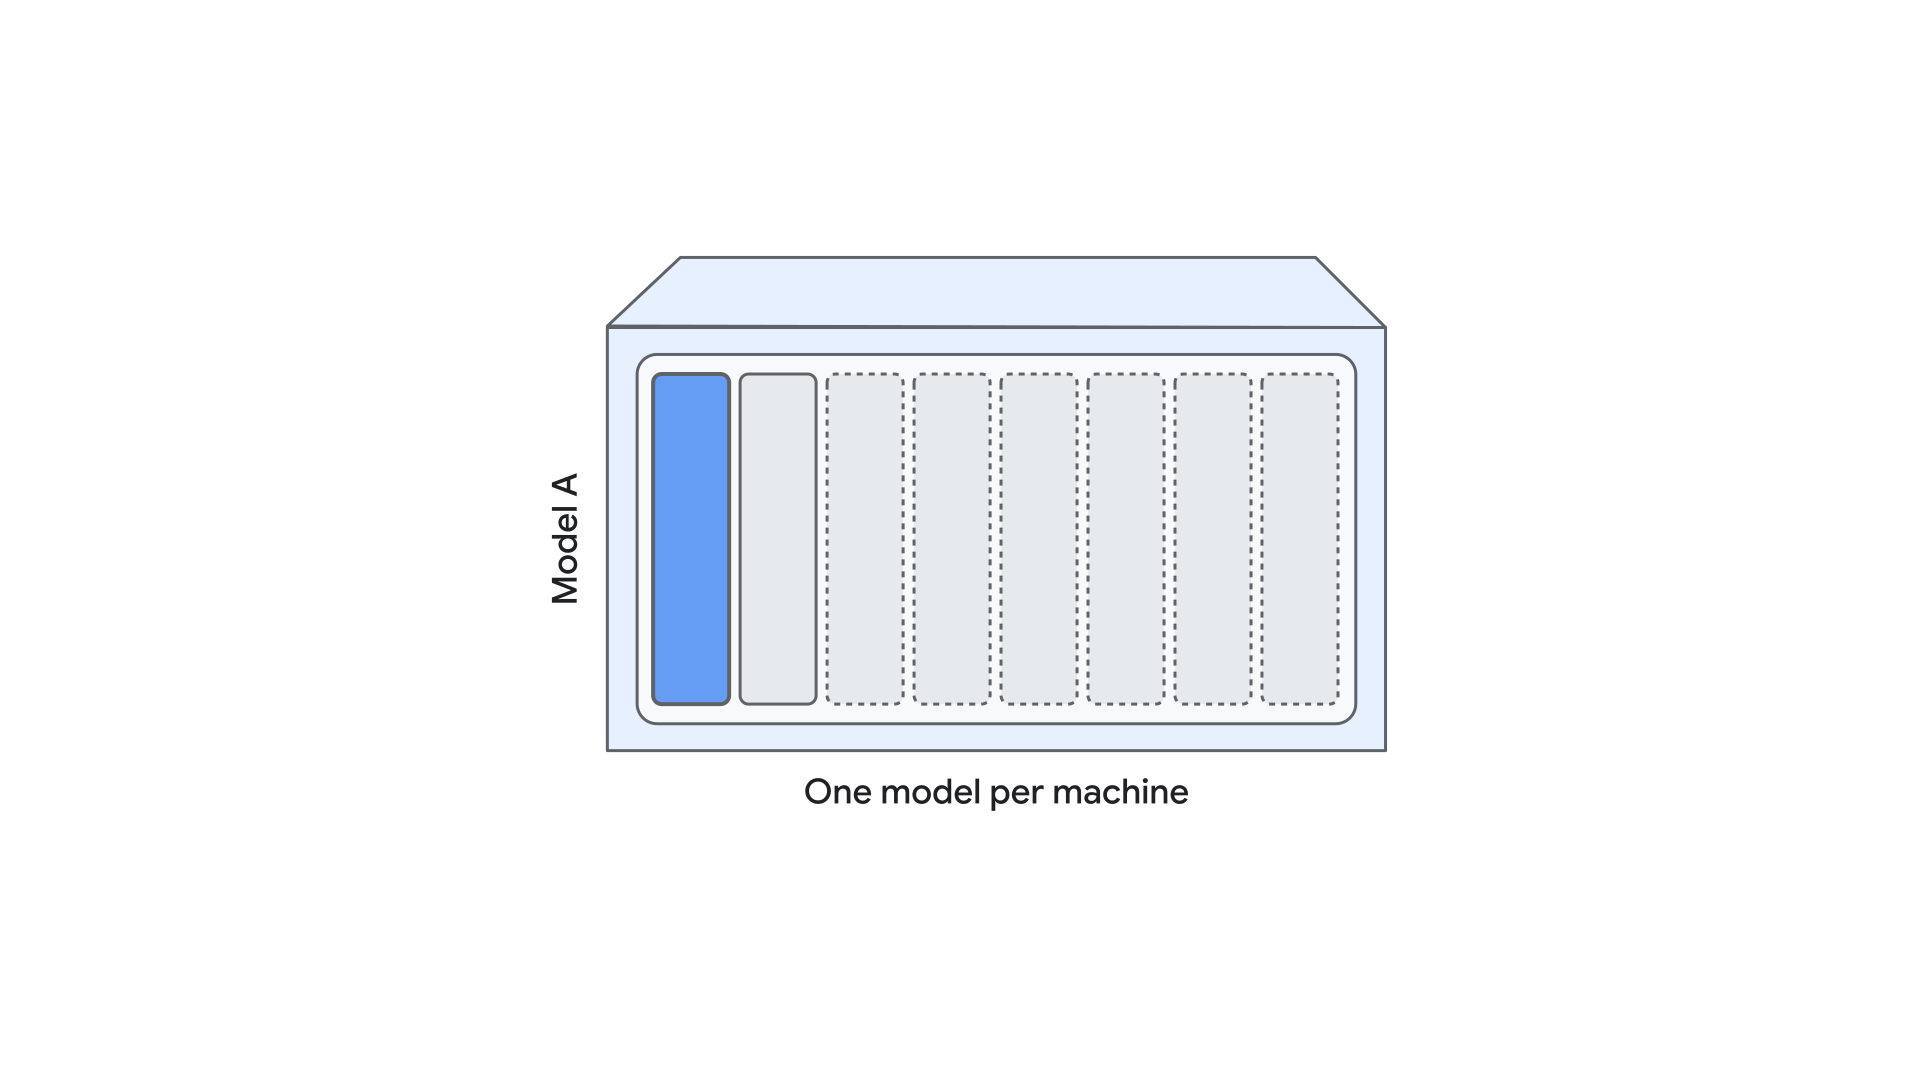
Co-hosting model mengatasi kesenjangan efisiensi ini dengan memungkinkan beberapa instance model berbagi resource virtual machine dan GPU yang sama. Hal ini mencakup model yang sepenuhnya berbeda, seperti Llama 3.3 dan Gemma 3. Dengan memanfaatkan pemisahan memori sub-GPU dan partisi resource yang cerdas, Vertex AI Model Garden mengubah reservasi hardware statis menjadi pool komputasi yang fleksibel dan berdensitas tinggi.

Blog teknis ini menjelaskan secara mendetail proses Vertex AI Engineering dalam menghadirkan co-hosting model ke layanan cloud yang siap produksi. Kami akan membagikan metodologi kami untuk strategi implementasi tingkat container, mengidentifikasi konfigurasi penyajian yang optimal, dan temuan penting dari studi tolok ukur multi-model kami yang ekstensif, sehingga Anda dapat memaksimalkan efisiensi biaya penyajian LLM.
Memahami hosting bersama model: konsep dan arsitektur
Hosting bersama model adalah strategi penyajian dengan kepadatan tinggi yang memungkinkan beberapa instance model bahasa besar (LLM) atau arsitektur model yang berbeda untuk berbagi resource hardware fisik yang sama dalam satu virtual machine (VM). Tidak seperti model deployment tradisional yang mendedikasikan VM atau GPU penuh untuk satu model, co-hosting menggunakan partisi resource terperinci untuk memaksimalkan ROI hardware dan meningkatkan pemanfaatan memori dan resource komputasi.
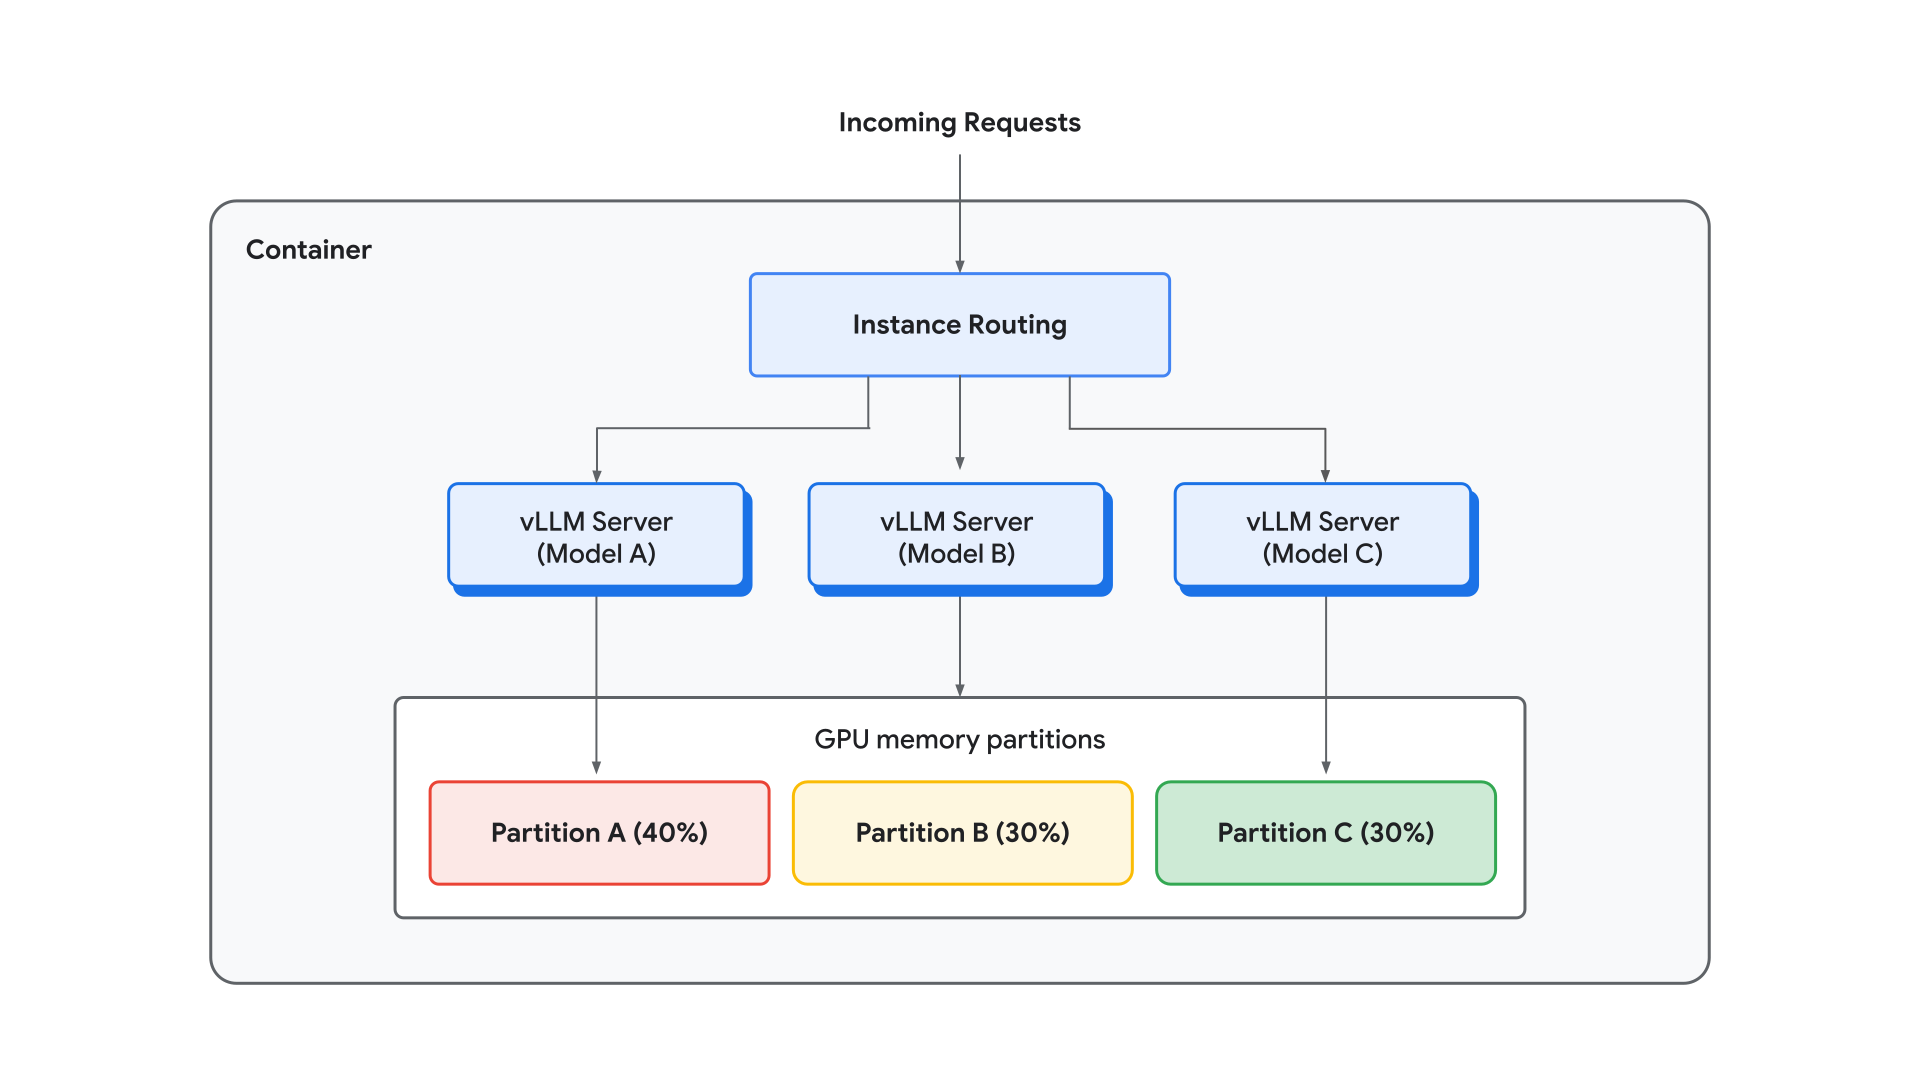
Implementasi kami berfokus pada solusi tingkat container yang memungkinkan penayangan beberapa model secara bersamaan dengan konfigurasi independen. Arsitektur ini beroperasi melalui beberapa mekanisme teknis terintegrasi, dimulai dengan deployment beberapa instance server model independen dalam satu container. Setiap instance ini berfungsi sebagai salinan lengkap dan independen dari server model, yang memungkinkan pemrosesan permintaan secara simultan di seluruh virtual machine. Untuk mengelola traffic ini, kami menerapkan lapisan perutean instance dalam container yang mendistribusikan permintaan masuk secara efisien di antara instance yang aktif.
Desain ini memberikan paralelisme terperinci dengan memungkinkan setiap model yang di-co-host menggunakan konfigurasi inferensi khusus, yang menampilkan setelan unik untuk Tensor Parallelism (TP), Pipeline Parallelism (PP), dan jumlah instance model tertentu. Hal ini dilengkapi dengan pemisahan resource, di mana partisi memori GPU tertentu ditetapkan ke setiap model—seperti partisi memori GPU 0,4 per model—untuk memastikan bahwa beragam workload dapat berjalan bersama di akselerator yang sama tanpa saling menghabiskan resource memori penting. Pendekatan arsitektur ini mengubah reservasi hardware statis, seperti node GPU 8x H100 penuh, menjadi kumpulan komputasi fleksibel yang mampu melayani beragam portofolio—mulai dari model penalaran besar hingga model chat kecil dengan latensi rendah.
Studi pembuatan prototipe dan tolok ukur
Sebelum mengembangkan orchestrator yang siap produksi, kami melakukan studi tolok ukur yang komprehensif untuk memvalidasi efisiensi teoretis dari hosting bersama model. Fase ini bertujuan untuk menguji secara menyeluruh paralelisme native vLLM dan mengukur secara tepat tingkat "interferensi" saat model berbagi silikon yang sama.
Investigasi paralelisme: Menemukan "titik persilangan"
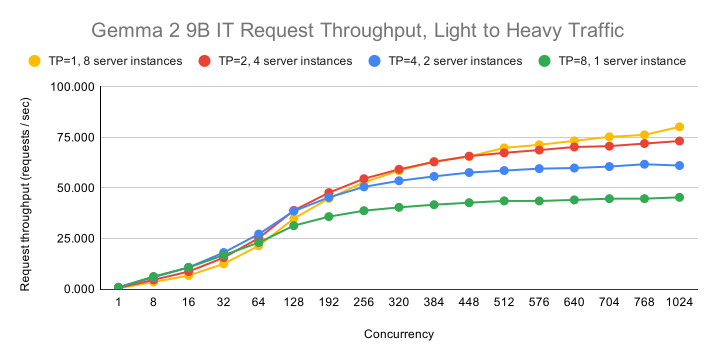
Analisis awal kami berfokus pada Paralelisme Tensor (TP) native vLLM dan implementasi Vertex dari instance model sebagai beberapa instance server vLLM untuk menentukan cara strategi ini berinteraksi dengan berbagai beban pengguna. Kami menemukan bahwa konfigurasi yang optimal sangat bergantung pada konkurensi; pada konkurensi yang lebih rendah, Tensor Parallelism yang tinggi (misalnya, TP=8) memberikan latensi terendah untuk setiap permintaan dengan mendistribusikan lapisan di semua akselerator yang tersedia. Namun, seiring meningkatnya traffic serentak, bottleneck akan bergeser. Untuk memaksimalkan throughput dalam kondisi beban tinggi, konfigurasi yang optimal beralih dari TP=8 ke TP=4, TP=2, dan akhirnya TP=1, sekaligus meningkatkan jumlah instance model independen. Transisi ini menentukan "titik persilangan" saat manfaat pengurangan latensi komunikasi antar-GPU dalam penyiapan TP rendah lebih besar daripada kecepatan mentah eksekusi TP tinggi. Berikut ini adalah diagram titik persilangan dengan model Gemma 2 9B IT.
Penskalaan optimal: Model tunggal, multi-replika
Untuk menetapkan dasar pengukuran yang ketat untuk skalabilitas, kami melakukan tolok ukur penyajian beberapa instance model yang sama pada satu node. Dalam kondisi traffic jenuh (2048 permintaan serentak per GPU), meluncurkan delapan instance server vLLM independen pada node 8xH100 menghasilkan peningkatan throughput sekitar 7,8 kali lipat dengan regresi latensi hampir nol dibandingkan dengan dasar pengukuran GPU tunggal.
Perbandingan infrastruktur: Penjadwalan bersama container vs. pod
Kami mengevaluasi lebih lanjut orkestrasi tingkat container kami terhadap solusi tingkat infrastruktur native, khususnya penjadwalan bersama Pod. Meskipun kedua solusi memberikan performa yang sebanding untuk inferensi multi-replika, kami akhirnya memilih pendekatan tingkat container untuk produk dengan kelayakan minimum (MVP) kami. Keputusan ini didorong oleh fleksibilitas superior yang ditawarkan solusi tingkat container untuk hosting bersama yang heterogen, sehingga developer dapat menyajikan berbagai arsitektur model secara berdampingan dengan partisi memori terperinci yang ditentukan software dan tidak dibatasi oleh batasan penjadwalan Kubernetes yang mendasarinya. Selain itu, orkestrasi tingkat container memungkinkan iterasi yang jauh lebih cepat dan lebih mudah untuk disesuaikan dan diinovasikan.
Pengujian interferensi: Co-hosting berbagai model
Tonggak pencapaian pembuatan prototipe terakhir adalah "Uji Interferensi", tempat kami menghosting bersama Gemma-3n-E2B-it dan Llama-3.1-8B-Instruct di VM yang sama. Dengan setiap model yang diberi partisi memori GPU 0,4, performa inferensi tetap hampir sama dengan tolok ukur model tunggal. Misalnya, Gemma-3n mencapai 30,21 reqs dalam lingkungan yang dihosting bersama dibandingkan dengan 30,96 reqs dalam isolasi. Hasil ini mengonfirmasi bahwa hampir tidak ada gangguan komputasi antara model yang dihosting bersama, bahkan dalam kondisi traffic yang padat, asalkan resource memori dipartisi dengan tepat untuk mencegah kelaparan KV cache.
Implementasi container MVP
Transisi dari benchmark yang divalidasi ke sistem yang siap produksi memerlukan rekayasa orchestrator dalam container yang tangguh. Fase pengembangan ini berfokus pada pembuatan lapisan software tingkat tinggi yang mampu mengelola kompleksitas beberapa siklus proses model sekaligus memastikan isolasi resource deterministik.
Desain server co-hosting model
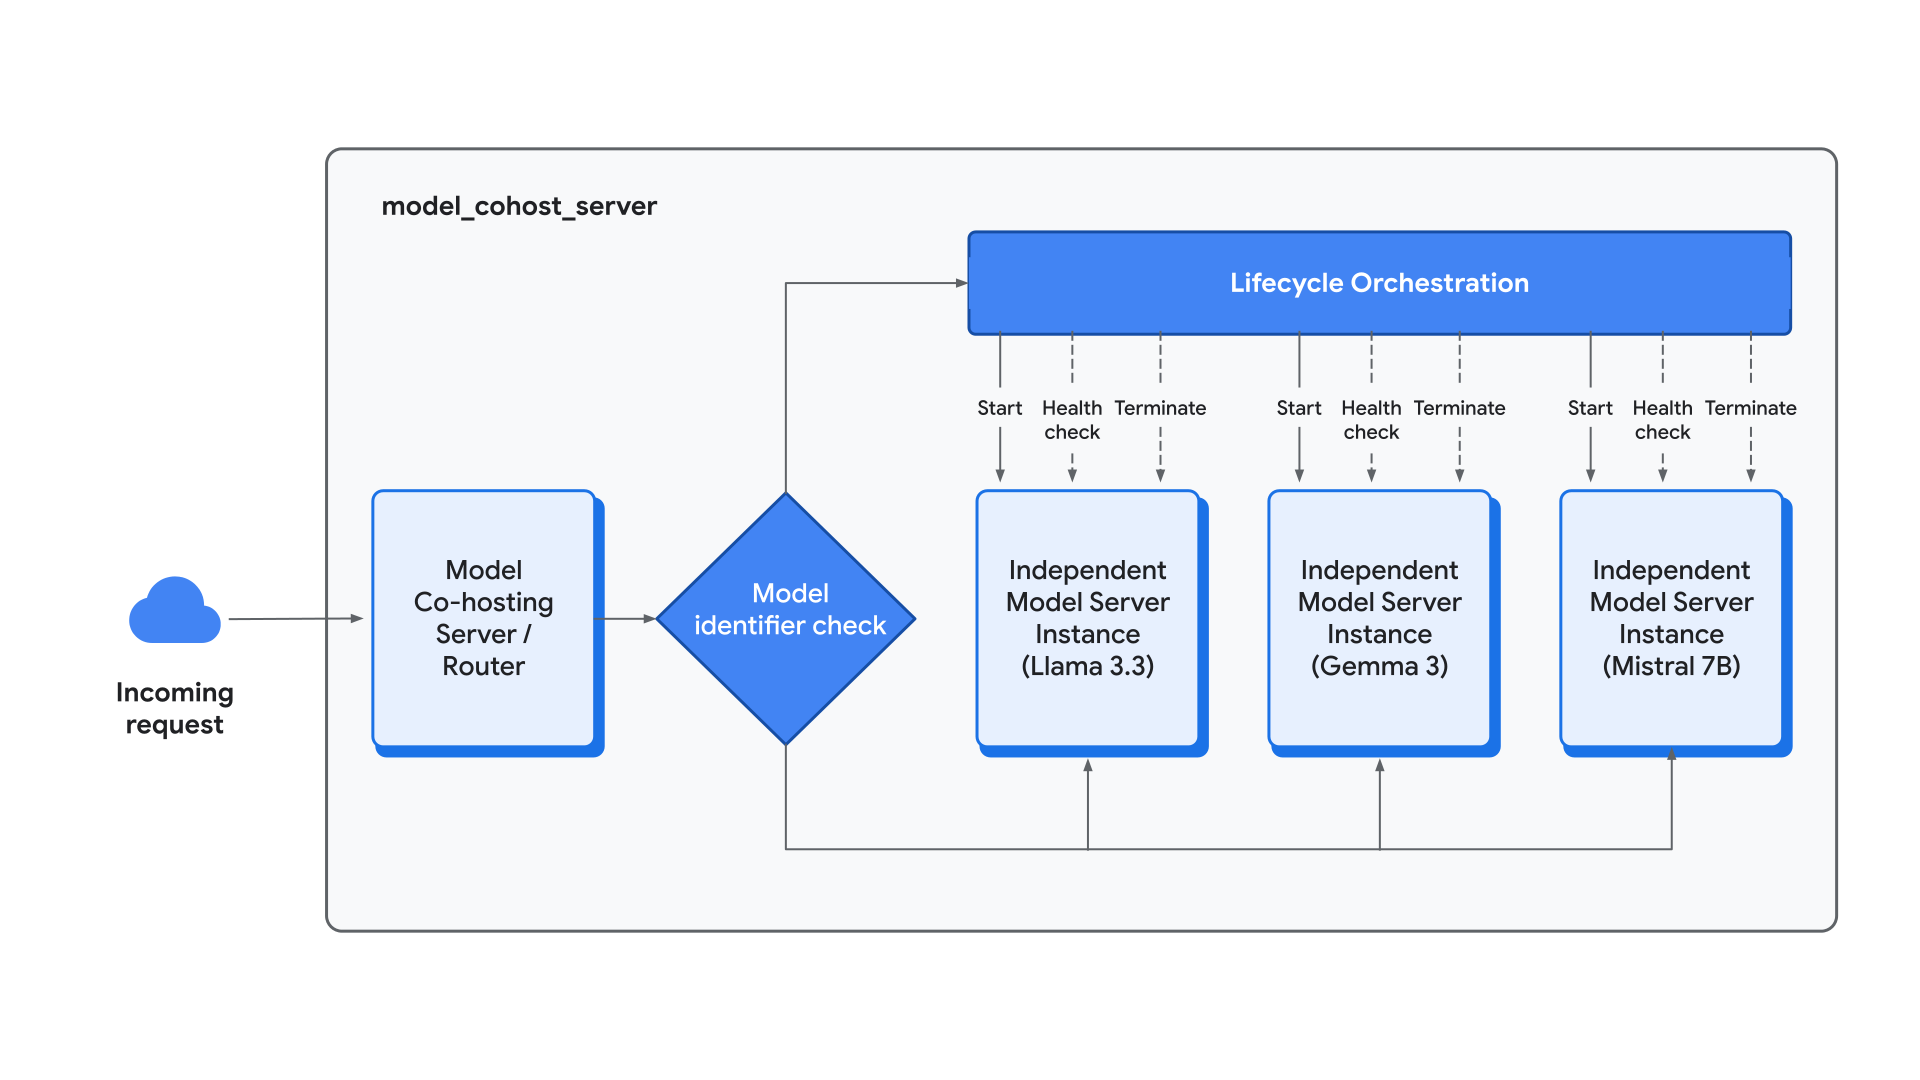
Inti dari implementasi kami adalah model_cohost_server, titik entri kustom yang dirancang untuk bertindak sebagai orchestrator master dalam container. Berbeda
dari model proses tunggal standar, server ini menerapkan pengelolaan
subproses, yang memfasilitasi eksekusi serentak beberapa instance server model
independen—seperti vLLM—sebagai subproses yang terisolasi. Untuk mengelola
traffic masuk, orchestrator menggunakan pemilihan rute permintaan tingkat tinggi,
mengidentifikasi permintaan berdasarkan ID model uniknya melalui argumen seperti
--served-model-name dan mengarahkannya ke instance server internal
yang sesuai. Selain pemilihan rute, server menyediakan orkestrasi siklus proses yang komprehensif, mengelola inisialisasi, pemantauan kondisi, dan penghentian semua instance yang dihosting bersama. Pengelolaan terpusat ini menyediakan endpoint tunggal dan terpadu untuk traffic eksternal sekaligus mempertahankan batas operasional yang berbeda dari setiap subproses.
Partisi resource GPU: Pemisahan deterministik
Untuk menghilangkan risiko workload satu model yang memicu error Kehabisan Memori
(OOM) di seluruh lingkungan yang dihosting bersama, kami menerapkan mekanisme pemisahan resource
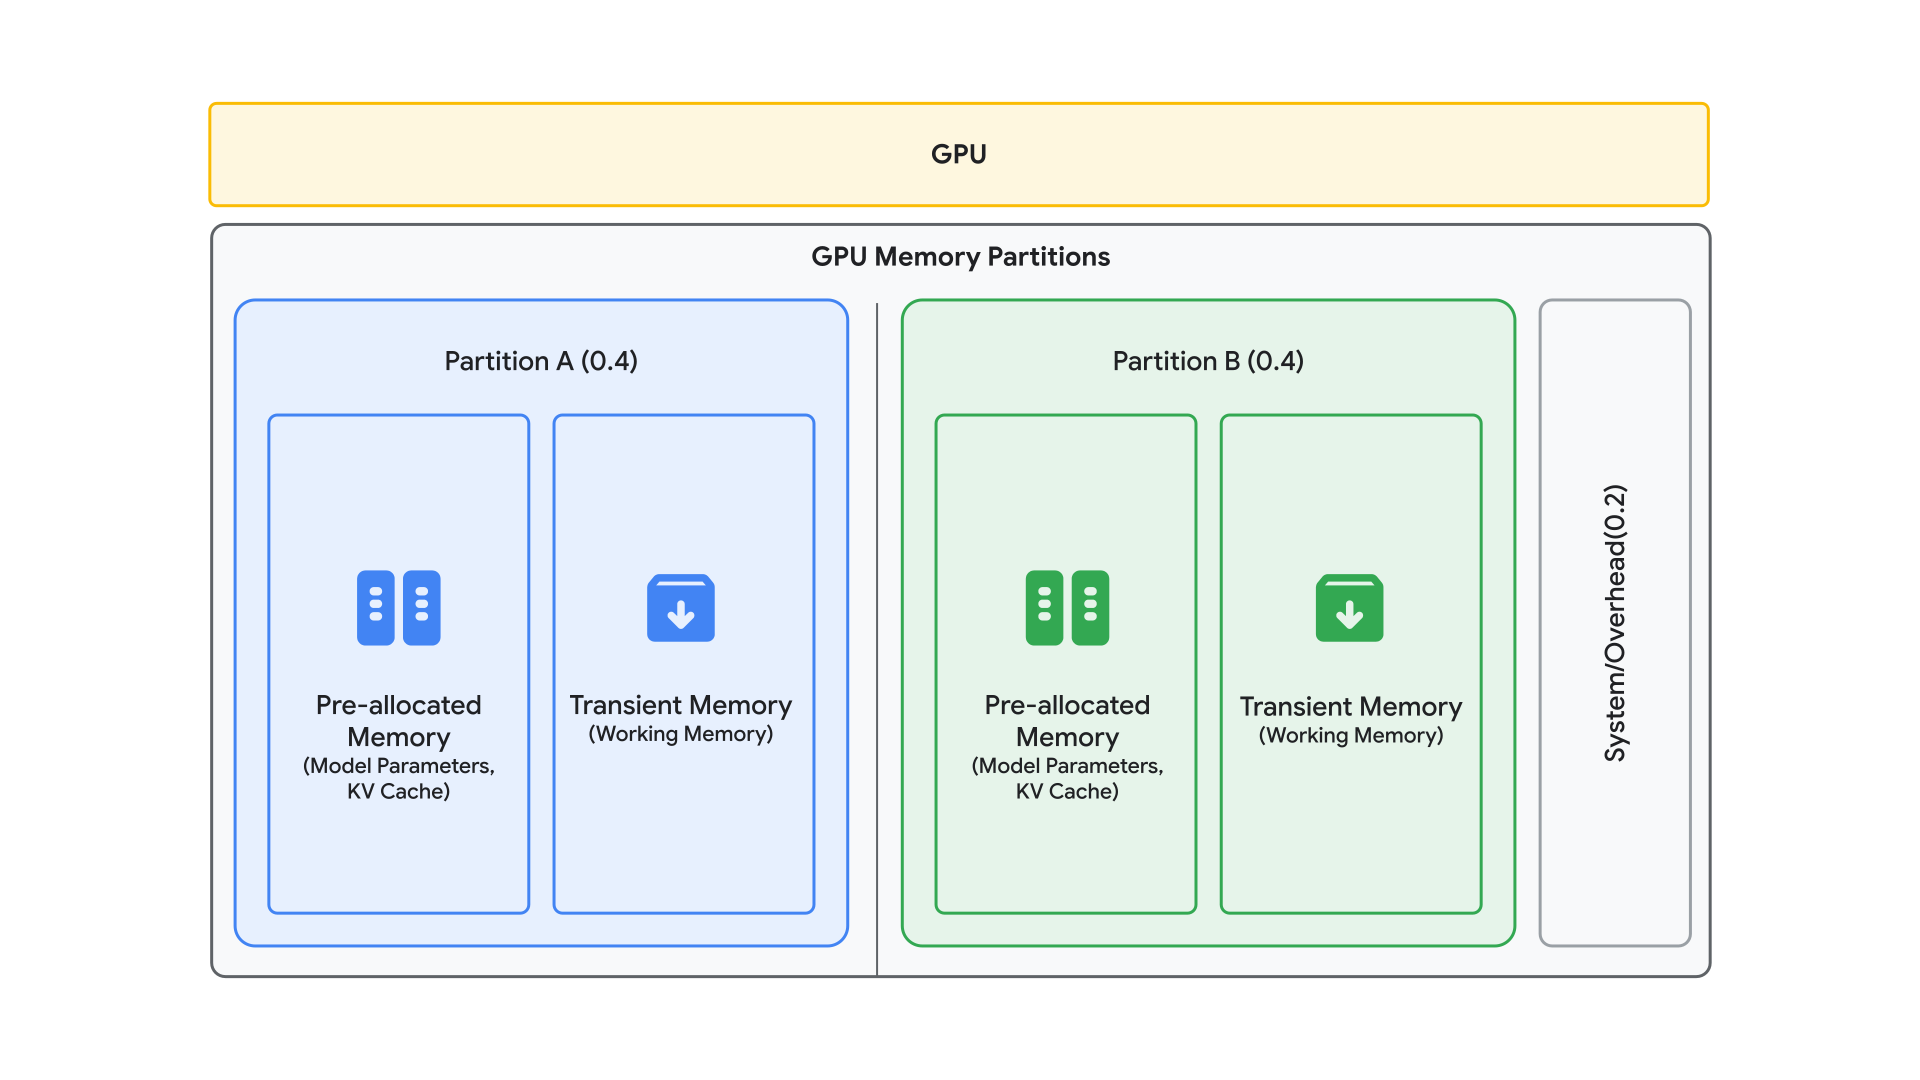
yang ketat. Hal ini dioperasionalkan melalui argumen gpu-memory-partition, yang memungkinkan developer menentukan rasio memori eksplisit (misalnya, 0,4, 0,4) untuk mencadangkan persentase tetap dari total memori GPU node untuk setiap instance model individual.
Untuk memandu alokasi ini, kami mengadopsi model memori "Dialokasikan sebelumnya vs. Sementara", yang membedakan antara persyaratan resource statis dan dinamis.
Memori "yang telah dialokasikan" terdiri dari memori yang digunakan untuk bobot model dan cache KV. Jumlah memori yang digunakan untuk bobot model bergantung pada jumlah parameter dan presisi model. Misalnya, model parameter 8B di BF16
memerlukan penyimpanan statis sekitar 16 GB. Jumlah memori yang digunakan untuk
cache KV bergantung pada dimensi model, presisi, panjang konteks, dan jumlah
urutan. Memori "sementara" terdiri dari komputasi perantara dan
memori kerja inferensi. Argumen gpu-memory-partition memperhitungkan memori yang "telah dialokasikan sebelumnya". Sebaiknya sediakan ruang buffer untuk memori "sementara"
dengan menetapkan jumlah gpu-memory-partition agar lebih kecil dari 1,0.
Produksisasi
Fase produksi co-hosting model dengan Vertex AI didedikasikan untuk membangun lingkungan yang lancar dan siap produksi untuk konfigurasi penyajian multi-replika model tunggal dan multi-model. Transisi ini secara efektif menerjemahkan temuan tolok ukur empiris menjadi alur kerja deployment yang disederhanakan dan struktur dukungan infrastruktur yang terintegrasi secara mendalam.
Alur kerja deployment yang disederhanakan
Untuk menurunkan hambatan masuk untuk penyaluran kepadatan tinggi, kami menstandarkan konfigurasi hosting bersama menggunakan argumen container kustom yang terintegrasi secara native dengan Vertex AI API yang ada. Untuk mesin virtual bentuk penuh, seperti node 8x H100, kami mengembangkan utilitas tolok ukur untuk menyesuaikan resep terbaik bagi kasus penggunaan spesifik Anda. Utilitas tolok ukur ini akan memungkinkan Anda menemukan konfigurasi yang secara otomatis menyeimbangkan Tensor Parallelism (TP), Pipeline Parallelism (PP), dan jumlah instance model berdasarkan jumlah parameter dan presisi model tertentu. Hal ini dilengkapi dengan dukungan Deployment API yang kuat, sehingga developer dapat menentukan parameter terperinci ini—termasuk partisi memori GPU yang tepat—langsung dalam permintaan deployModel standar dan men-deploy model.
Penyajian multi-model dinamis
Kemajuan signifikan dalam perjalanan teknis kami adalah transisi dari konfigurasi statis ke arsitektur penyaluran dinamis. Kemampuan ini sangat penting untuk lingkungan produksi yang ditandai dengan pola traffic yang berubah dengan cepat, karena kemampuan untuk memuat atau menghapus model tanpa memulai ulang container secara penuh sangat penting untuk menjaga fleksibilitas infrastruktur dan ketersediaan tinggi.
Dynamic Update API (update_models)
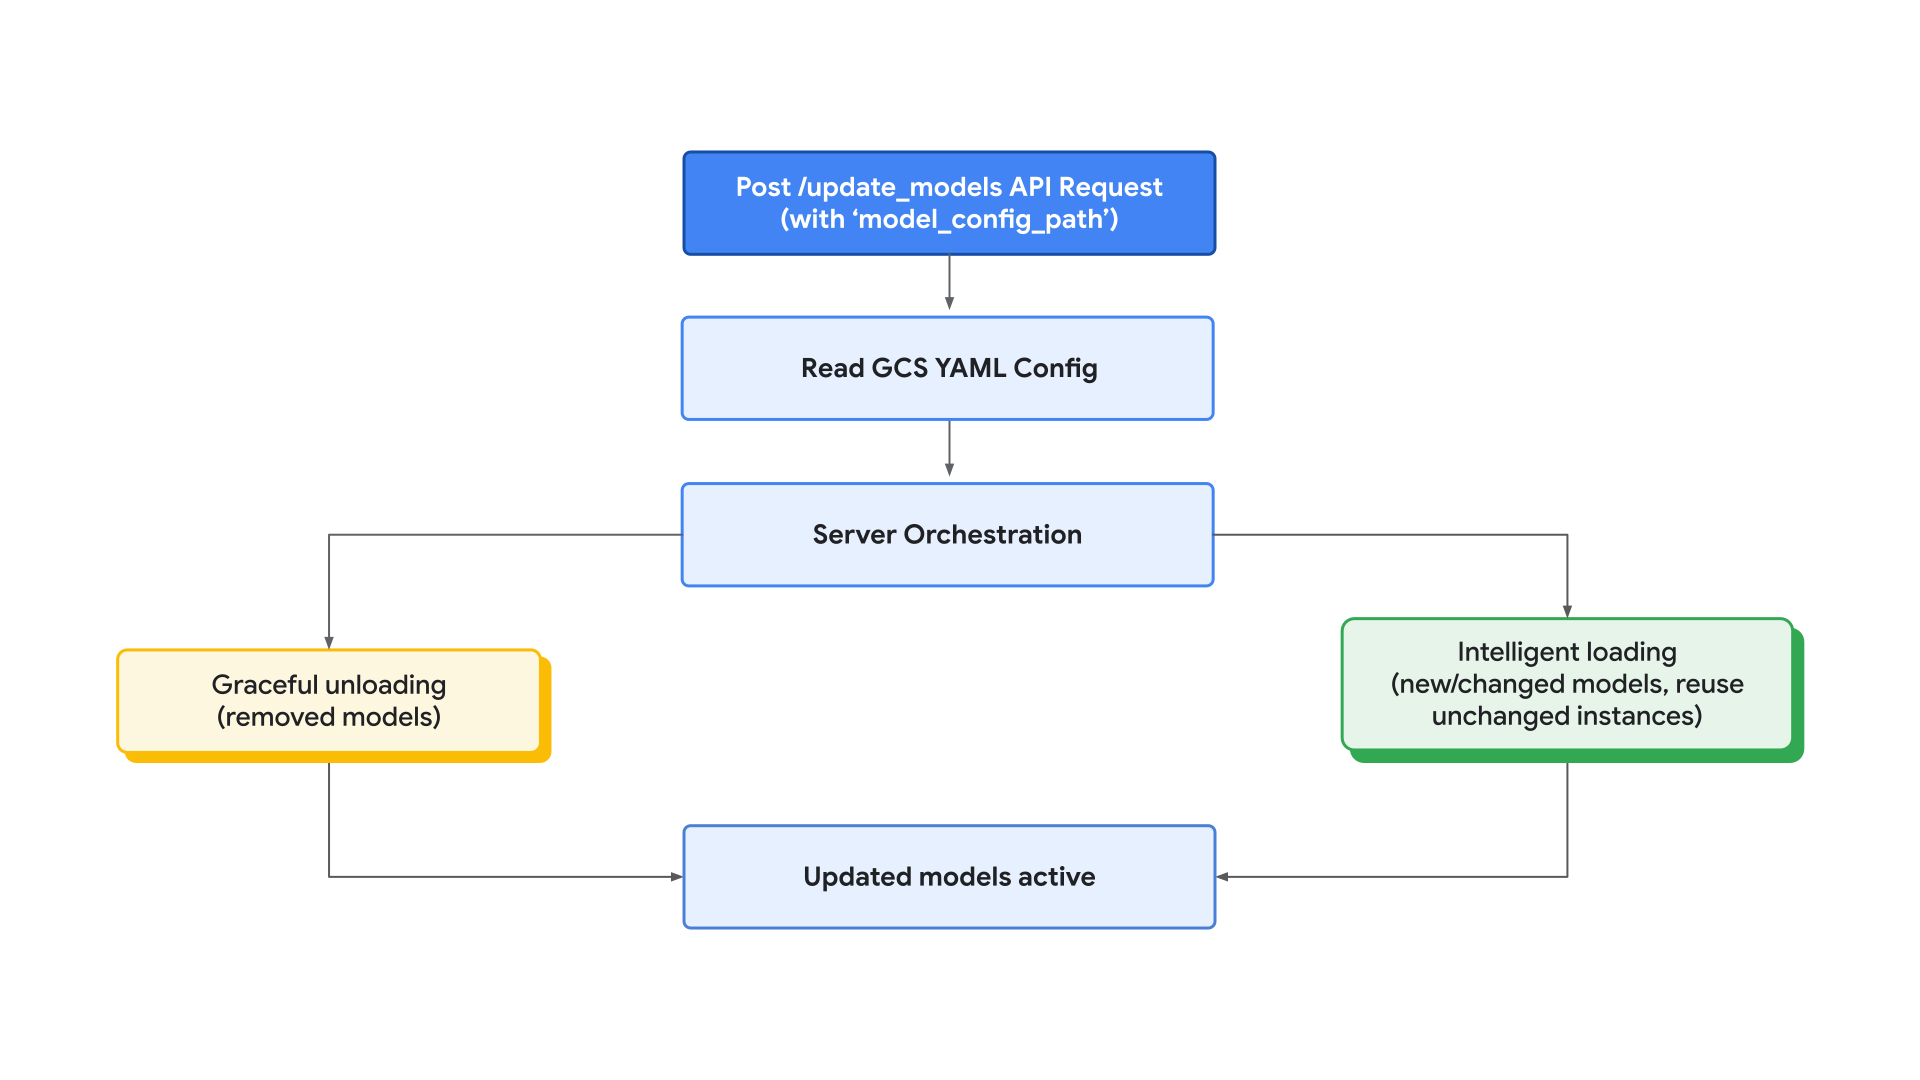
Untuk mengatasi keterbatasan yang melekat pada deployment yang tidak dapat diubah, kami menerapkan API update model khusus dalam container co-hosting model vLLM Vertex Model Garden. API ini memfasilitasi hot re-loading, sehingga server dapat menyesuaikan portofolio model yang dihosting secara langsung berdasarkan file konfigurasi terpusat yang disimpan di bucket Google Cloud Storage (GCS).
Proses update dimulai melalui permintaan POST ke endpoint update_models, yang menyertakan model_config_path yang mengarah ke file YAML GCS.
Setelah menerima permintaan ini, server akan menjalankan urutan orkestrasi multi-tahap
yang dioptimalkan untuk periode nonaktif minimal:
- Penghapusan halus: Sistem mengidentifikasi model yang tidak ada dalam konfigurasi baru dan menghentikan subprosesnya terlebih dahulu, sehingga segera mengklaim kembali memori GPU dan resource komputasi.
- Pemuatan dan penggunaan kembali yang cerdas: Server kemudian menginisialisasi instance model baru. Yang terpenting, jika setelan paralelisme model—seperti Tensor Parallelism (TP) atau Pipeline Parallelism (PP)—dan partisi memori yang dialokasikan tetap tidak berubah, orchestrator akan menggunakan kembali instance yang sedang berjalan. Pengoptimalan ini mengabaikan fase inisialisasi ulang yang mahal, sehingga memastikan layanan aktif tetap tidak terganggu selama perubahan konfigurasi.
Analisis latensi dan performa
Analisis empiris dari strategi update ini menunjukkan bahwa hot re-loading dinamis secara signifikan mengurangi penalti "cold start" yang biasanya terkait dengan penyaluran LLM berskala besar.
Kesimpulan
Co-hosting model dengan Vertex AI merepresentasikan perubahan paradigma yang mendasar, beralih dari deployment monolitik yang kaku dan berat hardware ke arsitektur penyajian yang lancar dan efisien. Dengan berkembang melampaui standar "satu model per VM" menjadi model pool komputasi kepadatan tinggi, organisasi dapat mengurangi Total Biaya Kepemilikan (TCO) secara signifikan sekaligus mempertahankan—dan sering kali meningkatkan—tolok ukur performa.
Perjalanan engineering kami dan studi benchmark multi-model yang ekstensif telah menetapkan serangkaian panduan produksi yang pasti untuk arsitektur ini:
- Tidak ada konfigurasi yang cocok untuk semua. Kami mendukung pencarian resep penyajian terbaik untuk kasus penggunaan tertentu (model, hardware, traffic), dan membangun alat untuk melakukannya.
- Menskalakan throughput dengan replika.
- Meningkatkan pemanfaatan resource dengan mendobrak batasan hardware dan membagi memori pada tingkat yang lebih terperinci.
Agar berhasil menerapkan arsitektur yang di-co-host, sebaiknya gunakan alur kerja teknis berikut:
- Partisi eksplisit: Gunakan argumen
--gpu-memory-partitionsuntuk mengalokasikan resource memori untuk setiap model. - Tolok ukur iteratif: Manfaatkan Utilitas Tolok Ukur yang disediakan untuk mengidentifikasi titik "Concurrency Crossover" tertentu untuk workload Anda—konfigurasi "sweet spot" dari jumlah instance, TP, dan PP.
Penerapan co-hosting di Google Cloud Model Garden memberikan blueprint yang skalabel untuk membangun aplikasi AI dengan kepadatan tinggi. Developer dianjurkan untuk mengeksplorasi kemampuan ini dan mereproduksi benchmark kami menggunakan notebook tutorial yang disediakan untuk mengoptimalkan konfigurasi inferensi sesuai kebutuhan spesifik perusahaan mereka.
Terima kasih telah membaca
Kami menantikan masukan dan pertanyaan Anda tentang Vertex AI.
Ucapan terima kasih
Kami ingin menyampaikan terima kasih yang tulus kepada tim Google Cloud Vertex AI. Secara khusus, kami berterima kasih kepada Bo Wu dan Ting Yu atas kepemimpinan dan panduan mereka, serta Deborah He, Shawn Ma, Desmond Liu, Yang Pan, Surya K G Tangatur, dan Luis Rizo atas kontribusi mereka yang sangat berharga, selama project ini.