

בתחום המתפתח של מודלי שפה גדולים (LLM), דפוס הפריסה "מודל אחד לכל מכונה" הופך לצוואר בקבוק משמעותי מבחינת היעילות של עלות ההצגה של מודלי LLM בארגונים. כדי לנהל עומסי שיא, מודלי LLM דורשים לעיתים קרובות הקצאות חומרה משמעותיות, כמו צומתי GPU מלאים מסוג 8x H100. עם זאת, במהלך פעולות רגילות, המשאבים היקרים האלה בדרך כלל לא מנוצלים מספיק, מה שמוביל לעלות בעלות כוללת (TCO) גבוהה.
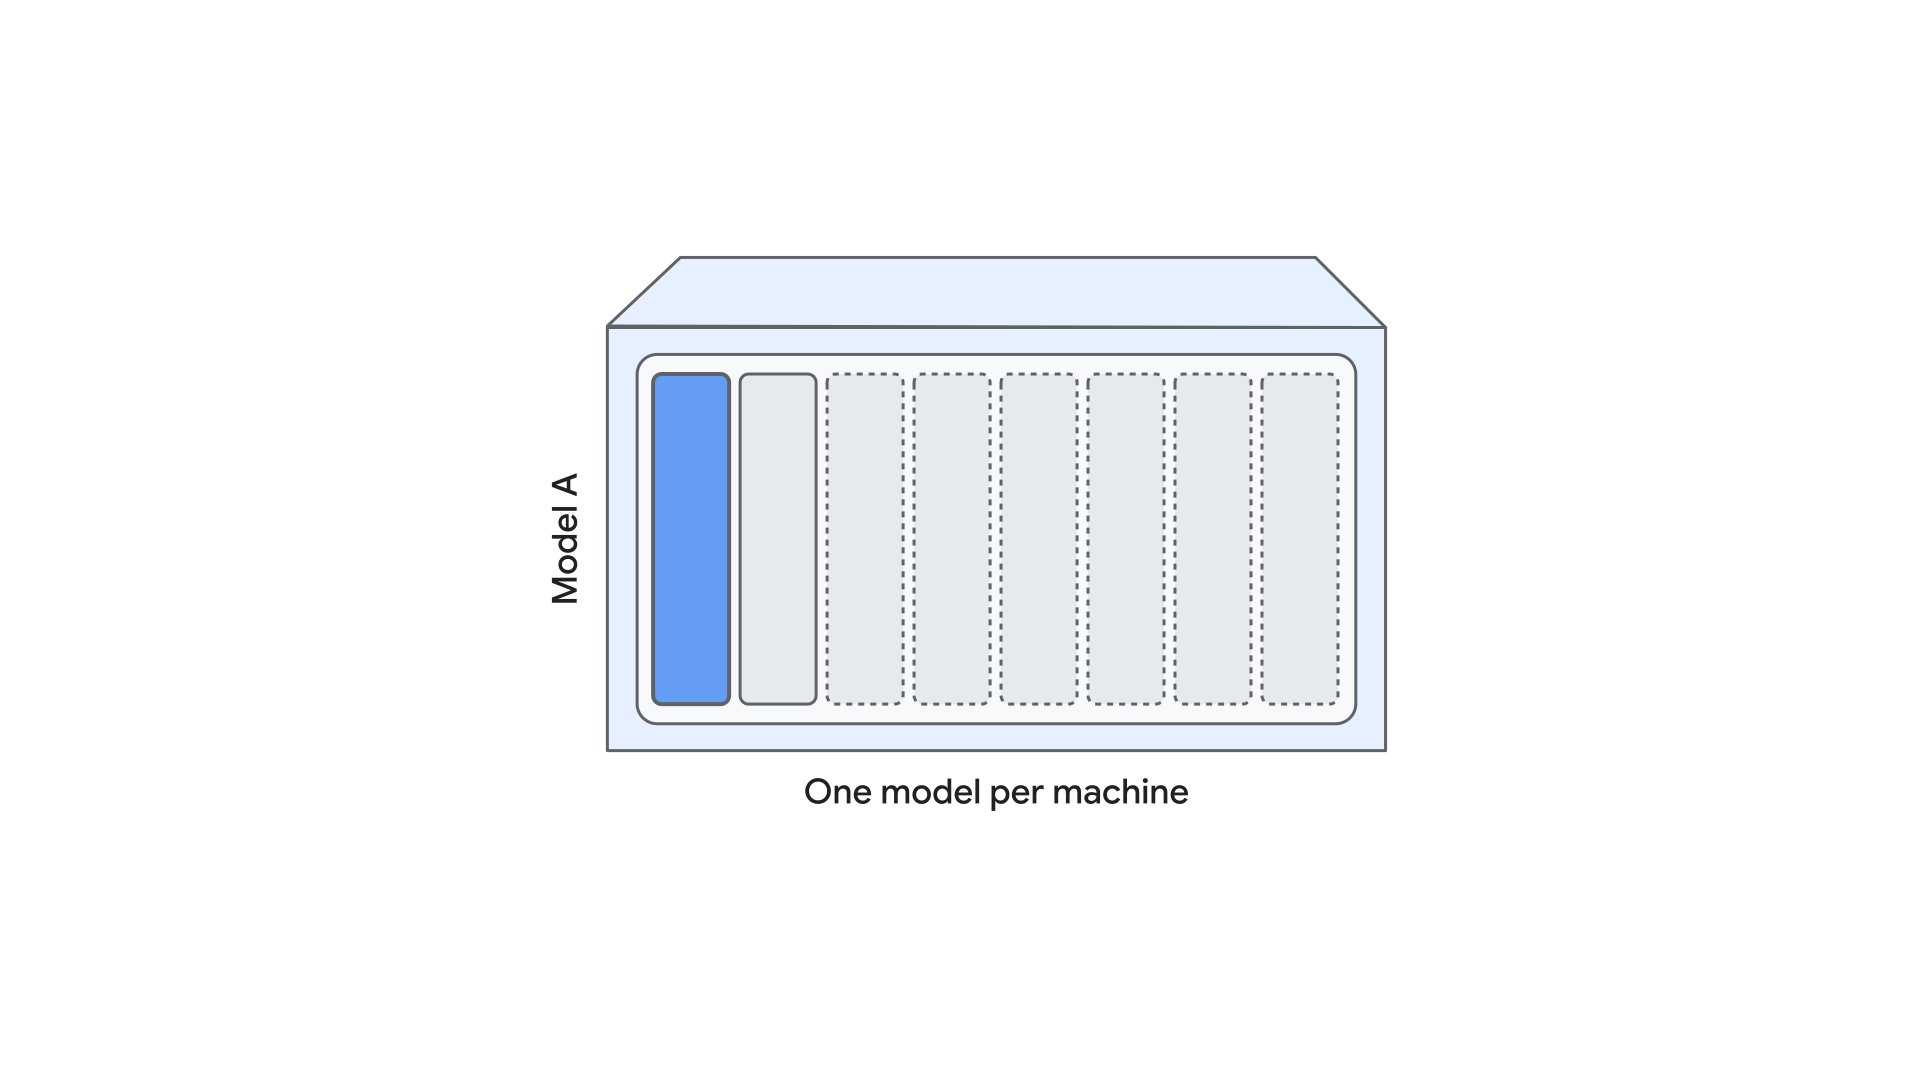
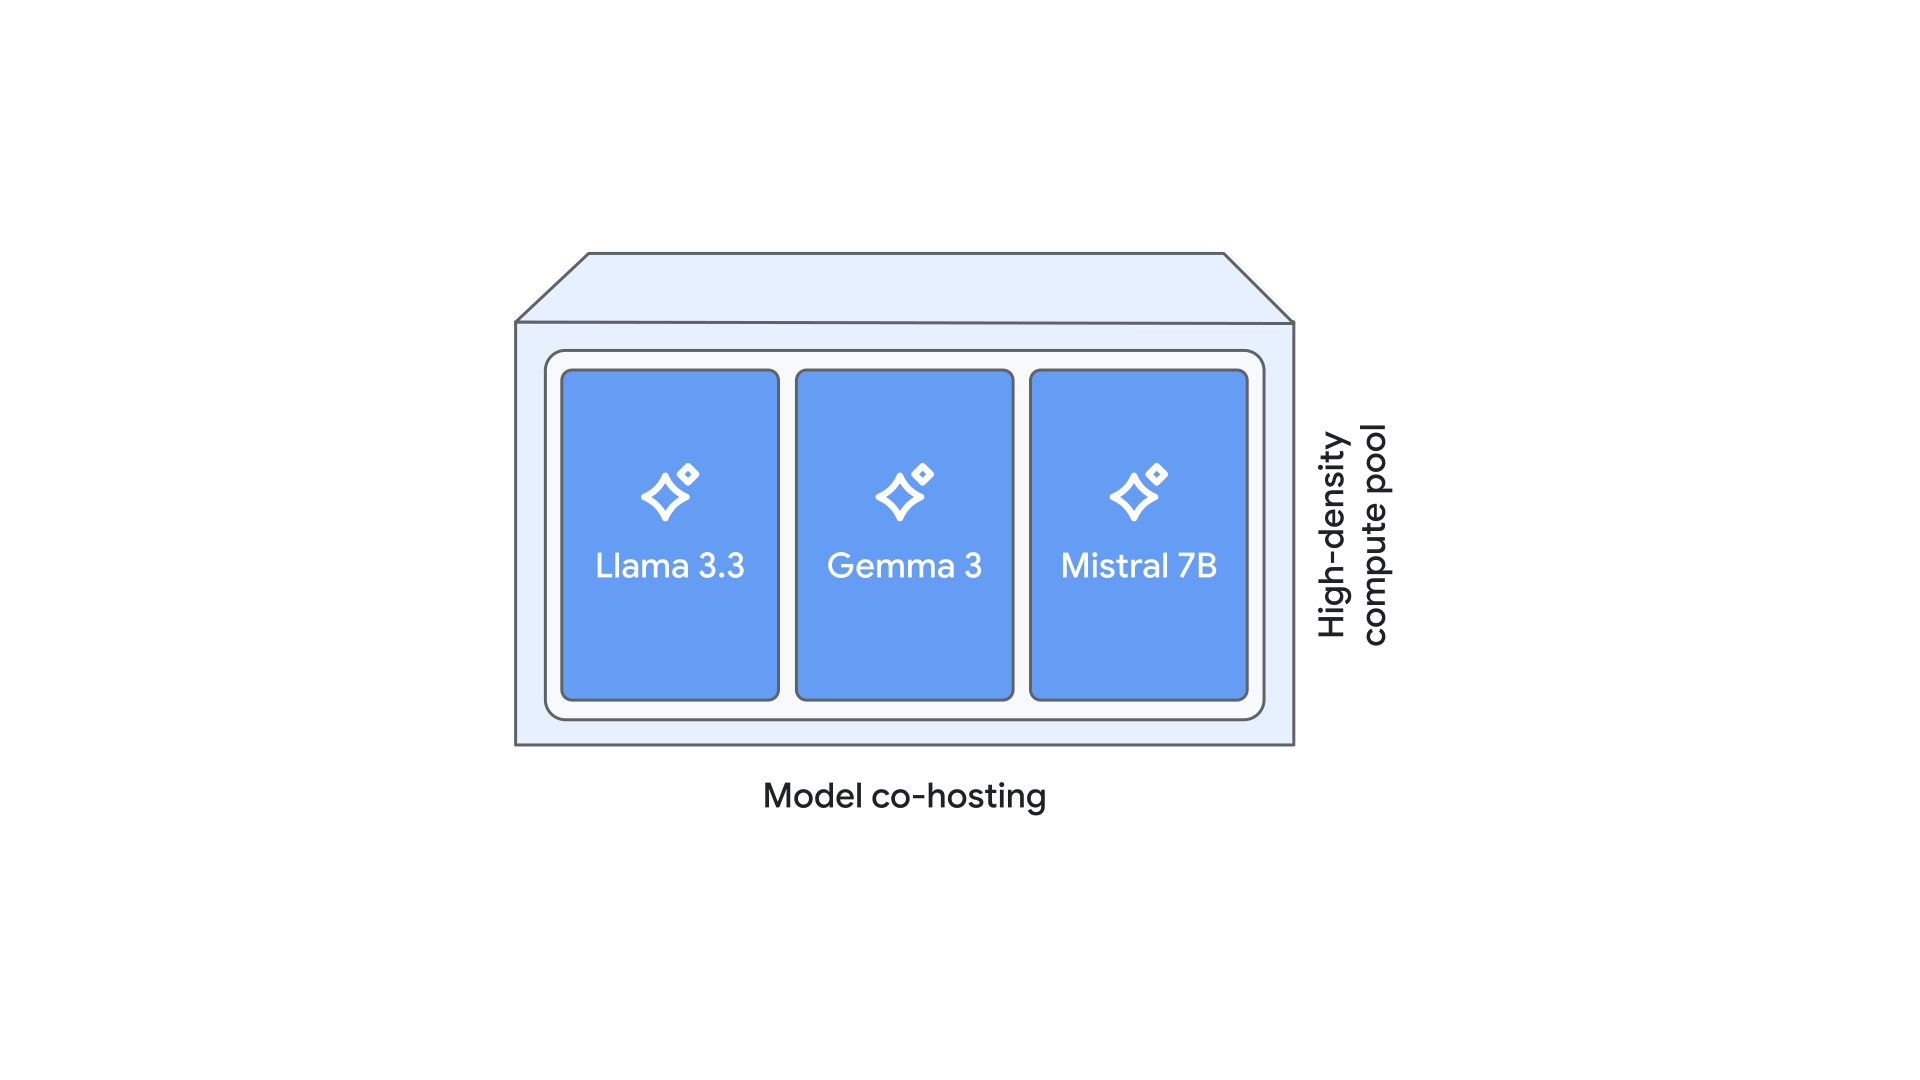
אירוח משותף של מודלים פותר את בעיית היעילות הזו, כי הוא מאפשר לכמה מכונות של מודלים לחלוק את אותם משאבים של מכונות וירטואליות ו-GPU. זה כולל מודלים שונים לגמרי, כמו Llama 3.3 ו-Gemma 3. באמצעות חלוקה חכמה של משאבים וחלוקה של זיכרון ה-GPU, Vertex AI Model Garden הופך את הקצאת החומרה הסטטית למאגרי מחשוב גמישים וצפופים.
בפוסט הזה בבלוג הטכני מפורט התהליך של Vertex AI Engineering להבאת אירוח משותף של מודלים לשירות ענן שמוכן לייצור. נשתף את המתודולוגיה שלנו לאסטרטגיות הטמעה ברמת הקונטיינר, נזהה הגדרות אופטימליות להצגת מודעות ונציג ממצאים עיקריים מהמחקר המקיף שלנו להשוואה בין מודלים, כדי שתוכלו למקסם את היעילות של עלות הצגת המודעות ב-LLM.
הסבר על אירוח משותף של מודלים: קונספט וארכיטקטורה
אירוח משותף של מודלים הוא אסטרטגיית שירות בצפיפות גבוהה, שמאפשרת לכמה מכונות של מודל שפה גדול (LLM) או לארכיטקטורות שונות של מודלים לחלוק את אותם משאבי חומרה פיזיים במכונה וירטואלית (VM) אחת. בניגוד למודלים המסורתיים של פריסה, שבהם מקצים מכונה וירטואלית או GPU שלם למודל אחד, באירוח משותף משתמשים בחלוקה מפורטת של המשאבים כדי למקסם את החזר ה-ROI על החומרה ולשפר את הניצול של הזיכרון ושל משאבי המחשוב.
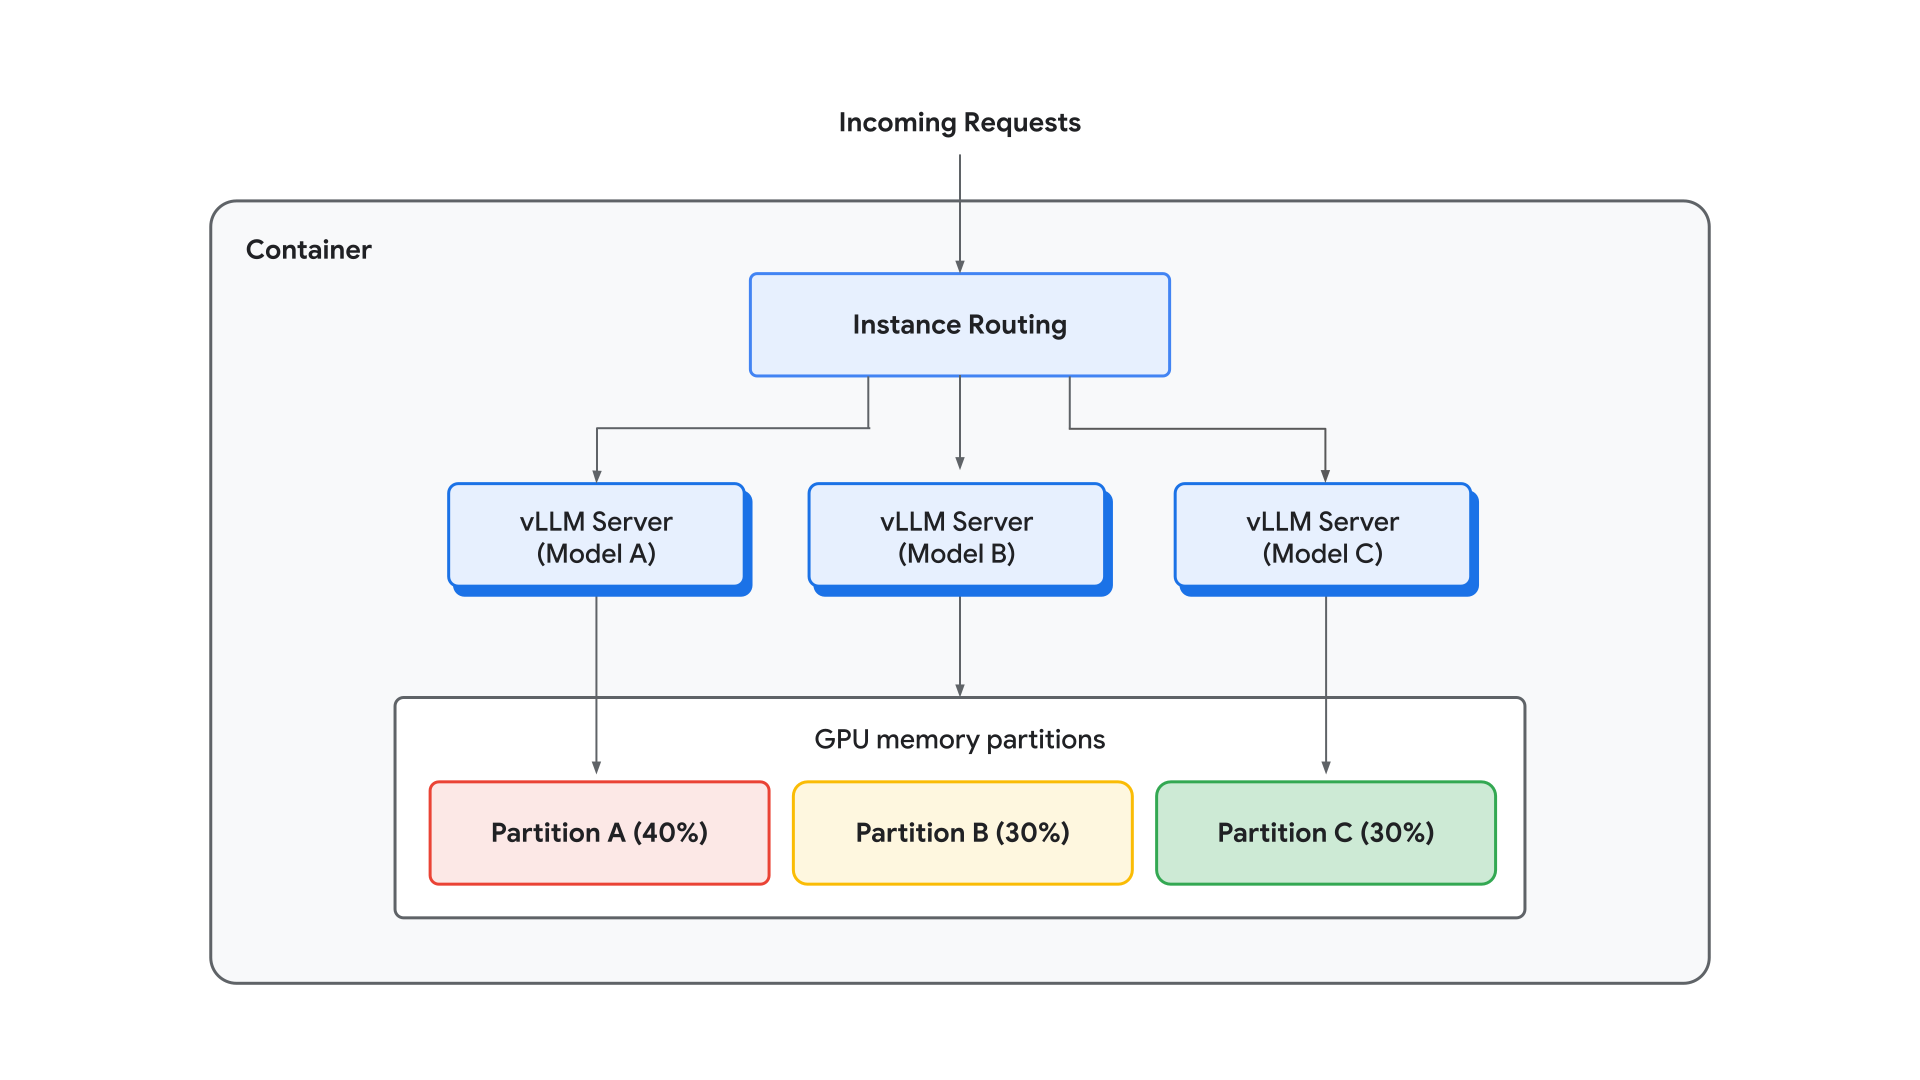
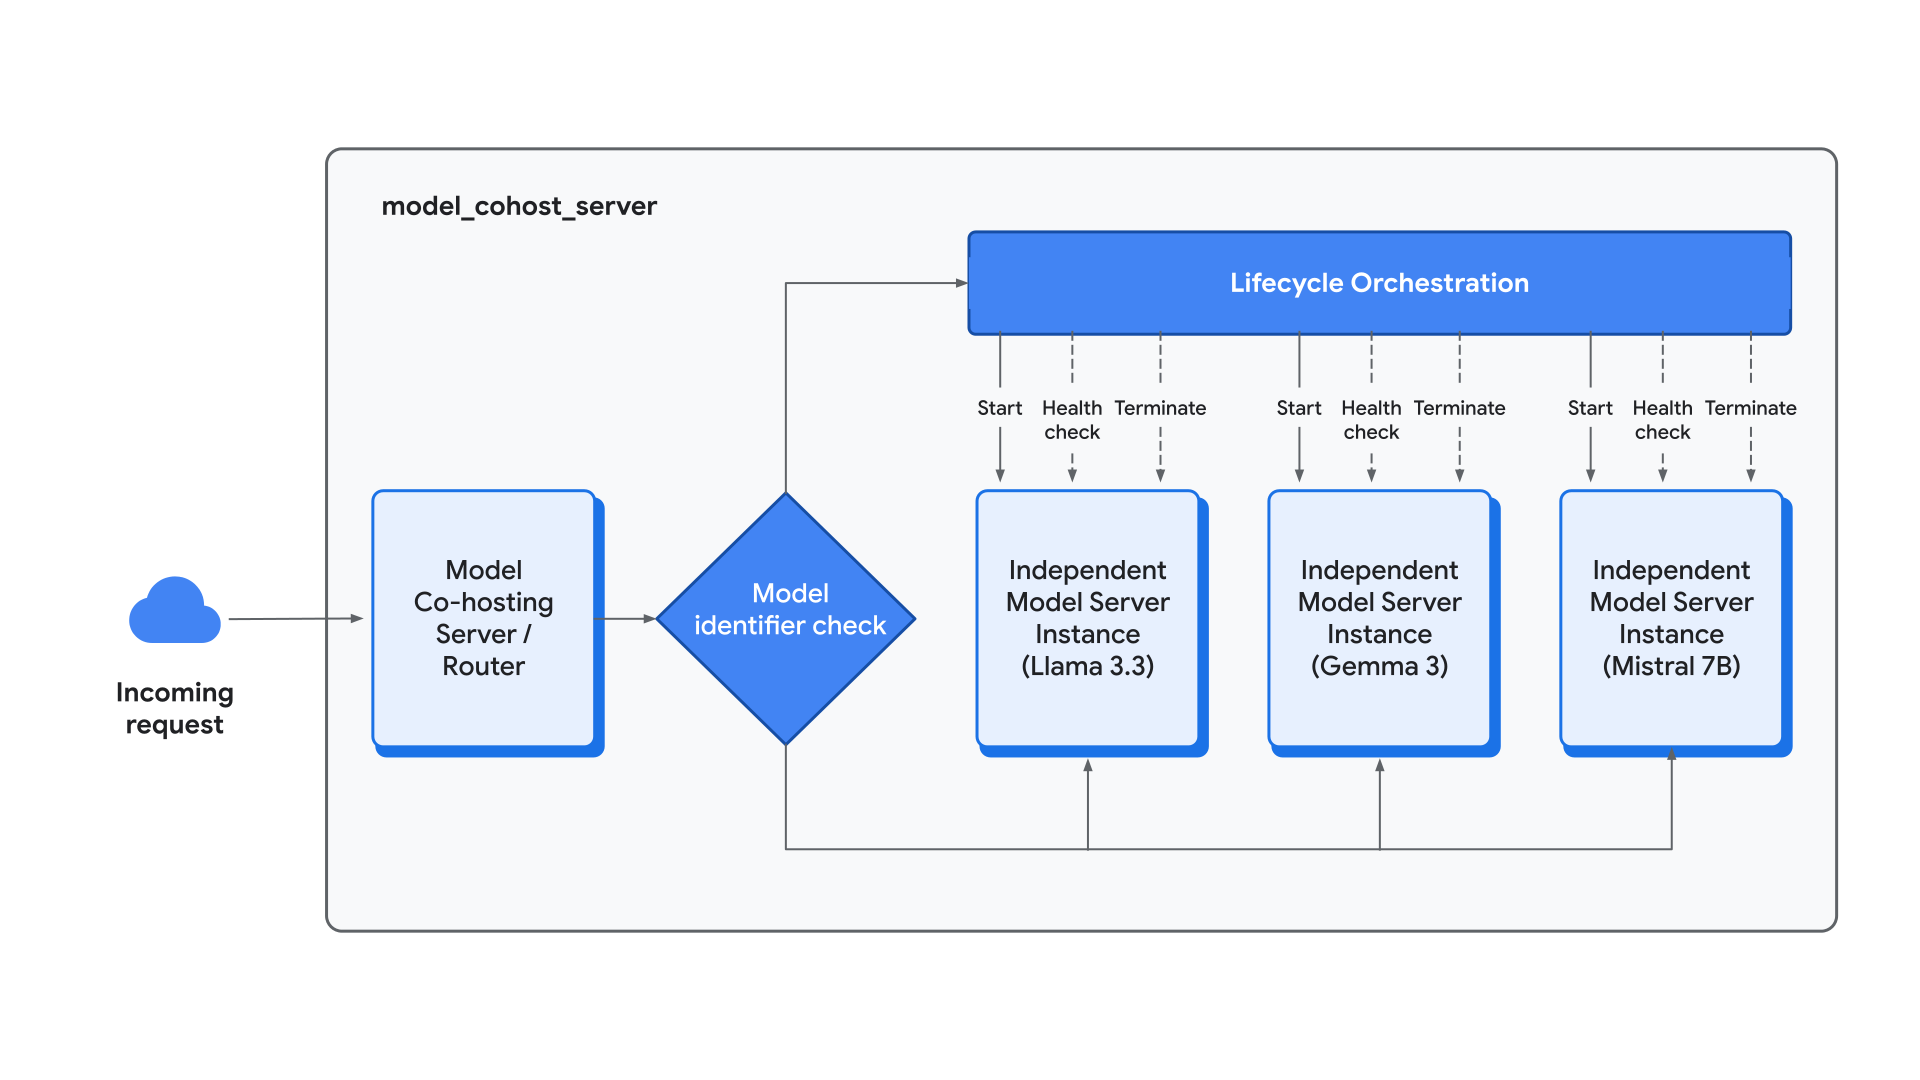
ההטמעה שלנו מתמקדת בפתרון ברמת הקונטיינר, שמאפשר להציג בו-זמנית כמה מודלים עם הגדרות אישיות נפרדות. הארכיטקטורה הזו פועלת באמצעות כמה מנגנונים טכניים משולבים, החל מפריסה של כמה מופעים עצמאיים של שרתי מודלים בתוך קונטיינר אחד. כל אחד מהמכונות האלה משמש כעותק מלא ועצמאי של שרת המודל, שמאפשר עיבוד בו-זמני של בקשות במכונה הווירטואלית. כדי לנהל את התנועה הזו, הטמענו שכבת ניתוב של מכונות בתוך הקונטיינר, שמפיצה ביעילות את הבקשות הנכנסות בין המכונות הפעילות.
העיצוב הזה מספק מקביליות מפורטת בכך שהוא מאפשר לכל מודל באירוח משותף להשתמש בהגדרת הצגה ייעודית, עם הגדרות ייחודיות למקביליות של Tensor (TP), מקביליות של צינור עיבוד נתונים (PP) ומספר ספציפי של מופעי מודלים. כדי להשלים את התהליך, המערכת מבצעת חלוקה של המשאבים, שבה מוקצים לכל מודל חלקים ספציפיים בזיכרון ה-GPU – למשל, חלק של 0.4 בזיכרון ה-GPU לכל מודל – כדי להבטיח שעומסי עבודה שונים יתקיימו במקביל באותו מאיץ בלי למנוע אחד מהשני משאבי זיכרון קריטיים. הגישה הארכיטקטונית הזו הופכת הקצאת חומרה סטטית, כמו צומת GPU מלא של 8x H100, למאגר מחשוב גמיש שיכול לשרת מגוון רחב של מודלים – ממודלים גדולים של חשיבה רציונלית ועד למודלים קטנים של צ'אט עם זמן אחזור קצר.
יצירת אב טיפוס ומחקר השוואתי
לפני שפיתחנו את כלי הניהול שמוכן לייצור, ערכנו מחקר השוואתי מקיף כדי לאמת את היעילות התיאורטית של אירוח משותף של מודלים. מטרת השלב הזה הייתה לבדוק ביסודיות את המקביליות המקורית של vLLM ולכמת במדויק את מידת "ההפרעה" כשמודלים משתפים את אותו סיליקון.
בדיקת מקביליות: מציאת "נקודת המעבר"
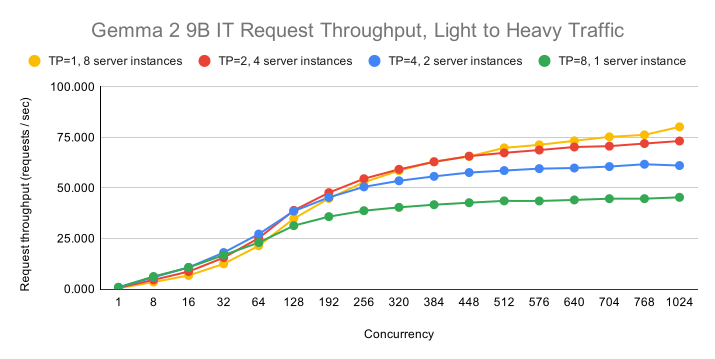
הניתוח הראשוני שלנו התמקד ב-Tensor Parallelism (TP) המקורי של vLLM ובהטמעה של Vertex AI של מכונות מודל כמספר מכונות של שרת vLLM, כדי לקבוע איך האסטרטגיות האלה פועלות עם עומסי משתמשים משתנים. גילינו שההגדרה האופטימלית תלויה מאוד בו-זמניות. ברמות נמוכות יותר של בו-זמניות, רמה גבוהה של Tensor Parallelism (למשל, TP=8) מספקת את זמן האחזור הנמוך ביותר לבקשות ספציפיות, על ידי הפצת שכבות בכל המאיצים הזמינים. אבל ככל שהתנועה בו-זמנית גדלה, צוואר הבקבוק משתנה. כדי למקסם את התפוקה בתנאי עומס גבוה, ההגדרה האופטימלית עוברת מ-TP=8 ל-TP=4, ל-TP=2 ובסופו של דבר ל-TP=1, ובמקביל מגדילה את מספר המופעים של המודלים הבלתי תלויים. המעבר הזה מגדיר "נקודת חיתוך" שבה היתרונות של זמן אחזור קצר יותר בתקשורת בין יחידות ה-GPU בהגדרות TP נמוכות, עולים על המהירות הגולמית של הפעלה ב-TP גבוה. בתרשים הבא מוצגת נקודת המעבר עם המודל Gemma 2 9B IT.
התאמה אופטימלית לעומס: מודל אחד, כמה רפליקות
כדי לקבוע בסיס קפדני ליכולת ההתאמה לעומס, בדקנו את הביצועים של הצגת כמה מופעים של אותו מודל בצומת אחד. בתנאי תעבורה רוויים (2,048 בקשות מקבילות לכל GPU), הפעלת שמונה מכונות שרת vLLM עצמאיות בצומת 8xH100 הניבה שיפור של פי 7.8 בקירוב בתפוקה, עם רגרסיה של זמן אחזור כמעט אפסית בהשוואה לבסיס של GPU יחיד.
השוואת תשתיות: תזמון משותף של קונטיינר לעומת pod
בנוסף, בדקנו את התזמור ברמת הקונטיינר בהשוואה לפתרונות מקוריים ברמת התשתית, ובמיוחד תזמון משותף של Pod. שני הפתרונות הניבו ביצועים דומים בהצגה של כמה רפליקות, אבל בסופו של דבר בחרנו בגישה ברמת הקונטיינר למוצר בר-הקיימא המינימלי (MVP). ההחלטה הזו התקבלה בגלל הגמישות העדיפה שהפתרון ברמת הקונטיינר מציע לאירוח משותף הטרוגני, שמאפשר למפתחים להציג ארכיטקטורות שונות של מודלים זו לצד זו עם מחיצות זיכרון מפורטות שמוגדרות בתוכנה, שלא מוגבלות על ידי אילוצי התזמון הבסיסיים של Kubernetes. בנוסף, התזמור ברמת הקונטיינר מאפשר לבצע איטרציות מהר יותר, וקל יותר להתאים אישית ולחדש.
בדיקת ההפרעה: אירוח משותף של מודלים שונים
אבן הדרך האחרונה בפיתוח אב הטיפוס הייתה "בדיקת ההפרעה", שבה אירחנו במשותף את Gemma-3n-E2B-it ואת Llama-3.1-8B-Instruct באותו VM. כשכל מודל קיבל הקצאה של 0.4 מזיכרון ה-GPU, ביצועי ההצגה נשארו כמעט זהים למבחני הביצועים של מודל יחיד. לדוגמה, Gemma-3n הגיע ל-30.21 בקשות בסביבה משותפת, בהשוואה ל-30.96 בקשות בסביבה מבודדת. התוצאות האלה מאשרות שיש מעט מאוד הפרעות חישוב בין מודלים שמתארחים יחד, גם בתנועה כבדה, בתנאי שמשאבי הזיכרון מחולקים כראוי כדי למנוע מחסור במטמון KV.
הטמעת מאגר תגים ב-MVP
המעבר מבדיקת ביצועים מאומתת למערכת שמוכנה לייצור הצריך פיתוח של כלי תזמור חזק ומבוסס-קונטיינרים. בשלב הפיתוח הזה התמקדנו בבניית שכבת תוכנה ברמה גבוהה, שיכולה לנהל את המורכבות של מחזורי חיים של כמה מודלים, תוך הבטחת בידוד דטרמיניסטי של המשאבים.
עיצוב שרת לאירוח משותף של מודלים
הליבה של ההטמעה שלנו היא model_cohost_server, נקודת כניסה מותאמת אישית שנועדה לפעול כמתזמר ראשי בתוך הקונטיינר. בניגוד למודל הרגיל של תהליך יחיד, השרת הזה מטמיע ניהול של תהליכי משנה, ומאפשר להריץ בו-זמנית כמה מכונות של שרת מודל עצמאי – כמו vLLM – כתהליכי משנה מבודדים. כדי לנהל את התנועה הנכנסת, התזמור משתמש בניתוב בקשות ברמה גבוהה, מזהה בקשות לפי מזהי המודלים הייחודיים שלהן באמצעות ארגומנטים כמו --served-model-name ומפנה אותן למכונה המתאימה של השרת הפנימי. מעבר לניתוב, השרת מספק תזמור מקיף של מחזור החיים, ומנהל את האתחול, את המעקב אחרי התקינות ואת הסיום של כל המכונות שמתארחות יחד. הניהול הריכוזי הזה מספק נקודת קצה מאוחדת אחת לתנועה חיצונית, תוך שמירה על הגבולות התפעוליים הנפרדים של כל תהליך משנה.
חלוקת משאבי GPU: חלוקה דטרמיניסטית לפרוסות
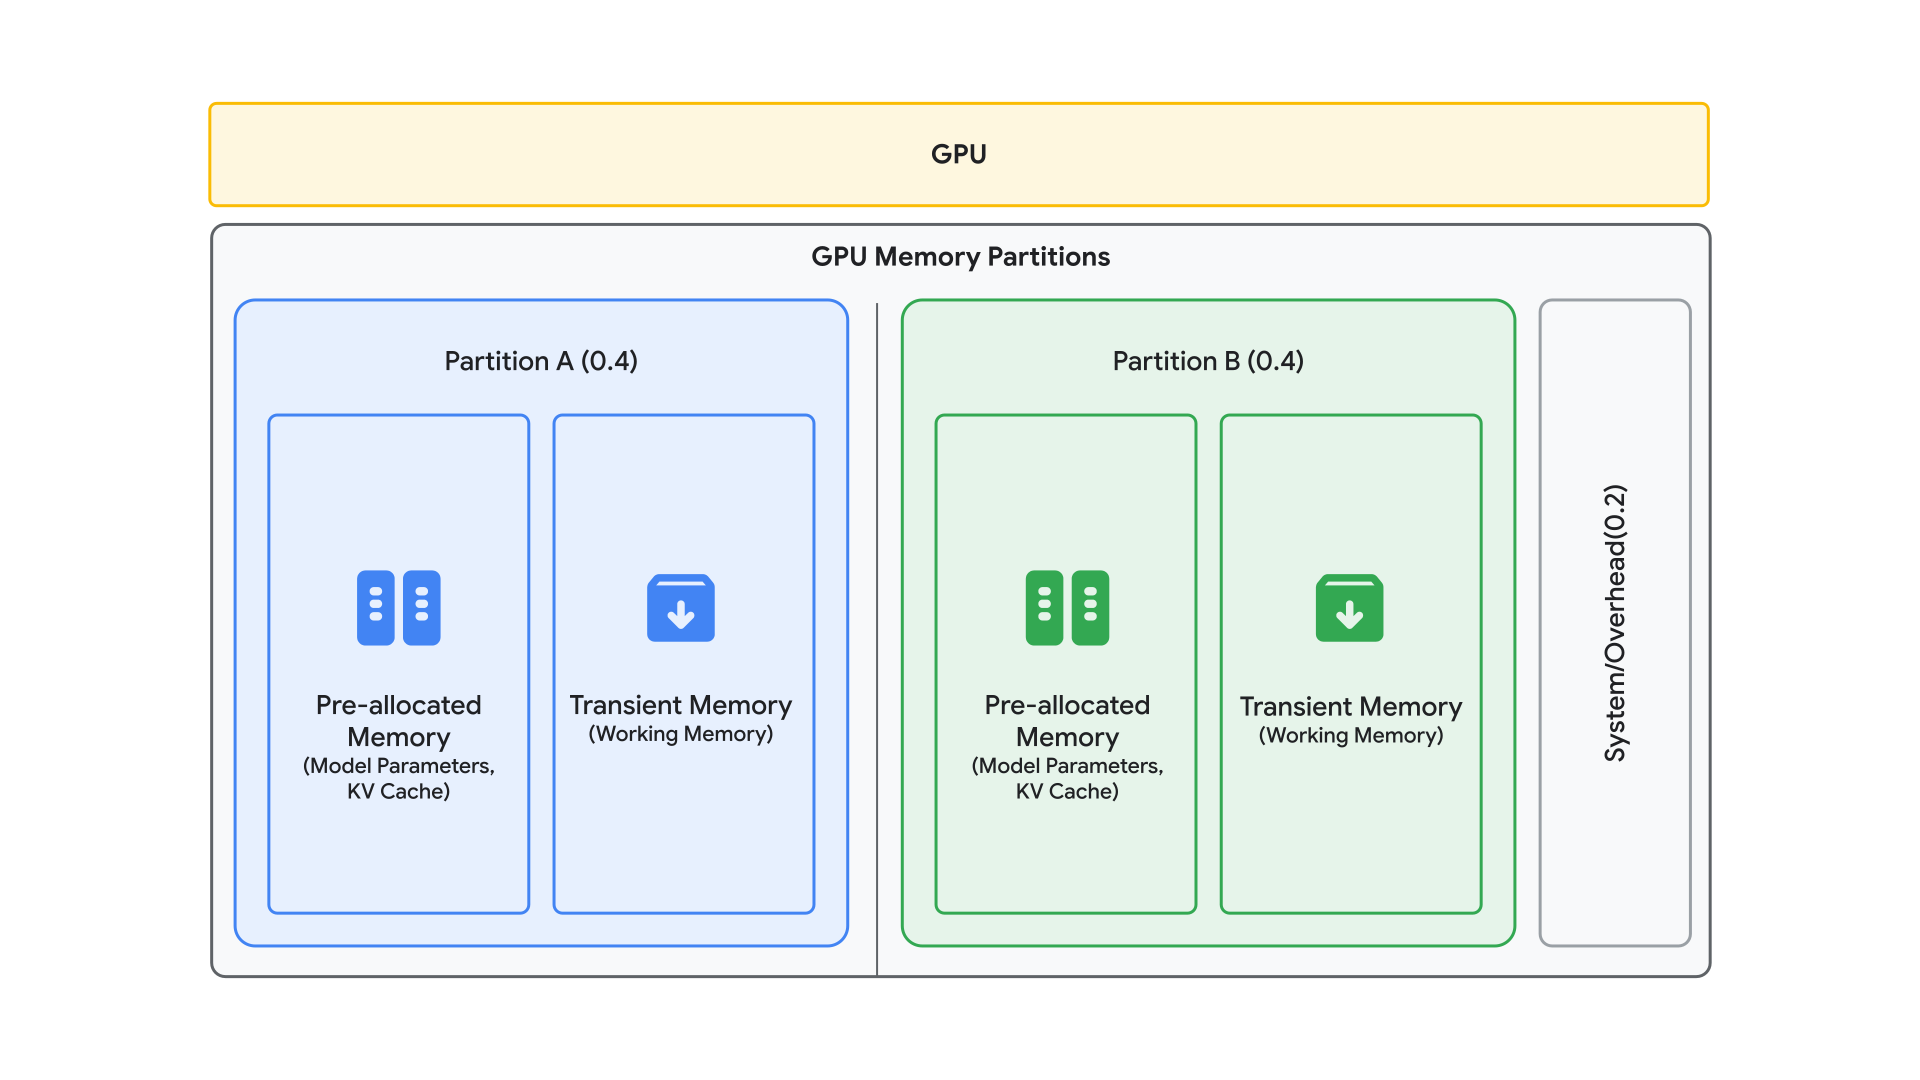
כדי למנוע מצב שבו עומס העבודה של מודל אחד יגרום לשגיאת "אין מספיק זיכרון" (OOM) בסביבה המשותפת, הטמענו מנגנון קפדני לחלוקת משאבים. ההקצאה הזו מתבצעת באמצעות הארגומנט gpu-memory-partition, שמאפשר למפתחים להגדיר יחסי זיכרון מפורשים (למשל, 0.4, 0.4) כדי להקצות אחוז קבוע מסך זיכרון ה-GPU של צומת לכל מופע של מודל.
כדי להנחות את ההקצאה הזו, אנחנו משתמשים במודל זיכרון "מוקצה מראש לעומת זמני", שמבדיל בין דרישות של משאבים סטטיים ודינמיים.
"הזיכרון שהוקצה מראש" מורכב מהזיכרון שמשמש למשקלי המודל ולמטמון ה-KV. כמות הזיכרון שמשמשת למשקלי המודל תלויה במספר הפרמטרים ובדיוק של המודל. לדוגמה, מודל של 8 מיליארד פרמטרים ב-BF16 דורש נפח אחסון סטטי של כ-16GB. כמות הזיכרון שמשמשת למטמון KV תלויה בממדי המודל, ברמת הדיוק, בחלון ההקשר ובמספר הרצפים. זיכרון "זמני" מורכב מחישובי ביניים ומזיכרון עבודה של הסקות. הארגומנט gpu-memory-partition מייצג את הזיכרון שהוקצה מראש. מומלץ להשאיר מקום פנוי לזיכרון "זמני" על ידי הגדרת סכום של gpu-memory-partition שיהיה קטן מ-1.0.
הפיכה למוצר
בשלב ההכנה לייצור של אירוח משותף של מודלים באמצעות Vertex AI, המטרה הייתה ליצור סביבה חלקה ומוכנה לייצור גם להגדרות של הצגת מודל יחיד עם כמה רפליקות וגם להגדרות של הצגת כמה מודלים. המעבר הזה תרגם בפועל ממצאים אמפיריים של נקודות השוואה לתהליכי עבודה פשוטים של פריסה ולמבנים של תמיכה בתשתית שמשולבים באופן עמוק.
תהליכי פריסה פשוטים יותר
כדי להקל על הכניסה לאירוח בצפיפות גבוהה, יצרנו סטנדרטיזציה של הגדרות האירוח המשותף באמצעות ארגומנטים של קונטיינרים בהתאמה אישית, שמשתלבים באופן מקורי עם ממשקי ה-API הקיימים של Vertex AI. למכונות וירטואליות בצורה מלאה, כמו צומת 8x H100, פיתחנו כלי להשוואה לשוק כדי להתאים אישית את המתכונים הטובים ביותר לתרחישי השימוש הספציפיים שלכם. כלי ההשוואה האלה מאפשרים לכם למצוא את ההגדרות שמאזנות באופן אוטומטי בין Tensor Parallelism (TP), Pipeline Parallelism (PP) ומספר המופעים של המודל, על סמך מספר הפרמטרים הספציפי ורמת הדיוק של המודל. בנוסף, יש תמיכה חזקה ב-Deployment API, שמאפשרת למפתחים לציין את הפרמטרים המפורטים האלה – כולל מחיצות מדויקות של זיכרון GPU – ישירות בבקשת deployModel רגילה ולפרוס מודלים.
פרסום דינמי של מודלים מרובים
התקדמות משמעותית בתהליך הטכני שלנו הייתה המעבר מהגדרות סטטיות לארכיטקטורת הצגה דינמית. היכולת הזו קריטית לסביבות ייצור שמתאפיינות בדפוסי תנועה שמשתנים במהירות, כי היכולת לטעון או לפרוק מודלים בלי להפעיל מחדש את הקונטיינר חיונית לשמירה על הגמישות של התשתית ועל זמינות גבוהה.
Dynamic Update API (update_models)
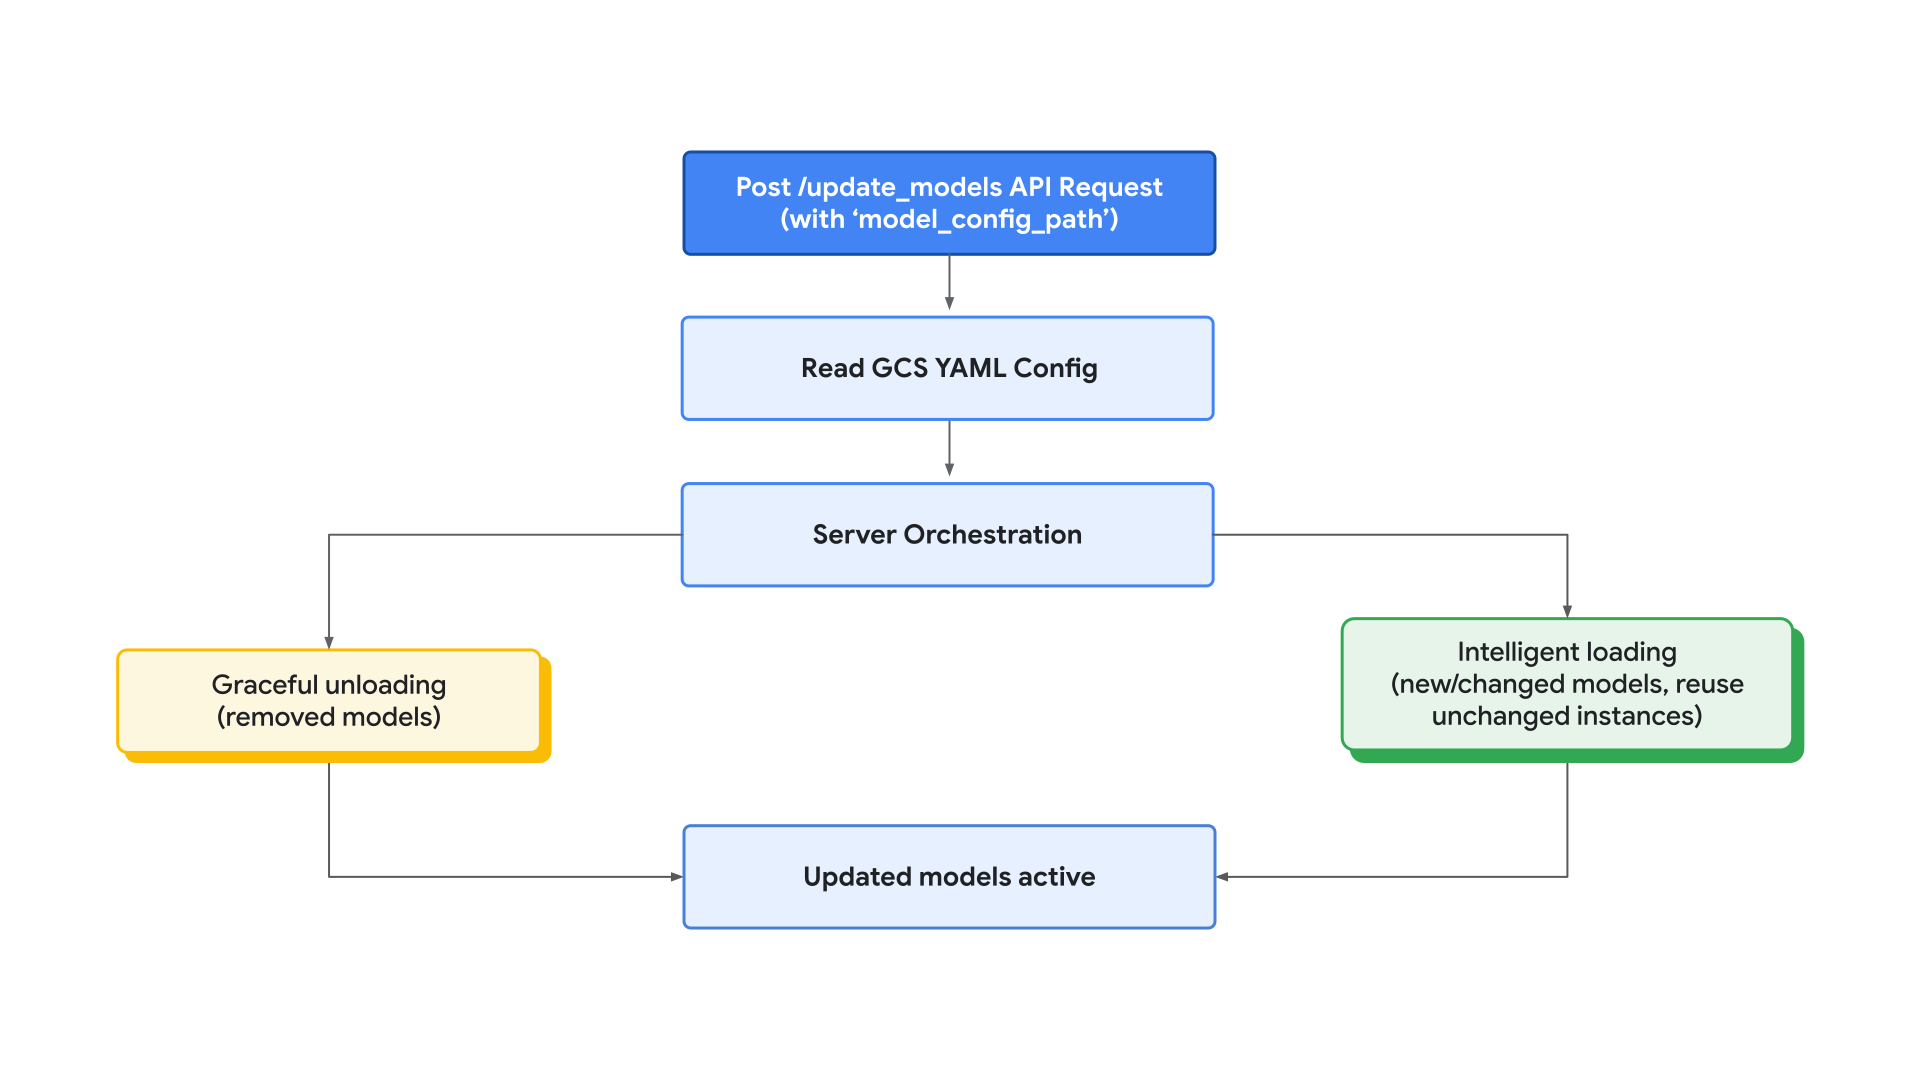
כדי להתמודד עם המגבלות המובנות של פריסות שלא ניתנות לשינוי, הטמענו ממשק API מיוחד לעדכון מודלים בתוך קונטיינר האירוח המשותף של מודל vLLM ב-Vertex Model Garden. ה-API הזה מאפשר טעינה מחדש בזמן אמת, כך שהשרת יכול להתאים את תיק המודלים המתארחים שלו תוך כדי תנועה, על סמך קובץ תצורה מרכזי שמאוחסן בקטגוריה של Google Cloud Storage (GCS).
תהליך העדכון מתחיל באמצעות בקשת POST לנקודת הקצה (endpoint) update_models, שכוללת את model_config_path שמצביע על קובץ ה-YAML ב-GCS.
אחרי קבלת הבקשה, השרת מבצע רצף תזמור בכמה שלבים, שמותאם לזמן השבתה מינימלי:
- פריקה הדרגתית: המערכת מזהה מודלים שלא נמצאים בהגדרה החדשה ומסיימת קודם את תהליכי המשנה שלהם, וכך מפנה מיד את זיכרון ה-GPU ומשאבי המחשוב.
- טעינה חכמה ושימוש חוזר: השרת מאתחל מופעים חדשים של המודל. חשוב לציין שאם הגדרות ההקבלה של המודל – כמו Tensor Parallelism (TP) או Pipeline Parallelism (PP) – והמחיצה של הזיכרון שהוקצה לו לא משתנות, כלי הניהול משתמש מחדש במכונה הפועלת הקיימת. האופטימיזציה הזו עוקפת את שלב האתחול מחדש, שהוא שלב יקר, וכך מבטיחה שהשירותים הפעילים לא יופסקו במהלך שינויי ההגדרות.
ניתוח של זמן האחזור והביצועים
ניתוח אמפירי של אסטרטגיות העדכון האלה מראה שטעינה דינמית מחדש של מודלים חמים מפחיתה באופן משמעותי את העיכוב ב "הפעלה במצב התחלתי" שקשור בדרך כלל להצגת מודלים גדולים של LLM.
סיכום
אירוח משותף של מודלים ב-Vertex AI מייצג שינוי פרדיגמה בסיסי, שבו עוברים מפריסות מונוליטיות קשיחות עם חומרה כבדה לארכיטקטורת הצגה גמישה ויעילה. אם ארגונים יעברו מהתקן של "מודל אחד לכל VM" למודל של מאגר מחשוב בצפיפות גבוהה, הם יוכלו להפחית באופן משמעותי את עלות הבעלות הכוללת (TCO) תוך שמירה על נקודות ההשוואה לביצועים, ולעיתים קרובות גם שיפור שלהן.
תהליך הפיתוח שלנו ומחקרים מקיפים להשוואה בין מודלים שונים עזרו לנו לגבש הנחיות ברורות לייצור בארכיטקטורה הזו:
- אין הגדרה אחת שמתאימה לכולם. אנחנו ממליצים למצוא את המתכון הטוב ביותר להצגה לתרחיש שימוש ספציפי (מודל, חומרה, תנועה), וליצור כלים לשם כך.
- התאמת התפוקה לעומס באמצעות רפליקות.
- לשפר את ניצול המשאבים על ידי פריצת גבולות החומרה ופיצול הזיכרון ברמה מפורטת יותר.
כדי להטמיע בהצלחה ארכיטקטורה של אירוח משותף, מומלץ להשתמש בתהליך העבודה הטכני הבא:
- חלוקה מפורשת: משתמשים בארגומנט
--gpu-memory-partitionsכדי להקצות משאבי זיכרון למודלים ספציפיים. - השוואה איטרטיבית לשוק: משתמשים בכלי ההשוואה לשוק שסופק כדי לזהות את נקודת ה-Concurrency Crossover הספציפית של עומס העבודה – הגדרת ה-sweet spot של מספר המכונות, ה-TP וה-PP.
הטמעת אירוח משותף ב-Model Garden של Google Cloud מספקת תוכנית מפורטת וניתנת להתאמה ליצירת אפליקציות AI בצפיפות גבוהה. אנחנו ממליצים למפתחים לבדוק את היכולות האלה ולשחזר את נקודות ההשוואה שלנו באמצעות המדריך ב-Notebook, כדי לבצע אופטימיזציה של הגדרות ההצגה בהתאם לדרישות הספציפיות של הארגון שלהם.
תודה שקראת
נשמח לקבל מכם משוב ושאלות על Vertex AI.
תודות
אנחנו רוצים להודות מקרב לב לצוות של Google Cloud Vertex AI. באופן ספציפי, אנחנו מודים ל-Bo Wu ול-Ting Yu על המנהיגות וההדרכה שלהם, וגם ל-Deborah He, ל-Shawn Ma, ל-Desmond Liu, ל-Yang Pan, ל-Surya K G Tangatur ול-Luis Rizo על התרומה החשובה שלהם לאורך הפרויקט הזה.