

Dans le paysage en constante évolution des grands modèles de langage (LLM), le modèle de déploiement "un modèle par machine" devient un goulot d'étranglement important pour la rentabilité de la diffusion de LLM dans les entreprises. Les LLM nécessitent souvent des réservations matérielles importantes, telles que des nœuds de GPU 8x H100 complets, pour gérer les pics de charge. Cependant, lors des opérations standards, ces ressources coûteuses sont souvent sous-utilisées, ce qui entraîne un coût total de possession (TCO) élevé.
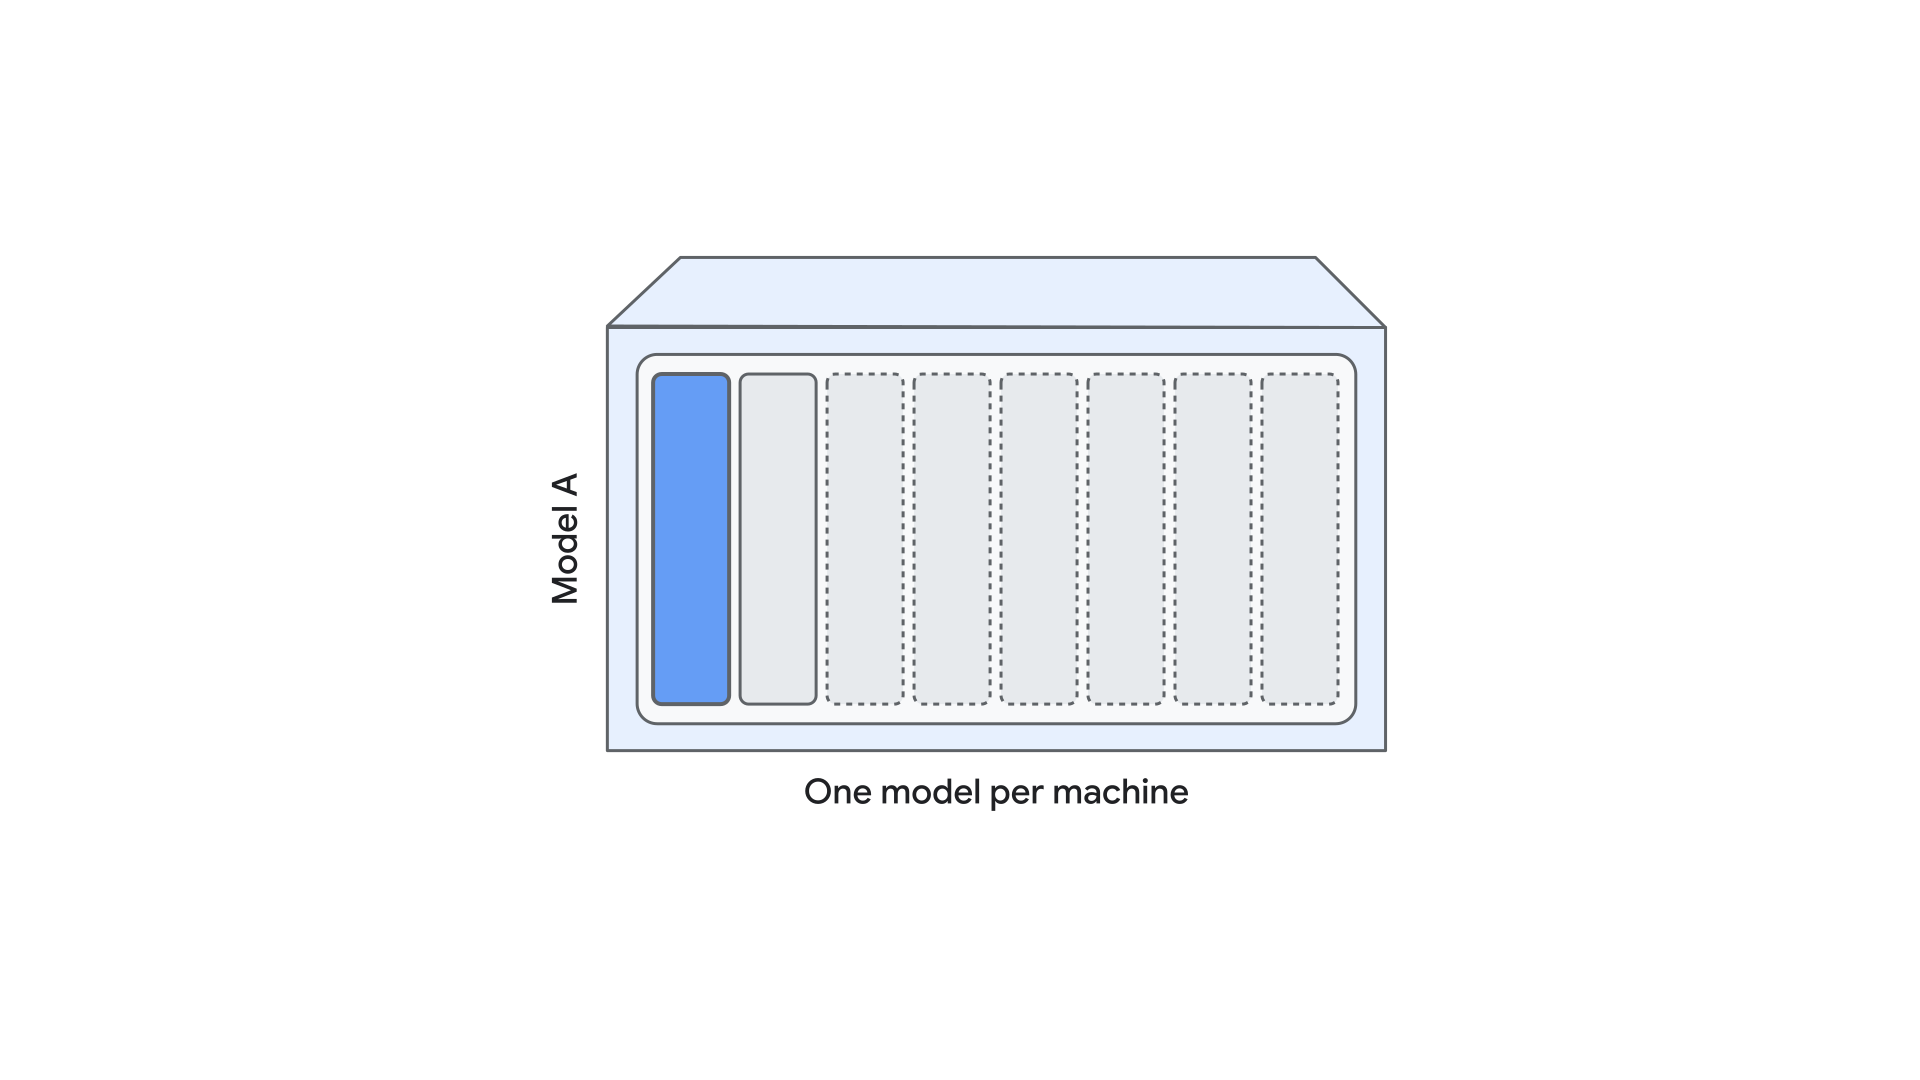
Cliquez pour agrandir l'image.
Le cohébergement de modèles comble ce manque d'efficacité en permettant à plusieurs instances de modèle de partager les mêmes ressources de machine virtuelle et de GPU. Cela inclut des modèles complètement différents, tels que Llama 3.3 et Gemma 3. En utilisant le découpage de la mémoire des sous-GPU et le partitionnement intelligent des ressources, Vertex AI Model Garden transforme les réservations de matériel statiques en pools de calcul flexibles et à haute densité.

Cliquez pour agrandir l'image.
Cet article de blog technique détaille le processus de Vertex AI Engineering pour intégrer la co-hébergement de modèles à un service cloud prêt pour la production. Nous vous présenterons notre méthodologie pour nos stratégies d'implémentation au niveau du conteneur, l'identification des configurations de diffusion optimales et les principaux résultats de notre étude comparative multimodèle approfondie, qui vous permettront de maximiser la rentabilité de la diffusion de vos LLM.
Comprendre la co-hébergement de modèles : concept et architecture
Le co-hébergement de modèles est une stratégie de diffusion à haute densité qui permet à plusieurs instances de grands modèles de langage (LLM) ou à différentes architectures de modèles de partager les mêmes ressources matérielles physiques au sein d'une même machine virtuelle (VM). Contrairement aux modèles de déploiement traditionnels qui dédient une VM ou un GPU complet à un seul modèle, la co-hébergement utilise un partitionnement précis des ressources pour maximiser le ROI du matériel et améliorer l'utilisation de la mémoire et des ressources de calcul.
Notre implémentation se concentre sur une solution au niveau du conteneur qui permet de diffuser simultanément plusieurs modèles avec des configurations indépendantes. Cette architecture fonctionne via plusieurs mécanismes techniques intégrés, à commencer par le déploiement de plusieurs instances de serveur de modèles indépendantes dans un seul conteneur. Chacune de ces instances sert de copie complète et indépendante du serveur de modèles, ce qui permet de traiter simultanément les requêtes sur la machine virtuelle. Pour gérer ce trafic, nous avons implémenté une couche de routage des instances dans le conteneur, qui répartit efficacement les requêtes entrantes entre les instances actives.
Cette conception offre un parallélisme précis en permettant à chaque modèle co-hébergé d'utiliser une configuration de diffusion dédiée, avec des paramètres uniques pour le parallélisme Tensor (TP), le parallélisme de pipeline (PP) et le nombre spécifique d'instances de modèle. Cette approche est complétée par le découpage des ressources, où des partitions de mémoire GPU spécifiques sont attribuées à chaque modèle (par exemple, une partition de mémoire GPU de 0,4 par modèle) pour garantir que diverses charges de travail coexistent sur le même accélérateur sans se priver mutuellement de ressources de mémoire critiques. Cette approche architecturale transforme une réservation matérielle statique, telle qu'un nœud GPU 8x H100 complet, en un pool de calcul flexible capable de diffuser un portefeuille diversifié, allant des grands modèles de raisonnement aux petits modèles de chat à faible latence.
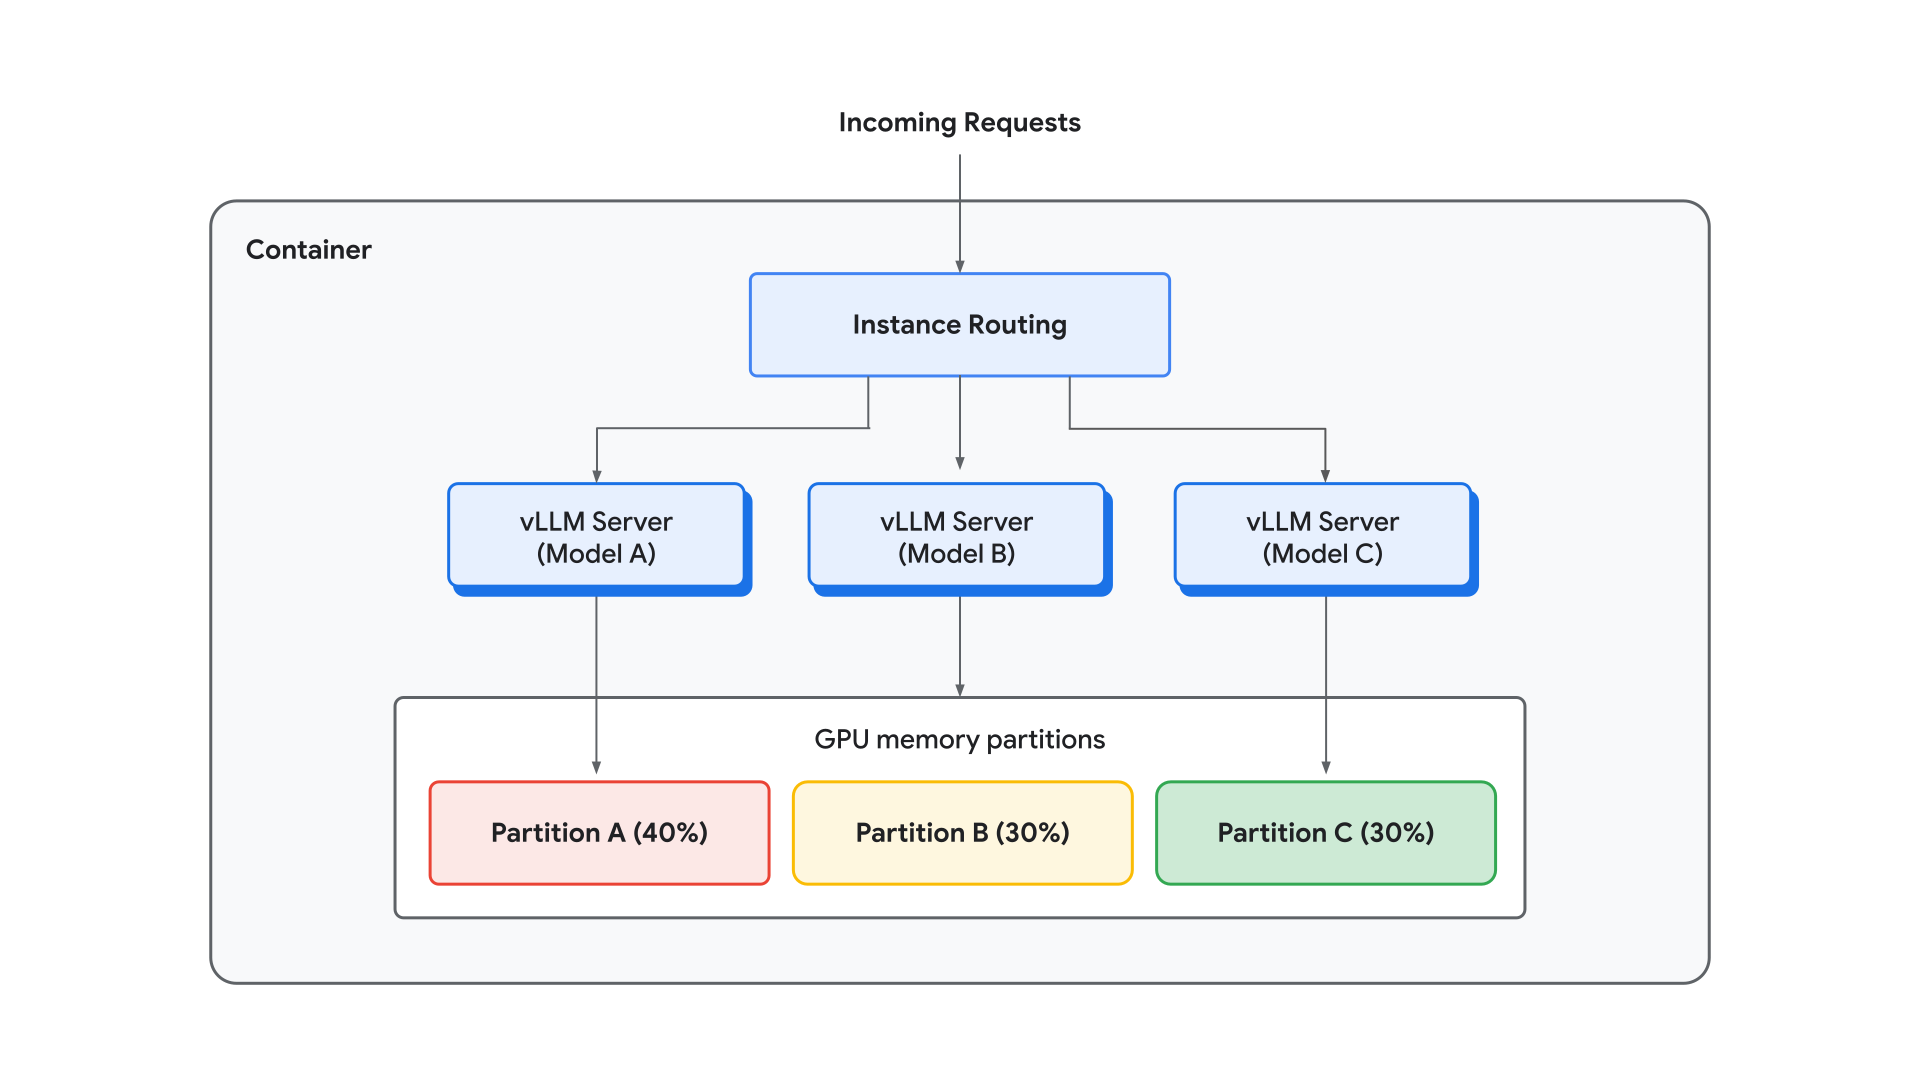
Cliquez pour agrandir l'image.
Étude de prototypage et d'analyse comparative
Avant de développer notre orchestrateur prêt pour la production, nous avons mené une étude comparative complète pour valider l'efficacité théorique de l'hébergement conjoint de modèles. Cette phase visait à tester minutieusement le parallélisme natif de vLLM et à quantifier précisément le degré d'"interférence" lorsque les modèles partagent le même silicium.
Investigation sur le parallélisme : trouver le "point de croisement"
Notre analyse initiale s'est concentrée sur le parallélisme de tenseurs (TP) natif de vLLM et sur l'implémentation Vertex des instances de modèle en tant qu'instances de serveur vLLM multiples afin de déterminer comment ces stratégies interagissent avec des charges utilisateur variables. Nous avons découvert que la configuration optimale dépend fortement de la simultanéité. À des niveaux de simultanéité inférieurs, un parallélisme de tenseur élevé (par exemple, TP=8) offre la latence la plus faible pour les requêtes individuelles en répartissant les couches sur tous les accélérateurs disponibles. Toutefois, à mesure que le trafic simultané augmente, le goulot d'étranglement se déplace. Pour maximiser le débit dans des conditions de charge élevée, la configuration optimale passe de TP=8 à TP=4, TP=2 et enfin TP=1, tout en augmentant simultanément le nombre d'instances de modèle indépendantes. Cette transition définit un "point de croisement" où les avantages d'une latence de communication inter-GPU réduite dans les configurations à faible TP l'emportent sur la vitesse brute d'une exécution à TP élevé. Vous trouverez ci-dessous un graphique des points de croisement avec le modèle Gemma 2 9B IT.
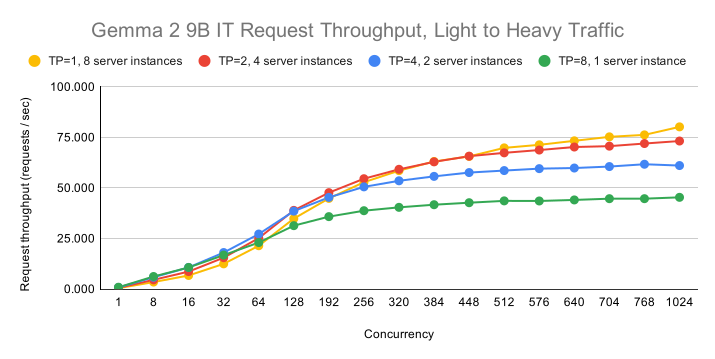
Cliquez pour agrandir l'image.
Scaling optimal : modèle unique, instances répliquées multiples
Pour établir une référence rigoureuse en matière d'évolutivité, nous avons comparé la mise en service de plusieurs instances du même modèle sur un seul nœud. Dans des conditions de trafic saturé (2 048 requêtes simultanées par GPU), le lancement de huit instances de serveur vLLM indépendantes sur un nœud 8xH100 a permis d'améliorer le débit d'environ 7,8 fois, avec une régression de latence pratiquement nulle par rapport à une référence à un seul GPU.
Comparaison des infrastructures : co-programmation de conteneurs et de pods
Nous avons également évalué notre orchestration au niveau des conteneurs par rapport aux solutions natives au niveau de l'infrastructure, en particulier la co-planification des pods. Bien que les deux solutions aient fourni des performances comparables pour la diffusion de plusieurs instances répliquées, nous avons finalement choisi l'approche au niveau du conteneur pour notre produit minimum viable (MVP). Cette décision a été motivée par la flexibilité supérieure qu'offre la solution au niveau du conteneur pour l'hébergement hétérogène, ce qui permet aux développeurs de diffuser différentes architectures de modèles côte à côte avec des partitions de mémoire granulaires définies par logiciel qui ne sont pas limitées par les contraintes de planification Kubernetes sous-jacentes. De plus, l'orchestration au niveau du conteneur permet d'itérer beaucoup plus rapidement, et il est plus facile de personnaliser et d'innover.
Le test d'interférence : co-hébergement de différents modèles
La dernière étape du prototypage a été le "test d'interférence", au cours duquel nous avons co-hébergé Gemma-3n-E2B-it et Llama-3.1-8B-Instruct sur la même VM. Chaque modèle étant associé à une partition de mémoire GPU de 0,4, les performances de diffusion sont restées presque identiques à celles des benchmarks à modèle unique. Par exemple, Gemma-3n a atteint 30,21 reqs dans un environnement co-hébergé, contre 30,96 reqs en isolation. Ces résultats confirment qu'il n'y a que peu ou pas d'interférences de calcul entre les modèles co-hébergés, même en cas de trafic important, à condition que les ressources de mémoire soient correctement partitionnées pour éviter l'épuisement du cache KV.
Implémentation du conteneur MVP
Le passage d'un benchmark validé à un système prêt pour la production a nécessité l'ingénierie d'un orchestrateur conteneurisé robuste. Cette phase de développement s'est concentrée sur la création d'une couche logicielle de haut niveau capable de gérer les complexités de plusieurs cycles de vie de modèles tout en garantissant une isolation déterministe des ressources.
Conception du serveur de co-hébergement de modèles
Le cœur de notre implémentation est model_cohost_server, un point d'entrée personnalisé conçu pour agir en tant qu'orchestrateur maître dans le conteneur. Contrairement au modèle standard à processus unique, ce serveur implémente la gestion des sous-processus, ce qui facilite l'exécution simultanée de plusieurs instances de serveur de modèles indépendantes (comme vLLM) en tant que sous-processus isolés. Pour gérer le trafic entrant, l'orchestrateur utilise un routage des requêtes de haut niveau, en identifiant les requêtes par leurs identifiants de modèle uniques via des arguments tels que --served-model-name et en les dirigeant vers l'instance de serveur interne correspondante. Au-delà du routage, le serveur fournit une orchestration complète du cycle de vie, en gérant l'initialisation, la surveillance de l'état et l'arrêt de toutes les instances co-hébergées. Cette gestion centralisée fournit un point de terminaison unique et unifié pour le trafic externe, tout en maintenant les limites opérationnelles distinctes de chaque sous-processus.
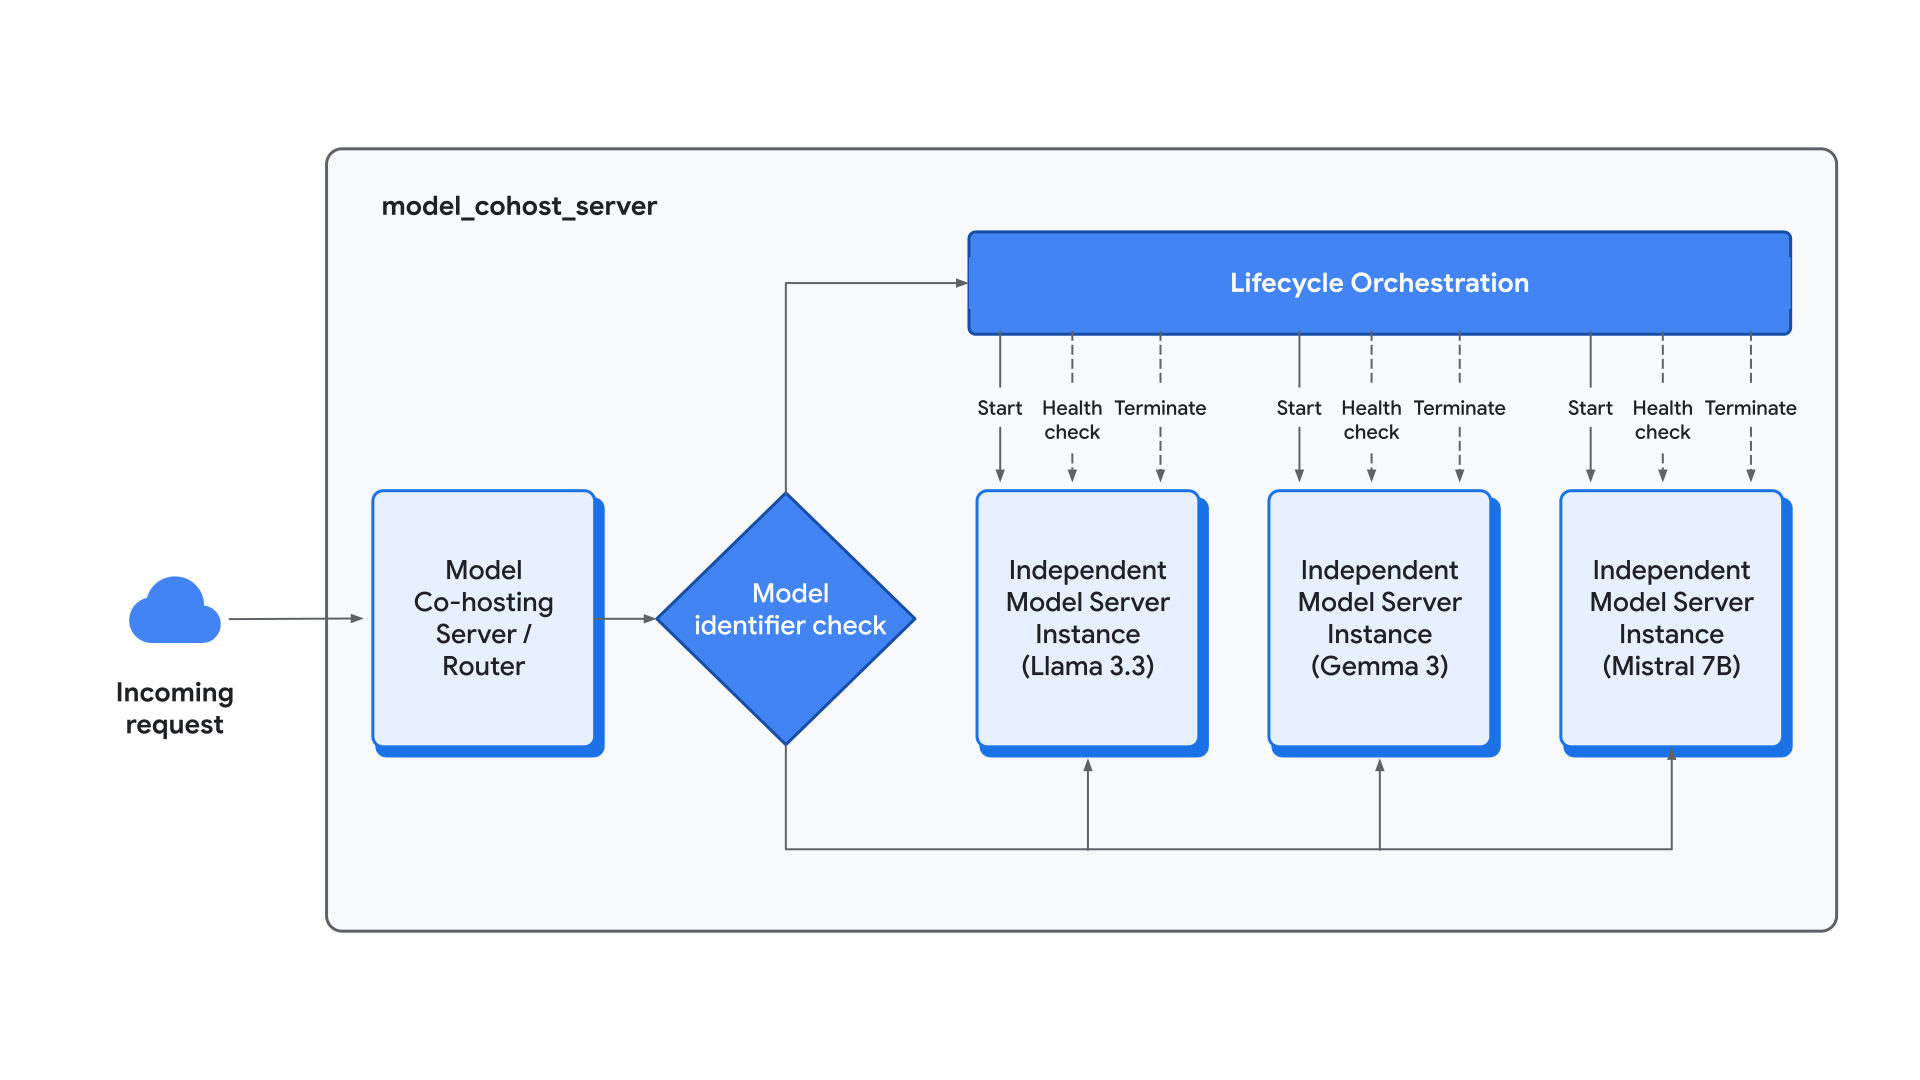
Cliquez pour agrandir l'image.
Partitionnement des ressources GPU : découpage déterministe
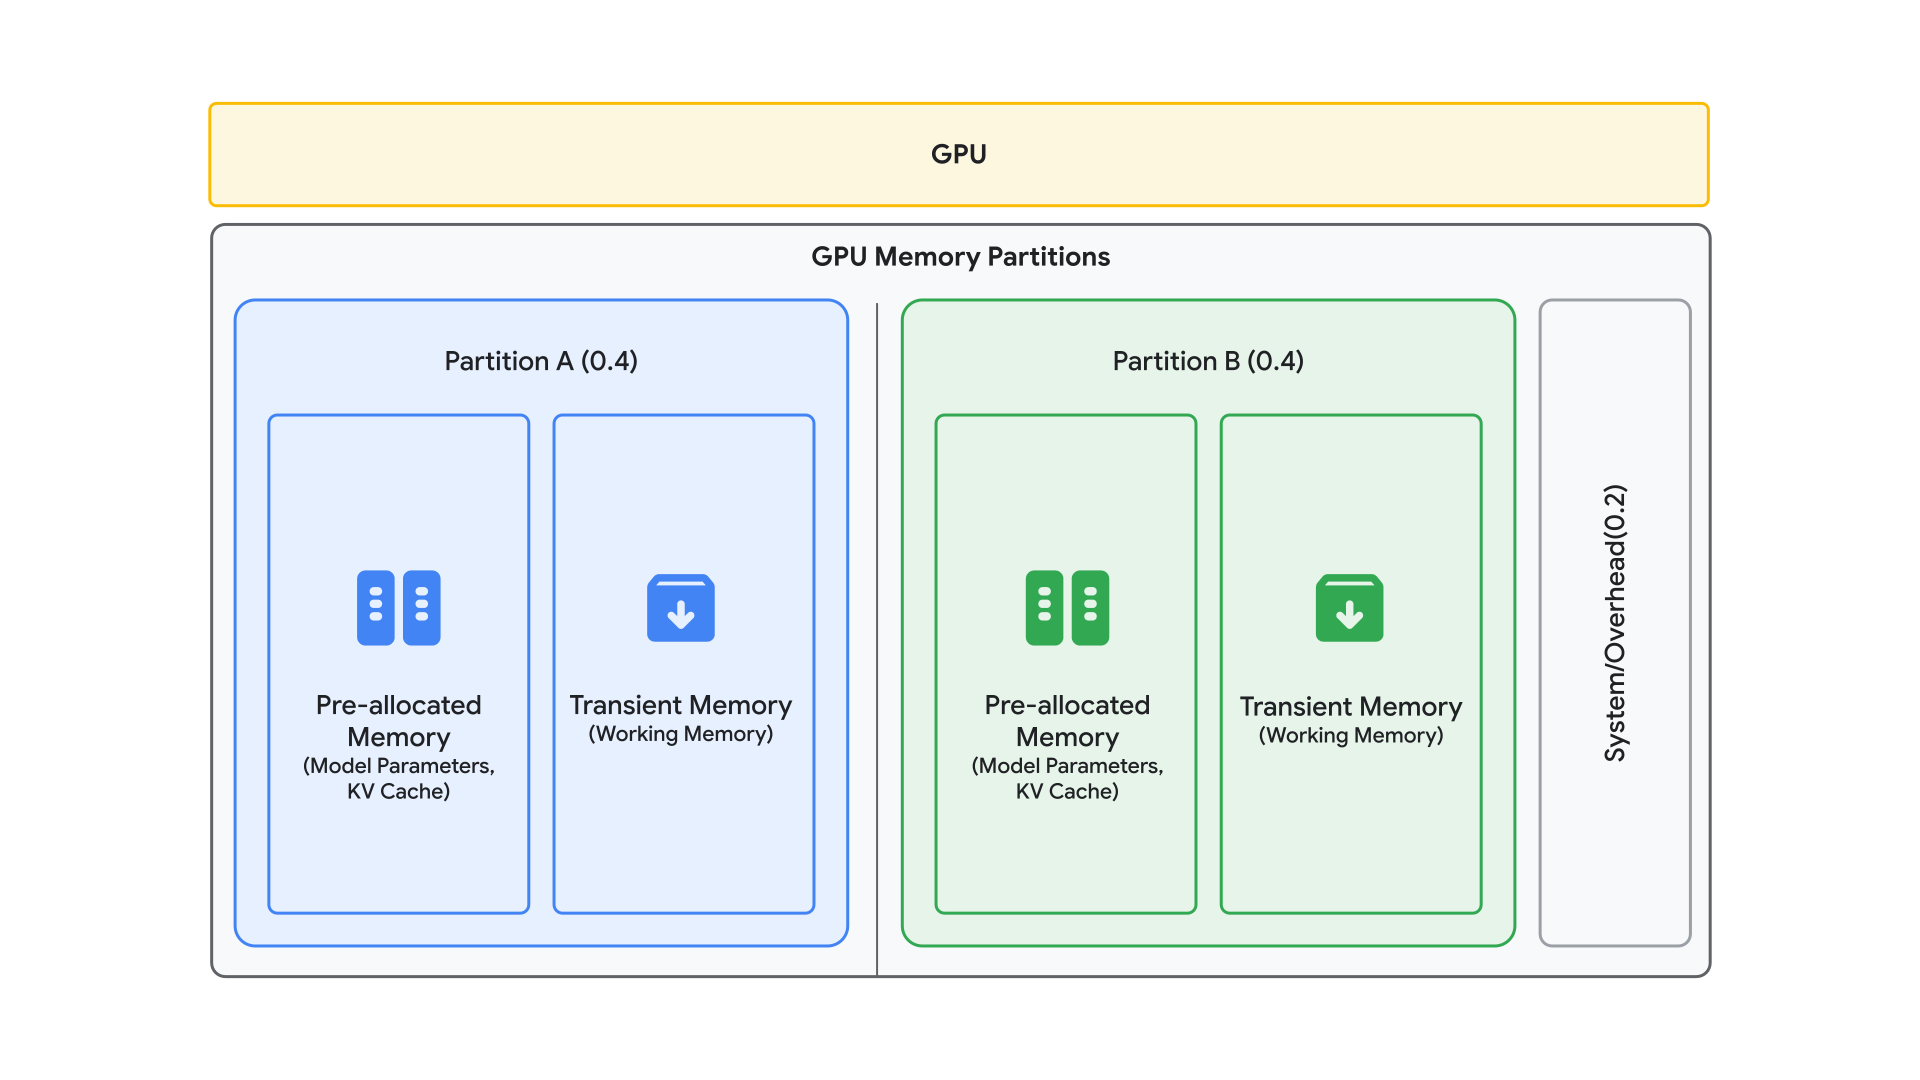
Pour éliminer le risque que la charge de travail d'un seul modèle déclenche une erreur de mémoire insuffisante (OOM) dans l'environnement co-hébergé, nous avons mis en place un mécanisme strict de découpage des ressources. Cela est mis en œuvre via l'argument gpu-memory-partition, qui permet aux développeurs de définir des ratios de mémoire explicites (par exemple, 0,4, 0,4) pour réserver un pourcentage fixe de la mémoire GPU totale d'un nœud pour chaque instance de modèle individuelle.
Pour guider cette allocation, nous adoptons un modèle de mémoire "préallouée ou temporaire", qui distingue les besoins en ressources statiques et dynamiques.
La mémoire "préallouée" correspond à la mémoire utilisée pour les pondérations du modèle et le cache KV. La quantité de mémoire utilisée pour les pondérations du modèle dépend du nombre de paramètres et de la précision du modèle. Par exemple, un modèle de 8 milliards de paramètres en BF16 nécessite environ 16 Go d'espace de stockage statique. La quantité de mémoire utilisée pour le cache KV dépend des dimensions du modèle, de la précision, de la longueur de contexte et du nombre de séquences. La mémoire "transitoire" se compose de calculs intermédiaires et de la mémoire de travail d'inférence. L'argument gpu-memory-partition tient compte de la mémoire "pré-allouée". Nous vous recommandons de laisser de la place pour la mémoire "transitoire" en définissant la somme des gpu-memory-partition sur une valeur inférieure à 1,0.
Cliquez pour agrandir l'image.
Productisation
La phase de mise en production de la co-hébergement de modèles avec Vertex AI a été consacrée à l'établissement d'un environnement fluide et prêt pour la production pour les configurations de diffusion à modèle unique et à plusieurs instances répliquées, ainsi que pour les configurations de diffusion à plusieurs modèles. Cette transition a permis de traduire efficacement les résultats empiriques des analyses comparatives en workflows de déploiement simplifiés et en structures de support d'infrastructure profondément intégrées.
Workflows de déploiement simplifiés
Pour faciliter l'accès à la diffusion haute densité, nous avons standardisé les configurations de co-hébergement à l'aide d'arguments de conteneur personnalisés qui s'intègrent de manière native aux API Vertex AI existantes. Pour les machines virtuelles de forme complète, telles qu'un nœud 8x H100, nous avons développé un utilitaire de benchmark afin de personnaliser les meilleures recettes pour vos cas d'utilisation spécifiques. Cet utilitaire de benchmark vous permet de trouver la configuration qui équilibre automatiquement le parallélisme Tensor (TP), le parallélisme de pipeline (PP) et le nombre d'instances de modèle en fonction du nombre de paramètres et de la précision du modèle. Cette fonctionnalité est complétée par une compatibilité robuste avec l'API Deployment, qui permet aux développeurs de spécifier ces paramètres précis (y compris les partitions de mémoire GPU exactes) directement dans une requête deployModel standard et de déployer des modèles.
Mise en service dynamique multimodèle
Une avancée majeure dans notre parcours technique a été la transition de configurations statiques vers une architecture de diffusion dynamique. Cette fonctionnalité est essentielle pour les environnements de production caractérisés par des schémas de trafic qui évoluent rapidement, car la possibilité de charger ou de décharger des modèles sans redémarrer complètement le conteneur est essentielle pour maintenir l'agilité de l'infrastructure et une haute disponibilité.
L'API Dynamic Update (update_models)
Pour remédier aux limites inhérentes aux déploiements immuables, nous avons implémenté une API de mise à jour de modèle spécialisée dans le conteneur de co-hébergement de modèles vLLM de Vertex Model Garden. Cette API facilite le rechargement à chaud, ce qui permet au serveur d'ajuster son portefeuille de modèles hébergés à la volée en fonction d'un fichier de configuration centralisé stocké dans un bucket Google Cloud Storage (GCS).
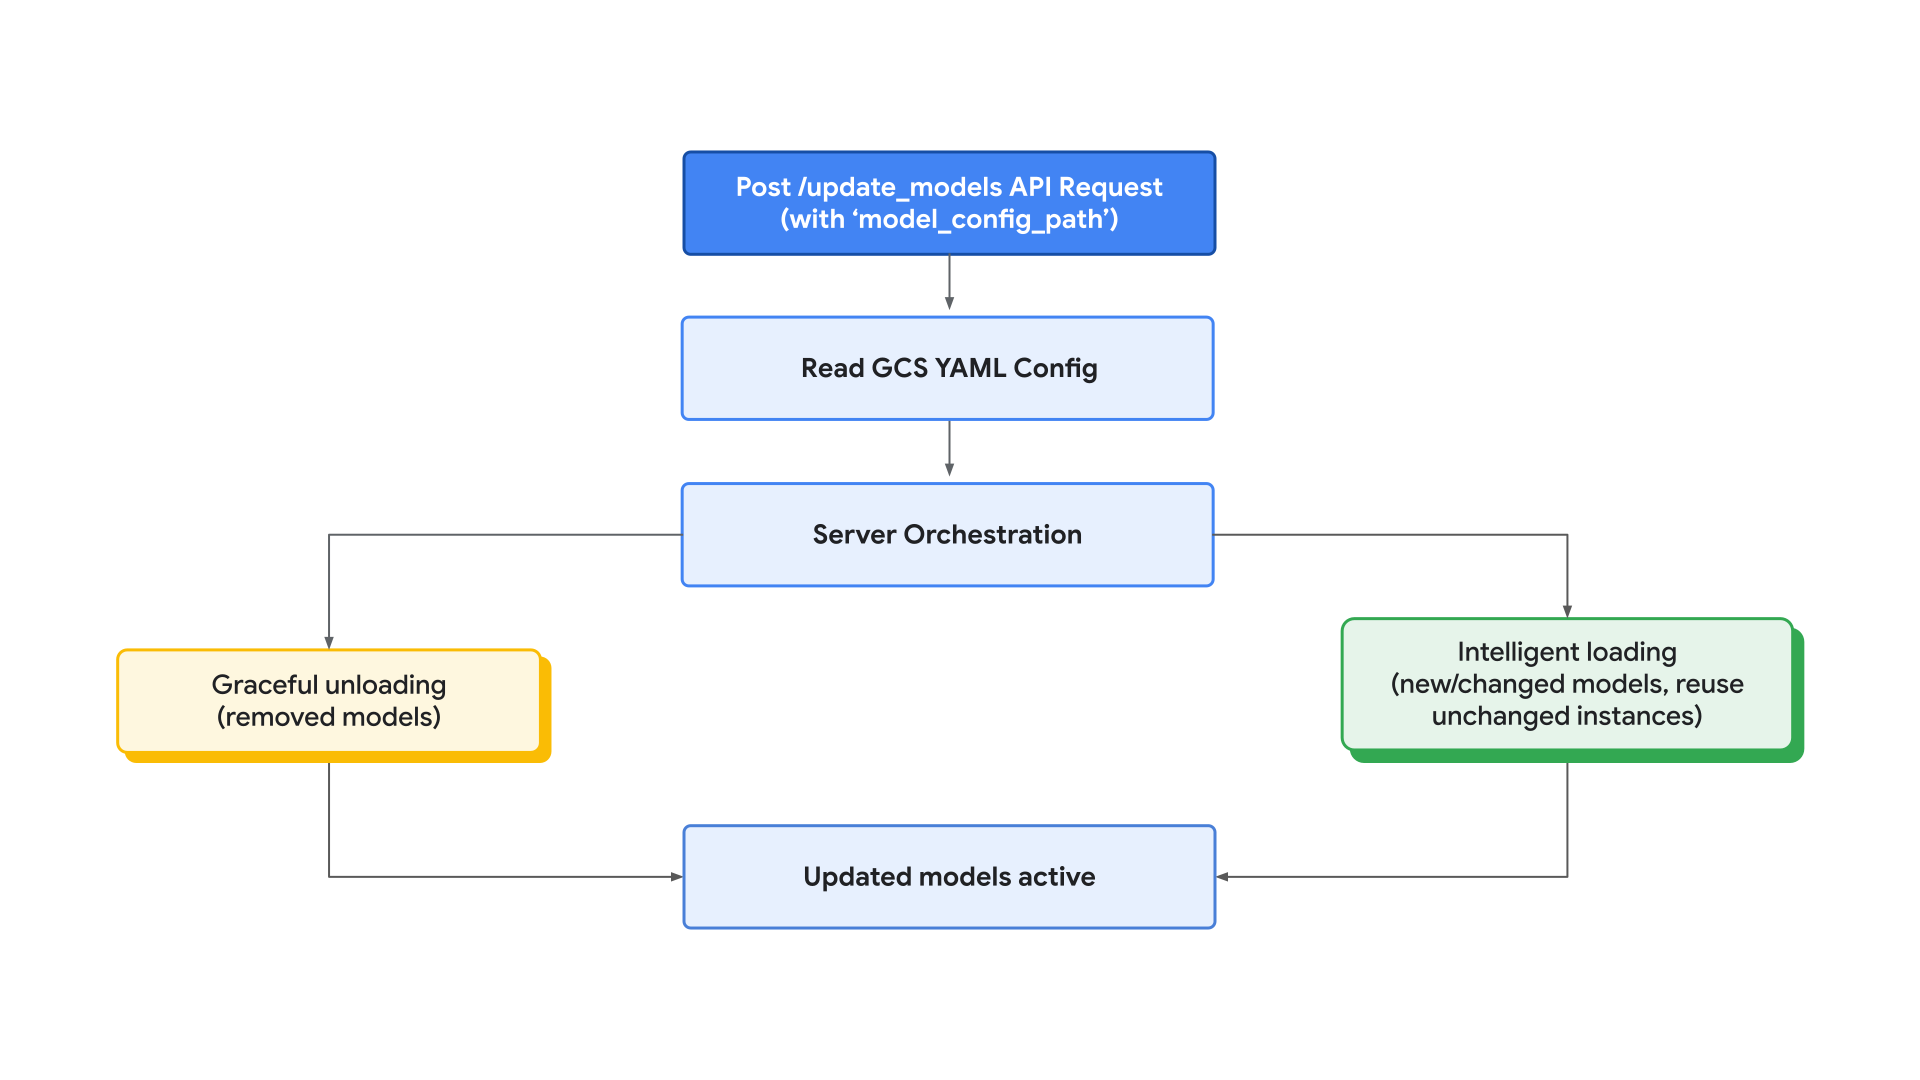
Le processus de mise à jour est lancé via une requête POST envoyée au point de terminaison update_models, qui inclut le model_config_path pointant vers le fichier YAML GCS.
À la réception de cette requête, le serveur exécute une séquence d'orchestration en plusieurs étapes optimisée pour un temps d'arrêt minimal :
- Déchargement progressif : le système identifie les modèles absents de la nouvelle configuration et met d'abord fin à leurs sous-processus, ce qui permet de récupérer immédiatement la mémoire et les ressources de calcul du GPU.
- Chargement et réutilisation intelligents : le serveur initialise ensuite de nouvelles instances de modèle. Surtout, si les paramètres de parallélisme d'un modèle (comme le parallélisme de tenseur (TP) ou le parallélisme de pipeline (PP)) et sa partition de mémoire allouée restent inchangés, l'orchestrateur réutilise l'instance en cours d'exécution existante. Cette optimisation permet d'éviter la phase de réinitialisation coûteuse, ce qui garantit que les services actifs ne sont pas interrompus lors des changements de configuration.
Cliquez pour agrandir l'image.
Analyse de la latence et des performances
L'analyse empirique de ces stratégies de mise à jour révèle que le rechargement à chaud dynamique atténue considérablement la pénalité de "démarrage à froid" généralement associée à la diffusion de LLM à grande échelle.
Conclusion
La co-hébergement de modèles avec Vertex AI représente un changement de paradigme fondamental, passant de déploiements monolithiques rigides et gourmands en matériel à une architecture de diffusion fluide et efficace. En allant au-delà de la norme "un modèle par VM" pour adopter un modèle de pool de calcul à haute densité, les entreprises peuvent réduire considérablement leur coût total de possession (TCO) tout en maintenant, et souvent en améliorant, les benchmarks de performances.
Notre parcours d'ingénierie et nos études comparatives approfondies sur plusieurs modèles ont permis d'établir un ensemble définitif de consignes de production pour cette architecture :
- Il n'existe pas de configuration universelle. Nous préconisons de trouver la meilleure recette de diffusion pour un cas d'utilisation spécifique (modèle, matériel, trafic) et de créer des outils pour y parvenir.
- Scaling du débit avec des instances répliquées.
- Améliorez l'utilisation des ressources en éliminant les limites matérielles et en fractionnant la mémoire à un niveau plus précis.
Pour implémenter correctement une architecture co-hébergée, nous vous recommandons le workflow technique suivant :
- Partitionnement explicite : utilisez l'argument
--gpu-memory-partitionspour allouer des ressources de mémoire à des modèles individuels. - Analyse comparative itérative : utilisez l'utilitaire d'analyse comparative fourni pour identifier le point de "croisement de simultanéité" spécifique à votre charge de travail, c'est-à-dire la configuration idéale du nombre d'instances, de TP et de PP.
L'implémentation de la co-hébergement sur Google Cloud Model Garden fournit un plan évolutif pour créer des applications d'IA à haute densité. Nous encourageons les développeurs à explorer ces fonctionnalités et à reproduire nos benchmarks à l'aide du notebook du tutoriel fourni pour optimiser les configurations de diffusion en fonction des exigences spécifiques de leur entreprise.
Merci pour votre attention
N'hésitez pas à nous faire part de vos commentaires et questions sur Vertex AI.
Remerciements
Nous tenons à exprimer notre sincère gratitude à l'équipe Google Cloud Vertex AI. Nous remercions en particulier Bo Wu et Ting Yu pour leur leadership et leurs conseils, ainsi que Deborah He, Shawn Ma, Desmond Liu, Yang Pan, Surya K G Tangatur et Luis Rizo pour leurs contributions inestimables tout au long de ce projet.