

In der sich ständig weiterentwickelnden Landschaft der Large Language Models (LLMs) wird das Bereitstellungsmuster „ein Modell pro Maschine“ zu einem erheblichen Engpass für die Kosteneffizienz der LLM-Bereitstellung in Unternehmen. LLMs erfordern oft erhebliche Hardwarereservierungen, z. B. vollständige 8x H100-GPU-Knoten, um Spitzenlasten zu bewältigen. Im Normalbetrieb werden diese teuren Ressourcen jedoch oft nicht ausgelastet, was zu hohen Gesamtbetriebskosten (TCO) führt.
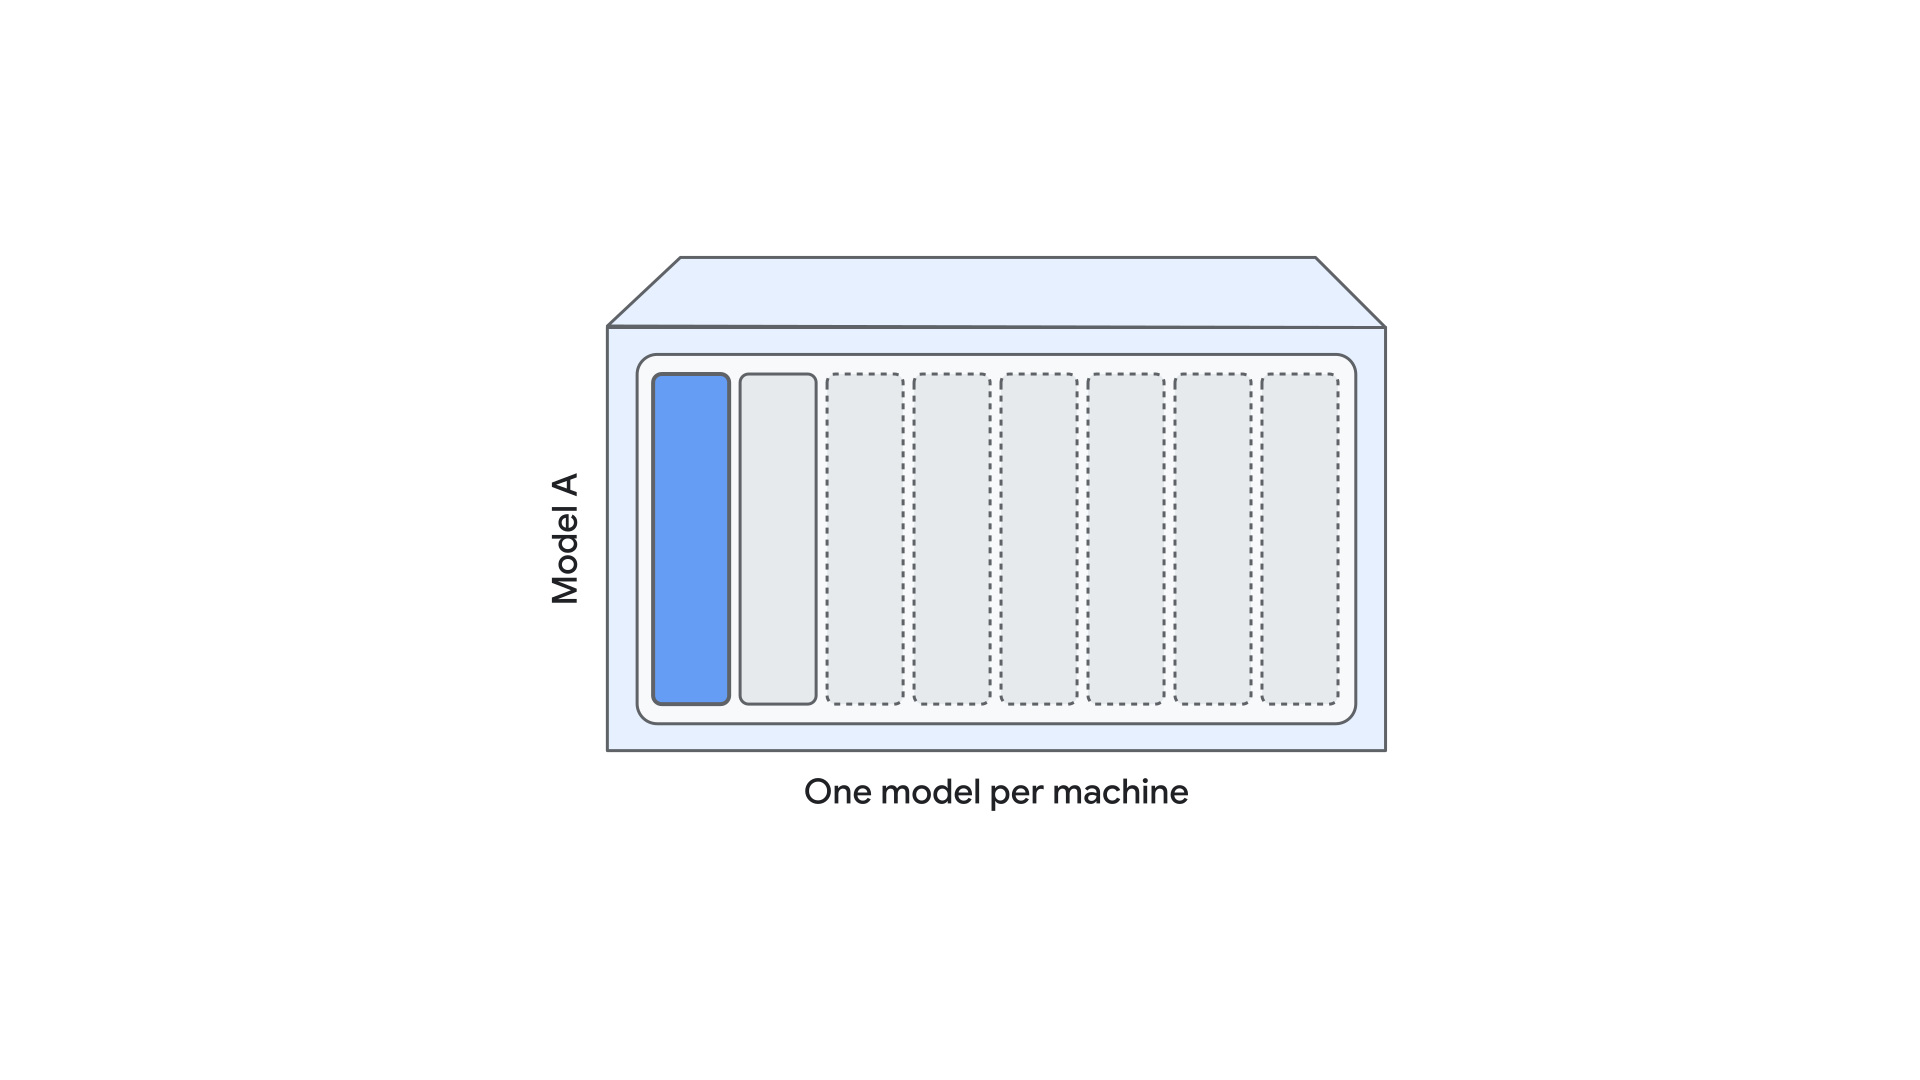
Zum Vergrößern auf das Bild klicken
Modell-Co-Hosting schließt diese Effizienzlücke, indem mehrere Modellinstanzen dieselben virtuellen Maschinen und GPU-Ressourcen gemeinsam nutzen können. Dazu gehören auch völlig andere Modelle wie Llama 3.3 und Gemma 3. Durch die Nutzung von Sub-GPU-Speicher-Slicing und intelligenter Ressourcenpartitionierung wandelt Vertex AI Model Garden statische Hardwarereservierungen in flexible, hochdichte Computing-Pools um.

Zum Vergrößern auf das Bild klicken
In diesem technischen Blog wird der Prozess von Vertex AI Engineering beschrieben, mit dem das Modell-Co-Hosting zu einem produktionsreifen Cloud-Dienst gemacht wurde. Wir stellen Ihnen unsere Methodik für Implementierungsstrategien auf Containerebene vor, zeigen Ihnen, wie Sie optimale Bereitstellungskonfigurationen ermitteln, und präsentieren Ihnen die wichtigsten Ergebnisse unserer umfangreichen Multi-Modell-Benchmark-Studie, damit Sie die Kosteneffizienz Ihrer LLM-Bereitstellung maximieren können.
Modell-Co-Hosting: Konzept und Architektur
Das Co-Hosting von Modellen ist eine Strategie für die Bereitstellung mit hoher Dichte, bei der mehrere LLM-Instanzen (Large Language Model) oder verschiedene Modellarchitekturen dieselben physischen Hardwareressourcen innerhalb einer einzelnen virtuellen Maschine (VM) gemeinsam nutzen können. Im Gegensatz zu herkömmlichen Bereitstellungsmodellen, bei denen eine vollständige VM oder GPU einem einzelnen Modell zugewiesen wird, wird beim Co-Hosting eine detaillierte Ressourcenpartitionierung verwendet, um den Hardware-ROI zu maximieren und die Auslastung von Speicher- und Rechenressourcen zu verbessern.
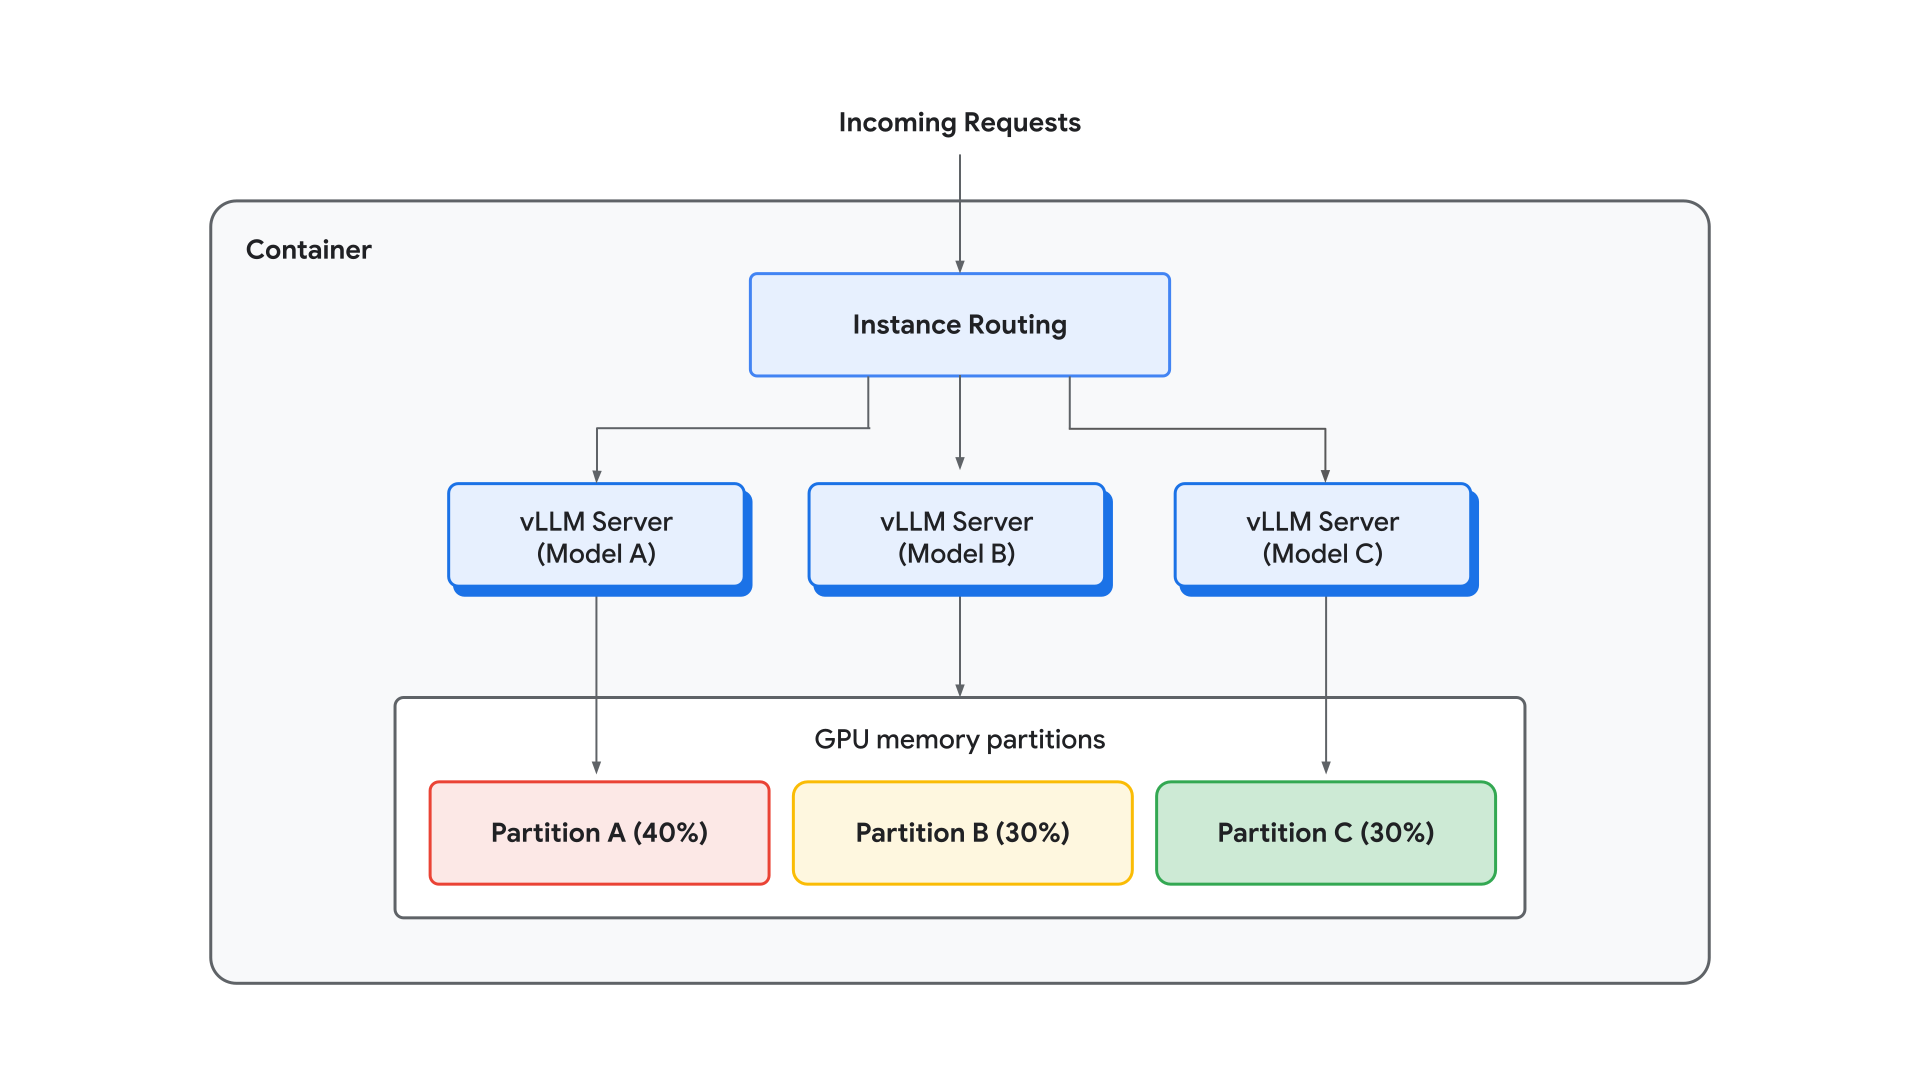
Unsere Implementierung konzentriert sich auf eine Lösung auf Containerebene, die die gleichzeitige Bereitstellung mehrerer Modelle mit unabhängigen Konfigurationen ermöglicht. Diese Architektur funktioniert über mehrere integrierte technische Mechanismen, beginnend mit der Bereitstellung mehrerer unabhängiger Modellserverinstanzen in einem einzelnen Container. Jede dieser Instanzen dient als vollständige, unabhängige Kopie des Modellservers, sodass Anfragen auf der virtuellen Maschine gleichzeitig verarbeitet werden können. Um diesen Traffic zu verwalten, haben wir eine Instanzrouting-Ebene im Container implementiert, die eingehende Anfragen effizient auf die aktiven Instanzen verteilt.
Dieses Design bietet eine detaillierte Parallelität, da jedes gemeinsam gehostete Modell eine dedizierte Bereitstellungskonfiguration mit eindeutigen Einstellungen für Tensor-Parallelität (TP), Pipeline-Parallelität (PP) und die spezifische Anzahl von Modellinstanzen verwenden kann. Dies wird durch die Ressourcenaufteilung ergänzt, bei der jedem Modell bestimmte GPU-Speicherpartitionen zugewiesen werden, z. B. eine 0,4-GPU-Speicherpartition pro Modell. So wird sichergestellt, dass verschiedene Arbeitslasten auf demselben Beschleuniger koexistieren können, ohne dass es zu einem Mangel an wichtigen Speicherressourcen kommt. Dieser Architekturansatz wandelt eine statische Hardwarereservierung, z. B. einen vollständigen 8x-H100-GPU-Knoten, in einen flexiblen Rechenpool um, der ein vielfältiges Portfolio bedienen kann – von großen Reasoning-Modellen bis hin zu kleinen Chatmodellen mit niedriger Latenz.
Zum Vergrößern auf das Bild klicken
Prototyping und Benchmark-Studie
Bevor wir unseren produktionsreifen Orchestrator entwickelt haben, haben wir eine umfassende Benchmark-Studie durchgeführt, um die theoretische Effizienz des Modell-Co-Hostings zu validieren. In dieser Phase sollte die native Parallelität von vLLM gründlich getestet und der Grad der „Interferenz“ genau quantifiziert werden, wenn Modelle dieselbe Hardware nutzen.
Untersuchung der Parallelität: Den „Übergangspunkt“ finden
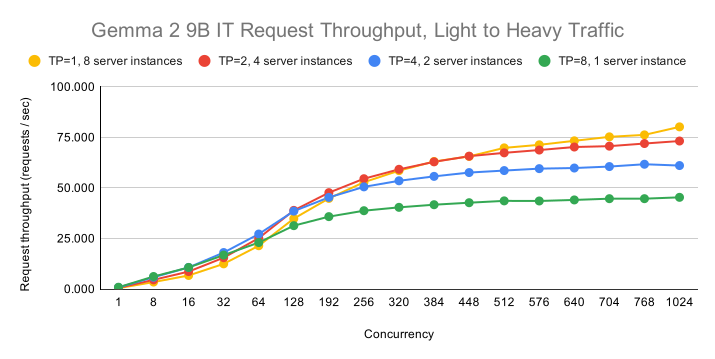
Unsere erste Analyse konzentrierte sich auf den nativen Tensor-Parallelismus (TP) von vLLM und die Vertex-Implementierung von Modellinstanzen als mehrere vLLM-Serverinstanzen, um zu ermitteln, wie diese Strategien mit unterschiedlichen Nutzerlasten interagieren. Wir haben festgestellt, dass die optimale Konfiguration stark von der Nebenläufigkeit abhängt. Bei geringerer Nebenläufigkeit bietet ein hoher Tensor-Parallelismus (z. B. TP=8) die niedrigste Latenz für einzelne Anfragen, da die Schichten auf alle verfügbaren Beschleuniger verteilt werden. Wenn der gleichzeitige Traffic jedoch zunimmt, verschiebt sich der Engpass. Um den Durchsatz unter hoher Last zu maximieren, wechselt die optimale Konfiguration von TP=8 zu TP=4, TP=2 und schließlich TP=1, während gleichzeitig die Anzahl der unabhängigen Modellinstanzen erhöht wird. Dieser Übergang definiert einen „Crossover-Punkt“, an dem die Vorteile einer reduzierten Latenz bei der GPU-zu-GPU-Kommunikation in Setups mit niedriger TP die reine Geschwindigkeit der Ausführung mit hoher TP überwiegen. Im Folgenden finden Sie ein Diagramm mit dem Crossover-Punkt für das Gemma 2 9B IT-Modell.
Zum Vergrößern auf das Bild klicken
Optimale Skalierung: Einzelnes Modell, mehrere Replikate
Um eine solide Grundlage für die Skalierbarkeit zu schaffen, haben wir die Bereitstellung mehrerer Instanzen desselben Modells auf einem einzelnen Knoten getestet. Unter gesättigten Traffic-Bedingungen (2.048 gleichzeitige Anfragen pro GPU) führte das Starten von acht unabhängigen vLLM-Serverinstanzen auf einem 8xH100-Knoten zu einer ungefähren 7,8-fachen Durchsatzverbesserung bei praktisch null Latenzregression im Vergleich zu einer Baseline mit einer einzelnen GPU.
Infrastrukturvergleich: Container- und Pod-Co-Scheduling
Wir haben unsere Orchestrierung auf Containerebene mit nativen Lösungen auf Infrastrukturebene verglichen, insbesondere mit der gemeinsamen Planung von Pods. Beide Lösungen lieferten eine vergleichbare Leistung für die Bereitstellung mit mehreren Replikaten. Letztendlich haben wir uns für den Ansatz auf Containerebene für unser Minimum Viable Product (MVP) entschieden. Diese Entscheidung wurde durch die überlegene Flexibilität der Lösung auf Containerebene für das heterogene Co-Hosting beeinflusst. Entwickler können damit verschiedene Modellarchitekturen nebeneinander mit detaillierten, softwaredefinierten Speicherpartitionen bereitstellen, die nicht durch zugrunde liegende Kubernetes-Planungseinschränkungen eingeschränkt sind. Darüber hinaus ermöglicht die Orchestrierung auf Containerebene eine viel schnellere Iteration und erleichtert die Anpassung und Innovation.
Der Interferenztest: Co-Hosting verschiedener Modelle
Der letzte Meilenstein beim Prototyping war der „Interferenztest“, bei dem wir Gemma-3n-E2B-it und Llama-3.1-8B-Instruct auf derselben VM gehostet haben. Da jedem Modell eine GPU-Speicherpartition von 0,4 zugewiesen wurde, blieb die Bereitstellungsleistung nahezu identisch mit den Benchmarks für einzelne Modelle. Beispiel: Gemma-3n erreichte 30,21 Anfragen in einer gemeinsam gehosteten Umgebung im Vergleich zu 30,96 Anfragen in einer isolierten Umgebung. Diese Ergebnisse bestätigen, dass es zwischen gemeinsam gehosteten Modellen kaum oder gar keine Recheninterferenzen gibt, selbst bei hohem Traffic, sofern die Speicherressourcen angemessen partitioniert sind, um eine KV-Cache-Starvation zu verhindern.
MVP-Containerimplementierung
Für den Übergang von einem validierten Benchmark zu einem produktionsreifen System war die Entwicklung eines robusten, containerisierten Orchestrators erforderlich. In dieser Entwicklungsphase ging es darum, eine übergeordnete Softwareschicht zu erstellen, die die Komplexität mehrerer Modelllebenszyklen bewältigen und gleichzeitig eine deterministische Ressourcenisolation gewährleisten kann.
Serverdesign für das Co-Hosting von Modellen
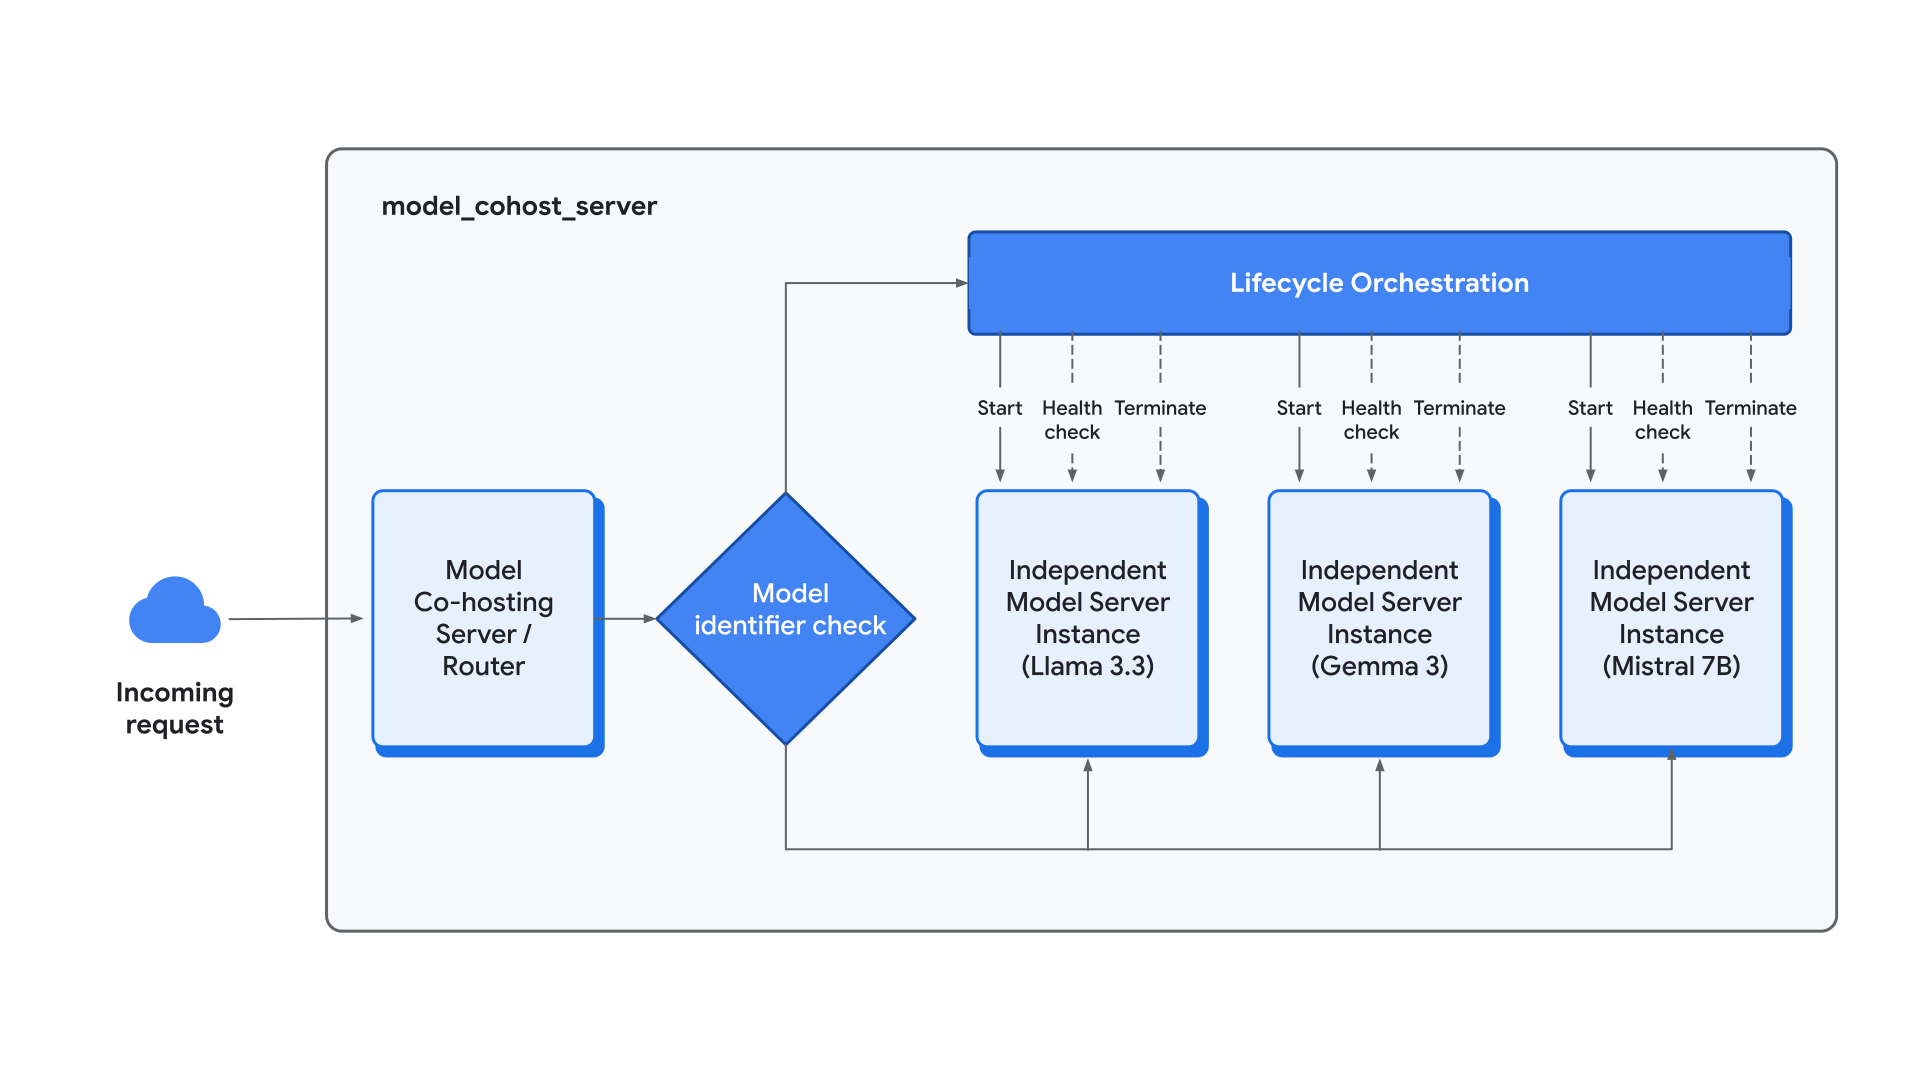
Das Herzstück unserer Implementierung ist der model_cohost_server, ein benutzerdefinierter Einstiegspunkt, der als Master-Orchestrator im Container fungiert. Dieser Server weicht vom standardmäßigen Einzelprozessmodell ab und implementiert die Verwaltung von Unterprozessen. Dadurch können mehrere unabhängige Modellserverinstanzen wie vLLM gleichzeitig als isolierte Unterprozesse ausgeführt werden. Zur Verwaltung des eingehenden Traffics verwendet der Orchestrator ein allgemeines Anfragerouting. Dabei werden Anfragen anhand ihrer eindeutigen Modellkennungen über Argumente wie --served-model-name identifiziert und an die entsprechende interne Serverinstanz weitergeleitet. Neben dem Routing bietet der Server eine umfassende Lebenszyklus-Orchestrierung, die die Initialisierung, das Zustandsmonitoring und die Beendigung aller gemeinsam gehosteten Instanzen verwaltet. Diese zentrale Verwaltung bietet einen einzigen, einheitlichen Endpunkt für externen Traffic und behält gleichzeitig die unterschiedlichen Betriebsgrenzen der einzelnen Unterprozesse bei.
Zum Vergrößern auf das Bild klicken
GPU-Ressourcenpartitionierung: Deterministisches Slicing
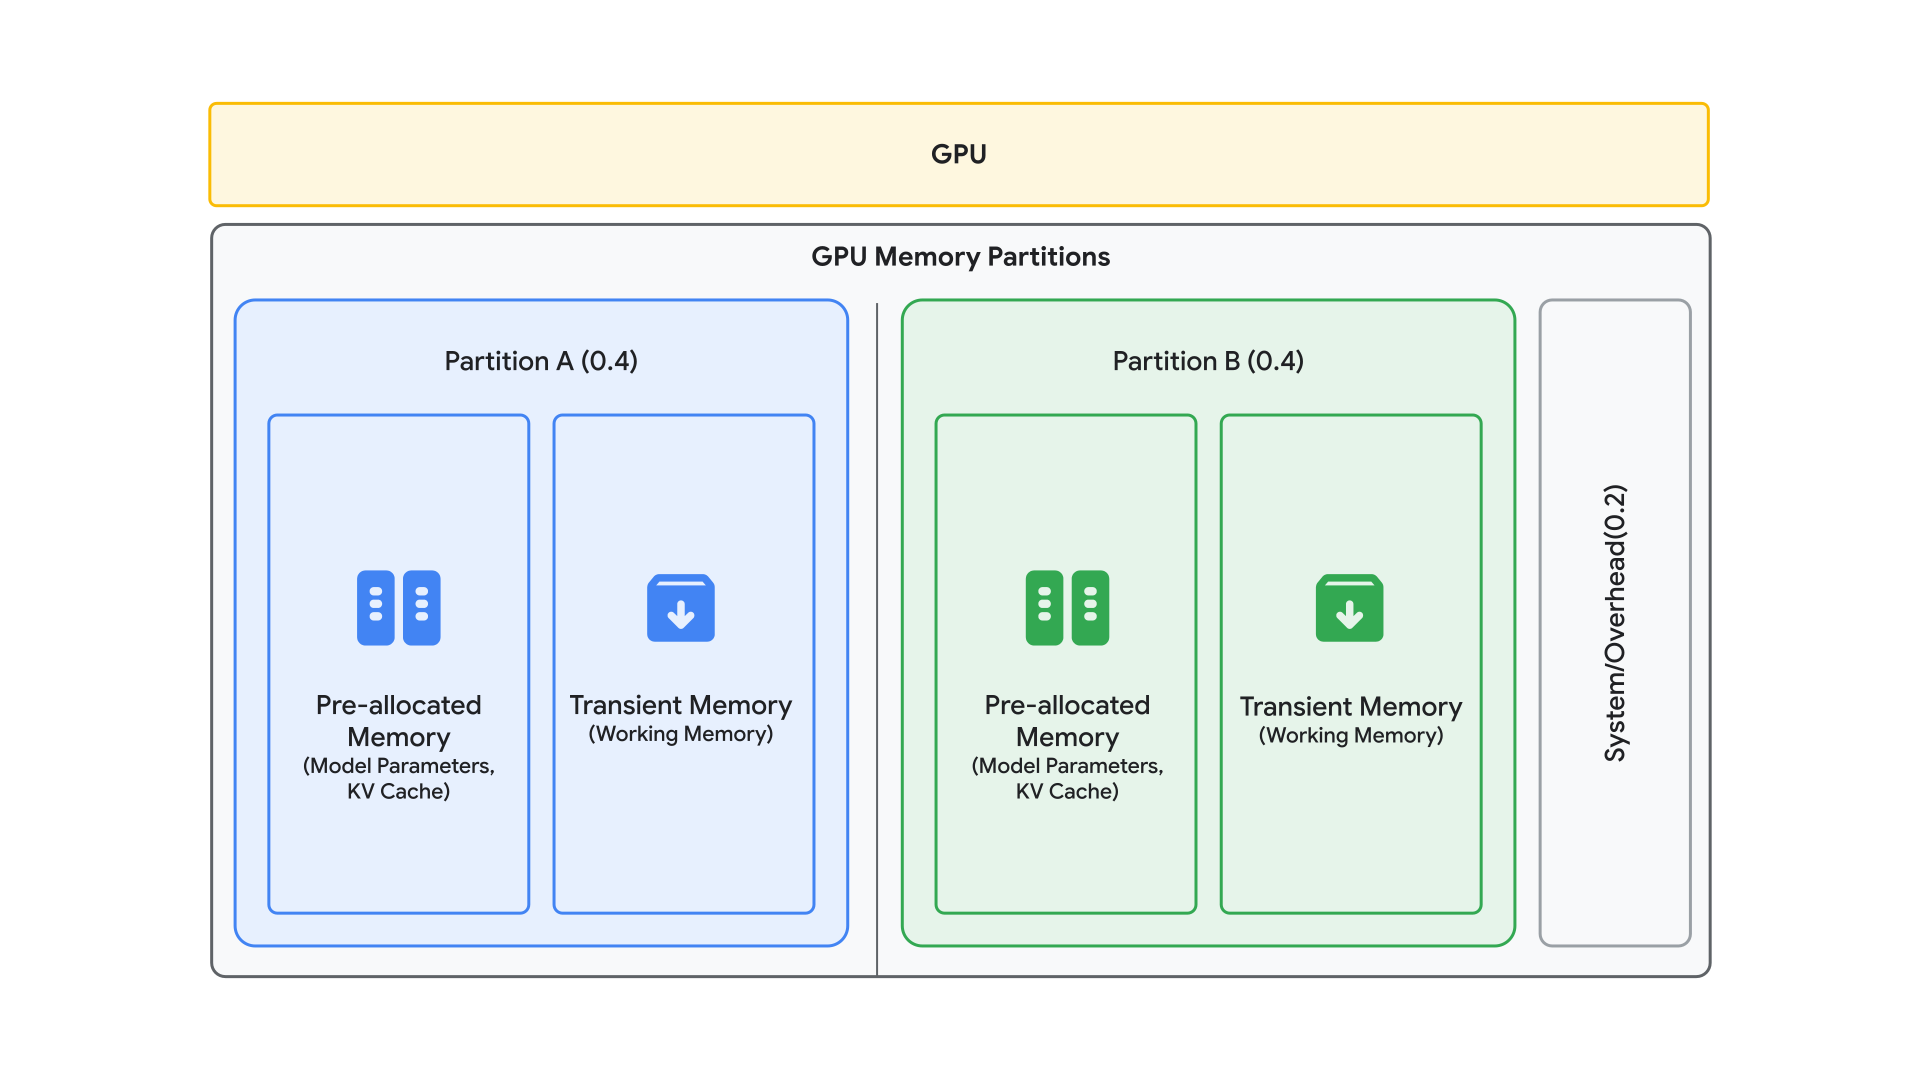
Um das Risiko zu eliminieren, dass die Arbeitslast eines einzelnen Modells einen Out-of-Memory-Fehler (OOM) in der gemeinsam gehosteten Umgebung auslöst, haben wir einen strikten Mechanismus zur Ressourcenaufteilung implementiert. Dies wird über das Argument gpu-memory-partition umgesetzt, mit dem Entwickler explizite Arbeitsspeicherverhältnisse (z. B. 0,4, 0,4) definieren können, um einen festen Prozentsatz des gesamten GPU-Arbeitsspeichers eines Knotens für jede einzelne Modellinstanz zu reservieren.
Um diese Zuweisung zu steuern, verwenden wir ein Speichermodell „Vorab zugewiesen“ im Vergleich zu „Vorübergehend“, das zwischen statischen und dynamischen Ressourcenanforderungen unterscheidet.
Der „vorab zugewiesene“ Arbeitsspeicher besteht aus dem Arbeitsspeicher, der für die Modellgewichtungen und den KV-Cache verwendet wird. Die Menge des für die Modellgewichtungen verwendeten Arbeitsspeichers hängt von der Parameteranzahl und der Genauigkeit des Modells ab. Ein Modell mit 8 Milliarden Parametern in BF16 benötigt beispielsweise etwa 16 GB statischen Speicher. Die für den KV-Cache verwendete Arbeitsspeichermenge hängt von den Modelldimensionen, der Genauigkeit, der Kontextlänge und der Anzahl der Sequenzen ab. „Temporärer“ Arbeitsspeicher besteht aus Zwischenberechnungen und dem Arbeitsspeicher für die Inferenz. Das Argument gpu-memory-partition berücksichtigt den „vorab zugewiesenen“ Arbeitsspeicher. Wir empfehlen, einen Puffer für „vorübergehenden“ Arbeitsspeicher zu lassen, indem Sie die Summe der gpu-memory-partitions auf weniger als 1,0 festlegen.
Zum Vergrößern auf das Bild klicken
Produktisierung
In der Produktivitätsphase des Modell-Co-Hostings mit Vertex AI wurde eine nahtlose, produktionsreife Umgebung für die Bereitstellung von Einzelmodellen mit mehreren Replikaten und von mehreren Modellen eingerichtet. Durch diese Umstellung wurden empirische Benchmark-Ergebnisse effektiv in vereinfachte Bereitstellungs-Workflows und tief integrierte Infrastruktur-Supportstrukturen übersetzt.
Vereinfachte Bereitstellungs-Workflows
Um die Einstiegshürde für die Bereitstellung mit hoher Dichte zu senken, haben wir die Co-Hosting-Konfigurationen mit benutzerdefinierten Containerargumenten standardisiert, die sich nativ in vorhandene Vertex AI APIs einbinden lassen. Für VMs mit vollständiger Form, z. B. einen 8x H100-Knoten, haben wir ein Benchmark-Dienstprogramm entwickelt, mit dem Sie die besten Rezepte für Ihre spezifischen Anwendungsfälle anpassen können. Mit diesen Benchmark-Dienstprogrammen können Sie die Konfiguration finden, die Tensor-Parallelität (TP), Pipeline-Parallelität (PP) und die Anzahl der Modellinstanzen basierend auf der spezifischen Parameteranzahl und Genauigkeit des Modells automatisch ausgleicht. Ergänzt wird dies durch eine robuste Deployment API-Unterstützung, mit der Entwickler diese detaillierten Parameter, einschließlich genauer GPU-Arbeitsspeicherpartitionen, direkt in einer Standard-deployModel-Anfrage angeben und Modelle bereitstellen können.
Dynamische Multi-Modell-Bereitstellung
Ein wichtiger Fortschritt auf unserem technischen Weg war der Übergang von statischen Konfigurationen zu einer dynamischen Bereitstellungsarchitektur. Diese Funktion ist für Produktionsumgebungen mit sich schnell ändernden Traffic-Mustern von entscheidender Bedeutung, da die Möglichkeit, Modelle ohne einen vollständigen Containerneustart zu laden oder zu entladen, für die Aufrechterhaltung der Infrastrukturflexibilität und Hochverfügbarkeit unerlässlich ist.
Die Dynamic Update API (update_models)
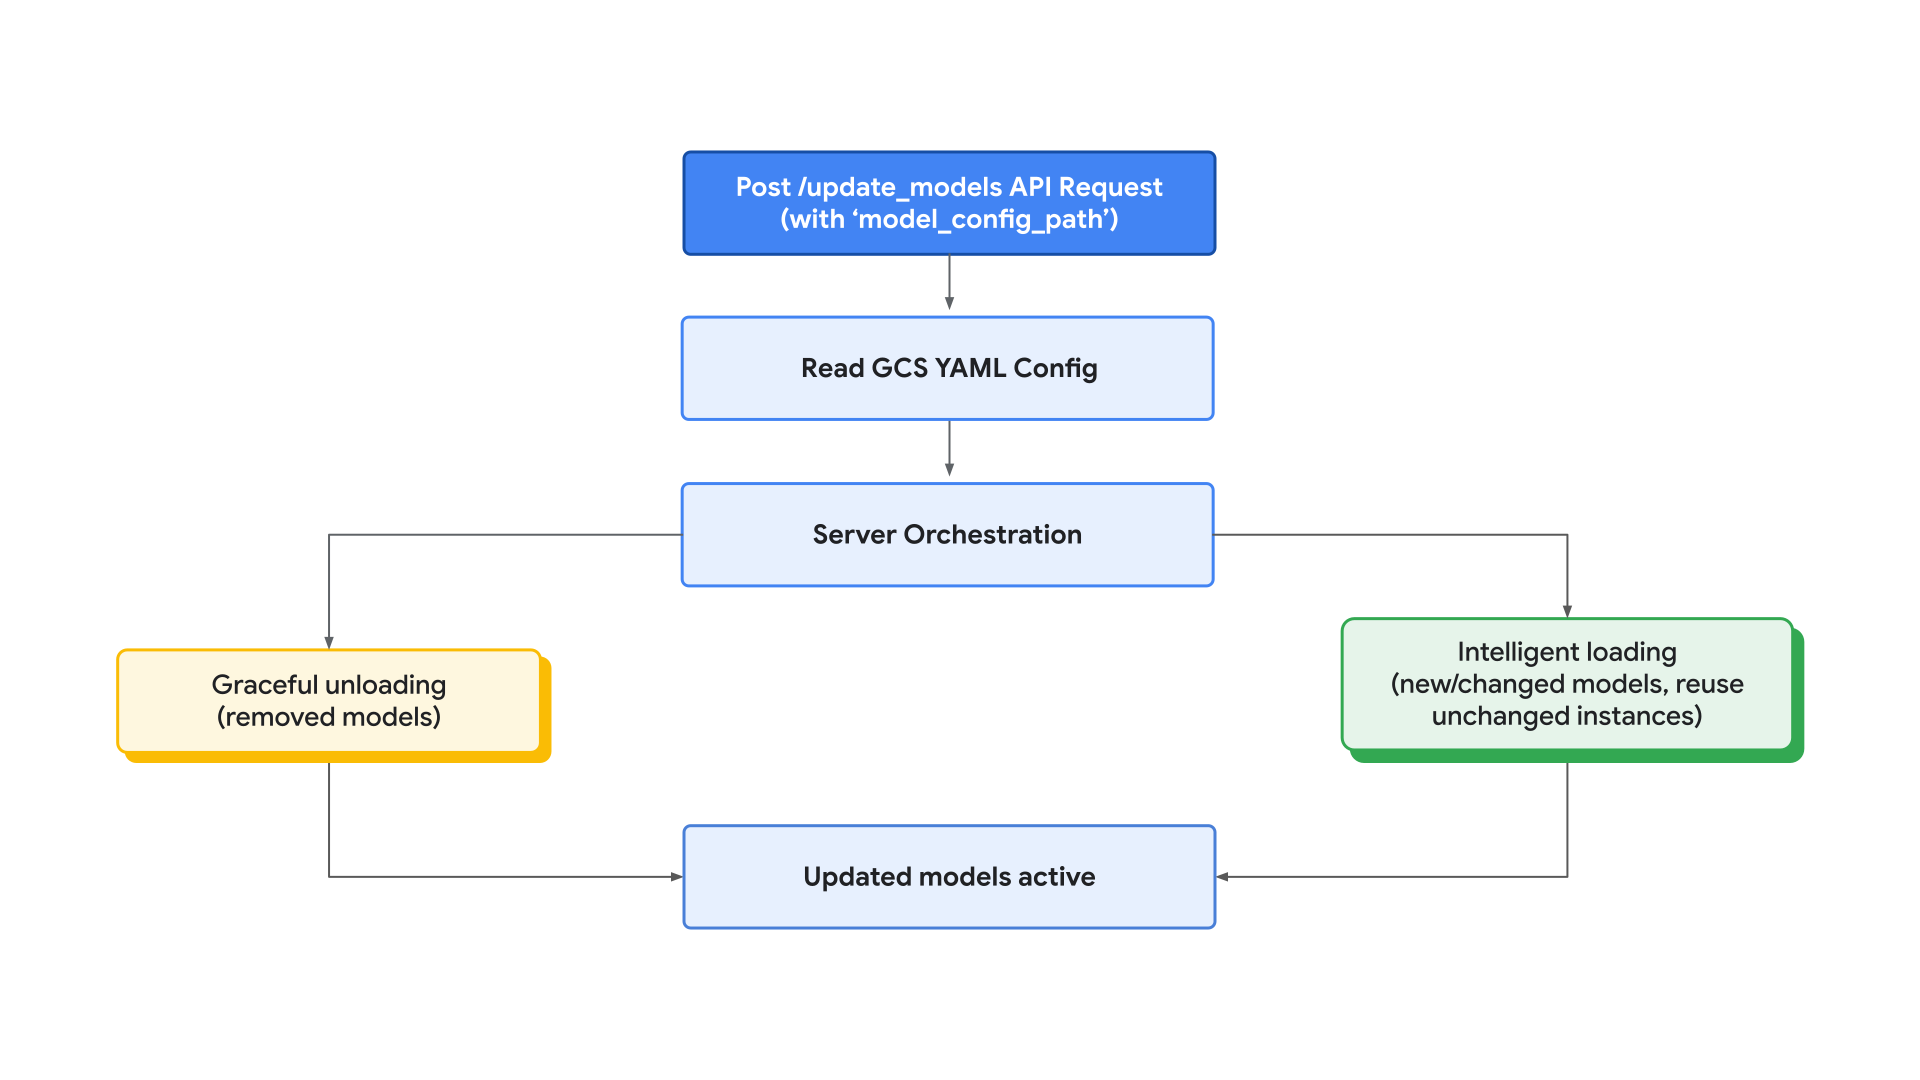
Um die inhärenten Einschränkungen unveränderlicher Bereitstellungen zu umgehen, haben wir eine spezielle API für Modellaktualisierungen im vLLM-Modell-Co-Hosting-Container von Vertex Model Garden implementiert. Diese API ermöglicht das Hot-Reloading, sodass der Server sein Portfolio an gehosteten Modellen im laufenden Betrieb anhand einer zentralen Konfigurationsdatei anpassen kann, die in einem Google Cloud Storage-Bucket (GCS) gespeichert ist.
Der Aktualisierungsvorgang wird über eine POST-Anfrage an den Endpunkt update_models initiiert, die den model_config_path enthält, der auf die GCS-YAML-Datei verweist.
Nach Erhalt dieser Anfrage führt der Server eine mehrstufige Orchestrierungssequenz aus, die für minimale Ausfallzeiten optimiert ist:
- Ordnungsgemäßes Entladen: Das System identifiziert Modelle, die in der neuen Konfiguration nicht vorhanden sind, und beendet zuerst ihre Unterprozesse. Dadurch werden GPU-Arbeitsspeicher und Rechenressourcen sofort freigegeben.
- Intelligentes Laden und Wiederverwenden: Der Server initialisiert dann neue Modellinstanzen. Wenn die Parallelitätseinstellungen eines Modells, z. B. Tensor-Parallelität (TP) oder Pipeline-Parallelität (PP), und die zugewiesene Speicherpartition unverändert bleiben, verwendet der Orchestrator die vorhandene laufende Instanz wieder. Durch diese Optimierung wird die kostspielige Phase der Neuinitialisierung umgangen, sodass aktive Dienste während Konfigurationsänderungen nicht unterbrochen werden.
Zum Vergrößern auf das Bild klicken
Latenz- und Leistungsanalyse
Die empirische Analyse dieser Aktualisierungsstrategien zeigt, dass das dynamische Hot-Reloading die Verzögerung durch einen „Kaltstart“, die häufig mit der Bereitstellung von LLMs in großem Maßstab verbunden ist, erheblich verringert.
Fazit
Das Modell-Co-Hosting mit Vertex AI stellt einen grundlegenden Paradigmenwechsel dar, der von starren, hardwareintensiven monolithischen Bereitstellungen zu einer flexiblen und effizienten Bereitstellungsarchitektur führt. Durch die Abkehr vom Standard „ein Modell pro VM“ hin zu einem Modell mit einem hochdichten Rechenpool können Unternehmen ihre Gesamtbetriebskosten (TCO) erheblich senken und gleichzeitig die Leistungsbenchmarks beibehalten und oft sogar verbessern.
Unsere Entwicklungsarbeit und umfangreiche Multi-Modell-Benchmark-Studien haben zu einer Reihe von Produktionsrichtlinien für diese Architektur geführt:
- Es gibt keine einheitliche Konfiguration. Wir empfehlen, das beste Bereitstellungsrezept für einen bestimmten Anwendungsfall (Modell, Hardware, Traffic) zu finden, und entwickeln Tools dafür.
- Durchsatz mit Replikaten skalieren.
- Verbessern Sie die Ressourcenauslastung, indem Sie Hardwaregrenzen aufheben und den Arbeitsspeicher auf einer detaillierteren Ebene aufteilen.
Für die erfolgreiche Implementierung einer gemeinsam gehosteten Architektur empfehlen wir den folgenden technischen Workflow:
- Explizite Partitionierung: Verwenden Sie das Argument
--gpu-memory-partitions, um Speicherressourcen für einzelne Modelle zuzuweisen. - Iteratives Benchmarking: Verwenden Sie das bereitgestellte Benchmark-Dienstprogramm, um den spezifischen „Concurrency Crossover“-Punkt für Ihre Arbeitslast zu ermitteln – die optimale Konfiguration der Anzahl der Instanzen, TP und PP.
Die Implementierung von Co-Hosting in Google Cloud Model Garden bietet einen skalierbaren Blueprint für die Erstellung von KI-Anwendungen mit hoher Dichte. Entwickler können diese Funktionen ausprobieren und unsere Benchmarks mit dem bereitgestellten Anleitungs-Notebook reproduzieren, um die Bereitstellungskonfigurationen für ihre spezifischen Unternehmensanforderungen zu optimieren.
Danke für die Kenntnisnahme
Wir freuen uns über Ihr Feedback und Ihre Fragen zu Vertex AI.
Danksagungen
Wir möchten dem Google Cloud Vertex AI-Team unseren aufrichtigen Dank aussprechen. Insbesondere danken wir Bo Wu und Ting Yu für ihre Leitung und Anleitung sowie Deborah He, Shawn Ma, Desmond Liu, Yang Pan, Surya K G Tangatur und Luis Rizo für ihre unschätzbaren Beiträge während dieses Projekts.