


PyTorch en Cloud TPU
PyTorch en Cloud TPU te permite entrenar, ajustar y entregar modelos abiertos en el hardware de Cloud TPU con la semántica estándar de PyTorch y las APIs distribuidas. Se integra en las herramientas del ecosistema que ya usas, como Hugging Face, vLLM, SGLang, llm-d, TorchTitan, TorchRec y Ray.
En la base de la pila, se encuentra TorchTPU, un backend nativo de PyTorch de código abierto desarrollado en conjunto con el equipo de PyTorch en Meta. TorchTPU proporciona bibliotecas, frameworks y herramientas para cada etapa del ciclo de vida del aprendizaje automático, desde la ejecución del entorno de ejecución principal y los kernels personalizados hasta la inferencia de producción, el entrenamiento a gran escala y la organización de clústeres.
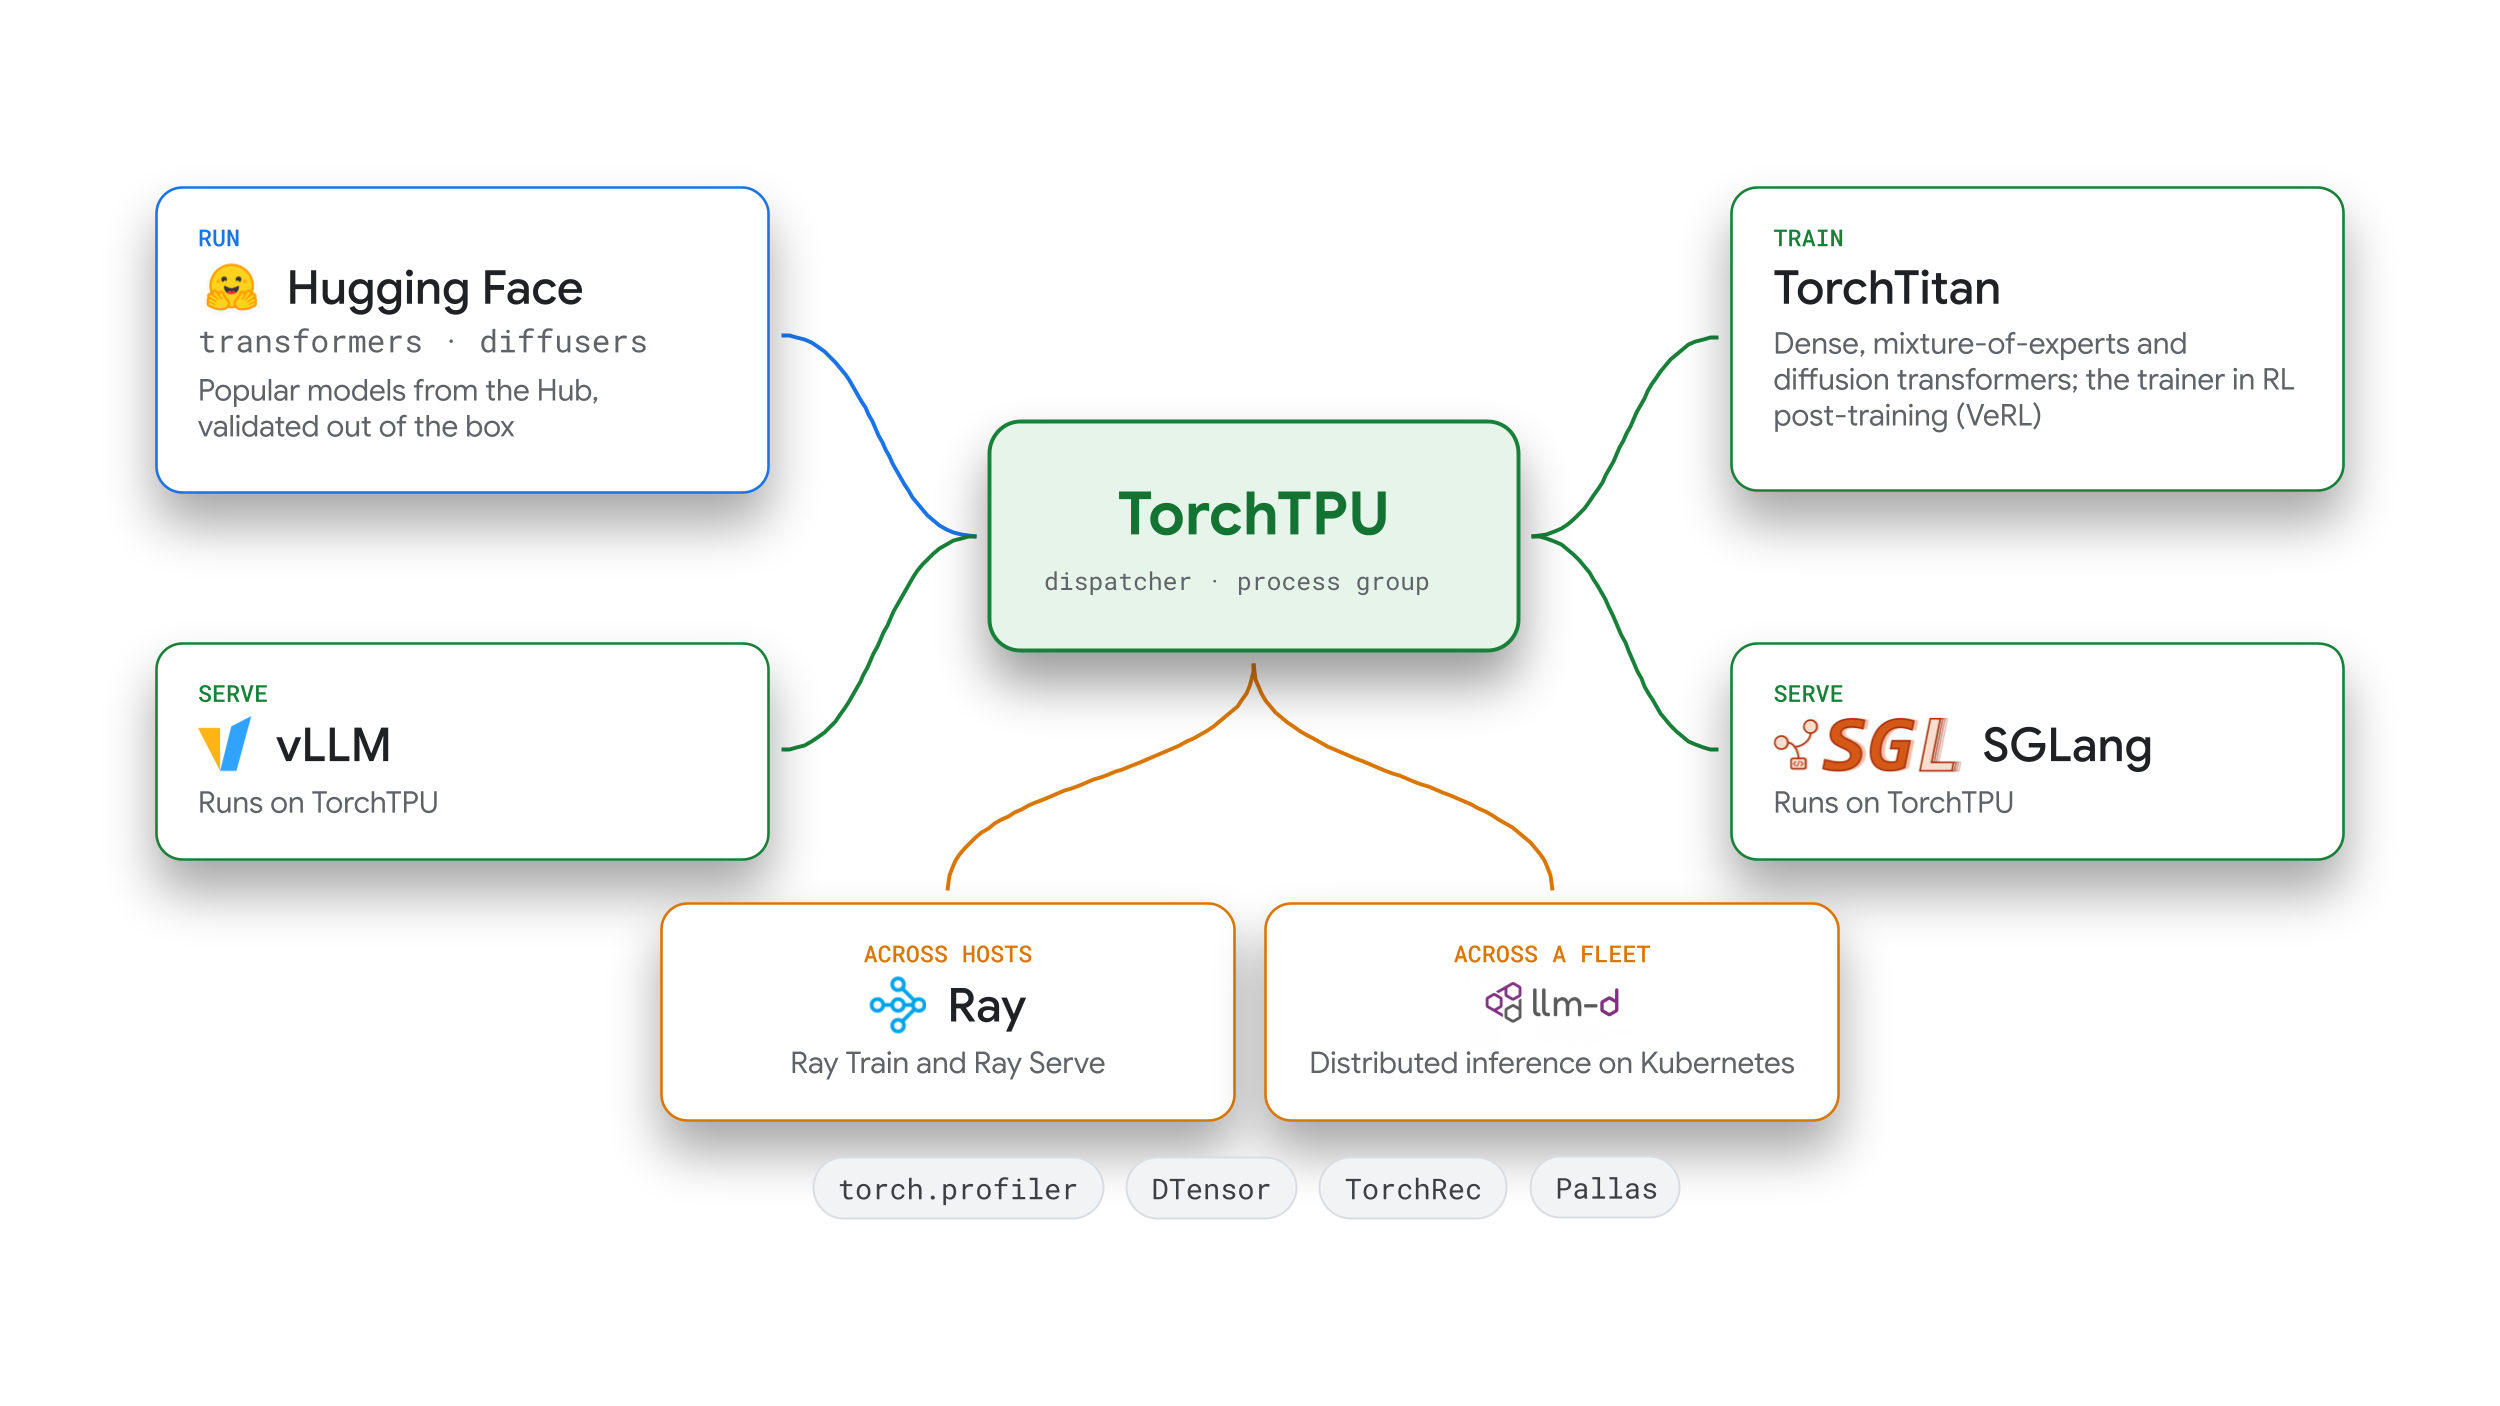
Comenzar
- Ejecuta modelos de PyTorch en TPU: comienza con TorchTPU y la documentación de TorchTPU.
- Entrega modelos de lenguaje grandes (LLM) y modelos multimodales: usa vLLM-TorchTPU o SGLang-TorchTPU.
- Enruta solicitudes en una flota de Kubernetes: usa llm-d.
- Entrena previamente o ajusta los modelos de base: usa TorchTitan en TPU (o TorchRec para los modelos de recomendación).
- Escala las canalizaciones de procesamiento de datos, entrenamiento, aprendizaje por refuerzo (RL) y entrega: usa Ray.
- Incorpora, perfila y ajusta modelos con tu asistente de programación: usa el TPU agent suite (versión preliminar).
TorchTPU: Backend nativo de PyTorch para Cloud TPU
TorchTPU proporciona el backend del dispositivo,
la integración del compilador de grafos y las APIs de kernel personalizadas para PyTorch en
Cloud TPU. Creado con el equipo de PyTorch, TorchTPU te permite depurar modelos
de forma interactiva en modo eager, compilar código de modelo con torch.compile y escalar
en porciones con torch.distributed (tpu_dist).
Para instalar TorchTPU, ejecuta el siguiente comando:
pip install torch_tpu
Para ejecutar una operación de tensor en una Cloud TPU, ejecuta el siguiente código de Python:
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
En el siguiente video, se proporciona una breve descripción general de TorchTPU:
Para obtener información más detallada, consulta Cómo funciona TorchTPU.
Motivación
Aunque las Cloud TPU se han vinculado históricamente con JAX y TensorFlow, la ejecución de PyTorch en TPU antes requería el registro de grafos de tensores diferidos (PyTorch/XLA), lo que a menudo implicaba agregar código para marcar regiones compilables. TorchTPU ejecuta operaciones de forma inmediata de forma predeterminada con el modelo de ejecución estándar de un proceso por dispositivo de PyTorch, por lo que las cargas de trabajo y las bibliotecas existentes se ejecutan sin reescrituras estructurales.
Diseño
TorchTPU ofrece compatibilidad nativa con TPU para PyTorch en torno a tres objetivos de diseño:
- Semántica estándar de PyTorch: Ejecuta un proceso por dispositivo y conserva las vistas de tensores de PyTorch y las mutaciones in situ sin una dependencia del entorno de ejecución de JAX.
- Ejecución inmediata de forma predeterminada: Ejecuta modelos de PyTorch estándar de inmediato en modo de ejecución inmediata para la depuración interactiva y la inspección paso a paso.
- Optimizaciones del compilador y del kernel: Proporciona fusión de operadores en modo inmediato
(además de la ejecución inmediata operador por operador), integración de
torch.compilecon límites de formas dinámicas para reducir las recompilaciones y APIs de kernel personalizadas.
Para la compilación de grafos, torch.compile captura el grafo de procesamiento de PyTorch
con TorchDynamo y lo compila en código máquina de TPU a través de OpenXLA y
StableHLO. Las operaciones colectivas se ejecutan a nivel del grupo de procesos
torch.distributed (tpu_dist).
Principales fortalezas
- Compatibilidad con operadores, modelos y Hugging Face: TorchTPU admite operadores
estándar de PyTorch (ATen) en pases hacia adelante y hacia atrás, y se prueba de forma continua
con modelos populares de Hugging Face. Puedes implementar modelos en
Transformers v5 pasando
device_map="tpu", ejecutar canalizaciones de Diffusers con el modo eager,torch.compiley el paralelismo de tensores, y perfilar las cargas de trabajo contorch.profileren TensorBoard y XProf. - Escalamiento de un solo chip a Multislice: El backend de
tpu_distadmiteDistributedDataParallel(DDP),FullyShardedDataParallel(FSDP2) yDTensor. Además,torch.tpu.distributed.topology_aware_meshasigna dimensiones de paralelismo a las interconexiones físicas de la TPU. - Modos de ejecución inmediata configurables: Proporciona tres modos de ejecución inmediata:
Strict(predeterminado): Envía operadores de forma individual y asíncrona, con la semántica imperativa estándar de PyTorch.Debug: Se ejecuta de forma síncrona con la verificación de límites de tensores.DeferAndFuse: fusiona secuencias de operadores eager para reducir el tráfico de memoria de ancho de banda alto (HBM).
- Compilación y almacenamiento en caché de grafos completos:
torch.compile(backend="tpu")compila grafos en ejecutables de TPU y los almacena en caché en procesos, hosts y reinicios de trabajos. - Kernels de TPU personalizados: Puedes llamar a kernels de Pallas personalizados, incluidos los kernels que se comunican directamente entre chips, como funciones estándar de PyTorch. También puedes usar kernels compilados previamente de la biblioteca de Tokamax o crear kernels portátiles basados en mosaicos con Helion.
Para obtener más información, consulta la documentación de TorchTPU, haz preguntas en el foro de debate de PyTorch en TPU o informa problemas en la herramienta de seguimiento de errores de TorchTPU.
Inferencia y entrega de producción
Para la implementación de producción, PyTorch en Cloud TPU se integra en motores de inferencia de código abierto y en la infraestructura de entrega distribuida nativa de Kubernetes.
vLLM-TorchTPU y SGLang-TorchTPU: Motores de inferencia
vLLM-TorchTPU y SGLang-TorchTPU son backends de TorchTPU para los motores de inferencia de vLLM y SGLang. Ambos backends ejecutan modelos abiertos, como Qwen, DeepSeek, GLM, Kimi, GPT-OSS y Gemma 4.
Para obtener más información, consulta la documentación de vLLM-TorchTPU y Anuncio de los nuevos motores de inferencia vLLM y SGLang en TPU.
Motivación
La entrega de cargas de trabajo de razonamiento, multimodales y de uso de herramientas suele requerir definiciones de modelos personalizadas, métodos de decodificación especulativa y esquemas de cuantización. Compilar los backends de vLLM y SGLang en TorchTPU te permite personalizar y depurar tu pila de entrega directamente en PyTorch.
Diseño
Ambos backends conservan los programadores estándar de vLLM y SGLang, los administradores de caché de pares clave-valor (KV) y los servidores de la API, mientras usan la ejecución de TorchTPU y los operadores personalizados de Pallas por debajo. La mayoría de los modelos ejecutan sus definiciones de modelos de PyTorch estándar, mientras que los bloques de procesamiento intensivo invocan kernels de Pallas dentro del grafo compilado para que los kernels específicos del hardware se puedan actualizar de forma independiente.
Principales fortalezas
- Paralelismo, cuantización y decodificación especulativa: admite el paralelismo de tensores, datos, expertos, canalizaciones y contextos en todos los hosts, junto con entradas multimodales (imagen y video) y de incorporaciones. Los métodos de decodificación especulativa admitidos incluyen la predicción de varios tokens (MTP), EAGLE-3, DFlash, DSpark y la coincidencia de n-gramas. Los formatos de cuantización admitidos incluyen cachés de KV de 8 bits (FP8) y puntos de control de modelos de punto flotante de 8 bits (FP8) y 4 bits (MXFP4 y NVFP4).
- Almacenamiento en caché de prefijos de dos niveles, llamada a funciones y resultado estructurado: El almacenamiento en caché de prefijos automático conserva los prefijos activos en la HBM y descarga los prefijos más antiguos en la memoria del host para evitar que se vuelvan a calcular en las solicitudes de varios turnos. Este almacenamiento en caché admite modelos recurrentes y de atención híbrida, y se incorporan la llamada a funciones y el resultado estructurado.
- Transferencias de caché de KV superpuestas con TPU Sync: Admite la entrega de precompletado y decodificación desagregada (separa el procesamiento de instrucciones y la generación de tokens en grupos de trabajadores distintos) entre hosts y la descarga de KV de host con TPU Sync. TPU Sync es una biblioteca de C++ de código abierto que lee los búferes de dispositivos de PyTorch directamente en subprocesos en segundo plano sin copiar datos a través de la memoria de la CPU del host.
Para obtener más información sobre vLLM-TorchTPU, consulta el repositorio de vLLM-TorchTPU y las recetas de vLLM-TorchTPU para TPU7x, haz preguntas en el canal de Slack de vLLM o informa problemas en la herramienta de seguimiento de errores de vLLM-TorchTPU.
Para obtener más información sobre SGLang-TorchTPU, consulta el repositorio de SGLang-TorchTPU o informa problemas en la Herramienta de seguimiento de errores de SGLang-TorchTPU.
llm-d: Inferencia distribuida nativa de Kubernetes
llm-d es un framework de zona de pruebas de código abierto de la Cloud Native Computing Foundation (CNCF) para la inferencia de LLM distribuida en Kubernetes. Se desarrolla con Red Hat, IBM, Google Cloudy una comunidad de más de 500 colaboradores y 35 organizaciones.
Motivación
Aunque los motores de inferencia de instancia única administran la ejecución por réplica, las flotas de producción deben controlar los aumentos repentinos de tráfico, las prioridades de varios usuarios, el uso compartido de contexto en toda la flota y los lanzamientos sin tiempo de inactividad. llm-d proporciona la capa de operaciones y enrutamiento a nivel de clúster para coordinar una flota de servidores de inferencia.
Diseño
llm-d se ejecuta antes que los servidores de modelos, como vLLM y SGLang, en Kubernetes. llm-d proporciona lo siguiente:
- Enruta las solicitudes según el estado de la caché de prefijos y la carga de réplicas.
- Coordina los grupos de trabajadores de precompletado y decodificación desagregados.
- Admite la fragmentación de mezcla de expertos (MoE) y la inferencia por lotes asíncrona.
- Administra la descarga de la caché de KV por niveles en la memoria del dispositivo, la memoria del host y el almacenamiento.
Principales fortalezas
- Enrutamiento de sesiones de varios turnos: Enruta las conversaciones de varios turnos a las réplicas que contienen su contexto almacenado en caché. La programación de prioridad de turnos y la compatibilidad con la API de Responses con estado permiten que los agentes reutilicen el contexto en todos los turnos para reducir el recálculo.
- Calidad de servicio de múltiples usuarios: El control de flujo de prioridad y equidad permite que las solicitudes sensibles a la latencia y las cargas de trabajo de agentes con ráfagas compartan una flota sin agotar los recursos.
- Operaciones de flota y actualizaciones progresivas: Proporciona una API de configuración de v1, alta disponibilidad del router y actualizaciones progresivas coordinadas que administran las réplicas de precompletado y decodificación como una sola unidad lógica.
- Entrega nativa de TorchTPU en Google Kubernetes Engine (GKE): Puedes entregar Cloud TPU junto con otros aceleradores detrás de un extremo de llm-d y administrar réplicas de vLLM-TorchTPU y SGLang-TorchTPU con las herramientas estándar de Kubernetes.
Para obtener más información, consulta llm-d Router en Acerca de GKE Inference Gateway y la guía de la puerta de enlace de GKE de llm-d, haz preguntas en el canal de Slack de llm-d o informa problemas en la Herramienta de seguimiento de errores de llm-d.
Bibliotecas de entrenamiento, ajuste y dominio
Para entrenar previamente, ajustar y adaptar modelos grandes, TorchTPU proporciona recetas de entrenamiento de referencia y bibliotecas específicas del dominio ajustadas para el hardware de TPU.
TorchTitan en TPU: Referencia de entrenamiento a gran escala
TorchTitan en TPU extiende TorchTitan, la plataforma de referencia modular de PyTorch para el entrenamiento de IA generativa, con pases de fragmentación de TPU, kernels personalizados y recetas de entrenamiento.
Motivación
Para escalar el entrenamiento en porciones de TPU de varios hosts, se requieren parámetros de fragmentación en la interconexión de chips y la comunicación superpuesta con el procesamiento. Google y Meta desarrollaron de forma conjunta pases de compilación y fragmentación de TPU dentro de TorchTitan para que no necesites diseñar estrategias de fragmentación de TPU personalizadas ni programar la comunicación de forma manual.
Diseño
Escribes modelos en PyTorch para un solo dispositivo sin código específico del acelerador. TorchTitan configura las capas del modelo a partir de archivos de configuración, lo que te permite reemplazar capas individuales por kernels de Pallas personalizados (como Splash Attention) sin editar la definición del modelo ni el bucle de entrenamiento.
La implementación de SimpleFSDP de TorchTitan coloca las operaciones de fragmentación de parámetros
directamente dentro del grafo compilado para que el compilador de XLA pueda superponer la comunicación del dispositivo
con el procesamiento. Además, la compilación de grafos de paso completo
captura todo el paso de entrenamiento como un solo programa de XLA. Para
las ejecuciones de Multislice, la fragmentación híbrida (HSDP) fragmenta dentro de cada porción
a través de la interconexión entre chips (ICI) y se replica entre porciones a través de la
red del centro de datos (DCN). Este diseño limita el tráfico entre porciones a una sola
reducción de gradiente por paso.
Principales fortalezas
- Recetas de entrenamiento previo y posterior al RL: Incluye recetas de referencia para LLM densos (Llama 3, Qwen 3 y MuseGlimmer 30B), modelos de MoE (Qwen 3 235B, validados en hasta 8,192 chips TPU7x) y transformadores de difusión (FLUX.1). Para el posentrenamiento de RL (como la optimización de políticas relativas de grupo o GRPO), VeRL (versión preliminar) delega las actualizaciones de parámetros a TorchTitan. Luego, envía los pesos actualizados a los motores de entrega para generar trayectorias de entrenamiento (lanzamientos).
- Configuración preconfigurada del compilador y del paralelismo: Las configuraciones de recetas incluyen parámetros preconfigurados del compilador y del paralelismo para que puedas ajustar el uso de FLOP del modelo (MFU) a través de archivos de configuración en lugar de cambios en el código.
- Incorporación de arquitecturas nuevas: El backend de modelado de Hugging Face Transformers ejecuta puntos de control del modelo de Hugging Face Hub (incluidos los modelos de MoE sin paralelismo de expertos) a través del entrenador de TorchTitan. Para los puertos de modelos completos, TorchTitan incluye una habilidad de incorporación paso a paso para ingenieros y agentes de programación.
- Reutilización de componentes independientes: Puedes adoptar TorchTitan de extremo a extremo o importar módulos individuales, operadores personalizados y marcas del compilador en una base de código de entrenamiento existente.
Para obtener más información, consulta la guía de introducción de TorchTitan en TPU y la receta de entrenamiento de TorchTitan Qwen3-8B para TPU7x, haz preguntas en el foro de discusión de TorchTitan o informa problemas en la herramienta de seguimiento de errores de TorchTitan.
TorchRec: Sistemas de recomendación
TorchRec es una biblioteca de dominio de PyTorch que proporciona tablas de embeddings distribuidas y primitivas de fragmentación para modelos de recomendación. En Cloud TPU, TorchRec descarga las búsquedas de tablas de incorporaciones dispersas en procesadores SparseCore de TPU dedicados mientras ejecuta operaciones de matrices densas en los TensorCores de TPU.
Para obtener más información sobre TorchRec, consulta la documentación de TorchRec, haz preguntas en el foro de debate de PyTorch en TPU o informa problemas en la Herramienta de seguimiento de errores de TorchRec.
Organización de clústeres y herramientas para desarrolladores
Para escalar canalizaciones de varios nodos y automatizar la incorporación de modelos, el ecosistema de TorchTPU se integra en Ray y proporciona extensiones de agentes de programación con acceso a la documentación de TPU.
Ray: Entrenamiento, entrega y RL distribuidos
Ray escala las cargas de trabajo de Python y de IA en los clústeres con Ray Train, Ray Serve, [Ray Data](https://docs.ray.io/en/latest/ray-core/walkthrough.html, Ray Core y frameworks de RL, como VeRL (versión preliminar).
Para obtener más información, consulta Anuncio de Ray en Google Cloud.
Motivación
El entrenamiento de Multislice y las canalizaciones de varias etapas (como los flujos de trabajo de RL
que combinan el procesamiento previo de datos, el entrenamiento y la generación de lanzamientos)
requieren el aprovisionamiento automatizado de porciones, el descubrimiento de topologías y la coordinación de trabajadores
tolerante a errores. Las utilidades de inicio independientes, como torchrun, no
aprovisionan porciones de TPU ni coordinan canalizaciones de actores de varias etapas, por lo que Ray administra
la programación y la ubicación en todo el clúster para las cargas de trabajo de TorchTPU.
Diseño
Cuando envías un trabajo que especifica la generación, la topología y el recuento de trabajadores de TPU,
Ray reserva porciones de TPU completas para que todos los trabajadores de una porción se programen
juntos. Luego, Ray descubre las direcciones de interconexión de chips y, luego, inicia un
trabajador de PyTorch por dispositivo TPU. El backend de PyTorch de Ray Train inicializa el dispositivo tpu
y el grupo de procesos tpu_dist automáticamente antes de iniciar el trabajo.
Principales fortalezas
- Ubicación que coincide con la topología: Hace coincidir la ubicación de los trabajadores en los hosts con la generación física de TPU y el diseño de porciones.
- Recuperación automática de fallas: Ejecuta trabajos de entrenamiento distribuidos en varias porciones de TPU en GKE con recuperación automática cuando falla un trabajador o una porción.
- Recuperación previa de datos directa a la TPU: El método
iter_torch_batchesde Ray Data recupera previamente lotes como tensores de PyTorch directamente en la memoria del dispositivo TPU. - Organización de inferencia de varios hosts: Administra implementaciones de entrega de varios hosts para vLLM-TorchTPU y SGLang-TorchTPU.
TPU agent suite: Agentes de programación para TPU (versión preliminar)
El TPU agent suite es una extensión de código abierto para asistentes de programación, incluidos Claude Code y Google Antigravity, que se enfoca en la inferencia de transformadores (LLM densos y modelos de MoE) en TPU v6e y TPU7x.
Para obtener más información, mira la descripción general de TPU agent suite de código abierto:
Motivación
Los asistentes de programación de uso general suelen carecer de contexto actual sobre las topologías de hardware de TPU, las marcas del compilador de XLA, la telemetría de XProf y las restricciones del kernel de Pallas. TPU agent suite le brinda a tu asistente acceso a la documentación oficial de TPU y a flujos de trabajo estructurados. Esto ayuda a evitar sugerencias de marcas no válidas y automatiza la generación de perfiles y comparativas iterativas.
Diseño
El paquete agrega una base de conocimiento de TPU y cuatro subagentes específicos de tareas a tu
asistente de programación existente. Un agente de enrutamiento (tpu-agent) delega cada instrucción
al agente secundario adecuado sin ejecutar comandos por sí mismo. Cualquier ejecución de comandos
en tu VM de TPU o clúster de GKE requiere tu aprobación,
y los bucles de ajuste ejecutan una cantidad limitada de intentos registrados antes de devolver
resultados.
Principales fortalezas
- Incorporación de modelos y verificación de exactitud: El agente de
tpu-model-onboardingresuelve los operadores no admitidos y selecciona una ruta de entrega (vLLM-TorchTPU o PyTorch estándar). También compara los resultados capa por capa con el modelo de referencia de la CPU para verificar la exactitud numérica. - Diagnóstico de fallas y cuellos de botella: El agente de
tpu-diagnosticsanaliza los registros de fallas, inspecciona los perfiles de XProf y los seguimientos del compilador de XLA, y aísla los cuellos de botella del entorno de ejecución. - Desarrollo de kernels de Pallas personalizados: El agente de
tpu-kernel-developmentayuda a escribir y ajustar automáticamente kernels de TPU de Pallas personalizados dentro de un presupuesto de iteración limitado. - Búsqueda de documentación con citas: El agente de
tpu-knowledge-baseresponde preguntas técnicas con citas explícitas de la documentación y los instructivos oficiales de TPU, y, además, indica cuando un tema no está cubierto.
Para obtener más información, consulta la documentación de TPU agent suite, comparte comentarios y haz preguntas en TPU agent suite GitHub Discussions, o informa problemas en la Herramienta de seguimiento de errores de TPU agent suite.
¿Qué sigue?
- Comienza a usar la documentación de TorchTPU.
- Prueba las recetas de TorchTitan en TPU.
- Implementa cargas de trabajo de inferencia con vLLM-TorchTPU y SGLang-TorchTPU.
- Haz preguntas en el foro de debate de PyTorch en TPU.
- Para analizar un caso de uso específico con el equipo de ingeniería y productos de Google, envía un correo electrónico a torchtpu-feedback@google.com.