


Cloud TPU 上的 PyTorch
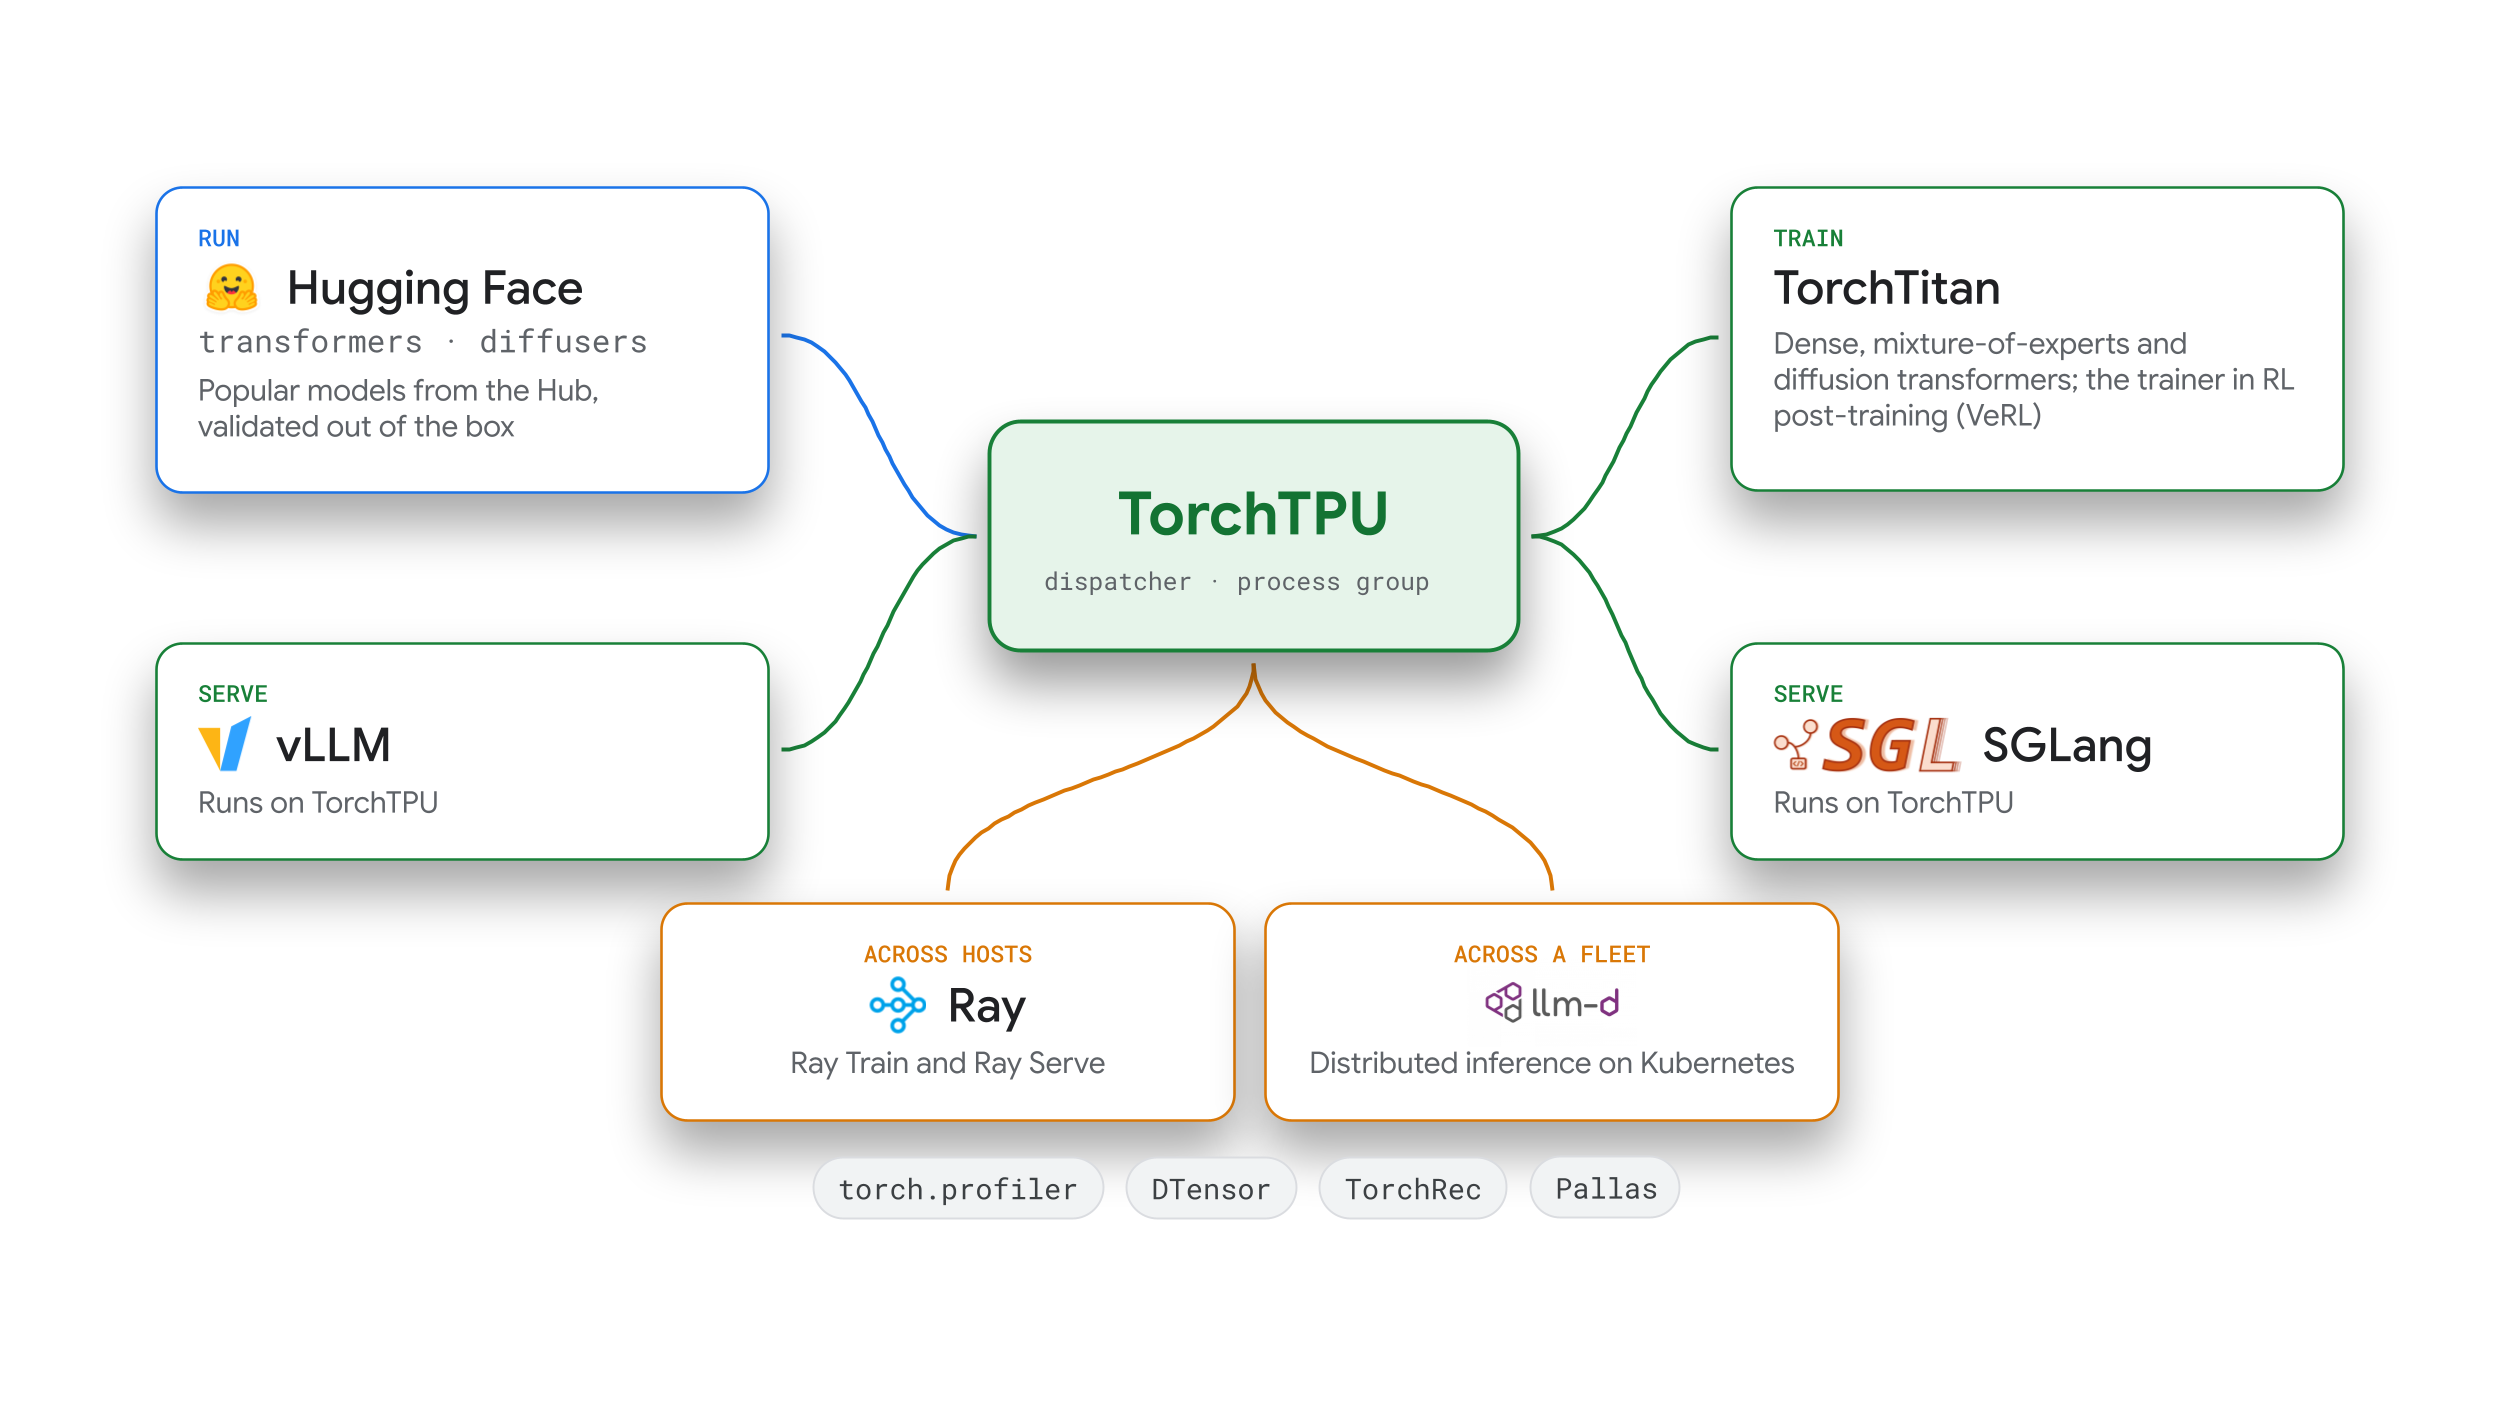
借助 PyTorch on Cloud TPU,您可以使用标准 PyTorch 语义和分布式 API 在 Cloud TPU 硬件上训练、微调和部署开放模型。它可与您已在使用的生态系统工具集成,包括 Hugging Face、vLLM、SGLang、llm-d、TorchTitan、TorchRec 和 Ray。
该堆栈的基础是 TorchTPU,这是一个与 Meta 的 PyTorch 团队共同开发的开源 PyTorch 原生后端。TorchTPU 为机器学习生命周期的每个阶段提供库、框架和工具,涵盖核心运行时执行、自定义内核、生产推理、大规模训练和集群编排。
开始使用
- 在 TPU 上运行 PyTorch 模型:从 TorchTPU 和 TorchTPU 文档开始。
- 应用大语言模型 (LLM) 和多模态模型:使用 vLLM-TorchTPU 或 SGLang-TorchTPU。
- 在 Kubernetes 舰队中路由请求:使用 llm-d。
- 预训练或微调基础模型:使用 TPU 上的 TorchTitan(或用于推荐模型的 TorchRec)。
- 扩缩数据处理、训练、强化学习 (RL) 和服务流水线:使用 Ray。
- 使用编码辅助来加载、剖析和调优模型:使用 TPU Agent Suite(预览版)。
TorchTPU:适用于 Cloud TPU 的 PyTorch 原生后端
TorchTPU 为 Cloud TPU 上的 PyTorch 提供设备后端、图编译器集成和自定义内核 API。TorchTPU 是与 PyTorch 团队合作开发的,可让您在 Eager 模式下以交互方式调试模型,使用 torch.compile 编译模型代码,并使用 torch.distributed (tpu_dist) 跨切片扩缩。
如需安装 TorchTPU,请运行以下命令:
pip install torch_tpu
如需在 Cloud TPU 上运行张量运算,请运行以下 Python 代码:
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
以下视频简要介绍了 TorchTPU:
如需了解详情,请参阅 TorchTPU 现已开源:在 TPU 上运行原生 PyTorch,以及 TorchTPU 的工作原理。
动机
虽然 Cloud TPU 历来与 JAX 和 TensorFlow 搭配使用,但以前在 TPU 上运行 PyTorch 需要进行延迟张量图记录 (PyTorch/XLA),这通常意味着需要添加代码来标记可编译区域。TorchTPU 默认使用 PyTorch 的标准“每个设备一个进程”执行模型,以 Eager 模式运行操作,因此现有工作负载和库无需重写结构即可运行。
设计
TorchTPU 为 PyTorch 带来了 PyTorch 原生 TPU 支持,其设计目标主要有三个:
- 标准 PyTorch 语义:每个设备运行一个进程,并保留 PyTorch 张量视图和就地突变,而无需依赖 JAX 运行时。
- 默认即刻执行:在即刻模式下立即运行标准 PyTorch 模型,以便进行交互式调试和逐步检查。
- 编译器和内核优化:在即刻模式下提供运算符融合(除了逐个运算符的即刻执行之外),
torch.compile与动态形状边界集成以减少重新编译,以及自定义内核 API。
对于图编译,torch.compile 会使用 TorchDynamo 捕获 PyTorch 计算图,并通过 OpenXLA 和 StableHLO 将其编译为 TPU 机器代码。集合操作在 torch.distributed 进程组级别 (tpu_dist) 运行。
主要优势
- 算子、模型和 Hugging Face 支持:TorchTPU 支持前向和后向传递中的标准 PyTorch (ATen) 算子,并持续针对热门 Hugging Face 模型进行测试。您可以通过传递
device_map="tpu"在 Transformers v5 中部署模型,使用 Eager 模式、torch.compile和张量并行运行 Diffusers 流水线,以及在 TensorBoard 和 XProf 中使用torch.profiler分析工作负载。 - 单芯片到 Multislice 伸缩:
tpu_dist后端支持DistributedDataParallel(DDP)、FullyShardedDataParallel(FSDP2) 和DTensor。此外,torch.tpu.distributed.topology_aware_mesh会将并行性维度映射到物理 TPU 互连。 - 可配置的即刻执行模式:提供三种即刻执行模式:
Strict(默认):使用标准命令式 PyTorch 语义单独且异步地分派运算符。Debug:使用张量边界检查同步运行。DeferAndFuse:融合 Eager 算子序列,以减少高带宽内存 (HBM) 流量。
- 全图编译和缓存:
torch.compile(backend="tpu")会将图编译为 TPU 可执行文件,并在进程、主机和作业重启之间缓存这些文件。 - 自定义 TPU 内核:您可以将自定义 Pallas 内核(包括直接在芯片之间通信的内核)作为标准 PyTorch 函数进行调用。您还可以使用 Tokamax 库中的预构建内核,或使用 Helion 编写可移植的基于图块的内核。
如需了解详情,请参阅 TorchTPU 文档,在 PyTorch on TPU 讨论论坛中提问,或在 TorchTPU 问题跟踪器中报告问题。
生产环境推理和服务
对于生产部署,Cloud TPU 上的 PyTorch 与开源推理引擎和 Kubernetes 原生分布式服务基础设施集成。
vLLM-TorchTPU 和 SGLang-TorchTPU:推理引擎
vLLM-TorchTPU 和 SGLang-TorchTPU 是适用于 vLLM 和 SGLang 推理引擎的 TorchTPU 后端。这两个后端都运行 Qwen、DeepSeek、GLM、Kimi、GPT-OSS 和 Gemma 4 等开放模型。
如需了解详情,请参阅 vLLM-TorchTPU 文档和宣布在 TPU 上推出新的 vLLM 和 SGLang 推理引擎。
动机
提供推理、多模态和工具使用工作负载通常需要自定义模型定义、推测性解码方法和量化方案。在 TorchTPU 上构建 vLLM 和 SGLang 后端,可让您直接在 PyTorch 中自定义和调试服务堆栈。
设计
这两个后端都保留了标准 vLLM 和 SGLang 调度器、键值对 (KV) 缓存管理器和 API 服务器,同时在底层使用 TorchTPU 执行和自定义 Pallas 算子。大多数模型都会运行其标准 PyTorch 模型定义,而计算密集型块会在编译后的计算图中调用 Pallas 内核,以便独立更新硬件专用内核。
主要优势
- 并行处理、量化和推测性解码:支持跨主机的张量、数据、专家、流水线和上下文并行处理,以及多模态(图片和视频)和嵌入输入。支持的推测解码方法包括多词元预测 (MTP)、EAGLE-3、DFlash、DSpark 和 n-gram 匹配。支持的量化格式包括 8 位 (FP8) KV 缓存以及 8 位 (FP8) 和 4 位(MXFP4 和 NVFP4)浮点模型检查点。
- 两层前缀缓存、工具调用和结构化输出:自动前缀缓存会将活跃前缀保留在 HBM 中,并将较旧的前缀卸载到主机内存,以避免在多轮请求中重新计算。此缓存支持混合注意力机制和循环模型,并内置了工具调用和结构化输出功能。
- 使用 TPU Sync 重叠 KV 缓存传输:支持跨主机分离预填充和解码服务(将提示处理和 token 生成分离到不同的工作器池),并使用 TPU Sync 进行主机 KV 卸载。TPU Sync 是一个开源 C++ 库,可直接在后台线程上读取 PyTorch 设备缓冲区,而无需通过主机 CPU 内存复制数据。
如需详细了解 vLLM-TorchTPU,请参阅 vLLM-TorchTPU 代码库和适用于 TPU7x 的 vLLM-TorchTPU recipe,在 vLLM Slack 频道中提问,或在 vLLM-TorchTPU 问题跟踪器中报告问题。
如需详细了解 SGLang-TorchTPU,请参阅 SGLang-TorchTPU 代码库,或在 SGLang-TorchTPU 问题跟踪器中报告问题。
llm-d:Kubernetes 原生分布式推理
llm-d 是一个开源 Cloud Native Computing Foundation (CNCF) 沙盒框架,用于在 Kubernetes 上进行分布式 LLM 推理。它由 Red Hat、IBM、 Google Cloud以及一个由 500 多名贡献者和 35 个组织组成的社区共同开发。
动机
虽然单实例推理引擎负责管理每个副本的执行,但生产集群必须处理流量高峰、多租户优先级、集群范围的上下文共享和零停机发布。llm-d 提供集群级路由和操作层,用于协调推理服务器集群。
设计
llm-d 在 Kubernetes 上的 vLLM 和 SGLang 等模型服务器前端运行。llm-d 提供以下功能:
- 根据前缀缓存状态和副本负载路由请求。
- 协调解耦的预填充和解码工作器池。
- 支持混合专家 (MoE) 分片和异步批量推理。
- 管理跨设备内存、主机内存和存储空间的分层 KV 缓存分流。
主要优势
- 多轮会话路由:将多轮对话路由到包含其缓存上下文的副本。轮次优先调度和有状态 Responses API 支持让智能体能够跨轮次重复使用上下文,从而减少重新计算。
- 多租户服务质量:优先级和公平性流控制可让对延迟时间敏感的请求和突发代理工作负载共享一个舰队,而不会出现资源匮乏。
- 舰队操作和滚动更新:提供 v1 配置 API、路由器高可用性以及协调的滚动更新,将预填充和解码副本作为单个逻辑单元进行管理。
- Google Kubernetes Engine (GKE) 上的原生 TorchTPU 应用:您可以在一个 llm-d 端点后与其他加速器一起应用 Cloud TPU,并使用标准 Kubernetes 工具管理 vLLM-TorchTPU 和 SGLang-TorchTPU 副本。
如需了解详情,请参阅 GKE Inference Gateway 简介中的 llm-d 路由器和 llm-d GKE Gateway 指南,在 llm-d Slack 频道中提问,或在 llm-d 问题跟踪器中报告问题。
训练、微调和领域库
为了预训练、微调和调整大型模型,TorchTPU 提供了针对 TPU 硬件进行调优的参考训练配方和特定领域库。
TPU 上的 TorchTitan:大规模训练参考
TPU 上的 TorchTitan 扩展了 TorchTitan(用于生成式 AI 训练的 PyTorch 模块化参考平台),具有 TPU 分片传递、自定义内核和训练方案。
如需了解详情,请参阅将 TorchTPU 集成到 TorchTitan 中并针对 TPU 优化模型。
动机
如需在多主机 TPU 切片上扩缩训练,需要跨芯片互连对参数进行分片,并使通信与计算重叠。Google 和 Meta 在 TorchTitan 中共同开发了 TPU 分片和编译传递,因此您无需设计自定义 TPU 分片策略或手动安排通信。
设计
您可以使用单设备 PyTorch 编写模型,而无需使用加速器专用代码。TorchTitan 会根据配置文件配置模型层,让您无需修改模型定义或训练循环,即可将各个层替换为自定义 Pallas 内核(例如 Splash Attention)。
TorchTitan 的 SimpleFSDP 实现将参数分片操作直接放置在已编译的计算图中,以便 XLA 编译器可以将设备通信与计算重叠。此外,全步图编译会将整个训练步骤捕获为单个 XLA 程序。对于 Multislice 运行,混合分片 (HSDP) 会通过芯片间互连 (ICI) 在每个切片内进行分片,并通过数据中心网络 (DCN) 跨切片进行复制。此布局将跨切片流量限制为每步一次梯度缩减。
主要优势
- 预训练和 RL 后训练 recipe:包括密集 LLM(Llama 3、Qwen 3 和 MuseGlimmer 30B)、MoE 模型(Qwen 3 235B,在多达 8,192 个 TPU7x 芯片上进行了验证)和扩散转换器 (FLUX.1) 的参考 recipe。对于 RL 训练后(例如群组相对策略优化 [GRPO]),VeRL(预览版)会将参数更新委托给 TorchTitan。然后,它会将更新后的权重推送到服务引擎,以生成训练轨迹(展开)。
- 预配置的编译器和并行设置:配方配置包括预配置的编译器和并行设置,因此您可以通过配置文件而不是代码更改来调整模型 FLOP 利用率 (MFU)。
- 新架构的初始配置:Hugging Face Transformers 建模后端通过 TorchTitan 训练器运行 Hugging Face Hub 模型检查点(包括没有专家并行性的 MoE 模型)。对于完整模型移植,TorchTitan 为工程师和编码智能体提供了分步入门技能。
- 独立组件重用:您可以端到端采用 TorchTitan,也可以将各个模块、自定义运算符和编译器标志导入现有训练代码库。
如需了解详情,请参阅 TorchTitan on TPU 入门指南和适用于 TPU7x 的 TorchTitan Qwen3-8B 训练方案,在 TorchTitan 讨论论坛中提问,或在 TorchTitan 问题跟踪器中报告问题。
TorchRec:推荐系统
TorchRec 是一个 PyTorch 领域库,为推荐模型提供分布式嵌入表和分片基元。在 Cloud TPU 上,TorchRec 会将稀疏嵌入表查找分流到专用 TPU SparseCore 处理器,同时在 TPU TensorCore 上运行密集矩阵运算。
如需详细了解 TorchRec,请参阅 TorchRec 文档,在 PyTorch on TPU 讨论论坛中提问,或在 TorchRec 问题跟踪器中报告问题。
集群编排和开发者工具
为了扩缩多节点流水线并自动执行模型初始配置,TorchTPU 生态系统与 Ray 集成,并提供可访问 TPU 文档的编码智能体扩展程序。
Ray:分布式训练、服务和强化学习
Ray 使用 Ray Train、Ray Serve、Ray Data、Ray Core 和 RL 框架(例如 VeRL [预览版])在集群中扩缩 Python 和 AI 工作负载。如需了解详情,请参阅宣布 Ray 支持 Google TPU 上的 PyTorch。
动机
多切片训练和多阶段流水线(例如结合了数据预处理、训练和 rollout 生成的 RL 工作流)需要自动切片预配、拓扑发现和容错工作器协调。torchrun 等独立启动实用程序不会预配 TPU 切片或协调多阶段 actor 流水线,因此 Ray 会管理 TorchTPU 工作负载的集群级调度和放置。
设计
当您提交指定 TPU 代系、拓扑和工作器数量的作业时,Ray 的 SlicePlacementGroup API 会预留完整的 TPU 切片,以便切片中的所有工作器通过芯片间互连 (ICI) 一起进行群组调度。Ray 会为每个工作器 (TPU_VISIBLE_CHIPS) 隔离一个逻辑 TPU 设备,并配置 TorchTPU 的切片构建器地址和网状拓扑。在 Ray Train 中,在 ScalingConfig 中使用 TorchTrainer 设置 use_tpu=True 会自动在工作器之间初始化 tpu 设备和 tpu_dist 进程组。
主要优势
- 拓扑匹配的群组调度:
SlicePlacementGroup和TorchTrainer会将跨主机的 worker 放置位置与物理 TPU 代系和切片布局相匹配,以防止资源碎片化。 - 自动故障恢复:在 GKE 上的 TPU 切片之间运行分布式 DDP、FSDP2 和 DTensor 训练作业,并在工作器或切片发生故障时自动恢复。
- 直接到 TPU 的数据预提取:Ray Data 的
iter_torch_batches方法会将批次作为 PyTorch 张量直接预提取到 TPU 设备内存中。 - 多主机推理编排:Ray Serve LLM (
LLMConfig) 为每个副本预留一个SlicePlacementGroup,并在单主机和多主机 TPU 切片中部署与 OpenAI 兼容的 vLLM-TorchTPU 端点。
如需开始在 GKE 上使用,请参阅 Ray on GKE 简介以及有关如何使用 Ray 和 TorchTPU 在多主机 TPU 上微调模型和使用 Ray 和 TorchTPU 在多主机 TPU 上应用 LLM 的教程。
TPU Agent Suite:适用于 TPU 的编码智能体(预览版)
TPU Agent Suite 是适用于编码辅助(包括 Claude Code 和 Google Antigravity)的开源扩展程序,专注于 TPU v6e 和 TPU7x 上的 Transformer 推理(密集大语言模型和 MoE 模型)。
如需了解详情,请观看开源 TPU Agent Suite 概览:
动机
通用编码辅助通常缺乏有关 TPU 硬件拓扑、XLA 编译器标志、XProf 遥测和 Pallas 内核限制的最新上下文。TPU Agent Suite 可让您的助理访问官方 TPU 文档和结构化工作流。这有助于防止出现无效的标志建议,并自动执行迭代性能分析和基准测试。
设计
该套件会向您现有的编码辅助添加一个 TPU 知识库和四个特定于任务的子智能体。路由智能体 (tpu-agent) 会将每个提示委托给适当的子智能体,而不会自行运行命令。在 TPU 虚拟机或 GKE 集群上执行任何命令都需要获得您的批准,并且调优循环会在返回结果之前运行有限次数的记录尝试。
主要优势
- 模型初始配置和准确率验证:
tpu-model-onboarding智能体可解决不受支持的算子问题,并选择服务路径(vLLM-TorchTPU 或标准 PyTorch)。它还会将逐层输出与 CPU 参考模型进行比较,以验证数值准确性。 - 崩溃和瓶颈诊断:
tpu-diagnostics代理会分析崩溃日志、检查 XProf 性能分析文件和 XLA 编译器跟踪记录,并找出运行时瓶颈。 - 自定义 Pallas 内核开发:
tpu-kernel-development代理可帮助在有限的迭代预算内编写和自动调优自定义 Pallas TPU 内核。 - 带引用的文档查找:
tpu-knowledge-base代理会回答技术问题,并明确引用官方 TPU 文档和教程,同时说明某个主题未涵盖的情况。
如需了解详情,请参阅 TPU Agent Suite 文档,在 TPU Agent Suite GitHub 讨论中分享反馈和提出问题,或在 TPU Agent Suite 问题跟踪器中报告问题。
后续步骤
- 开始阅读 TorchTPU 文档。
- 试用 TPU 上的 TorchTitan 配方。
- 使用 vLLM-TorchTPU 和 SGLang-TorchTPU 部署推理工作负载。
- 在 PyTorch on TPU 讨论论坛中提问。
- 如需与 Google 产品和工程团队讨论特定用例,请发送电子邮件至 torchtpu-feedback@google.com。