


Cloud TPU での PyTorch
Cloud TPU で PyTorch を使用すると、標準の PyTorch セマンティクスと分散 API を使用して、Cloud TPU ハードウェアでオープンモデルのトレーニング、ファインチューニング、サービングを行うことができます。Hugging Face、vLLM、SGLang、llm-d、TorchTitan、TorchRec、Ray など、すでに使用しているエコシステム ツールと統合されます。
スタックの基盤となるのは、Meta の PyTorch チームと共同開発したオープンソースの PyTorch ネイティブ バックエンドである TorchTPU です。TorchTPU は、コア ランタイム実行やカスタム カーネルから、本番環境での推論、大規模なトレーニング、クラスタ オーケストレーションまで、ML ライフサイクルのすべてのステージに対応するライブラリ、フレームワーク、ツールを提供します。
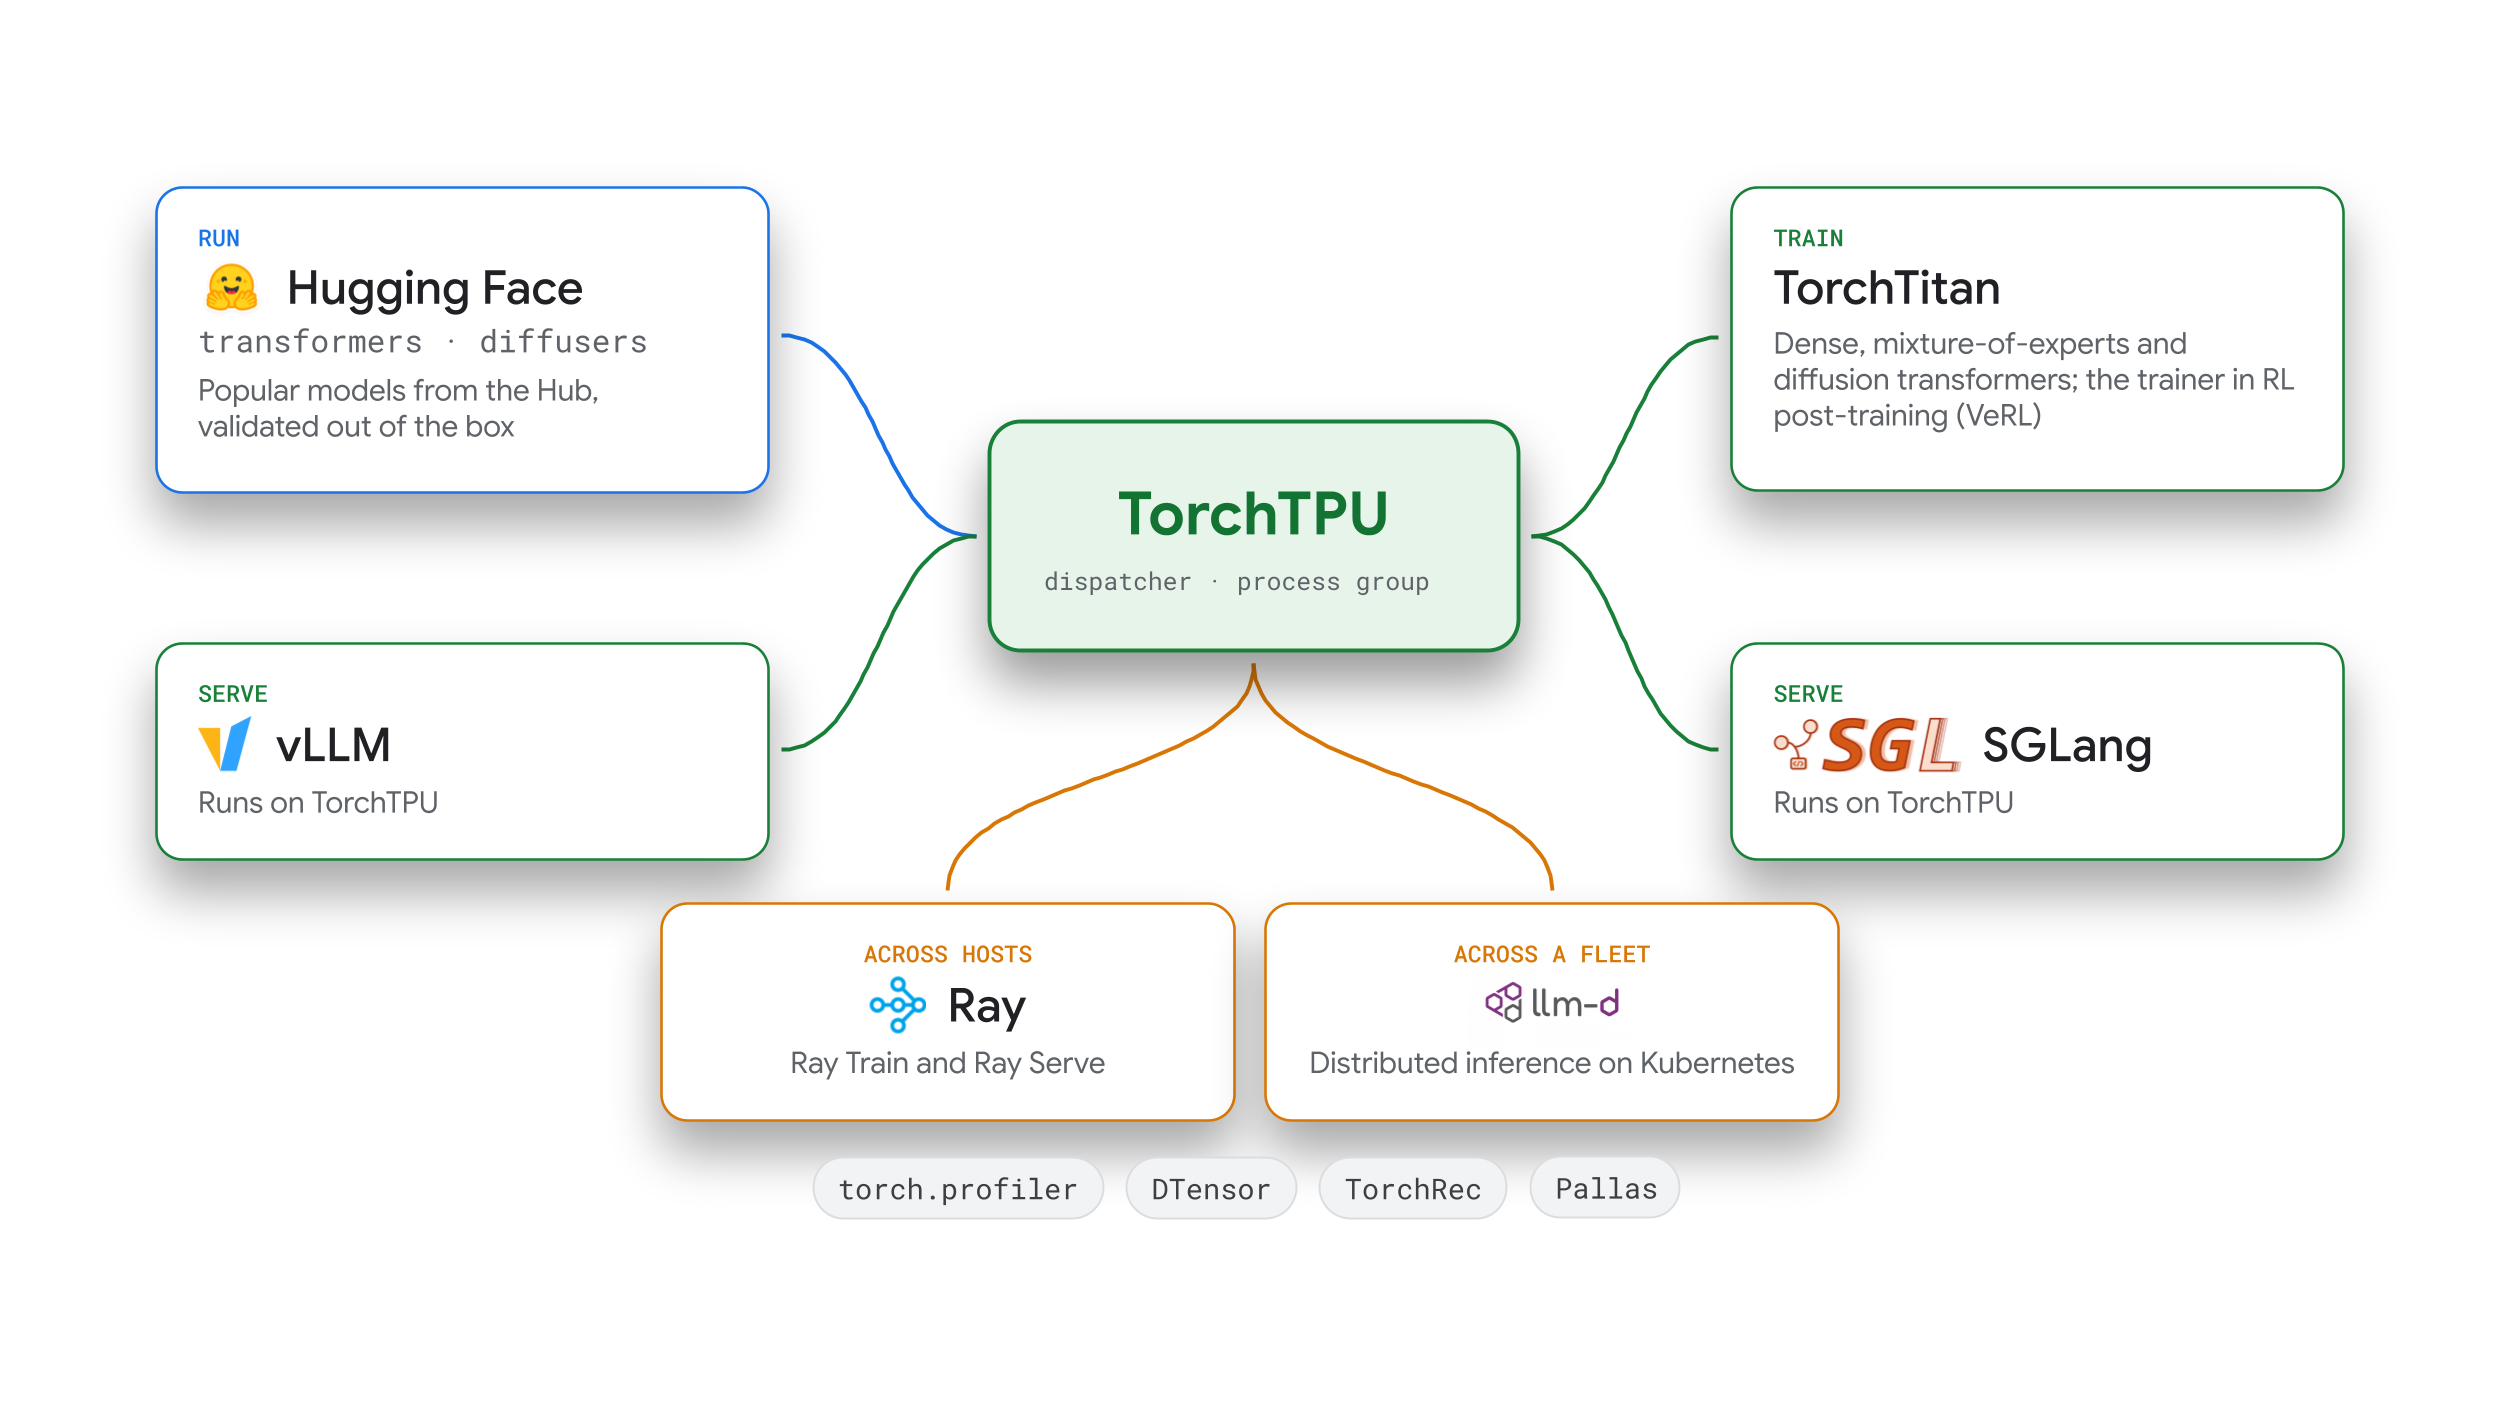
使ってみる
- TPU で PyTorch モデルを実行する: TorchTPU と TorchTPU のドキュメントから始めます。
- 大規模言語モデル(LLM)とマルチモーダル モデルを提供する: vLLM-TorchTPU または SGLang-TorchTPU を使用します。
- Kubernetes フリート全体でリクエストをルーティングする: llm-d を使用します。
- 基盤モデルの事前トレーニングまたはファインチューニング: TPU 上の TorchTitan(またはレコメンデーション モデルの場合は TorchRec)を使用します。
- データ処理、トレーニング、強化学習(RL)、サービング パイプラインをスケーリングする: Ray を使用します。
- コーディング支援を使用してモデルをオンボーディング、プロファイリング、チューニングする: TPU Agent Suite(プレビュー)を使用します。
TorchTPU: Cloud TPU 向けの PyTorch ネイティブ バックエンド
TorchTPU は、Cloud TPU 上の PyTorch 用にデバイス バックエンド、グラフ コンパイラの統合、カスタム カーネル API を提供します。PyTorch チームと共同で開発された TorchTPU を使用すると、eager モードでモデルをインタラクティブにデバッグし、torch.compile でモデルコードをコンパイルし、torch.distributed(tpu_dist)でスライス全体にスケーリングできます。
TorchTPU をインストールするには、次のコマンドを実行します。
pip install torch_tpu
Cloud TPU でテンソル演算を実行するには、次の Python コードを実行します。
import torch

device = torch.device("tpu")

x = torch.randn((4, 4), device=device)
y = torch.ones((4, 4), device=device)
result = torch.matmul(x, y).cpu()

print(f"Executed on device: {x.device}")
print(f"Result shape on CPU: {result.shape}, sum: {result.sum():.4f}")
次の動画では、TorchTPU の概要を説明しています。
詳細については、TorchTPU がオープンソースになりました: TPU でネイティブ PyTorch を実行すると TorchTPU の仕組みをご覧ください。
目的
これまで、Cloud TPU は JAX や TensorFlow と組み合わせて使用されてきましたが、TPU で PyTorch を実行するには、遅延テンソル グラフの記録(PyTorch/XLA)が必要でした。これは、コンパイル可能なリージョンをマークするコードを追加することを意味していました。TorchTPU は、PyTorch の標準の 1 デバイスあたり 1 プロセスの実行モデルを使用して、デフォルトでオペレーションを即時実行します。そのため、既存のワークロードとライブラリは、構造を書き換えることなく実行されます。
デザイン
TorchTPU は、次の 3 つの設計目標に沿って、PyTorch に PyTorch ネイティブの TPU サポートを提供します。
- 標準の PyTorch セマンティクス: デバイスごとに 1 つのプロセスを実行し、JAX ランタイムに依存せずに PyTorch テンソルビューとインプレース ミューテーションを保持します。
- デフォルトで Eager Execution: 標準の PyTorch モデルを Eager モードですぐに実行し、インタラクティブなデバッグとステップバイステップの検査を行います。
- コンパイラとカーネルの最適化: 演算子ごとの Eager Execution に加えて、Eager モードでの演算子の融合、
torch.compileと動的形状境界の統合による再コンパイルの削減、カスタム カーネル API を提供します。
グラフのコンパイルでは、torch.compile は TorchDynamo を使用して PyTorch 計算グラフをキャプチャし、OpenXLA と StableHLO を介して TPU マシンコードにコンパイルします。集合オペレーションは、torch.distributed プロセス グループ レベル(tpu_dist)で実行されます。
主な強み
- 演算子、モデル、Hugging Face のサポート: TorchTPU は、フォワードパスとバックワードパスで標準の PyTorch(ATen)演算子をサポートしており、一般的な Hugging Face モデルに対して継続的にテストされています。
device_map="tpu"を渡して Transformers v5 にモデルをデプロイし、eager モード、torch.compile、テンソル並列処理で Diffusers パイプラインを実行し、TensorBoard と XProf でtorch.profilerを使用してワークロードをプロファイリングできます。 - シングルチップからマルチスライスへのスケーリング:
tpu_distバックエンドは、DistributedDataParallel(DDP)、FullyShardedDataParallel(FSDP2)、DTensorをサポートしています。さらに、torch.tpu.distributed.topology_aware_meshは並列処理ディメンションを物理 TPU 相互接続にマッピングします。 - 構成可能な Eager Execution モード: 次の 3 つの Eager Execution モードが用意されています。
Strict(デフォルト): 標準の命令型 PyTorch セマンティクスを使用して、演算子を個別に非同期でディスパッチします。Debug: テンソル境界チェックと同期して実行されます。DeferAndFuse: 高帯域幅メモリ(HBM)トラフィックを削減するために、eager 演算子のシーケンスを融合します。
- フルグラフのコンパイルとキャッシュ保存:
torch.compile(backend="tpu")は、グラフを TPU 実行可能ファイルにコンパイルし、プロセス、ホスト、ジョブの再起動をまたいでキャッシュに保存します。 - カスタム TPU カーネル: チップ間で直接通信するカーネルを含むカスタム Pallas カーネルを、標準の PyTorch 関数として呼び出すことができます。Tokamax ライブラリのビルド済みカーネルを使用することも、Helion でポータブルなタイルベースのカーネルを作成することもできます。
詳細については、TorchTPU のドキュメントをご覧ください。TPU の PyTorch ディスカッション フォーラムで質問するか、TorchTPU の Issue Tracker で問題を報告してください。
本番環境での推論とサービス提供
本番環境へのデプロイでは、Cloud TPU 上の PyTorch は、オープンソースの推論エンジンと Kubernetes ネイティブの分散サービング インフラストラクチャと統合されます。
vLLM-TorchTPU と SGLang-TorchTPU: 推論エンジン
vLLM-TorchTPU と SGLang-TorchTPU は、vLLM 推論エンジンと SGLang 推論エンジンの TorchTPU バックエンドです。どちらのバックエンドも、Qwen、DeepSeek、GLM、Kimi、GPT-OSS、Gemma 4 などのオープンモデルを実行します。
詳細については、vLLM-TorchTPU のドキュメントと TPU での新しい vLLM および SGLang 推論エンジンの発表をご覧ください。
目的
推論、マルチモーダル、ツールを使用するワークロードを処理するには、多くの場合、カスタムモデル定義、投機的デコード方法、量子化スキームが必要です。TorchTPU で vLLM バックエンドと SGLang バックエンドを構築すると、PyTorch でサービング スタックを直接カスタマイズしてデバッグできます。
デザイン
どちらのバックエンドも、標準の vLLM と SGLang のスケジューラ、Key-Value(KV)キャッシュ マネージャー、API サーバーを保持しながら、内部で TorchTPU 実行とカスタム Pallas 演算子を使用します。ほとんどのモデルは標準の PyTorch モデル定義を実行しますが、コンピューティング負荷の高いブロックはコンパイルされたグラフ内で Pallas カーネルを呼び出すため、ハードウェア固有のカーネルを個別に更新できます。
主な強み
- 並列処理、量子化、投機的デコード: ホスト間のテンソル、データ、エキスパート、パイプライン、コンテキストの並列処理をサポートし、マルチモーダル(画像と動画)入力とエンベディング入力をサポートします。サポートされている投機的デコード方法には、マルチトークン予測(MTP)、EAGLE-3、DFlash、DSpark、n-gram マッチングなどがあります。サポートされている量子化形式には、8 ビット(FP8)KV キャッシュ、8 ビット(FP8)および 4 ビット(MXFP4 および NVFP4)浮動小数点モデル チェックポイントがあります。
- 2 層の接頭辞キャッシュ、ツール呼び出し、構造化出力: 自動接頭辞キャッシュは、アクティブな接頭辞を HBM に保持し、古い接頭辞をホストメモリにオフロードして、マルチターン リクエストでの再計算を回避します。このキャッシュは、ハイブリッド アテンション モデルと再帰モデルをサポートしており、ツール呼び出しと構造化出力が組み込まれています。
- TPU Sync を使用した KV キャッシュ転送のオーバーラップ: TPU Sync を使用して、ホスト間での分離されたプレフィルとデコードのサービング(プロンプト処理とトークン生成を個別のワーカープールに分離)とホスト KV オフロードをサポートします。TPU Sync は、ホスト CPU メモリを介してデータをコピーすることなく、バックグラウンド スレッドで PyTorch デバイス バッファを直接読み取るオープンソースの C++ ライブラリです。
vLLM-TorchTPU の詳細については、vLLM-TorchTPU リポジトリと TPU7x の vLLM-TorchTPU レシピをご覧ください。ご質問がある場合は、vLLM Slack チャンネルでお問い合わせください。また、問題が発生した場合は、vLLM-TorchTPU Issue Tracker で報告してください。
SGLang-TorchTPU の詳細については、SGLang-TorchTPU リポジトリをご覧ください。また、SGLang-TorchTPU Issue Tracker で問題を報告してください。
llm-d: Kubernetes ネイティブの分散推論
llm-d は、Kubernetes での分散 LLM 推論用のオープンソースの Cloud Native Computing Foundation(CNCF)サンドボックス フレームワークです。Red Hat、IBM、 Google Cloud、500 人以上のコントリビューターと 35 の組織からなるコミュニティによって開発されています。
目的
単一インスタンスの推論エンジンはレプリカごとの実行を管理しますが、本番環境フリートは、トラフィックの急増、マルチテナントの優先度、フリート全体のコンテキスト共有、ゼロダウンタイムのロールアウトを処理する必要があります。llm-d は、推論サーバーのフリートを調整するためのクラスタレベルのルーティングとオペレーション レイヤを提供します。
デザイン
llm-d は、Kubernetes 上の vLLM や SGLang などのモデルサーバーの前に実行されます。llm-d は、次の機能を提供します。
- プレフィックス キャッシュの状態とレプリカの負荷に基づいてリクエストをルーティングします。
- 分離されたプレフィル ワーカープールとデコード ワーカープールを調整します。
- Mixture-of-Experts(MoE)シャーディングと非同期バッチ推論をサポートします。
- デバイスメモリ、ホストメモリ、ストレージにわたる階層型 KV キャッシュのオフロードを管理します。
主な強み
- マルチターン セッション ルーティング: マルチターン会話を、キャッシュに保存されたコンテキストを保持するレプリカにルーティングします。ターン優先のスケジューリングとステートフルな Responses API のサポートにより、エージェントはターン間でコンテキストを再利用して再計算を減らすことができます。
- マルチテナントのサービス品質: 優先度と公平性のフロー制御により、レイテンシに敏感なリクエストとバースト性の高いエージェント ワークロードが、リソース不足になることなくフリートを共有できます。
- フリート オペレーションとローリング アップデート: v1 構成 API、ルーターの高可用性、プリフィル レプリカとデコード レプリカを単一の論理ユニットとして管理する調整されたローリング アップデートを提供します。
- Google Kubernetes Engine(GKE)でのネイティブ TorchTPU サービング: 1 つの llm-d エンドポイントの背後で他のアクセラレータとともに Cloud TPU をサービングし、標準の Kubernetes ツールを使用して vLLM-TorchTPU レプリカと SGLang-TorchTPU レプリカを管理できます。
詳細については、GKE Inference Gateway の概要の llm-d ルーターと llm-d GKE Gateway ガイドをご覧ください。質問がある場合は、llm-d Slack チャンネルに投稿してください。問題を報告する場合は、llm-d Issue Tracker をご利用ください。
トレーニング、ファインチューニング、ドメイン ライブラリ
大規模モデルの事前トレーニング、ファインチューニング、適応を行うために、TorchTPU には、TPU ハードウェア用にチューニングされたリファレンス トレーニング レシピとドメイン固有のライブラリが用意されています。
TPU 上の TorchTitan: 大規模トレーニングのリファレンス
TPU 上の TorchTitan は、生成 AI トレーニング用の PyTorch モジュラー リファレンス プラットフォームである TorchTitan を、TPU シャーディング パス、カスタム カーネル、トレーニング レシピで拡張します。
詳細については、TorchTPU を TorchTitan に統合し、TPU 向けにモデルを最適化するをご覧ください。
目的
マルチホスト TPU スライス間でトレーニングをスケーリングするには、チップ相互接続全体でパラメータをシャーディングし、通信と計算を重複させる必要があります。Google と Meta は、TorchTitan 内で TPU のシャーディングとコンパイル パスを共同開発しました。これにより、カスタム TPU シャーディング戦略を設計したり、通信を手動でスケジュールしたりする必要がなくなりました。
デザイン
アクセラレータ固有のコードを使用せずに、単一デバイスの PyTorch でモデルを記述します。TorchTitan は、構成ファイルからモデルレイヤを構成します。これにより、モデル定義やトレーニング ループを編集することなく、個々のレイヤをカスタム Pallas カーネル(Splash Attention など)に置き換えることができます。
TorchTitan の SimpleFSDP 実装では、パラメータ シャーディング オペレーションがコンパイル済みグラフ内に直接配置されるため、XLA コンパイラはデバイス通信と計算をオーバーラップできます。さらに、ステップ全体のグラフ コンパイルでは、トレーニング ステップ全体が単一の XLA プログラムとしてキャプチャされます。マルチスライス実行の場合、ハイブリッド シャーディング(HSDP)は、チップ間相互接続(ICI)を介して各スライス内でシャーディングし、データセンター ネットワーク(DCN)を介してスライス間で複製します。このレイアウトでは、スライス間のトラフィックがステップごとに 1 回の勾配削減に制限されます。
主な強み
- 事前トレーニングと RL ポストトレーニングのレシピ: 高密度 LLM(Llama 3、Qwen 3、MuseGlimmer 30B)、MoE モデル(Qwen 3 235B、最大 8,192 個の TPU7x チップで検証済み)、拡散トランスフォーマー(FLUX.1)のリファレンス レシピが含まれています。RL のトレーニング後の処理(グループ相対ポリシー最適化(GRPO)など)では、VeRL(プレビュー)がパラメータの更新を TorchTitan に委任します。次に、更新された重みをサービング エンジンに push して、トレーニング軌跡(ロールアウト)を生成します。
- 事前構成済みのコンパイラと並列処理の設定: レシピ構成には、事前構成済みのコンパイラと並列処理の設定が含まれているため、コードを変更するのではなく、構成ファイルを使用してモデルの FLOPs 使用率(MFU)を調整できます。
- 新しいアーキテクチャのオンボーディング: Hugging Face Transformers モデリング バックエンドは、TorchTitan トレーナーを介して Hugging Face Hub モデル チェックポイント(エキスパート並列処理のない MoE モデルを含む)を実行します。完全なモデルポートの場合、TorchTitan にはエンジニアとコーディング エージェント向けのステップバイステップのオンボーディング スキルが含まれています。
- スタンドアロン コンポーネントの再利用: TorchTitan をエンドツーエンドで採用することも、個々のモジュール、カスタム演算子、コンパイラ フラグを既存のトレーニング コードベースにインポートすることもできます。
詳細については、TPU での TorchTitan のスタートガイドと TPU7x の TorchTitan Qwen3-8B トレーニング レシピをご覧ください。TorchTitan ディスカッション フォーラムで質問するか、TorchTitan Issue Tracker で問題を報告してください。
TorchRec: レコメンデーション システム
TorchRec は、レコメンデーション モデルに分散エンベディング テーブルとシャーディング プリミティブを提供する PyTorch ドメイン ライブラリです。Cloud TPU では、TorchRec はスパース エンベディング テーブルのルックアップを専用の TPU SparseCore プロセッサにオフロードし、TPU TensorCore で高密度行列演算を実行します。
TorchRec の詳細については、TorchRec のドキュメントをご覧ください。PyTorch on TPU ディスカッション フォーラムで質問するか、TorchRec Issue Tracker で問題を報告してください。
クラスタ オーケストレーションとデベロッパー ツール
マルチノード パイプラインをスケーリングし、モデルのオンボーディングを自動化するために、TorchTPU エコシステムは Ray と統合され、TPU ドキュメントにアクセスできるコーディング エージェント拡張機能を提供します。
Ray: 分散トレーニング、サービング、RL
Ray は、Ray Train、Ray Serve、Ray Data、Ray Core、VeRL(プレビュー)などの RL フレームワークを使用して、クラスタ間で Python と AI のワークロードをスケーリングします。詳細については、Google TPU での PyTorch の Ray サポートの発表をご覧ください。
目的
マルチスライス トレーニングと多段階パイプライン(データの前処理、トレーニング、ロールアウト生成を組み合わせた RL ワークフローなど)には、自動化されたスライス プロビジョニング、トポロジ検出、フォールト トレラントなワーカー調整が必要です。torchrun などのスタンドアロン起動ユーティリティは、TPU スライスをプロビジョニングしたり、多段階アクター パイプラインを調整したりしません。そのため、Ray は TorchTPU ワークロードのクラスタ全体のスケジューリングと配置を管理します。
デザイン
TPU の世代、トポロジ、ワーカー数を指定してジョブを送信すると、Ray の SlicePlacementGroup API が完全な TPU スライスを予約します。これにより、スライス内のすべてのワーカーがチップ間相互接続(ICI)を介してギャング スケジューリングされます。Ray は、ワーカー(TPU_VISIBLE_CHIPS)ごとに 1 つの論理 TPU デバイスを分離し、TorchTPU のスライスビルダーのアドレスとメッシュ トポロジを構成します。Ray Train で、TorchTrainer を使用して ScalingConfig で use_tpu=True を設定すると、tpu デバイスと tpu_dist プロセス グループがワーカー間で自動的に初期化されます。
主な強み
- トポロジに一致するギャング スケジューリング:
SlicePlacementGroupとTorchTrainerは、ホスト間のワーカーの配置を物理 TPU の世代とスライス レイアウトに一致させ、リソースの断片化を防ぎます。 - 自動障害復旧: ワーカーまたはスライスに障害が発生した場合に自動復旧を行い、GKE の TPU スライス全体で分散 DDP、FSDP2、DTensor トレーニング ジョブを実行します。
- TPU への直接データ プリフェッチ: Ray Data の
iter_torch_batchesメソッドは、バッチを PyTorch テンソルとして TPU デバイスメモリに直接プリフェッチします。 - マルチホスト推論オーケストレーション: Ray Serve LLM(
LLMConfig)は、レプリカごとにSlicePlacementGroupを予約し、単一ホストとマルチホストの TPU スライスに OpenAI 互換の vLLM-TorchTPU エンドポイントをデプロイします。
GKE を使い始めるには、GKE での Ray についてと、Ray と TorchTPU を使用してマルチホスト TPU でモデルをファインチューニングする方法と Ray と TorchTPU を使用してマルチホスト TPU で LLM をサービングする方法に関するチュートリアルをご覧ください。
TPU Agent Suite: TPU 向けコーディング エージェント(プレビュー)
TPU Agent Suite は、Claude Code や Google Antigravity などのコーディング支援向けのオープンソース拡張機能で、TPU v6e と TPU7x での Transformer 推論(高密度 LLM と MoE モデル)に重点を置いています。
詳細については、オープンソースの TPU Agent Suite の概要をご覧ください。
目的
汎用のコーディング支援には、TPU ハードウェア トポロジ、XLA コンパイラ フラグ、XProf テレメトリー、Pallas カーネル制約に関する最新のコンテキストが欠けていることがよくあります。TPU Agent Suite を使用すると、アシスタントは公式の TPU ドキュメントと構造化されたワークフローにアクセスできます。これにより、無効なフラグの提案を防ぎ、反復的なプロファイリングとベンチマークを自動化できます。
デザイン
このスイートは、TPU ナレッジベースと 4 つのタスク固有のサブエージェントを既存のコーディング支援に追加します。ルーター エージェント(tpu-agent)は、コマンド自体を実行せずに、各プロンプトを適切なサブエージェントに委任します。TPU VM または GKE クラスタでのコマンド実行には、ユーザーの承認が必要です。チューニング ループは、記録された試行回数を制限して実行し、結果を返します。
主な強み
- モデルのオンボーディングと精度の検証:
tpu-model-onboardingエージェントは、サポートされていない演算子を解決し、サービングパス(vLLM-TorchTPU または標準の PyTorch)を選択します。また、レイヤごとの出力を CPU リファレンス モデルと比較して、数値の精度を検証します。 - クラッシュとボトルネックの診断:
tpu-diagnosticsエージェントは、クラッシュログを分析し、XProf プロファイルと XLA コンパイラ トレースを検査して、ランタイムのボトルネックを特定します。 - カスタム Pallas カーネルの開発:
tpu-kernel-developmentエージェントは、制限された反復処理予算内でカスタム Pallas TPU カーネルの作成と自動チューニングを支援します。 - 引用付きのドキュメント検索:
tpu-knowledge-baseエージェントは、公式の TPU ドキュメントとチュートリアルを明示的に引用して技術的な質問に回答し、トピックがカバーされていない場合はその旨を明記します。
詳細については、TPU Agent Suite のドキュメントをご覧ください。フィードバックの共有や質問は、TPU Agent Suite の GitHub ディスカッションで行ってください。問題の報告は、TPU Agent Suite の Issue Tracker で行ってください。
次のステップ
- TorchTPU のドキュメントを確認する。
- TPU での TorchTitan のレシピを試す。
- vLLM-TorchTPU と SGLang-TorchTPU を使用して推論ワークロードをデプロイする。
- TPU 上の PyTorch ディスカッション フォーラムで質問する。
- Google のプロダクト チームやエンジニアリング チームと特定のユースケースについて話し合うには、torchtpu-feedback@google.com にメールを送信してください。