


Práticas recomendadas de escalonamento para o Cloud Service Mesh no GKE
Este guia descreve as práticas recomendadas para resolver problemas de escalonamento de arquiteturas gerenciadas do Cloud Service Mesh no Google Kubernetes Engine. O principal objetivo dessas recomendações é garantir a performance, a confiabilidade e a utilização de recursos ideais para seus aplicativos de microsserviços à medida que eles crescem.
Para entender as limitações de escalonabilidade, consulte Limites de escalonabilidade do Cloud Service Mesh.
A escalonabilidade do Cloud Service Mesh no GKE depende da operação eficiente dos dois principais componentes: o plano de dados e o plano de controle. Este documento se concentra principalmente no escalonamento do plano de dados.
Como identificar problemas de escalonamento do plano de controle e do plano de dados
No Cloud Service Mesh, problemas de escalonamento podem ocorrer no plano de controle ou no plano de dados. Confira como identificar o tipo de problema de escalonamento que você está enfrentando:
Sintomas de problemas de escalonamento do plano de controle
Descoberta de serviço lenta:novos serviços ou endpoints demoram muito para serem descobertos e ficarem disponíveis.
Atrasos na configuração:as mudanças nas regras de gerenciamento de tráfego ou nas políticas de segurança demoram muito para serem propagadas.
Aumento da latência nas operações do plano de controle:operações como criar, atualizar ou excluir recursos do Cloud Service Mesh ficam lentas ou não respondem.
Erros relacionados ao Traffic Director:você pode observar erros nos registros do Cloud Service Mesh ou nas métricas do plano de controle que indicam problemas de conectividade, esgotamento de recursos ou limitação de API.
Escopo do impacto:os problemas do plano de controle geralmente afetam toda a malha, causando uma degradação generalizada da performance.
Propagação da configuração
Ao usar o Cloud Service Mesh gerenciado, é importante entender as expectativas em relação à latência de propagação da configuração.
Como o plano de controle orquestra a infraestrutura global, as modificações nos recursos de configuração, como VirtualService e DestinationRule, levam mais tempo para serem propagadas aos sidecars. As plataformas de entrega contínua não devem depender de atrasos de tempo estáticos ou de portões de tempo estritos para a propagação da configuração. Em vez disso, verifique se as operações de lançamento são idempotentes e concentre-se em verificar ativamente se a mudança de tráfego ou a propagação da configuração foi concluída antes de prosseguir para as próximas etapas. Remova qualquer dependência de "marcação de tempo" que não seja um tempo de imersão dedicado aplicado após confirmar que a configuração correta está em vigor.
Sintomas de problemas de escalonamento do plano de dados
Aumento da latência na comunicação entre serviços:as solicitações para um serviço na malha apresentam maior latência ou tempos limite, mas não há uso elevado de CPU/uso da memória nos contêineres do serviço.
Alto uso de CPU ou memória em proxies do Envoy:o alto uso de CPU ou memória pode indicar que os proxies estão com dificuldades para lidar com a carga de tráfego.
Impacto localizado:os problemas do plano de dados geralmente afetam serviços ou cargas de trabalho específicos, dependendo dos padrões de tráfego e da utilização de recursos dos proxies do Envoy.
Escalonar o plano de dados
Para escalonar o plano de dados, tente as seguintes técnicas:
- Configurar o escalonamento automático horizontal de pods (HPA)
- Otimizar a configuração do proxy do Envoy
- Otimizar a divisão de tráfego
- Monitorar e ajustar
Configurar o escalonamento automático horizontal de pods (HPA) para cargas de trabalho
Use o escalonamento automático horizontal de pods (HPA) para escalonar cargas de trabalho dinamicamente com mais pods com base na utilização de recursos. Considere o seguinte ao configurar o HPA:
Use o parâmetro
--horizontal-pod-autoscaler-sync-periodparakube-controller-managerpara ajustar a taxa de pesquisa do controlador HPA. A taxa de pesquisa padrão é de 15 segundos, e você pode definir um valor menor se esperar picos de tráfego mais rápidos. Para saber mais sobre quando usar o HPA com o GKE, consulte Escalonamento automático horizontal de pods.O comportamento de escalonamento padrão pode resultar na implantação (ou encerramento) de um grande número de pods de uma só vez, o que pode causar um pico no uso de recursos. Considere o uso de políticas de escalonamento para limitar a taxa em que os pods podem ser implantados.
Use EXIT_ON_ZERO_ACTIVE_CONNECTIONS para evitar a queda de conexões durante o escalonamento.
Para mais detalhes sobre o HPA, consulte Escalonamento automático horizontal de pods na documentação do Kubernetes.
Otimizar a configuração do proxy do Envoy
Para otimizar a configuração do proxy do Envoy, considere as seguintes recomendações:
Limites de recursos
É possível definir solicitações e limites de recursos para sidecars do Envoy nas especificações do pod. Isso evita a contenção de recursos e garante uma performance consistente.
É possível substituir os limites de recursos para cargas de trabalho específicas usando anotações de recursos nas especificações do pod.
Os limites de recursos ideais para seus proxies do Envoy dependem de fatores como volume de tráfego, complexidade da carga de trabalho e recursos do nó do GKE. Monitore e ajuste continuamente a malha de serviço para garantir a performance ideal.
Consideração importante :
- Qualidade de serviço (QoS) : definir solicitações e limites garante que seus proxies do Envoy tenham uma qualidade de serviço previsível.
Escopo das dependências de serviço
Considere reduzir o gráfico de dependência da malha declarando todas as dependências pela API Sidecar. Isso limita o tamanho e a complexidade da configuração enviada a uma determinada carga de trabalho, o que é fundamental para malhas maiores.
Como exemplo, a seguir está o gráfico de tráfego do aplicativo de amostra da boutique on-line.
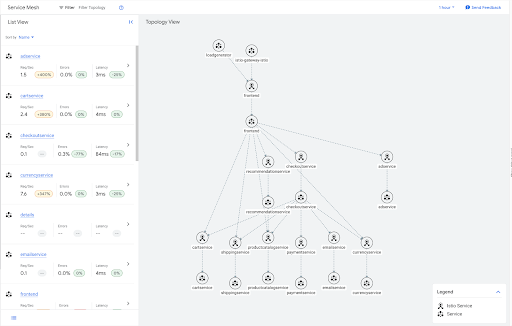
Muitos desses serviços são folhas no gráfico e, portanto, não precisam ter informações de saída para nenhum dos outros serviços na malha. É possível aplicar um recurso sidecar que limita o escopo da configuração do sidecar para esses serviços de folha, conforme mostrado no exemplo a seguir.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: leafservices
  namespace: default
spec:
  workloadSelector:
    labels:
      app: cartservice
      app: shippingservice
      app: productcatalogservice
      app: paymentservice
      app: emailservice
      app: currencyservice
  egress:
  -   hosts:
    -   "~/*"
Consulte o aplicativo de amostra da boutique on-line para detalhes sobre como implantar esse aplicativo de amostra.
Outro benefício do escopo do sidecar é a redução de consultas DNS desnecessárias. As dependências de serviço de escopo garantem que um sidecar do Envoy só faça consultas DNS para serviços com que ele realmente se comunicará, em vez de todos os clusters na malha de serviço.
Para implantações em grande escala que enfrentam problemas com tamanhos de configuração grandes nos sidecars, o escopo das dependências de serviço é altamente recomendado para a escalonabilidade da malha.
Para limitar o escopo da configuração de todas as cargas de trabalho em um único namespace, crie um recurso sidecar nesse namespace. Isso instrui todos os proxies do Envoy nesse namespace a receber apenas a configuração de serviços no próprio namespace.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: sidecar
  namespace: my-app
spec:
  egress:
  -   hosts:
    -   "my-app/*"
É possível aplicar o comportamento padrão para cada namespace na malha aplicando um único recurso sidecar ao namespace raiz, normalmente istio-system.
O sidecar a seguir restringe o tráfego de saída de cada sidecar na malha para serviços localizados no próprio namespace.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: sidear
  namespace: istio-system
spec:
  egress:
  -   hosts:
    -   "./*"
O Cloud Service Mesh impõe um limite ao número total de recursos sidecar que podem ser criados em uma única malha. Devido a essa restrição, a prática recomendada é criar um sidecar no nível do namespace.
Otimizar a divisão de tráfego
Se você depende de mudanças frequentes de tráfego, como lançamentos progressivos ou implantações azul-verde, o método usado para dividir o tráfego afetará a latência da configuração.
- Evite subconjuntos para mudanças rápidas:dividir o tráfego usando campos
subsetnoVirtualServiceem combinação com umaDestinationRulefaz com que o plano de controle crie, desanexe e anexe rapidamente os grupos de endpoints de rede (NEGs, na sigla em inglês) subjacentes. Essa reconciliação adiciona atrasos significativos de vários minutos, o que pode resultar na omissão de pesos de tráfego intermediários durante lançamentos automatizados rápidos. - Prefira o roteamento com base em host:em vez de usar subconjuntos, configure suas implantações para usar a divisão de tráfego com base em host. Ao rotear o tráfego entre serviços do Kubernetes de back-end completamente distintos com base nas configurações de host
VirtualService, o plano de controle evita a alteração das configurações de NEG. Isso reduz o overhead da infraestrutura e resulta em uma propagação de configuração muito mais rápida.
Monitorar e ajustar
Depois de definir os limites de recursos iniciais, é fundamental monitorar os proxies do Envoy para garantir que eles estejam funcionando de maneira ideal. Use os painéis do GKE para monitorar o uso de CPU e memória e ajustar os limites de recursos conforme necessário.
Para determinar se um proxy do Envoy exige limites de recursos aumentados, monitore o consumo de recursos em condições de tráfego típicas e de pico. Confira o que procurar:
Alto uso da CPU:se o uso da CPU do Envoy se aproximar ou exceder consistentemente o limite, ele poderá ter dificuldades para processar solicitações, levando a maior latência ou solicitações descartadas. Considere aumentar o limite da CPU.
Você pode estar inclinado a escalonar usando o escalonamento horizontal nesse caso, mas se o proxy sidecar não conseguir processar as solicitações tão rapidamente quanto o contêiner do aplicativo, o ajuste dos limites da CPU poderá produzir os melhores resultados.
Alto uso da memória:se o uso da memória do Envoy se aproximar ou exceder o limite, ele poderá começar a descartar conexões ou apresentar erros de memória insuficiente (OOM). Aumente o limite de memória para evitar esses problemas.
Registros de erros:examine os registros do Envoy para erros relacionados ao esgotamento de recursos, como erros upstream connect error ou disconnect or reset before headers ou too many open files. Esses erros podem indicar que o proxy precisa de mais recursos. Consulte os documentos de solução de problemas de escalonamento para outros erros relacionados a problemas de escalonamento.
Métricas de performance:monitore as principais métricas de performance, como latência de solicitação, taxas de erro e capacidade de processamento. Se você notar uma degradação da performance correlacionada com a alta utilização de recursos, pode ser necessário aumentar os limites.
Ao definir e monitorar ativamente os limites de recursos para os proxies do plano de dados, você pode garantir que a malha de serviço seja escalonada de maneira eficiente no GKE.
Escalonar o plano de controle
Esta seção descreve as configurações a serem ajustadas para escalonar o plano de controle.
Seletores de descoberta
Os seletores de descoberta são um campo no MeshConfig que permite especificar o conjunto de namespaces que os planos de controle consideram ao calcular atualizações de configuração para sidecars.
Por padrão, o Cloud Service Mesh monitora todos os namespaces no cluster. Isso pode ser um gargalo para clusters grandes que não precisam monitorar todos os recursos.
Use discoverySelectors para reduzir a carga computacional no plano de controle, limitando o número de recursos do Kubernetes (como serviços, pods e endpoints) que são monitorados e processados.
Ao usar a implementação do plano de controle TRAFFIC_DIRECTOR,
o Cloud Service Mesh só cria Google Cloud recursos, como serviços de back-end
e grupos de endpoints de rede, para recursos do Kubernetes em namespaces
especificados em discoverySelectors.
Para mais informações, consulte Seletores de descoberta na documentação do Istio (em inglês).
Minimizar a pegada de configuração
Use seletores de descoberta para limitar a pegada de configuração. É possível usar a configuração de saída do sidecar para limitar o uso de memória do proxy, mas a API Sidecar cria configurações mais complexas. Use a API Sidecar apenas para resolver problemas significativos de performance do plano de dados, porque ela aumenta a carga do plano de controle e reduz a escalonabilidade geral da malha.
Como criar resiliência
É possível ajustar as seguintes configurações para criar resiliência na malha de serviço:
Detecção de outlier
A detecção de outlier monitora hosts em um serviço upstream e os remove do pool de balanceamento de carga ao atingir um determinado limite de erro.
- Configuração principal
outlierDetection: configurações que controlam a remoção de hosts não íntegros do pool de balanceamento de carga.
- Benefícios:mantém um conjunto íntegro de hosts no pool de balanceamento de carga.
Para mais informações, consulte Detecção de outlier na documentação do Istio (em inglês).
Novas tentativas
Mitigue erros transitórios tentando novamente as solicitações com falha automaticamente.
- Configuração principal
attempts: número de novas tentativas.perTryTimeout: tempo limite por nova tentativa. Defina um valor menor que o tempo limite geral. Ele determina quanto tempo você vai esperar por cada nova tentativa.retryBudget: número máximo de novas tentativas simultâneas.
- Benefícios:taxas de sucesso mais altas para solicitações, impacto reduzido de falhas intermitentes.
Fatores a considerar :
- Idempotência:verifique se a operação que está sendo repetida é idempotente, o que significa que ela pode ser repetida sem efeitos colaterais indesejados.
- Número máximo de novas tentativas:limite o número de novas tentativas (por exemplo, no máximo 3) para evitar loops infinitos.
- Quebra de circuito:integre novas tentativas com disjuntores para evitar novas tentativas quando um serviço falhar consistentemente.
Para mais informações, consulte Novas tentativas na documentação do Istio (em inglês).
Tempos limite
Use tempos limite para definir o tempo máximo permitido para o processamento de solicitações.
- Configuração principal
timeout: tempo limite de solicitação para um serviço específico.idleTimeout: tempo que uma conexão pode permanecer inativa antes do fechamento.
- Benefícios:melhor capacidade de resposta do sistema, prevenção de vazamentos de recursos, proteção contra tráfego malicioso.
Fatores a considerar :
- Latência de rede:considere o tempo de retorno (RTT) esperado entre os serviços. Deixe algum buffer para atrasos inesperados.
- Gráfico de dependência de serviço:para solicitações encadeadas, verifique se o tempo limite de um serviço de chamada é menor que o tempo limite cumulativo das dependências dele para evitar falhas em cascata.
- Tipos de operações:tarefas de longa duração podem precisar de tempos limite significativamente maiores do que recuperações de dados.
- Tratamento de erros:os tempos limite precisam acionar a lógica de tratamento de erros apropriada (por exemplo, nova tentativa, fallback, quebra de circuito).
Para mais informações, consulte Tempos limite na documentação do Istio (em inglês).
Monitorar e ajustar
Considere começar com as configurações padrão para tempos limite, detecção de outlier e novas tentativas e, em seguida, ajuste-as gradualmente com base nos requisitos específicos do serviço e nos padrões de tráfego observados. Por exemplo, analise dados reais sobre quanto tempo seus serviços normalmente levam para responder. Em seguida, ajuste os tempos limite para corresponder às características específicas de cada serviço ou endpoint.
Telemetria
Use a telemetria para monitorar continuamente a malha de serviço e ajustar a configuração dela para otimizar a performance e a confiabilidade.
- Métricas:use métricas abrangentes, especificamente, volumes de solicitações, latência e taxas de erro. Integre ao Cloud Monitoring para visualização e alertas.
- Rastreamento distribuído: ative a integração de rastreamento distribuído com Cloud Trace para ter insights detalhados sobre os fluxos de solicitação nos seus serviços.
- Registro:configure o registro de acesso para capturar informações detalhadas sobre solicitações e respostas.
Informações adicionais
- Para saber mais sobre o Cloud Service Mesh, consulte a visão geral do Cloud Service Mesh.
- Para orientações gerais sobre engenharia de confiabilidade do site (SRE) sobre escalonabilidade, consulte os capítulos Como lidar com sobrecarga e Como lidar com falhas em cascata no livro do Google sobre SRE (em inglês).