


שיטות מומלצות להתאמת קנה מידה של Cloud Service Mesh ב-GKE
במדריך הזה מתוארות שיטות מומלצות לפתרון בעיות שקשורות לשינוי גודל בארכיטקטורות מנוהלות של Cloud Service Mesh ב-Google Kubernetes Engine. המטרה העיקרית של ההמלצות האלה היא להבטיח ביצועים אופטימליים, אמינות וניצול משאבים של אפליקציות המיקרו-שירותים שלכם כשהן גדלות.
כדי להבין את המגבלות על יכולת ההתאמה לגודל, אפשר לעיין במאמר מגבלות על יכולת ההתאמה לגודל של Cloud Service Mesh.
היכולת של Cloud Service Mesh להתרחב ב-GKE תלויה בפעולה היעילה של שני הרכיבים העיקריים שלו: מישור הנתונים ומישור הבקרה. המאמר הזה מתמקד בעיקר בהרחבת מישור הנתונים.
זיהוי בעיות בהרחבת מישור הבקרה לעומת מישור הנתונים
ב-Cloud Service Mesh, בעיות שקשורות לשינוי גודל יכולות להתרחש במישור הבקרה או במישור הנתונים. כך אפשר לזהות את סוג הבעיה שקשורה להרחבת הפעילות:
תסמינים של בעיות בהרחבת מישור הבקרה
גילוי שירותים איטי: לוקח הרבה זמן עד שמערכת ה-DNS מגלה שירותים או נקודות קצה חדשים והם הופכים לזמינים.
עיכובים בהגדרות: חולף זמן רב עד ששינויים בכללי ניהול התנועה או במדיניות האבטחה מופצים.
עלייה בחביון בפעולות של רמת הבקרה: פעולות כמו יצירה, עדכון או מחיקה של משאבי Cloud Service Mesh הופכות לאיטיות או לא מגיבות.
שגיאות שקשורות ל-Traffic Director: יכול להיות שתראו שגיאות ביומנים של Cloud Service Mesh או במדדים של מישור הבקרה שמצביעות על בעיות בקישוריות, על ניצול יתר של משאבים או על הגבלת קצב של API.
היקף ההשפעה: בעיות במישור הבקרה משפיעות בדרך כלל על כל הרשת, וגורמות לירידה נרחבת בביצועים.
הפצת ההגדרות
כשמשתמשים ב-Managed Cloud Service Mesh, חשוב להבין את הציפיות לגבי זמן האחזור של הפצת ההגדרות.
מישור הבקרה מתזמן את התשתית הגלובלית, ולכן לוקח יותר זמן להפיץ שינויים במשאבי ההגדרה כמו VirtualService ו-DestinationRule ל-sidecar. פלטפורמות לפיתוח רציף לא צריכות להסתמך על השהיות סטטיות בתזמון או על שערי זמן קפדניים להפצת ההגדרות. במקום זאת, מוודאים שפעולות ההשקה הן אידמפוטנטיות ומתמקדים באימות פעיל של השלמת העברת התנועה או הפצת ההגדרות לפני שממשיכים לשלבים הבאים. יש להסיר כל תלות ב'תזמון' מלבד זמן טבילה ייעודי שמוגדר אחרי שמוודאים שההגדרה הנכונה קיימת.
תסמינים של בעיות בהתאמת קנה המידה של מישור הנתונים
עלייה בחביון בתקשורת בין שירותים: בקשות לשירות בתוך הרשת חווים חביון גבוה יותר או פסק זמן, אבל אין עלייה בשימוש במעבד או בזיכרון במאגרי הנתונים של השירות.
שימוש גבוה ב-CPU או בזיכרון בשרתי proxy של Envoy: שימוש גבוה ב-CPU או בזיכרון עשוי להצביע על כך ששרתי ה-proxy מתקשים להתמודד עם עומס התנועה.
השפעה מקומית: בעיות במישור הנתונים משפיעות בדרך כלל על שירותים או עומסי עבודה ספציפיים, בהתאם לדפוסי התנועה ולניצול המשאבים של שרתי ה-proxy של Envoy.
שינוי קנה המידה של מישור הנתונים
כדי להרחיב את מישור הנתונים, אפשר לנסות את הטכניקות הבאות:
- הגדרת התאמה אופקית של קבוצות Pod לעומס (HPA)
- אופטימיזציה של הגדרת פרוקסי של Envoy
- אופטימיזציה של חלוקת התנועה
- מעקב וכוונון
הגדרת Horizontal Pod Autoscaling (HPA) לעומסי עבודה
אפשר להשתמש ב-התאמה אופקית של קבוצות Pod לעומס (HPA) כדי לשנות את גודל עומסי העבודה באופן דינמי באמצעות הוספה של קבוצות Pod נוספות על סמך ניצול המשאבים. כשמגדירים את HPA, כדאי להביא בחשבון את הנקודות הבאות:
משתמשים בפרמטר
--horizontal-pod-autoscaler-sync-periodkube-controller-managerכדי לשנות את קצב הסקר של בקר ה-HPA. קצב הסקרים שמוגדר כברירת מחדל הוא 15 שניות, ואולי כדאי להגדיר אותו כנמוך יותר אם אתם צופים עליות מהירות בתנועת הגולשים. למידע נוסף על מקרים שבהם כדאי להשתמש ב-HPA עם GKE, אפשר לקרוא את המאמר התאמה אופקית של קבוצות Pod לעומס.התנהגות ברירת המחדל של שינוי הגודל יכולה להוביל לפריסה (או לסיום) של מספר גדול של פודים בבת אחת, מה שיכול לגרום לעלייה חדה בשימוש במשאבים. כדאי להשתמש בכללי מדיניות של שינוי גודל כדי להגביל את קצב הפריסה של הפודים.
כדי למנוע ניתוקים במהלך צמצום הקיבולת, משתמשים ב-EXIT_ON_ZERO_ACTIVE_CONNECTIONS.
לפרטים נוספים על HPA, אפשר לעיין במאמר בנושא שינוי אוטומטי של מספר העותקים של Pod אופקית במסמכי העזרה של Kubernetes.
אופטימיזציה של ההגדרה של Envoy Proxy
כדי לבצע אופטימיזציה של ההגדרה של Envoy proxy, כדאי לפעול לפי ההמלצות הבאות:
מגבלות על משאבים
אתם יכולים להגדיר בקשות למשאבים ומגבלות עבור Envoy sidecars במפרטי ה-Pod. כך נמנעת תחרות על משאבים ומושגת רמת ביצועים עקבית.
אתם יכולים לבטל את מגבלות המשאבים לעומסי עבודה ספציפיים באמצעות הערות משאבים במפרטים של ה-Pod.
מגבלות המשאבים האופטימליות עבור שרתי ה-proxy של Envoy תלויות בגורמים כמו נפח התנועה, מורכבות עומס העבודה ומשאבי הצומת של GKE. חשוב לעקוב אחרי Service mesh ולבצע בו כוונון באופן שוטף כדי להבטיח ביצועים אופטימליים.
שיקול חשוב:
- איכות השירות (QoS): הגדרת בקשות ומגבלות מבטיחה שלשרתי ה-proxy של Envoy תהיה איכות שירות צפויה.
הגדרת היקף של יחסי תלות בין שירותים
כדאי לשקול לצמצם את גרף התלות של הרשת על ידי הצהרה על כל התלויות באמצעות Sidecar API. כך מגבילים את הגודל והמורכבות של התצורה שנשלחת לעומס עבודה מסוים, וזה חשוב במיוחד לרשתות גדולות יותר.
לדוגמה, התרשים הבא מציג את התנועה באפליקציית הדוגמה של חנות הבוטיק אונליין.
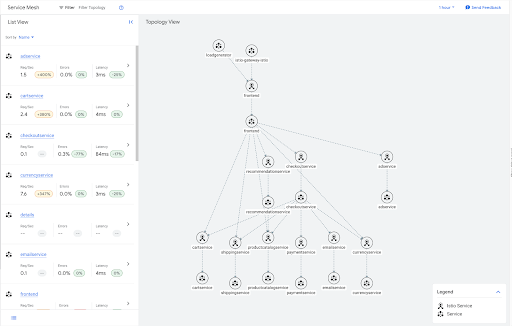
הרבה מהשירותים האלה הם עלים בגרף, ולכן הם לא צריכים לכלול מידע על יציאה לשירותים אחרים ברשת. אפשר להחיל משאב Sidecar שמגביל את היקף ההגדרה של ה-Sidecar בשירותים האלה ברמת העלה, כמו בדוגמה הבאה.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: leafservices
  namespace: default
spec:
  workloadSelector:
    labels:
      app: cartservice
      app: shippingservice
      app: productcatalogservice
      app: paymentservice
      app: emailservice
      app: currencyservice
  egress:
  -   hosts:
    -   "~/*"
במאמר דוגמה לאפליקציה של בוטיק אונליין מוסבר איך פורסים את האפליקציה לדוגמה הזו.
יתרון נוסף של הגדרת היקף של קובץ sidecar הוא צמצום של שאילתות DNS מיותרות. הגדרת היקף של יחסי תלות בין שירותים מבטיחה ש-Envoy sidecar יבצע רק שאילתות DNS לשירותים שהוא יתקשר איתם בפועל, במקום לכל אשכול ב-Service mesh.
בכל פריסה רחבת היקף שבה יש בעיות עם גדלים גדולים של קובצי הגדרות ב-sidecars, מומלץ מאוד להגדיר את התלות בשירותים כדי לשפר את יכולת ההתאמה של הרשת.
כדי להגביל את היקף ההגדרה לכל עומסי העבודה במרחב שמות יחיד, יוצרים משאב Sidecar אחד במרחב השמות הזה. ההוראה הזו גורמת לכל שרתי ה-proxy של Envoy במרחב השמות הזה לקבל רק הגדרות של שירותים במרחב השמות שלהם.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: sidecar
  namespace: my-app
spec:
  egress:
  -   hosts:
    -   "my-app/*"
אפשר להחיל התנהגות ברירת מחדל על כל מרחב שמות ברשת על ידי החלת משאב Sidecar יחיד על מרחב השמות הבסיסי, בדרך כלל istio-system.
ה-Sidecar הבא מגביל את תנועת היציאה של כל Sidecar ברשת לשירותים שנמצאים במרחב השמות שלו.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: sidear
  namespace: istio-system
spec:
  egress:
  -   hosts:
    -   "./*"
שימו לב: ב-Cloud Service Mesh יש הגבלה על המספר הכולל של משאבי Sidecar שאפשר ליצור ברשת אחת. בגלל המגבלה הזו, מומלץ ליצור Sidecar ברמת מרחב השמות.
אופטימיזציה של חלוקת התנועה
אם אתם מסתמכים על העברת תנועה תכופה – כמו השקות הדרגתיות או פריסות כחולות-ירוקות – השיטה שבה אתם משתמשים כדי לפצל את התנועה תשפיע על זמן האחזור של ההגדרה.
- לא מומלץ להשתמש בתת-קבוצות כדי לבצע שינויים מהירים: פיצול התנועה באמצעות שדות
subsetב-VirtualServiceבשילוב עםDestinationRuleגורם למישור הבקרה ליצור, לנתק ולחבר מחדש במהירות קבוצות בסיסיות של נקודות קצה ברשת (NEGs). התהליך הזה מוסיף עיכובים משמעותיים של כמה דקות, ולכן יכול להיות שמשקלי התנועה הביניים יידלגו במהלך השקות אוטומטיות מהירות. - העדפה של ניתוב מבוסס-מארח: במקום להשתמש בקבוצות משנה, מגדירים את הפריסות כך שישתמשו בפיצול תנועה מבוסס-מארח. על ידי ניתוב תנועה בין שירותי Kubernetes שונים לחלוטין שמגובים על ידי
VirtualServiceהגדרות מארח, מישור הבקרה נמנע משינוי הגדרות של NEG. כך מצמצמים את עלויות התקורה של התשתית ומקבלים הפצה מהירה יותר של ההגדרות.
מעקב וכוונון
אחרי שמגדירים את מגבלות המשאבים הראשוניות, חשוב לעקוב אחרי שרתי ה-proxy של Envoy כדי לוודא שהם פועלים בצורה אופטימלית. אפשר להשתמש במרכזי הבקרה של GKE כדי לעקוב אחרי השימוש במעבד ובזיכרון, ולשנות את מגבלות המשאבים לפי הצורך.
כדי לקבוע אם פרוקסי Envoy דורש הגדלה של מגבלות המשאבים, צריך לעקוב אחרי צריכת המשאבים שלו בתנאי תנועה רגילים ובתנאי תנועה בשיא. אלה הפרטים שצריך לחפש:
שימוש גבוה במעבד: אם השימוש במעבד של Envoy מתקרב באופן עקבי למגבלה או חורג ממנה, יכול להיות שהוא מתקשה לעבד בקשות, מה שמוביל לזמן אחזור מוגבר או לבקשות שנפסלות. כדאי להגדיל את המגבלה על יחידת העיבוד המרכזית (CPU).
במקרה כזה, יכול להיות שתחשבו על הגדלת הקיבולת באמצעות הגדלה אופקית, אבל אם שרת ה-proxy של ה-sidecar לא מצליח לעבד את הבקשות במהירות כמו קונטיינר האפליקציה, יכול להיות שהתאמה של מגבלות ה-CPU תניב את התוצאות הטובות ביותר.
שימוש גבוה בזיכרון: אם השימוש בזיכרון של Envoy מתקרב למגבלה או חורג ממנה, יכול להיות שהוא יתחיל להפיל חיבורים או יחווה שגיאות של חוסר זיכרון (OOM). כדי למנוע את הבעיות האלה, צריך להגדיל את מגבלת הזיכרון.
יומני שגיאות: בודקים ביומנים של Envoy אם יש שגיאות שקשורות לניצול יתר של משאבים, כמו upstream connect error (שגיאה בחיבור במעלה הזרם) או disconnect or reset before headers (ניתוק או איפוס לפני הכותרות) או too many open files (יותר מדי קבצים פתוחים). יכול להיות שהשגיאות האלה מצביעות על כך שדרושים יותר משאבים לשרת הפרוקסי. במסמכים לפתרון בעיות שקשורות לשינוי גודל אפשר למצוא מידע על שגיאות אחרות שקשורות לשינוי גודל.
מדדי ביצועים: מעקב אחרי מדדי ביצועים מרכזיים כמו זמן האחזור של הבקשה, שיעורי השגיאות וקצב העברת הנתונים. אם אתם מבחינים בירידה בביצועים שקשורה לניצול גבוה של משאבים, יכול להיות שתצטרכו להגדיל את המגבלות.
הגדרה ומעקב פעילים של מגבלות על משאבים עבור שרתי proxy של מישור הנתונים מאפשרים לוודא שה-Service mesh ניתנת להרחבה ביעילות ב-GKE.
שינוי קנה המידה של מישור הבקרה
בקטע הזה מתוארות הגדרות שאפשר לשנות כדי להרחיב את מישור הבקרה.
בוררי Discovery
בוררי גילוי הם שדה ב-MeshConfig שמאפשר לכם לציין את קבוצת מרחבי השמות שמישורי הבקרה לוקחים בחשבון כשהם מחשבים עדכוני הגדרה עבור תהליכים משניים.
כברירת מחדל, Cloud Service Mesh עוקב אחרי כל מרחבי השמות באשכול. זה יכול להיות צוואר בקבוק באשכולות גדולים שלא צריכים לעקוב אחרי כל המשאבים.
אפשר להשתמש ב-discoverySelectors כדי להפחית את עומס החישוב במישור הבקרה על ידי הגבלת מספר משאבי Kubernetes (כמו שירותים, קבוצות Pod ונקודות קצה) שנצפים ומעובדים.
כשמשתמשים בהטמעה של TRAFFIC_DIRECTORמישור הבקרה Google Cloud , Cloud Service Mesh יוצר רק משאבים של Kubernetes במרחבי שמות שצוינו ב-discoverySelectors, כמו Backend Services ו-Network Endpoint Groups.
מידע נוסף זמין במאמר בנושא Discovery selectors במסמכי Istio.
מזעור ניצול המשאבים
משתמשים בסלקטורים של Discovery כדי להגביל את טביעת הרגל של ההגדרה. אפשר להשתמש בהגדרת יציאה של Sidecar כדי להגביל את השימוש בזיכרון של ה-proxy, אבל ה-API של Sidecar יוצר הגדרות מורכבות יותר. מומלץ להשתמש ב-Sidecar API רק כדי לפתור בעיות משמעותיות בביצועים של מישור הנתונים, כי הוא מגדיל את העומס במישור הבקרה ומקטין את יכולת ההתאמה הכוללת של הרשת.
פיתוח חוסן
כדי לשפר את החוסן (resilience) של Service mesh, אפשר לשנות את ההגדרות הבאות:
זיהוי חריגות
זיהוי חריגות מנטר את המארחים בשירות במעלה הזרם ומסיר אותם ממאגר איזון העומסים כשהם מגיעים לסף שגיאה מסוים.
- הגדרת המפתח:
-
outlierDetection: הגדרות שקובעות את ההוצאה של מארחים לא תקינים ממאגר איזון העומסים.
-
- יתרונות: שומר על קבוצה תקינה של מארחים במאגר איזון העומסים.
מידע נוסף זמין במאמר בנושא זיהוי חריגות במסמכי Istio.
ניסיונות חוזרים
צמצום שגיאות זמניות על ידי ניסיון חוזר אוטומטי של בקשות שנכשלו.
- הגדרת המפתח:
-
attempts: מספר הניסיונות החוזרים. -
perTryTimeout: הזמן הקצוב לכל ניסיון חוזר. הגדירו את משך הזמן הזה לקצר יותר ממשך הזמן הכולל להמתנה. הוא קובע כמה זמן תמתינו לכל ניסיון חוזר בנפרד. -
retryBudget: מספר הניסיונות החוזרים המקסימלי בו-זמנית.
-
- יתרונות: שיעורי הצלחה גבוהים יותר של בקשות, השפעה מופחתת של כשלים לסירוגין.
נקודות שכדאי להביא בחשבון:
- אידמפוטנטיות: מוודאים שהפעולה שמנסים לבצע שוב היא אידמפוטנטית, כלומר אפשר לחזור עליה בלי תופעות לוואי לא רצויות.
- Max Retries: הגבלת מספר הניסיונות החוזרים (למשל, 3 ניסיונות חוזרים לכל היותר) כדי למנוע לולאות אינסופיות.
- ניתוק מעגל: שילוב של ניסיונות חוזרים עם מפסקי זרם כדי למנוע ניסיונות חוזרים כששירות נכשל באופן עקבי.
מידע נוסף מופיע במאמר בנושא ניסיונות חוזרים במסמכי התיעוד של Istio.
חסימות זמניות
משתמשים בערכי הזמן הקצוב לתפוגה כדי להגדיר את הזמן המקסימלי שמוקצב לעיבוד הבקשה.
- הגדרת המפתח:
-
timeout: בקשה להגדרת זמן קצוב לתפוגה בשירות מסוים. -
idleTimeout: הזמן שחיבור יכול להישאר לא פעיל לפני שהוא נסגר.
-
- יתרונות: שיפור מהירות התגובה של המערכת, מניעת דליפות של משאבים, הגנה מפני תנועה זדונית.
נקודות שכדאי להביא בחשבון:
- השהיית רשת: צריך לקחת בחשבון את זמן הלוך ושוב (RTT) הצפוי בין השירותים. כדאי להשאיר זמן נוסף למקרה של עיכובים לא צפויים.
- גרף תלות בשירות: עבור בקשות בשרשרת, מוודאים שזמן קצוב לתפוגה של שירות שמבצע קריאה קצר יותר מזמן קצוב לתפוגה המצטבר של התלויות שלו, כדי למנוע כשלים מדורגים.
- סוגי פעולות: יכול להיות שיהיה צורך בערכי זמן קצובים לתפוגה ארוכים משמעותית למשימות ארוכות טווח מאשר לאחזור נתונים.
- טיפול בשגיאות: אם חלף הזמן הקצוב לתפוגה, צריך להפעיל לוגיקה מתאימה לטיפול בשגיאות (למשל, ניסיון חוזר, חזרה למצב קודם, ניתוק מעגל).
מידע נוסף זמין במאמר בנושא Timeouts במסמכי התיעוד של Istio.
מעקב וכוונון
מומלץ להתחיל עם הגדרות ברירת המחדל של פסק זמן, זיהוי חריגים וניסיונות חוזרים, ואז לשנות אותן בהדרגה בהתאם לדרישות הספציפיות של השירות ולדפוסי התנועה שנצפו. לדוגמה, תוכלו לעיין בנתונים מהעולם האמיתי כדי לראות כמה זמן בדרך כלל לוקח לשירותים שלכם להגיב. לאחר מכן, משנים את הגדרות הזמן הקצוב לתפוגה כך שיתאימו למאפיינים הספציפיים של כל שירות או נקודת קצה.
Telemetry
משתמשים בטלמטריה כדי לעקוב באופן רציף אחרי Service mesh ולשנות את ההגדרות שלה כדי לשפר את הביצועים והאמינות.
- מדדים: כדאי להשתמש במדדים מקיפים, ובמיוחד בנפחי בקשות, בזמן אחזור ובשיעורי שגיאות. שילוב עם Cloud Monitoring להצגה חזותית ולהתראות.
- מעקב מבוזר: הפעלת שילוב של מעקב מבוזר עם Cloud Trace כדי לקבל תובנות מעמיקות לגבי זרימות הבקשות בשירותים.
- רישום ביומן: מגדירים רישום ביומן של גישה כדי לתעד מידע מפורט על בקשות ותגובות.
מקורות מידע נוספים
- מידע נוסף על Cloud Service Mesh זמין במאמר סקירה כללית על Cloud Service Mesh.
- הנחיות כלליות בנושא Site Reliability Engineering (SRE) לצורך שיפור יכולת ההתאמה לגודל זמינות בפרקים טיפול בעומס יתר וטיפול בכשלים מדורגים בספר Google SRE.