


Bonnes pratiques de scaling pour Cloud Service Mesh sur GKE
Ce guide décrit les bonnes pratiques pour résoudre les problèmes de scaling des architectures gérées Cloud Service Mesh sur Google Kubernetes Engine. L'objectif principal de ces recommandations est de garantir des performances, une fiabilité et une utilisation des ressources optimales pour vos applications de microservices à mesure qu'elles se développent.
Pour comprendre les limites de scalabilité, consultez Limites de scalabilité de Cloud Service Mesh
La scalabilité de Cloud Service Mesh sur GKE dépend du fonctionnement efficace de ses deux composants principaux : le plan de données et le plan de contrôle. Ce document se concentre principalement sur le scaling du plan de données.
Identifier les problèmes de scaling du plan de contrôle par rapport à ceux du plan de données
Dans Cloud Service Mesh, les problèmes de scaling peuvent se produire dans le plan de contrôle ou dans le plan de données. Voici comment identifier le type de problème de scaling que vous rencontrez :
Symptômes des problèmes de scaling du plan de contrôle
Découverte détection de services : la découverte et la disponibilité des nouveaux services ou points de terminaison prennent beaucoup de temps.
Retards de configuration : la propagation des modifications apportées aux règles de gestion du trafic ou aux stratégies de sécurité prend beaucoup de temps.
Latence accrue dans les opérations du plan de contrôle : les opérations telles que la création, la mise à jour ou la suppression de ressources Cloud Service Mesh deviennent lentes ou ne répondent plus.
Erreurs liées à Traffic Director : vous pouvez observer des erreurs dans les journaux Cloud Service Mesh ou les métriques du plan de contrôle indiquant des problèmes de connectivité, d'épuisement des ressources ou de limitation de l'API.
Étendue de l'impact : les problèmes liés au plan de contrôle affectent généralement l'ensemble du maillage, ce qui entraîne une dégradation généralisée des performances.
Propagation de la configuration
Lorsque vous utilisez Cloud Service Mesh géré, il est important de comprendre les attentes concernant la latence de propagation de la configuration.
Étant donné que le plan de contrôle orchestre l'infrastructure mondiale, la propagation des modifications apportées aux ressources de configuration telles que VirtualService et DestinationRule prend plus de temps pour les side-cars. Les plates-formes de livraison continue ne doivent pas s'appuyer sur des délais statiques ni sur des portes temporelles strictes pour la propagation de la configuration. Assurez-vous plutôt que vos opérations de déploiement sont idempotentes et concentrez-vous sur la vérification active de la réussite du changement de trafic ou de la propagation de la configuration avant de passer aux étapes suivantes. Supprimez toute dépendance au "timing" autre qu'un temps de stabilisation dédié appliqué après avoir confirmé que la configuration correcte est en place.
Symptômes des problèmes de scaling du plan de données
Latence accrue dans la communication de service à service : les requêtes adressées à un service dans le maillage présentent une latence ou des délais avant expiration plus élevés, mais l'utilisation du processeur/de la mémoire n'est pas élevée dans les conteneurs du service.
Utilisation élevée du processeur ou de la mémoire dans les proxys Envoy : une utilisation élevée du processeur ou de la mémoire peut indiquer que les proxys ont du mal à gérer la charge de trafic.
Impact localisé : les problèmes liés au plan de données affectent généralement des services ou des charges de travail spécifiques, en fonction des modèles de trafic et de l'utilisation des ressources des proxys Envoy.
Scaling du plan de données
Pour mettre à l'échelle le plan de données, essayez les techniques suivantes :
- Configurer l'autoscaling horizontal des pods (AHP)
- Optimiser la configuration du proxy Envoy
- Optimiser la répartition du trafic
- Surveiller et ajuster
Configurer l'autoscaling horizontal des pods (AHP) pour les charges de travail
Utilisez l'autoscaling horizontal des pods (AHP) pour mettre à l'échelle dynamiquement les charges de travail avec des pods supplémentaires en fonction de l'utilisation des ressources. Tenez compte des points suivants lors de la configuration de l'AHP :
Utilisez le paramètre
--horizontal-pod-autoscaler-sync-periodpourkube-controller-managerafin d'ajuster le taux d'interrogation du contrôleur AHP. Le taux d'interrogation par défaut est de 15 secondes. Vous pouvez envisager de le définir sur une valeur inférieure si vous prévoyez des pics de trafic plus rapides. Pour en savoir plus sur le moment où utiliser l'AHP avec GKE, consultez Autoscaling horizontal des pods.Le comportement de scaling par défaut peut entraîner le déploiement (ou l'arrêt) d'un grand nombre de pods à la fois, ce qui peut entraîner un pic d'utilisation des ressources. Envisagez d'utiliser des stratégies de scaling pour limiter le taux de déploiement des pods.
Utilisez EXIT_ON_ZERO_ACTIVE_CONNECTIONS pour éviter d'abandonner les connexions lors du scaling à la baisse.
Pour en savoir plus sur l'AHP, consultez Autoscaling horizontal des pods dans la documentation Kubernetes.
Optimiser la configuration du proxy Envoy
Pour optimiser la configuration du proxy Envoy, tenez compte des recommandations suivantes :
Limites de ressources
Vous pouvez définir des requêtes et des limites de ressources pour les side-cars Envoy dans les spécifications de vos pods. Cela évite les conflits de ressources et garantit des performances cohérentes.
Vous pouvez remplacer les limites de ressources pour des charges de travail spécifiques à l'aide de annotations de ressources dans les spécifications de vos pods.
Les limites de ressources optimales pour vos proxys Envoy dépendent de facteurs tels que le volume de trafic, la complexité de la charge de travail et les ressources des nœuds GKE. Surveillez et ajustez en permanence votre maillage de services pour garantir des performances optimales.
Considération importante :
- Qualité de service (QoS) : la définition des requêtes et des limites garantit que vos proxys Envoy disposent d'une qualité de service prévisible.
Dépendances de services de portée
Envisagez de réduire le graphique de dépendances de votre maillage en déclarant toutes vos dépendances via l'API Sidecar. Cela limite la taille et la complexité de la configuration envoyée à une charge de travail donnée, ce qui est essentiel pour les maillages plus volumineux.
Par exemple, voici le graphique de trafic de l'exemple d'application de boutique en ligne.
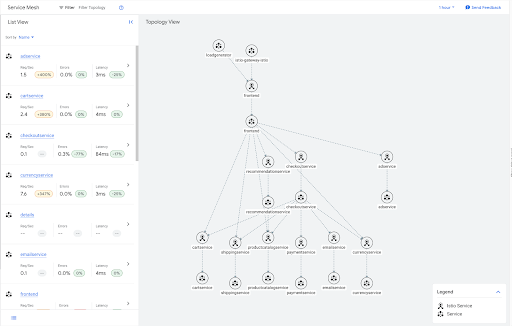
Beaucoup de ces services sont des feuilles dans le graphique et n'ont donc pas besoin d'informations de sortie pour les autres services du maillage. Vous pouvez appliquer une ressource Sidecar limitant la portée de la configuration du side-car pour ces services feuilles, comme illustré dans l'exemple suivant.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: leafservices
  namespace: default
spec:
  workloadSelector:
    labels:
      app: cartservice
      app: shippingservice
      app: productcatalogservice
      app: paymentservice
      app: emailservice
      app: currencyservice
  egress:
  -   hosts:
    -   "~/*"
Pour savoir comment déployer cet exemple d'application, consultez Exemple d'application de boutique en ligne.
Un autre avantage de la portée du side-car est la réduction des requêtes DNS inutiles. La portée des dépendances de service garantit qu'un side-car Envoy n'effectue des requêtes DNS que pour les services avec lesquels il communiquera réellement, au lieu de chaque cluster du maillage de services.
Pour tous les déploiements à grande échelle qui rencontrent des problèmes liés à la taille des configurations dans leurs side-cars, il est vivement recommandé de définir la portée des dépendances de service pour la scalabilité du maillage.
Pour limiter la portée de la configuration de toutes les charges de travail d'un même espace de noms, créez une ressource Sidecar dans cet espace de noms. Cela indique à tous les proxys Envoy de cet espace de noms de ne recevoir la configuration que pour les services de leur propre espace de noms.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: sidecar
  namespace: my-app
spec:
  egress:
  -   hosts:
    -   "my-app/*"
Vous pouvez appliquer un comportement par défaut à chaque espace de noms de votre maillage en appliquant une seule ressource Sidecar à l'espace de noms racine, généralement istio-system.
Le side-car suivant limite le trafic de sortie de chaque side-car du maillage aux services situés dans son propre espace de noms.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: sidear
  namespace: istio-system
spec:
  egress:
  -   hosts:
    -   "./*"
Notez que Cloud Service Mesh impose une limite au nombre total de ressources Sidecar pouvant être créées dans un même maillage. En raison de cette contrainte, la création d'un side-car au niveau de l'espace de noms est la pratique recommandée.
Optimiser la répartition du trafic
Si vous vous appuyez sur des changements de trafic fréquents, tels que des déploiements progressifs ou des déploiements bleu-vert, la méthode que vous utilisez pour répartir le trafic aura un impact sur la latence de configuration.
- Évitez les sous-ensembles pour les changements rapides : la répartition du trafic à l'aide de champs
subsetdans votreVirtualServiceen combinaison avec uneDestinationRuleentraîne la création, le détachement et la réassociation rapides des groupes de points de terminaison du réseau (NEG) sous-jacents par le plan de contrôle. Cette réconciliation ajoute des délais importants de plusieurs minutes, ce qui peut entraîner l'omission de pondérations de trafic intermédiaires lors de déploiements automatisés rapides. - Privilégiez le routage basé sur l'hôte : au lieu d'utiliser des sous-ensembles, configurez vos déploiements pour qu'ils utilisent la répartition du trafic basée sur l'hôte. En acheminant le trafic entre des services Kubernetes de backend complètement distincts en fonction des configurations d'hôte
VirtualService, le plan de contrôle évite de modifier les configurations NEG. Cela réduit la charge de l'infrastructure et accélère considérablement la propagation de la configuration.
Surveiller et ajuster
Après avoir défini les limites de ressources initiales, il est essentiel de surveiller vos proxys Envoy pour vous assurer qu'ils fonctionnent de manière optimale. Utilisez les tableaux de bord GKE pour surveiller l'utilisation du processeur et de la mémoire, et ajuster les limites de ressources si nécessaire.
Pour déterminer si un proxy Envoy nécessite des limites de ressources plus élevées, surveillez sa consommation de ressources dans des conditions de trafic normales et de pointe. Voici ce qu'il faut rechercher :
Utilisation élevée du processeur : si l'utilisation du processeur par Envoy approche ou dépasse constamment sa limite, il peut avoir du mal à traiter les requêtes, ce qui entraîne une latence accrue ou des requêtes abandonnées. Envisagez d'augmenter la limite du processeur.
Dans ce cas, vous pouvez être tenté d'effectuer un scaling horizontal, mais si le proxy side-car n'est pas en mesure de traiter les requêtes aussi rapidement que le conteneur d'application, l'ajustement des limites du processeur peut produire les meilleurs résultats.
Utilisation élevée de la mémoire : si l'utilisation de la mémoire par Envoy approche ou dépasse sa limite, il peut commencer à abandonner des connexions ou à rencontrer des erreurs de mémoire insuffisante. Augmentez la limite de mémoire pour éviter ces problèmes.
Journaux d'erreurs : examinez les journaux d'Envoy pour détecter les erreurs liées à l'épuisement des ressources, telles que les erreurs upstream connect error (erreur de connexion en amont), disconnect or reset before headers (déconnexion ou réinitialisation avant les en-têtes) ou too many open files (trop de fichiers ouverts). Ces erreurs peuvent indiquer que le proxy a besoin de plus de ressources. Pour d'autres erreurs liées aux problèmes de scaling, consultez les documents de dépannage du scaling .
Métriques de performances : surveillez les métriques de performances clés telles que la latence des requêtes, les taux d'erreur et le débit. Si vous constatez une dégradation des performances corrélée à une utilisation élevée des ressources, il peut être nécessaire d'augmenter les limites.
En définissant et en surveillant activement les limites de ressources pour vos proxys de plan de données, vous pouvez vous assurer que votre maillage de services évolue efficacement sur GKE.
Scaling du plan de contrôle
Cette section décrit les paramètres à ajuster pour mettre à l'échelle votre plan de contrôle.
Sélecteurs de découverte
Les sélecteurs de découverte sont un champ de MeshConfig qui vous permet de spécifier l'ensemble des espaces de noms que les plans de contrôle prennent en compte lors du calcul des mises à jour de configuration pour les side-cars.
Par défaut, Cloud Service Mesh surveille tous les espaces de noms du cluster. Cela peut constituer un goulot d'étranglement pour les grands clusters qui n'ont pas besoin de surveiller toutes les ressources.
Utilisez discoverySelectors pour réduire la charge de calcul sur le plan de contrôle en limitant le nombre de ressources Kubernetes (telles que les services, les pods et les points de terminaison) qui sont surveillées et traitées.
Lorsque vous utilisez l'implémentation du plan de contrôle TRAFFIC_DIRECTOR,
Cloud Service Mesh ne crée Google Cloud des ressources, telles que des services de backend et des groupes de points de terminaison du réseau, que pour les ressources Kubernetes des espaces de noms
spécifiés dans discoverySelectors.
Pour en savoir plus, consultez Sélecteurs de découverte dans la documentation Istio.
Réduire l'empreinte de la configuration
Utilisez les sélecteurs de découverte pour limiter l'empreinte de la configuration. Vous pouvez utiliser la configuration de sortie Sidecar pour limiter l'utilisation de la mémoire du proxy, mais l'API Sidecar crée des configurations plus complexes. N'utilisez l'API Sidecar que pour résoudre des problèmes de performances importants du plan de données, car elle augmente la charge du plan de contrôle et réduit la scalabilité globale du maillage.
Intégrer la résilience
Vous pouvez ajuster les paramètres suivants pour intégrer la résilience à votre maillage de services :
Détection des anomalies
La détection des anomalies surveille les hôtes d'un service en amont et les supprime du pool d'équilibrage de charge lorsqu'un seuil d'erreur est atteint.
- Configuration clé
outlierDetection: paramètres contrôlant l'éviction des hôtes défaillants du pool d'équilibrage de charge.
- Avantages : maintient un ensemble d'hôtes sains dans le pool d'équilibrage de charge.
Pour en savoir plus, consultez Détection des anomalies dans la documentation Istio.
Tentatives
Atténuez les erreurs temporaires en réessayant automatiquement les requêtes ayant échoué.
- Configuration clé
attempts: nombre de tentatives.perTryTimeout: délai avant expiration par tentative. Définissez une valeur inférieure à votre délai avant expiration global. Il détermine la durée pendant laquelle vous attendez chaque tentative.retryBudget: nombre maximal de tentatives simultanées.
- Avantages : taux de réussite plus élevés pour les requêtes, impact réduit des échecs intermittents.
Facteurs à prendre en compte :
- Idempotence : assurez-vous que l'opération réessayée est idempotente, ce qui signifie qu'elle peut être répétée sans effets secondaires involontaires.
- Nombre maximal de tentatives : limitez le nombre de tentatives (par exemple, 3 tentatives au maximum) pour éviter les boucles infinies.
- Rupture de circuit : intégrez des tentatives avec des disjoncteurs pour éviter les tentatives lorsqu'un service échoue systématiquement.
Pour en savoir plus, consultez Tentatives dans la documentation Istio.
Délais avant expiration
Utilisez des délais avant expiration pour définir la durée maximale autorisée pour le traitement des requêtes.
- Configuration clé
timeout: délai avant expiration de la requête pour un service spécifique.idleTimeout: durée pendant laquelle une connexion peut rester inactive avant d'être fermée.
- Avantages : amélioration de la réactivité du système, prévention des fuites de ressources, renforcement contre le trafic malveillant.
Facteurs à prendre en compte :
- Latence du réseau : tenez compte du délai aller-retour (DAR) attendu entre les services. Laissez une marge pour les retards inattendus.
- Graphique de dépendances de service : pour les requêtes enchaînées, assurez-vous que le délai avant expiration d'un service appelant est inférieur au délai avant expiration cumulé de ses dépendances afin d'éviter les défaillances en cascade.
- Types d'opérations : les tâches de longue durée peuvent nécessiter des délais avant expiration beaucoup plus longs que les récupérations de données.
- Gestion des erreurs : les délais avant expiration doivent déclencher une logique de gestion des exceptions appropriée (par exemple, nouvelle tentative, secours, rupture de circuit).
Pour en savoir plus, consultez Délais avant expiration dans la documentation Istio.
Surveiller et ajuster
Envisagez de commencer par les paramètres par défaut pour les délais avant expiration, la détection des anomalies et les tentatives, puis ajustez-les progressivement en fonction des exigences spécifiques de votre service et des modèles de trafic observés. Par exemple, examinez les données réelles sur le temps de réponse habituel de vos services. Ajustez ensuite les délais avant expiration en fonction des caractéristiques spécifiques de chaque service ou point de terminaison.
Télémétrie
Utilisez la télémétrie pour surveiller en permanence votre maillage de services et ajuster sa configuration afin d'optimiser les performances et la fiabilité.
- Métriques : utilisez des métriques complètes, en particulier les volumes de requêtes, la latence et les taux d'erreur. Intégrez-les à Cloud Monitoring pour la visualisation et les alertes.
- Traçage distribué : activez l'intégration du traçage distribué à Cloud Trace pour obtenir des insights approfondis sur les flux de requêtes dans vos services.
- Journalisation : configurez la journalisation des accès pour capturer des informations détaillées sur les requêtes et les réponses.
Autres ressources à lire
- Pour en savoir plus sur Cloud Service Mesh, consultez la présentation de Cloud Service Mesh.
- Pour obtenir des conseils généraux sur l'ingénierie en fiabilité des sites (SRE) concernant la scalabilité, consultez les chapitres Gérer la surcharge et Gérer les défaillances en cascade du livre sur l'ingénierie SRE de Google.