


Prácticas recomendadas de escalamiento para Cloud Service Mesh en GKE
En esta guía, se describen las prácticas recomendadas para resolver problemas de escalamiento de arquitecturas de Cloud Service Mesh administrado en Google Kubernetes Engine. El objetivo principal de estas recomendaciones es garantizar un rendimiento, una confiabilidad y un uso de recursos óptimos para tus aplicaciones de microservicios a medida que crecen.
Para comprender las limitaciones de escalabilidad, consulta Límites de escalabilidad de Cloud Service Mesh
La escalabilidad de Cloud Service Mesh en GKE depende del funcionamiento eficiente de sus dos componentes principales: el plano de datos y el plano de control. Este documento se centra principalmente en el escalamiento del plano de datos.
Identifica problemas de escalamiento del plano de control y del plano de datos
En Cloud Service Mesh, los problemas de escalamiento pueden ocurrir en el plano de control o en el plano de datos. A continuación, te mostramos cómo puedes identificar qué tipo de problema de escalamiento tienes:
Síntomas de problemas de escalamiento del plano de control
Descubrimiento de servicios lento: Los servicios o extremos nuevos tardan mucho en descubrirse y estar disponibles.
Demoras en la configuración: Los cambios en las reglas de administración del tráfico o las políticas de seguridad tardan mucho en propagarse.
Aumento de la latencia en las operaciones del plano de control: Las operaciones como crear, actualizar o borrar recursos de Cloud Service Mesh se vuelven lentas o no responden.
Errores relacionados con Traffic Director: Es posible que observes errores en los registros de Cloud Service Mesh o en las métricas del plano de control que indiquen problemas con la conectividad, el agotamiento de recursos o la limitación de la API.
Alcance del impacto: Los problemas del plano de control suelen afectar a toda la malla, lo que provoca una degradación generalizada del rendimiento.
Propagación de la configuración
Cuando usas Cloud Service Mesh administrado, es importante comprender las expectativas con respecto a la latencia de propagación de la configuración.
Debido a que el plano de control organiza la infraestructura global, las modificaciones en los recursos de configuración como VirtualService y DestinationRule tardan más en propagarse a los sidecars. Las plataformas de entrega continua no deben depender de demoras de tiempo estáticas ni de puertas de tiempo estrictas para la propagación de la configuración. En su lugar, asegúrate de que tus operaciones de lanzamiento sean idempotentes y enfócate en verificar de forma activa que se haya completado el cambio de tráfico o la propagación de la configuración antes de continuar con los siguientes pasos. Quita cualquier dependencia del "tiempo" que no sea un tiempo de prueba dedicado que se aplique después de confirmar que la configuración correcta esté en su lugar.
Síntomas de problemas de escalamiento del plano de datos
Aumento de la latencia en la comunicación de servicio a servicio: Las solicitudes a un servicio en la malla experimentan una latencia o tiempos de espera más altos, pero no hay un uso elevado de CPU o memoria en los contenedores del servicio.
Uso elevado de CPU o memoria en los proxies de Envoy: El uso elevado de CPU o memoria puede indicar que los proxies tienen dificultades para controlar la carga de tráfico.
Impacto localizado: Los problemas del plano de datos suelen afectar a servicios o cargas de trabajo específicos, según los patrones de tráfico y el uso de recursos de los proxies de Envoy.
Escala el plano de datos
Para escalar el plano de datos, prueba las siguientes técnicas:
- Configura el ajuste de escala automático horizontal de pods (HPA)
- Optimiza la configuración del proxy de Envoy
- Optimiza la división del tráfico
- Supervisa y ajusta
Configura el ajuste de escala automático horizontal de pods (HPA) para las cargas de trabajo
Usa el ajuste de escala automático horizontal de pods (HPA) para escalar de forma dinámica las cargas de trabajo con pods adicionales según el uso de recursos. Ten en cuenta lo siguiente cuando configures HPA:
Usa el parámetro
--horizontal-pod-autoscaler-sync-periodparakube-controller-managerpara ajustar la frecuencia de sondeo del controlador de HPA. La frecuencia de sondeo predeterminada es de 15 segundos, y puedes considerar establecerla en un valor más bajo si esperas aumentos de actividad de tráfico más rápidos. Para obtener más información sobre cuándo usar HPA con GKE, consulta Ajuste de escala automático horizontal de pods.El comportamiento de escalamiento predeterminado puede generar una gran cantidad de pods implementados (o finalizados) a la vez, lo que puede provocar un aumento repentino en el uso de recursos. Considera usar políticas de escalamiento para limitar la velocidad a la que se pueden implementar los pods.
Usa EXIT_ON_ZERO_ACTIVE_CONNECTIONS para evitar descartar conexiones durante la reducción de escala.
Para obtener más detalles sobre HPA, consulta Ajuste de escala automático horizontal de pods en la documentación de Kubernetes.
Optimiza la configuración del proxy de Envoy
Para optimizar la configuración del proxy de Envoy, ten en cuenta las siguientes recomendaciones:
Límites de recursos
Puedes definir solicitudes y límites de recursos para los sidecars de Envoy en las especificaciones de tus pods. Esto evita la contención de recursos y garantiza un rendimiento coherente.
Puedes anular los límites de recursos para cargas de trabajo específicas con anotaciones de recursos en las especificaciones de tus pods.
Los límites de recursos óptimos para tus proxies de Envoy dependen de factores como el volumen de tráfico, la complejidad de la carga de trabajo y los recursos del nodo de GKE. Supervisa y ajusta continuamente tu malla de servicios para garantizar un rendimiento óptimo.
Consideración importante:
- Calidad de servicio (QoS): Si configuras las solicitudes y los límites, te aseguras de que tus proxies de Envoy tengan una calidad de servicio predecible.
Define el alcance de las dependencias de servicios
Considera recortar el gráfico de dependencias de tu malla declarando todas tus dependencias a través de la API de Sidecar. Esto limita el tamaño y la complejidad de la configuración que se envía a una carga de trabajo determinada, lo que es fundamental para las mallas más grandes.
Por ejemplo, el siguiente es el gráfico de tráfico de la aplicación de muestra Online Boutique.
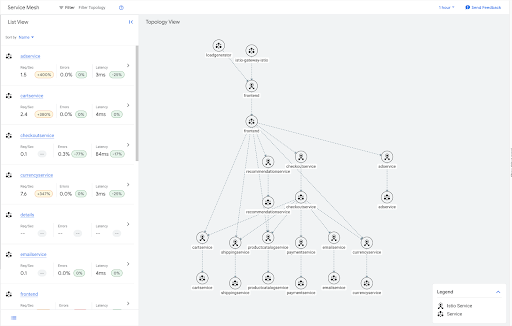
Muchos de estos servicios son hojas en el gráfico y, como tales, no necesitan tener información de salida para ninguno de los otros servicios de la malla. Puedes aplicar un recurso de sidecar que limite el alcance de la configuración del sidecar para estos servicios de hoja, como se muestra en el siguiente ejemplo.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: leafservices
  namespace: default
spec:
  workloadSelector:
    labels:
      app: cartservice
      app: shippingservice
      app: productcatalogservice
      app: paymentservice
      app: emailservice
      app: currencyservice
  egress:
  -   hosts:
    -   "~/*"
Consulta Aplicación de muestra Online Boutique para obtener detalles sobre cómo implementar esta aplicación de muestra.
Otro beneficio del alcance del sidecar es la reducción de las consultas de DNS innecesarias. El alcance de las dependencias de servicios garantiza que un sidecar de Envoy solo realice consultas de DNS para los servicios con los que se comunicará en lugar de cada clúster en la malla de servicios.
Para cualquier implementación a gran escala que tenga problemas con tamaños de configuración grandes en sus sidecars, se recomienda enfáticamente definir el alcance de las dependencias de servicios para la escalabilidad de la malla.
Para limitar el alcance de la configuración de todas las cargas de trabajo dentro de un solo espacio de nombres, crea un recurso de sidecar en ese espacio de nombres. Esto indica a todos los proxies de Envoy dentro de ese espacio de nombres que solo reciban la configuración de los servicios en su propio espacio de nombres.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: sidecar
  namespace: my-app
spec:
  egress:
  -   hosts:
    -   "my-app/*"
Puedes aplicar el comportamiento predeterminado para cada espacio de nombres de tu malla si aplicas un solo recurso de sidecar al espacio de nombres raíz, por lo general, istio-system.
El siguiente sidecar restringe el tráfico de salida de cada sidecar en la malla a los servicios ubicados dentro de su propio espacio de nombres.
apiVersion: networking.istio.io/v1beta1
kind: Sidecar
metadata:
  name: sidear
  namespace: istio-system
spec:
  egress:
  -   hosts:
    -   "./*"
Ten en cuenta que Cloud Service Mesh impone un límite en la cantidad total de recursos de sidecar que se pueden crear dentro de una sola malla. Debido a esta restricción, la práctica recomendada es crear sidecar a nivel del espacio de nombres.
Optimiza la división del tráfico
Si dependes de cambios de tráfico frecuentes, como lanzamientos progresivos o implementaciones azul-verde, el método que uses para dividir el tráfico afectará la latencia de configuración.
- Evita los subconjuntos para cambios rápidos: La división del tráfico con los campos
subseten tuVirtualServiceen combinación con unaDestinationRulehace que el plano de control cree, separe y vuelva a conectar rápidamente los grupos de extremos de red (NEG) subyacentes. Esta conciliación agrega demoras significativas de varios minutos, lo que puede provocar que se omitan los pesos de tráfico intermedios durante los lanzamientos automáticos rápidos. - Prefiere el enrutamiento basado en el host: En lugar de usar subconjuntos, configura tus implementaciones para que usen la división de tráfico basada en host. Al enrutar el tráfico entre servicios de Kubernetes de respaldo completamente distintos según las configuraciones de host de
VirtualService, el plano de control evita la rotación de las configuraciones de NEG. Esto reduce la sobrecarga de la infraestructura y genera una propagación de configuración mucho más rápida.
Supervisa y ajusta
Después de establecer los límites de recursos iniciales, es fundamental supervisar tus proxies de Envoy para asegurarte de que funcionen de manera óptima. Usa los paneles de GKE para supervisar el uso de CPU y memoria, y ajustar los límites de recursos según sea necesario.
Para determinar si un proxy de Envoy requiere límites de recursos aumentados, supervisa su consumo de recursos en condiciones de tráfico típicas y máximas. Esto es lo que debes buscar:
Uso elevado de CPU: Si el uso de CPU de Envoy se acerca o supera constantemente su límite, es posible que tenga dificultades para procesar las solicitudes, lo que genera un aumento de la latencia o solicitudes descartadas. Considera aumentar el límite de CPU.
En este caso, es posible que te inclines a escalar con el escalamiento horizontal, pero si el proxy de sidecar no puede procesar las solicitudes con la misma rapidez que el contenedor de la aplicación, ajustar los límites de CPU puede producir los mejores resultados.
Uso elevado de memoria: Si el uso de memoria de Envoy se acerca o supera su límite, es posible que comience a descartar conexiones o experimente errores de memoria insuficiente (OOM). Aumenta el límite de memoria para evitar estos problemas.
Registros de errores: Examina los registros de Envoy en busca de errores relacionados con el agotamiento de recursos, como errores de conexión ascendente o desconexión o restablecimiento antes de los encabezados o demasiados archivos abiertos. Estos errores pueden indicar que el proxy necesita más recursos. Consulta los documentos de solución de problemas de escalamiento para ver otros errores relacionados con problemas de escalamiento.
Métricas de rendimiento: Supervisa las métricas de rendimiento clave, como la latencia de las solicitudes, las tasas de error y la capacidad de procesamiento. Si observas una degradación del rendimiento relacionada con un uso elevado de recursos, es posible que sea necesario aumentar los límites.
Si estableces y supervisas de forma activa los límites de recursos para tus proxies de plano de datos, puedes asegurarte de que tu malla de servicios se escale de manera eficiente en GKE.
Escala el plano de control
En esta sección, se describen los parámetros de configuración que se deben ajustar para escalar el plano de control.
Selectores de descubrimiento
Los selectores de descubrimiento son un campo en MeshConfig que te permite especificar el conjunto de espacios de nombres que consideran los planos de control cuando calculan las actualizaciones de configuración para los sidecars.
De forma predeterminada, Cloud Service Mesh observa todos los espacios de nombres del clúster. Esto puede ser un cuello de botella para los clústeres grandes que no necesitan observar todos los recursos.
Usa discoverySelectors para reducir la carga computacional en el plano de control. Para ello, limita la cantidad de recursos de Kubernetes (como servicios, pods y extremos) que se observan y procesan.
Cuando se usa la implementación del plano de control TRAFFIC_DIRECTOR,
Cloud Service Mesh solo crea Google Cloud recursos, como servicios de backend
y grupos de extremos de red, para los recursos de Kubernetes en los espacios de nombres
especificados en discoverySelectors.
Para obtener más información, consulta Selectores de descubrimiento en la documentación de Istio.
Minimiza el impacto de la configuración
Usa los selectores de descubrimiento para limitar el impacto de la configuración. Puedes usar la configuración de salida de sidecar para limitar el uso de memoria del proxy, pero la API de Sidecar crea configuraciones más complejas. Solo usa la API de Sidecar para resolver problemas importantes de rendimiento del plano de datos, ya que aumenta la carga del plano de control y reduce la escalabilidad general de la malla.
Desarrolla la capacidad de recuperación
Puedes ajustar los siguientes parámetros de configuración para desarrollar la resiliencia en tu malla de servicios:
Detección de valores atípicos
La detección de valores atípicos supervisa los hosts en un servicio ascendente y los quita del grupo de balanceo de cargas cuando alcanzan un umbral de error.
- Configuración clave:
outlierDetection: Configuración que controla la expulsión de hosts en mal estado del grupo de balanceo de cargas.
- Beneficios: Mantiene un conjunto de hosts en buen estado en el grupo de balanceo de cargas.
Para obtener más información, consulta Detección de valores atípicos en la documentación de Istio.
Reintentos
Mitiga los errores transitorios reintentando automáticamente las solicitudes fallidas.
- Configuración clave:
attempts: Cantidad de reintentos.perTryTimeout: Tiempo de espera por reintento. Establécelo en un valor más corto que el tiempo de espera general. Determina cuánto tiempo esperarás para cada reintento individual.retryBudget: Reintentos simultáneos máximos.
- Beneficios: Tasas de éxito más altas para las solicitudes, impacto reducido de las fallas intermitentes.
Factores que se deben tener en cuenta:
- Idempotencia: Asegúrate de que la operación que se reintenta sea idempotente, lo que significa que se puede repetir sin efectos secundarios no deseados.
- Reintentos máximos: Limita la cantidad de reintentos (p.ej., un máximo de 3 reintentos) para evitar bucles infinitos.
- Interrupción de circuitos: Integra los reintentos con los interruptores de circuitos para evitar los reintentos cuando un servicio falla de manera constante.
Para obtener más información, consulta Reintentos en la documentación de Istio.
Tiempos de espera
Usa los tiempos de espera para definir el tiempo máximo permitido para el procesamiento de solicitudes.
- Configuración clave:
timeout: Tiempo de espera de la solicitud para un servicio específico.idleTimeout: Tiempo que una conexión puede permanecer inactiva antes del cierre.
- Beneficios: Mejora la capacidad de respuesta del sistema, evita las pérdidas de recursos y refuerza la protección contra el tráfico malicioso.
Factores que se deben tener en cuenta:
- Latencia de red: Ten en cuenta el tiempo de ida y vuelta (RTT) esperado entre los servicios. Deja un búfer para las demoras inesperadas.
- Gráfico de dependencias de servicios: Para las solicitudes encadenadas, asegúrate de que el tiempo de espera de un servicio de llamada sea más corto que el tiempo de espera acumulativo de sus dependencias para evitar errores en cascada.
- Tipos de operaciones: Es posible que las tareas de larga duración necesiten tiempos de espera significativamente más largos que las recuperaciones de datos.
- Manejo de errores: Los tiempos de espera deben activar la lógica de manejo de errores adecuada (p.ej., reintento, resguardo, interrupción de circuitos).
Para obtener más información, consulta Tiempos de espera en la documentación de Istio.
Supervisa y ajusta
Considera comenzar con la configuración predeterminada para los tiempos de espera, la detección de valores atípicos y los reintentos, y luego ajustarlos de forma gradual según los requisitos específicos del servicio y los patrones de tráfico observados. Por ejemplo, observa los datos del mundo real sobre cuánto tiempo suelen tardar en responder tus servicios. Luego, ajusta los tiempos de espera para que coincidan con las características específicas de cada servicio o extremo.
Telemetría
Usa la telemetría para supervisar continuamente tu malla de servicios y ajustar su configuración para optimizar el rendimiento y la confiabilidad.
- Métricas: Usa métricas integrales, específicamente, volúmenes de solicitudes, latencia y tasas de error. Intégralo con Cloud Monitoring para la visualización y las alertas.
- Seguimiento distribuido: Habilita la integración del seguimiento distribuido con Cloud Trace para obtener estadísticas detalladas sobre los flujos de solicitudes en tus servicios.
- Registro: Configura el registro de acceso para capturar información detallada sobre las solicitudes y las respuestas.
Lecturas adicionales
- Para obtener más información sobre Cloud Service Mesh, consulta la descripción general de Cloud Service Mesh.
- Para obtener orientación general sobre la ingeniería de confiabilidad de sitios (SRE) en cuanto a la escalabilidad, consulta los capítulos Controla la sobrecarga y Aborda fallas en cascada en el libro SRE de Google.