


架構
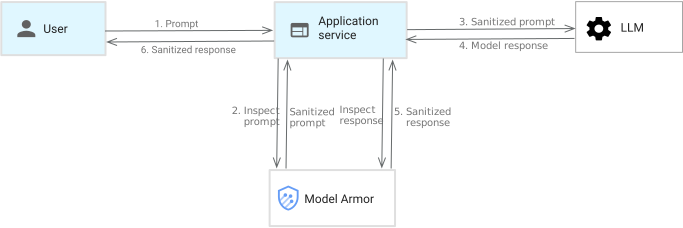
這張圖表顯示使用 Model Armor 保護 LLM 和使用者的應用程式。以下步驟說明資料流程:
- 向應用程式提供提示。
- Model Armor 會檢查傳入的提示,確認是否含有潛在的敏感內容。
- 提示詞 (或經過清理的提示詞) 會傳送至 LLM。
- LLM 生成回覆。
- Model Armor 會檢查生成的回覆,確認是否含有潛在的敏感內容。
- 系統會將回覆 (或清理過的回覆) 傳送給您。 Model Armor 會在回覆中詳細說明觸發和未觸發的篩選器。
Model Armor 會過濾輸入內容 (提示) 和輸出內容 (回覆),防止 LLM 接觸或生成惡意或敏感內容。
網路需求
如要從虛擬私有雲網路存取 Model Armor 區域端點,必須建立 Private Service Connect 端點,才能存取 Model Armor API。使用 Private Google Access 或 VPC Service Controls 存取區域端點時,必須執行這項操作,才能避免發生憑證錯誤。詳情請參閱「排解 Model Armor 問題」和「透過 Private Service Connect 端點存取區域端點」。
Model Armor 的使用時機
以下是一些常見用途:
- 遮蓋私密資料並降低外洩風險:使用 Sensitive Data Protection 掃描提示和模型回覆,並遮蓋私密智慧財產 (IP) 或個人識別資訊 (PII)。
- 防範提示詞注入和越獄攻擊:阻擋惡意輸入內容,防止這類內容規避系統防護機制,或操縱大型語言模型 (LLM) 執行非預期的動作。
- 過濾有害或有害內容:根據可設定的信賴度門檻,篩選使用者輸入內容和模型輸出內容,避免出現仇恨言論、騷擾、情色內容、危險內容和兒少性虐待內容 (CSAM)。
- 檢查非結構化文件文字:從 PDF 等文件格式中擷取並掃描文字,攔截內嵌的惡意酬載或敏感資料。
- 螢幕圖片輸入內容和回覆:檢查圖片中的視覺內容和文字,偵測內嵌的威脅、機密資訊類型 (infoTypes) 或違規行為。
- 確保品牌形象一致並遵守業務政策:過濾 AI 應用程式生成的社群媒體貼文,避免出現危險或仇恨內容等有害訊息。
Model Armor 範本
您可以使用 Model Armor 範本,設定 Model Armor 篩選提示詞和回覆的方式。這類範本是一組自訂的篩選條件和門檻,可針對不同的安全信心水準進行設定,方便您控管要標記的內容。
門檻代表信賴水準,也就是 Model Armor 對提示詞或回覆中包含違規內容的信心程度。舉例來說,您可以建立範本,並設定 HIGH 門檻,篩除含有仇恨內容的提示詞。也就是說,Model Armor 會回報提示詞含有仇恨內容的信心水準。LOW_AND_ABOVE 門檻表示對該聲明有任何程度的信心 (LOW、MEDIUM 和 HIGH)。
詳情請參閱 Model Armor 範本。
Model Armor 信賴水準
您可以為負責任的 AI 技術安全類別 (露骨內容、危險、騷擾和仇恨言論)、提示詞注入和越獄偵測,以及 Sensitive Data Protection (包括主題性) 設定信心水準。
對於支援精細門檻的可信度,Model Armor 的解讀方式如下:
- 高:識別極有可能違規的內容。
- 中等以上:識別違規機率中等或較高的內容。
- 低與以上:識別違規機率低、中或高的內容。
篩選器敏感度會影響偵測率。門檻越低,可識別的事件就越多,但偽陽性事件的頻率可能會增加。
| 信賴水準 | 偵測機率 | 偽陽性風險 | 建議用途 |
|---|---|---|---|
| 高 | 只有在幾乎確定內容違規時才會標記。 | 極低 | 以不間斷的使用者互動為優先的正式環境。 |
| 中與以上 | 標記信賴度適中的內容。 | 中 | 標準企業應用程式。在強效防護和可接受的誤判率之間取得平衡。適合一般內容安全。 |
| 低與以上 | 只要內容稍有違規跡象,就會遭到檢舉。 | 高 | 請謹慎使用。可能適合提示詞注入和越獄偵測等高風險類別,因為這類別的重點在於避免誤判為負面內容,即使可能誤判為正面內容也沒關係。由於有封鎖無害內容的高風險,因此不建議用於一般負責任的 AI 內容類別。 |
注意事項與最佳做法
- 分離範本:為使用者提示詞和模型回覆設定不同的 Model Armor 範本。使用者輸入內容和模型輸出內容的風險等級和目標不同:
- 輸入範本:著重於防範惡意輸入內容、提示詞注入、越獄嘗試,以及上傳敏感資料。
- 輸出範本:著重於防止模型洩漏敏感資料、生成有害或不符合品牌形象的內容,或是傳回惡意網址。將範本分開可讓您更精細地控管、更輕鬆地追蹤封鎖內容,以及進行微調。
- 偽陽性影響:偽陽性可能會錯誤封鎖正當的提示或回覆,導致使用者體驗不佳。
Low and above設定雖然詳盡,但可能會導致 AI 應用程式出現大量誤判。 - 依類別調整:最佳篩選等級取決於您想防範的危害類別。舉例來說,針對提示詞注入和越獄偵測,以及一般內容安全 (仇恨言論、騷擾、危險內容),請先使用
High或Medium and above,盡量減少誤判。 - 反覆測試:請務必針對提示和回應的代表性資料集測試篩選器設定,包括已知良好和不良的範例。建立偽陽性基準,並據此調整等級。
- 監控:持續監控正式環境中的篩選器效能,以防出現非預期的封鎖行為或誤判率突然增加。
- 使用者意見回饋:提供機制,讓使用者檢舉內容遭誤封鎖的情況。這類意見回饋有助於調整篩選器等級。
設定策略範例
- 初始部署:
- 將一般負責任的 AI 篩選器 (仇恨言論和騷擾) 設為
High。 - 將提示詞注入和越獄偵測篩選器設為
Medium。如果是 Gemini Enterprise 等應用程式,請將門檻設為High,以免發生誤報。 - 使用進階 Sensitive Data Protection 範本,為您的用途設定必要的資訊類型;基本 Sensitive Data Protection 提供的資訊類型有限,主要適用於美國地區。
- 將一般負責任的 AI 篩選器 (仇恨言論和騷擾) 設為
- 測試和驗證:
- 使用一組已知的安全查詢徹底測試,確保查詢不會遭到封鎖。
- 評估一般使用者流量的偽陽率。
- 調整:
- 如果誤報情形仍很嚴重,請將門檻變更為
High。 - 如果覺得特定類別的防護力不足,請謹慎考慮降低該類別的門檻,但務必先經過徹底測試。
- 如果誤報情形仍很嚴重,請將門檻變更為
根據各類別的特定風險和誤判容許度,謹慎選取篩選器層級,即可提升 Model Armor 的效用。如要回報誤判和疏漏,請與 Cloud Customer Care 聯絡。
Model Armor 篩選器
Model Armor 提供多種過濾機制,協助您提供安全可靠的 AI 模型。可用的篩選器類別如下:
負責任的 AI 技術安全篩選器
您可以根據指定信賴水準,篩選下列類別的提示和回覆:
| 類別 | 定義 |
|---|---|
| 仇恨言論 | 針對特定身分和/或受保護特質發表負面或有害言論。 |
| 騷擾 | 針對他人發表含有威脅、恐嚇、霸凌或辱罵意圖的言論。 |
| 煽情露骨內容 | 提及性行為或其他猥褻情事的內容。 |
| 危險內容 | 宣傳有害商品、服務與活動,或是提供接觸管道。 |
| 兒少性虐待內容 | 提及兒少性虐待內容 (CSAM)。這項篩選器預設為啟用,無法關閉。 |
提示詞注入和越獄偵測
提示詞注入是一種安全漏洞,攻擊者會在文字輸入內容 (提示詞) 編寫特殊指令來誘騙 AI 模型。這樣一來,AI 可能忽視正常指令、透露私密/機密資訊,或是執行非預先設定的動作。
在 LLM 的脈絡中,越獄是指規避模型內建的安全通訊協定和道德規範。這會導致 LLM 生成原本應避免的回覆,例如有害、不道德和危險內容。
啟用提示詞注入和越獄偵測功能後,Model Armor 會掃描提示詞和回覆中的惡意內容。如果偵測到這類內容,Model Armor 會封鎖提示或回覆。
Sensitive Data Protection
Sensitive Data Protection 是一項 Google Cloud 服務,可協助您探索、分類及去識別化機密資料。Sensitive Data Protection 可識別私密元素、內容和文件,協助您降低資料外洩風險,避免資料流入及流出 AI 工作負載。您可以在 Model Armor 中直接使用 Sensitive Data Protection,轉換、權杖化及遮蓋敏感元素,同時保留非敏感內容。Model Armor 可接受現有的檢查範本,做為藍圖簡化掃描程序,並找出符合貴商家和法規遵循需求的機密資料。這可確保使用 Sensitive Data Protection 的其他工作負載之間的一致性和互通性。
Model Armor 提供兩種 Sensitive Data Protection 設定模式:
基本設定:在這個模式中,您可以指定要掃描的機密資料類型,藉此設定 Sensitive Data Protection。這個模式支援下列類別:
- 信用卡號碼
- 美國社會安全號碼 (SSN)
- 金融帳戶號碼
- 美國個人納稅識別號碼 (ITIN)
- Google Cloud 憑證
- Google Cloud API 金鑰
基本設定僅支援檢查作業,不支援使用 Sensitive Data Protection 範本。詳情請參閱「基本 Sensitive Data Protection 設定」。
進階設定:這個模式提供更多彈性和自訂選項,可透過 Sensitive Data Protection 範本進行設定。Sensitive Data Protection 範本是預先定義的設定,可讓您指定更精細的偵測規則和去識別化技術。進階設定支援檢查和去識別化作業。詳情請參閱「進階機密資料保護設定」。
Sensitive Data Protection 的信賴水準與其他篩選器的信賴水準不同。如要進一步瞭解 Sensitive Data Protection 的信賴度等級,請參閱「Sensitive Data Protection 比對可能性」。如要進一步瞭解 Sensitive Data Protection,請參閱「Sensitive Data Protection 總覽」。
惡意網址偵測
惡意網址通常會偽裝成合法網址,因此成為網路釣魚攻擊、散布惡意軟體和其他線上威脅的強大工具。舉例來說,如果 PDF 內含惡意網址,可用於入侵處理 LLM 輸出的任何下游系統。
啟用惡意網址偵測功能後,Model Armor 會掃描網址,判斷是否為惡意網址。進而採取行動,避免系統傳回惡意網址。
Model Armor 會擷取網址,直到達到 256 個網址或酬載結尾為止,並只掃描提示和回覆中找到的前 256 個網址。
定義違規處置類型
強制執行措施會定義偵測到違規情事後的處理方式。如要設定 Model Armor 處理偵測結果的方式,請設定強制執行類型。Model Armor 提供下列強制執行類型:
- 僅檢查:在這個模式下,Model Armor 會根據設定的安全和安全政策分析內容。如果發現違規行為,系統會將詳細資料記錄到 Cloud Logging,以供監控和分析。不過,這不會停止整合式服務處理要求或回應。這項功能有助於測試新政策、瞭解潛在違規率,以及稽核,且不會影響實際流量。如要從這個模式獲取價值,請啟用 Cloud Logging。
- 「檢查並封鎖」:這個模式提供主動防護功能。當 Model Armor 偵測到違規行為時,不僅會記錄事件,還會阻止違規內容繼續執行。舉例來說,系統會在提示傳送至模型前封鎖不符規定的提示,或在不安全的回覆傳送給使用者前停止傳送。
強制執行類型會決定 Model Armor 整合的運作方式,以及強制執行的保護層級,因此非常重要。這項設定通常可在 Model Armor 範本和底線設定中設定,針對不同用途和整合服務,允許不同程度的強制執行。詳情請參閱「定義範本的強制執行類型」和「定義樓層設定的強制執行類型」。
各模式的運作方式如下:
| 模式 | 函式 | 影響 | 用途 |
|---|---|---|---|
Inspect only |
當 Model Armor 偵測到可能違反政策的行為 (例如:負責任的 AI 技術篩選器標記的內容、潛在的機密資料、疑似提示詞注入的嘗試),就會在 Cloud Logging 中記錄偵測事件。不過,這項功能不會阻止系統將提示傳送至 LLM,也不會阻止 LLM 將回覆傳送給您。 | 偵測到攻擊時,與 AI 應用程式的互動會繼續進行,不會遭到 Model Armor 封鎖或修改。您會收到回應,就像檢查未導致封鎖一樣。 | 政策測試和調整:部署新 AI 代理程式的機構可能想瞭解潛在問題提示或回覆的類型和頻率,但不想打擾早期使用者。他們會在 監控新興威脅:安全團隊可能會使用這個模式監控新類型的提示詞注入嘗試,或意外洩漏的機密資料,且不會影響應用程式功能。 法規遵循稽核:記錄所有潛在違規事項 (即使未遭到封鎖),可提供有價值的資料,用於法規遵循報告和風險評估。 |
Inspect and block |
這是有效的違規處置模式。當 Model Armor 根據設定的偵測器及其閾值偵測到違規行為時,系統會記錄事件並提供判決結果,以封鎖要求。呼叫服務、整合點或政策執行點 (PEP) 負責封鎖後續處理程序。
|
如果系統偵測到違規內容,就會拒絕要求或不提供 LLM 回覆。您收到應用程式傳送的訊息,指出無法處理要求。具體訊息取決於用戶端應用程式的設計,是否要處理 Model Armor 的封鎖判決。 |
防範有害內容:
Sensitive Data Protection:
停止提示詞注入和越獄偵測:
封鎖不安全的網址:
強制執行自訂主題:
|
最佳做法是先使用 Inspect only,瞭解特定用途的潛在封鎖率和效力。分析記錄並調整設定後,即可切換至 Inspect and block 啟用防護。
如要有效使用 Inspect only 並取得實用洞察資訊,請啟用 Cloud Logging。如果未啟用 Cloud Logging,Inspect only 不會產生任何實用資訊。
透過 Cloud Logging 存取記錄。依服務名稱篩選
modelarmor.googleapis.com。找出與您在範本中啟用的作業相關的項目。詳情請參閱「使用 Logs Explorer 查看記錄檔」。
Model Armor 底限設定
雖然 Model Armor 範本可為個別應用程式提供彈性,但機構通常需要為所有 AI 應用程式建立基本防護等級。使用 Model Armor 底限設定建立這個基準。這些設定會定義在 Google Cloud 資源階層中,專案層級建立的所有範本都必須符合的最低要求。
詳情請參閱「Model Armor 底限設定」。
語言支援
Model Armor 篩選器支援清除多種語言的提示詞和回覆。
- Sensitive Data Protection 篩選器支援英文和其他語言,具體取決於您選取的infoTypes。
負責任的 AI 技術 和提示詞注入與越獄偵測篩選器已在下列語言中測試:
- 中文 (國語)
- 英文
- 法文
- 德文
- 義大利文
- 日文
- 韓文
- 葡萄牙文
- 西班牙文
這些篩選器也適用於許多其他語言,但結果品質可能有所不同。如要查看語言代碼,請參閱這篇文章。
啟用多語言偵測功能的方法有兩種:
啟用一次性設定:如要簡化設定程序,可以使用 REST API 在 Model Armor 範本層級啟用多語言偵測功能,做為一次性設定。詳情請參閱「建立 Model Armor 範本」。
文件審查
文件中的文字可能含有惡意和敏感內容。 Model Armor 可以篩選下列類型的文件,防範安全風險、提示詞注入和越獄活動、敏感資料洩露,以及惡意網址:
- CSV
- 文字檔案:TXT
- Microsoft Word 文件:DOCX、DOCM、DOTX、DOTM
- Microsoft PowerPoint 投影片:PPTX、PPTM、POTX、POTM、POT
- Microsoft Excel 工作表:XLSX、XLSM、XLTX、XLTM
圖片審查
Model Armor 會過濾提示詞和回覆中提供的圖片,防範圖片內含的風險,保護生成式 AI 應用程式。Model Armor 會使用下列方法篩選圖片:
- 影像掃描:僅使用進階 Sensitive Data Protection 篩選器,掃描圖片中的影像內容。
- 光學字元辨識 (OCR):掃描圖片中的文字。
使用 Model Armor 篩選圖片時,請注意下列限制:
- Model Armor 螢幕圖片只能是 JPEG、PNG 和 BMP 格式。
- 每張圖片不得超過 4 MB。
- Model Armor 不會檢查檔案中嵌入的圖片。
- 如果您使用
SanitizeUserPrompt和SanitizeModelResponse方法,Model Armor 不會篩選提示和回覆中與文字一起提供的圖片。 - Model Armor 每次要求只會檢查一張圖片。
使用
SanitizeUserPrompt和SanitizeModelResponse方法時,不支援一次篩選多張圖片。 - 圖片審查功能僅支援
us和eu多區域。如果將含有圖片的提示傳送至 Model Armor 不支援圖片篩選的區域端點,回應中的invocation_result欄位會顯示FAILURE。
詳情請參閱「清除含有圖片的提示」。
限制
使用 Model Armor 時,請注意下列限制:
- Model Armor 會將每則提示詞和回覆視為單輪要求,並分別檢查。不會追蹤對話記錄,也不會在多輪對話中保留脈絡。
- Model Armor 不會解碼或檢查編碼內容,例如以 Base64、十六進位、網址編碼或密文編碼的提示。
- Model Armor 不支援音訊或影片。 此外,Model Armor 不支援在單一要求中結合文字和圖片的提示。如要瞭解圖片審查限制和支援的格式,請參閱「圖片審查」。
資料處理和儲存
Model Armor 的設計原則是保護隱私權和資料最小化原則。除非您明確設定並啟用平台記錄功能,否則 Model Armor 不會儲存 AI 互動內容,讓您控管資料保留時間。本節說明 Model Armor 如何處理您的資料:
- 無狀態處理和內容處置:Model Armor 屬於無狀態服務,所有提示和模型回覆都會完全在記憶體中處理。在標準作業期間,這項服務不會記錄、儲存或長期保留任何分析內容;分析完成後,所有資料都會立即捨棄。
- 客戶控管的記錄:只有透過 Cloud Logging,與處理內容相關的資料才會儲存。如果您選擇為 Model Armor 服務啟用 Cloud Logging,系統會將事件詳細資料 (可能包括中繼資料或所分析內容的程式碼片段,視設定而定) 傳送至您指定的 Cloud Logging 目的地。記錄的資料範圍和保留時間取決於 Cloud Logging 設定。
- 安全儲存和加密:Model Armor 處理的所有資料都會受到業界標準加密技術保護。包括使用 TLS 1.2 以上版本傳輸中的資料,以及在分析期間短暫儲存在記憶體中的資料。
- 區域資料落地:Model Armor 處理程序為無狀態,但這項服務支援嚴格的資料落地控管機制。這可確保所有暫時性處理作業都只會在您定義的地理界線內進行,例如
US或EU。 - 選擇性處理:為確保作業效率和區域法規遵循情形,Model Armor 只會傳輸及處理有效篩選條件的資料。如果特定篩選器已停用 (例如因區域限制或使用者偏好設定),系統就不會將資料傳送至與該篩選器相關聯的基礎服務,也不會處理資料。
- 全球法規遵循標準:Model Armor 是 Google Cloud 生態系統的一環,因此享有嚴格的安全防護基礎。基礎架構會定期接受獨立稽核,以維持 SOC 1/2/3 和 ISO/IEC 27001 等認證。
定價
您可以單獨購買 Model Armor 服務,也可以將其整合至 Security Command Center。系統不會對略過的資料收費。 如需定價資訊,請參閱下列文章:
權杖
生成式 AI 模型會將文字和其他資料拆解成較小的單元,稱為「詞元」。一個符記約等於 4 個字元。如要進一步瞭解如何計算權杖,請參閱「瞭解及計算權杖」。
Model Armor 會根據 AI 提示和回覆中的分詞總數,計算價格並強制執行篩選器限制。如要進一步瞭解各篩選器的權杖限制,請參閱「權杖系統限制」。
後續步驟
- 瞭解 Model Armor 範本。
- 瞭解 Model Armor 底限設定。
- 瞭解 Model Armor 端點。
- 清理提示詞和回覆。
- 瞭解 Model Armor 稽核記錄。
- 排解 Model Armor 問題。