


Arsitektur
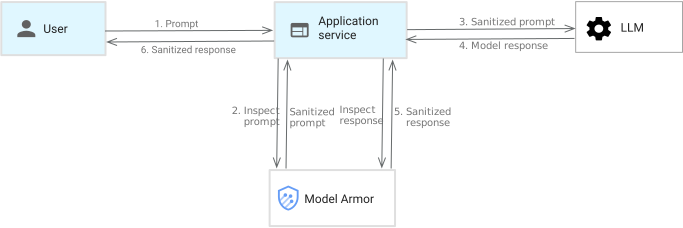
Diagram ini menunjukkan aplikasi yang menggunakan Model Armor untuk melindungi LLM dan pengguna. Langkah-langkah berikut menjelaskan alur data:
- Anda memberikan perintah ke aplikasi.
- Model Armor memeriksa perintah yang masuk untuk menemukan potensi konten sensitif.
- Perintah (atau perintah yang disanitasi) dikirim ke LLM.
- LLM menghasilkan respons.
- Model Armor memeriksa respons yang dihasilkan untuk menemukan potensi konten sensitif.
- Respons (atau respons yang dibersihkan) dikirimkan kepada Anda. Model Armor mengirimkan deskripsi mendetail tentang filter yang dipicu dan tidak dipicu dalam respons.
Model Armor memfilter input (perintah) dan output (respons) untuk mencegah LLM terpapar atau menghasilkan konten berbahaya atau sensitif.
Persyaratan jaringan
Untuk mengakses endpoint regional Model Armor dari dalam jaringan VPC, Anda harus membuat endpoint Private Service Connect ke API Model Armor. Hal ini diperlukan untuk mencegah error sertifikat saat endpoint regional diakses menggunakan Akses Google Pribadi atau Kontrol Layanan VPC. Untuk mengetahui informasi selengkapnya, lihat Memecahkan masalah Model Armor dan Tentang mengakses endpoint regional melalui endpoint Private Service Connect.
Kapan harus menggunakan Model Armor
Berikut adalah beberapa kasus penggunaan umum:
- Menyamarkan data sensitif dan memitigasi kebocoran: Memindai dan menyamarkan kekayaan intelektual (IP) atau informasi identitas pribadi (PII) sensitif dari perintah dan respons model menggunakan Sensitive Data Protection.
- Mencegah serangan injeksi perintah dan jailbreak: Memblokir input yang bertentangan yang mencoba melewati batasan sistem atau memanipulasi model bahasa besar (LLM) agar melakukan tindakan yang tidak diinginkan.
- Memfilter konten berbahaya atau tidak pantas: Memeriksa input pengguna dan output model terhadap nilai minimum keyakinan yang dapat dikonfigurasi untuk ujaran kebencian, pelecehan, konten seksual, konten berbahaya, dan materi pelecehan seksual terhadap anak-anak (CSAM).
- Memeriksa teks dokumen tidak terstruktur: Mengekstrak dan memindai teks dalam format dokumen seperti PDF untuk mencegat payload berbahaya yang disematkan atau data sensitif.
- Input dan respons gambar layar: Memeriksa konten visual dan teks dalam gambar untuk mendeteksi ancaman tersemat, jenis informasi sensitif (infoTypes), atau pelanggaran kebijakan.
- Menerapkan keselarasan merek dan kebijakan bisnis: Memfilter postingan media sosial yang dibuat oleh aplikasi AI yang berisi pesan berbahaya, seperti konten berbahaya atau konten yang menyebarkan kebencian.
Template Model Armor
Template Model Armor memungkinkan Anda mengonfigurasi cara Model Armor menyaring perintah dan respons. Template ini berfungsi sebagai serangkaian filter dan batasan yang disesuaikan untuk berbagai tingkat keyakinan keamanan dan keselamatan, yang memungkinkan Anda mengontrol konten yang ditandai.
Nilai minimum mewakili tingkat keyakinan—seberapa yakin Model Armor bahwa perintah atau respons menyertakan konten yang melanggar. Misalnya, Anda dapat membuat template yang memfilter perintah untuk konten penuh kebencian dengan nilai minimum HIGH, yang berarti Model Armor melaporkan keyakinan tinggi bahwa perintah tersebut berisi konten penuh kebencian. Nilai minimum LOW_AND_ABOVE menunjukkan tingkat keyakinan (LOW, MEDIUM, dan HIGH) dalam membuat klaim tersebut.
Untuk mengetahui informasi selengkapnya, lihat Template Model Armor.
Tingkat keyakinan Model Armor
Anda dapat menetapkan tingkat keyakinan untuk kategori keamanan AI yang bertanggung jawab (konten seksual vulgar, berbahaya, pelecehan, dan ujaran kebencian), deteksi injeksi perintah dan jailbreak, serta perlindungan data sensitif (termasuk aktualitas).
Untuk tingkat keyakinan yang mendukung nilai minimum terperinci, Model Armor menafsirkannya sebagai berikut:
- Tinggi: Mengidentifikasi konten dengan kemungkinan pelanggaran yang tinggi.
- Sedang dan lebih tinggi: Mengidentifikasi konten dengan kemungkinan pelanggaran sedang atau tinggi.
- Rendah dan lebih tinggi: Mengidentifikasi konten dengan kemungkinan pelanggaran rendah, sedang, atau tinggi.
Sensitivitas filter mengontrol rasio deteksi. Nilai minimum yang lebih rendah mengidentifikasi lebih banyak peristiwa, tetapi dapat meningkatkan frekuensi positif palsu.
| Tingkat keyakinan | Probabilitas deteksi | Risiko positif palsu | Kasus penggunaan yang direkomendasikan |
|---|---|---|---|
| Tinggi | Hanya melaporkan konten yang hampir pasti melanggar. | Sangat rendah | Lingkungan produksi yang memprioritaskan interaksi pengguna tanpa gangguan. |
| Medium and above (Sedang dan lebih tinggi) | Melaporkan konten dengan tingkat keyakinan yang seimbang. | Sedang | Aplikasi perusahaan standar. Menawarkan jalan tengah antara perlindungan yang kuat dan rasio positif palsu yang dapat diterima. Sesuai untuk keamanan konten umum. |
| Low and above (Rendah dan lebih tinggi) | Menandai konten apa pun yang bahkan memiliki sedikit indikasi pelanggaran. | Tinggi | Gunakan dengan hati-hati. Berpotensi cocok untuk kategori dengan taruhan tinggi seperti deteksi injeksi perintah dan jailbreak, yang mencegah negatif palsu sangat penting, bahkan dengan risiko menerima positif palsu. Tidak direkomendasikan untuk kategori konten AI yang bertanggung jawab umum karena risiko tinggi pemblokiran konten yang tidak berbahaya. |
Pertimbangan dan praktik terbaik
- Memisahkan template: Konfigurasi template Model Armor terpisah untuk perintah pengguna dan respons model. Input pengguna dan output model memiliki profil dan tujuan risiko yang berbeda:
- Template input: Berfokus pada pencegahan input berbahaya, injeksi perintah, upaya jailbreak, dan penguploadan data sensitif.
- Template output: Berfokus untuk mencegah model membocorkan data sensitif, menghasilkan konten berbahaya atau di luar merek, atau menampilkan URL berbahaya. Dengan memisahkan template, Anda dapat memiliki kontrol yang lebih terperinci, keterlacakan pemblokiran yang lebih baik, dan penyesuaian yang lebih mudah.
- Dampak positif palsu: Positif palsu dapat menurunkan kualitas pengalaman pengguna dengan salah memblokir perintah atau respons yang sah. Setelan
Low and above, meskipun menyeluruh, dapat menyebabkan volume positif palsu yang tinggi dalam aplikasi AI. - Penyesuaian spesifik per kategori: Tingkat filter yang optimal bergantung pada kategori bahaya yang ingin Anda cegah. Misalnya, untuk deteksi injeksi perintah dan jailbreak serta keamanan konten umum (ujaran kebencian, pelecehan, konten berbahaya), mulailah dengan
HighatauMedium and aboveuntuk meminimalkan positif palsu. - Pengujian iteratif: Selalu uji konfigurasi filter Anda terhadap serangkaian perintah dan respons yang representatif, termasuk contoh baik dan buruk yang diketahui. Tetapkan dasar pengukuran untuk positif palsu dan sesuaikan tingkatnya dengan tepat.
- Pemantauan: Terus pantau performa filter dalam produksi untuk mendeteksi perilaku pemblokiran yang tidak terduga atau peningkatan tiba-tiba pada positif palsu.
- Masukan pengguna: Sediakan mekanisme bagi pengguna untuk melaporkan kasus saat konten salah diblokir. Masukan ini sangat berharga untuk menyesuaikan tingkat filter.
Contoh strategi konfigurasi
- Deployment awal:
- Menetapkan filter AI yang bertanggung jawab umum (ujaran kebencian dan pelecehan) ke
High. - Setel filter deteksi injeksi perintah dan jailbreak ke
Medium. Untuk aplikasi seperti Gemini Enterprise, tetapkan nilai minimum keHighuntuk menghindari positif palsu. - Gunakan template Sensitive Data Protection tingkat lanjut untuk mengonfigurasi infotype yang diperlukan untuk kasus penggunaan Anda; Sensitive Data Protection tingkat dasar menyediakan infotype terbatas, yang terutama ditujukan untuk wilayah Amerika Serikat.
- Menetapkan filter AI yang bertanggung jawab umum (ujaran kebencian dan pelecehan) ke
- Pengujian dan validasi:
- Uji secara menyeluruh dengan serangkaian kueri aman yang diketahui untuk memastikan kueri tersebut tidak diblokir.
- Mengevaluasi rasio positif palsu pada traffic pengguna umum.
- Penyesuaian:
- Jika Anda terus mengalami volume positif palsu yang tinggi, ubah
nilai minimum ke
High. - Jika perlindungan terhadap kategori tertentu tampak tidak memadai, pertimbangkan dengan hati-hati untuk menurunkan batas hanya untuk kategori tersebut, setelah pengujian menyeluruh.
- Jika Anda terus mengalami volume positif palsu yang tinggi, ubah
nilai minimum ke
Dengan memilih tingkat filter secara cermat berdasarkan risiko dan toleransi spesifik untuk positif palsu bagi setiap kategori, Anda dapat mengoptimalkan efektivitas Model Armor. Untuk melaporkan positif palsu dan negatif palsu, hubungi Cloud Customer Care.
Filter Model Armor
Model Armor menawarkan berbagai filter untuk membantu Anda menyediakan model AI yang aman dan terlindungi. Kategori filter berikut tersedia.
Filter keamanan AI yang bertanggung jawab
Anda dapat menyaring perintah dan respons pada tingkat keyakinan yang ditentukan untuk kategori berikut:
| Kategori | Definisi |
|---|---|
| Ujaran kebencian | Komentar negatif atau berbahaya yang menargetkan atribut identitas dan/atau dilindungi. |
| Pelecehan | Komentar yang mengancam, mengintimidasi, menindas, atau melecehkan yang menargetkan individu lain. |
| Sexually explicit | Berisi referensi ke tindakan seksual atau konten cabul lainnya. |
| Dangerous content | Mempromosikan atau memungkinkan akses ke barang, layanan, dan aktivitas berbahaya. |
| materi pelecehan seksual terhadap anak-anak (CSAM) | Berisi referensi ke materi pelecehan seksual terhadap anak-anak (CSAM). Filter ini diterapkan secara default dan tidak dapat dinonaktifkan. |
Deteksi injeksi perintah dan jailbreak
Injeksi perintah adalah kerentanan keamanan yang memungkinkan penyerang membuat perintah khusus dalam input teks (perintah) untuk menipu model AI. Hal ini dapat menyebabkan AI mengabaikan petunjuk biasanya, mengungkapkan informasi sensitif, atau melakukan tindakan yang tidak dirancang untuk dilakukannya.
Jailbreak dalam konteks LLM mengacu pada tindakan melewati protokol keamanan dan pedoman etika yang ada dalam model. Hal ini memungkinkan LLM menghasilkan respons yang awalnya dirancang untuk dihindari, seperti konten berbahaya, tidak etis, dan berbahaya.
Jika deteksi injeksi perintah dan jailbreak diaktifkan, Model Armor memindai perintah dan respons untuk mencari konten berbahaya. Jika terdeteksi, Model Armor akan memblokir perintah atau respons.
Sensitive Data Protection
Sensitive Data Protection adalah Google Cloud layanan yang membantu Anda menemukan, mengklasifikasi, dan melakukan de-identifikasi data sensitif. Sensitive Data Protection dapat mengidentifikasi elemen, konteks, dan dokumen sensitif untuk membantu Anda mengurangi risiko kebocoran data yang masuk dan keluar dari beban kerja AI. Anda dapat menggunakan Sensitive Data Protection langsung dalam Model Armor untuk mengubah, membuat token, dan menyamarkan elemen sensitif sambil mempertahankan konteks non-sensitif. Model Armor dapat menerima template inspeksi yang ada, yang berfungsi sebagai cetak biru untuk menyederhanakan proses pemindaian dan mengidentifikasi data sensitif yang spesifik untuk kebutuhan bisnis dan kepatuhan Anda. Hal ini memastikan konsistensi dan interoperabilitas antara beban kerja lain yang menggunakan Sensitive Data Protection.
Model Armor menawarkan dua mode untuk konfigurasi Sensitive Data Protection:
Konfigurasi dasar: Dalam mode ini, Anda mengonfigurasi Sensitive Data Protection dengan menentukan jenis data sensitif yang akan dipindai. Mode ini mendukung kategori berikut:
- Nomor kartu kredit
- Nomor jaminan sosial (SSN) Amerika Serikat
- Nomor rekening keuangan
- Nomor identifikasi wajib pajak pribadi (ITIN) AS
- Google Cloud kredensial
- Google Cloud Kunci API
Konfigurasi dasar hanya mendukung operasi inspeksi dan tidak mendukung penggunaan template Perlindungan Data Sensitif. Untuk mengetahui informasi selengkapnya, lihat Konfigurasi Dasar Perlindungan Data Sensitif.
Konfigurasi lanjutan: Mode ini menawarkan lebih banyak fleksibilitas dan penyesuaian melalui template Perlindungan Data Sensitif. Template Perlindungan Data Sensitif adalah konfigurasi bawaan yang memungkinkan Anda menentukan aturan deteksi dan teknik de-identifikasi yang lebih terperinci. Konfigurasi lanjutan mendukung operasi inspeksi dan penghapusan identitas. Untuk mengetahui informasi selengkapnya, lihat Konfigurasi Sensitive Data Protection tingkat lanjut.
Tingkat keyakinan untuk Perlindungan Data Sensitif beroperasi secara berbeda dengan tingkat keyakinan untuk filter lainnya. Untuk mengetahui informasi selengkapnya tentang tingkat keyakinan untuk Sensitive Data Protection, lihat Kemungkinan kecocokan Sensitive Data Protection. Untuk mengetahui informasi selengkapnya tentang Sensitive Data Protection secara umum, lihat Ringkasan Sensitive Data Protection.
Deteksi URL berbahaya
URL berbahaya sering kali disamarkan agar terlihat sah, sehingga menjadi alat yang ampuh untuk serangan phishing, distribusi malware, dan ancaman online lainnya. Misalnya, jika PDF berisi URL berbahaya yang disematkan, PDF tersebut dapat digunakan untuk membahayakan sistem hilir yang memproses output LLM.
Jika deteksi URL berbahaya diaktifkan, Model Armor akan memindai URL untuk mengidentifikasi apakah URL tersebut berbahaya atau tidak. Hal ini memungkinkan Anda mengambil tindakan dan mencegah URL berbahaya ditampilkan.
Model Armor mengekstrak URL hingga mencapai 256 URL atau akhir payload, dan hanya memindai 256 URL pertama yang ditemukan dalam perintah dan respons.
Menentukan jenis penegakan
Penegakan menentukan apa yang terjadi setelah pelanggaran terdeteksi. Untuk mengonfigurasi cara Model Armor menangani deteksi, Anda menetapkan jenis penegakan. Model Armor menawarkan jenis penerapan berikut:
- Hanya periksa: Dalam mode ini, Model Armor menganalisis konten berdasarkan kebijakan keamanan dan keselamatan yang dikonfigurasi. Jika pelanggaran ditemukan, detailnya akan dicatat ke Cloud Logging untuk pemantauan dan analisis. Namun, hal ini tidak menghentikan permintaan atau respons agar tidak diproses oleh layanan terintegrasi. Hal ini berguna untuk menguji kebijakan baru, memahami potensi tingkat pelanggaran, dan mengaudit tanpa memengaruhi traffic aktif. Untuk mendapatkan nilai dari mode ini, Cloud Logging harus diaktifkan.
- Periksa dan blokir: Mode ini memberikan perlindungan aktif. Saat Model Armor mendeteksi pelanggaran, Model Armor tidak hanya mencatat peristiwa tersebut, tetapi juga mencegah konten yang melanggar diproses. Misalnya, perintah yang tidak mematuhi kebijakan akan diblokir sebelum mencapai model, atau respons model yang tidak aman akan dihentikan sebelum dikirim ke pengguna.
Pilihan jenis penerapan sangat penting untuk cara kerja integrasi Model Armor Anda dan tingkat perlindungan yang diterapkan. Setelan ini biasanya dapat dikonfigurasi dalam template Model Armor dan setelan batas bawah, sehingga memungkinkan berbagai tingkat penegakan untuk berbagai kasus penggunaan dan layanan terintegrasi. Untuk mengetahui informasi selengkapnya, lihat Menentukan jenis penerapan untuk template dan Menentukan jenis penerapan untuk setelan lantai.
Berikut cara kerja setiap mode:
| Mode | Fungsi | Dampak | Kasus penggunaan |
|---|---|---|---|
Inspect only |
Saat mendeteksi potensi pelanggaran kebijakan (misalnya, konten yang ditandai oleh filter AI yang bertanggung jawab, potensi data sensitif, upaya injeksi perintah yang dicurigai), Model Armor akan mencatat peristiwa deteksi di Cloud Logging. Namun, fitur ini tidak mencegah perintah dikirim ke LLM atau respons dari LLM dikembalikan kepada Anda. | Interaksi dengan aplikasi AI berlanjut tanpa pemblokiran atau modifikasi yang jelas oleh Model Armor pada saat deteksi. Anda menerima respons seolah-olah pemeriksaan tidak menghasilkan pemblokiran. | Pengujian dan penyesuaian kebijakan: Organisasi yang men-deploy agen AI baru mungkin ingin memahami jenis dan frekuensi perintah atau respons yang berpotensi bermasalah tanpa mengganggu pengguna awal. Detektor ini mengonfigurasi dalam mode
Memantau ancaman baru: Tim keamanan dapat menggunakan mode ini untuk memantau jenis baru upaya prompt injection atau eksposur data sensitif yang tidak terduga tanpa memengaruhi fungsi aplikasi. Audit kepatuhan: Mencatat semua potensi pelanggaran, meskipun tidak diblokir, dapat memberikan data berharga untuk pelaporan kepatuhan dan penilaian risiko. |
Inspect and block |
Ini adalah mode penerapan aktif. Saat mendeteksi pelanggaran kebijakan berdasarkan detektor yang dikonfigurasi dan nilai minimumnya, Model Armor akan mencatat peristiwa tersebut dan memberikan putusan untuk memblokir permintaan. Layanan panggilan
atau titik integrasi atau Titik Penerapan Kebijakan (PEP) bertanggung jawab untuk
memblokir pemrosesan lebih lanjut.
|
Permintaan Anda ditolak, atau Anda tidak menerima respons dari LLM jika ditemukan pelanggaran. Anda menerima pesan dari aplikasi yang menunjukkan bahwa permintaan tidak dapat diproses. Pesan spesifik bergantung pada cara aplikasi klien dirancang untuk menangani putusan pemblokiran dari Model Armor. |
Mencegah konten berbahaya:
Sensitive Data Protection:
Hentikan deteksi injeksi perintah dan jailbreak:
Memblokir URL yang tidak aman:
Menerapkan topik kustom:
|
Sebagai praktik terbaik, mulailah dengan Inspect only untuk memahami potensi tingkat pemblokiran dan efikasi untuk kasus penggunaan spesifik Anda. Setelah menganalisis log dan menyesuaikan konfigurasi, Anda dapat beralih ke Inspect and block untuk perlindungan aktif.
Untuk menggunakan Inspect only secara efektif dan mendapatkan insight berharga, aktifkan
Cloud Logging. Tanpa Cloud Logging diaktifkan, Inspect only tidak akan memberikan
informasi yang berguna.
Akses log Anda melalui Cloud Logging. Filter menurut nama layanan
modelarmor.googleapis.com. Cari entri yang terkait dengan operasi yang Anda aktifkan di template. Untuk mengetahui informasi selengkapnya, lihat Melihat log menggunakan Logs Explorer.
Setelan tingkat Model Armor
Meskipun template Model Armor memberikan fleksibilitas untuk setiap aplikasi, organisasi sering kali perlu menetapkan tingkat perlindungan dasar di semua aplikasi AI mereka. Gunakan setelan tingkat Model Armor untuk menetapkan dasar ini. Setelan ini menentukan persyaratan minimum untuk semua template yang dibuat di tingkat project dalam hierarki Google Cloud resource.
Untuk mengetahui informasi selengkapnya, lihat Setelan tingkat Model Armor.
Dukungan bahasa
Filter Model Armor mendukung pembersihan perintah dan respons dalam beberapa bahasa.
- Filter Sensitive Data Protection mendukung bahasa Inggris dan bahasa lainnya, bergantung pada infoTypes yang Anda pilih.
Filter AI yang bertanggung jawab dan deteksi injeksi perintah dan jailbreak diuji dalam bahasa berikut:
- China (Mandarin)
- Inggris
- Prancis
- Jerman
- Italia
- Jepang
- Korea
- Portugis
- Spanyol
Filter ini dapat berfungsi dalam banyak bahasa lain, tetapi kualitas hasilnya mungkin bervariasi. Untuk kode bahasa, lihat Bahasa yang didukung.
Ada dua cara untuk mengaktifkan deteksi multi-bahasa:
Aktifkan di setiap permintaan: Untuk kontrol terperinci, aktifkan deteksi multi-bahasa berdasarkan per-permintaan saat membersihkan perintah pengguna dan membersihkan respons model.
Aktifkan satu kali: Jika lebih menyukai penyiapan yang lebih sederhana, Anda dapat mengaktifkan deteksi multi-bahasa sebagai konfigurasi satu kali di tingkat template Model Armor menggunakan REST API. Untuk mengetahui informasi selengkapnya, lihat Membuat template Model Armor.
Pemeriksaan dokumen
Teks dalam dokumen dapat berisi konten sensitif dan berbahaya. Model Armor dapat menyaring jenis dokumen berikut untuk keamanan, upaya injeksi perintah dan jailbreak, data sensitif, dan URL berbahaya:
- CSV
- File teks: TXT
- Dokumen Microsoft Word: DOCX, DOCM, DOTX, DOTM
- Slide Microsoft PowerPoint: PPTX, PPTM, POTX, POTM, POT
- Lembar Microsoft Excel: XLSX, XLSM, XLTX, XLTM
Penyaringan gambar
Model Armor menyaring gambar yang diberikan dalam perintah dan respons untuk membantu melindungi aplikasi AI generatif Anda dari risiko yang tertanam dalam gambar. Model Armor menyaring gambar menggunakan metode berikut:
- Pemindaian visual: Memindai konten visual dalam gambar saja menggunakan filter Sensitive Data Protection lanjutan.
- Pengenalan karakter optik (OCR): Memindai teks dalam gambar.
Pertimbangkan batasan berikut saat Anda menggunakan Model Armor untuk menyaring gambar:
- Gambar layar Model Armor hanya dalam format JPEG, PNG, dan BMP.
- Setiap gambar harus berukuran 4 MB atau lebih kecil.
- Model Armor tidak menyaring gambar yang disematkan dalam file.
- Model Armor tidak menyaring gambar yang diberikan bersama dengan teks dalam perintah dan respons jika Anda menggunakan metode
SanitizeUserPromptdanSanitizeModelResponse. - Model Armor hanya menyaring satu gambar per permintaan.
Penyaringan beberapa gambar sekaligus tidak didukung saat Anda menggunakan metode
SanitizeUserPromptdanSanitizeModelResponse. - Penyaringan gambar hanya didukung di multi-region
usdaneu. Jika Anda mengirimkan perintah yang berisi gambar ke endpoint regional yang tidak mendukung penyaringan gambar Model Armor, kolominvocation_resultdalam respons akan menunjukkanFAILURE.
Untuk mengetahui informasi selengkapnya, lihat Membersihkan perintah yang berisi gambar.
Batasan
Pertimbangkan batasan berikut saat Anda menggunakan Model Armor:
- Model Armor memeriksa setiap perintah dan respons secara independen sebagai permintaan satu giliran. Gemini tidak melacak histori percakapan atau mempertahankan konteks di seluruh interaksi multi-giliran.
- Model Armor tidak mendekode atau memeriksa konten yang dienkode, seperti perintah yang dienkode dalam Base64, heksadesimal, encoding URL, atau ciphertext.
- Model Armor tidak mendukung audio atau video. Selain itu, Model Armor tidak mendukung perintah yang menggabungkan teks dan gambar dalam satu permintaan. Untuk mengetahui batasan pemeriksaan gambar dan format yang didukung, lihat Pemeriksaan gambar.
Penanganan dan penyimpanan data
Model Armor dirancang dengan mempertimbangkan prinsip privasi dan minimisasi data. Model Armor tidak menyimpan konten interaksi AI Anda kecuali jika Anda secara eksplisit mengonfigurasi dan mengaktifkan logging platform, sehingga Anda memiliki kontrol atas retensi data. Bagian ini menjelaskan cara Model Armor menangani data Anda:
- Pemrosesan stateless dan penghapusan konten: Model Armor beroperasi sebagai layanan stateless, memproses semua perintah dan respons model sepenuhnya di dalam memori. Fitur ini tidak mencatat, menyimpan, atau mempertahankan konten apa pun secara permanen yang dianalisis selama operasi standarnya; semua data akan langsung dihapus setelah analisis selesai.
- Pencatatan log yang dikontrol pelanggan: Satu-satunya keadaan saat data yang terkait dengan konten yang sedang diproses disimpan adalah melalui Cloud Logging. Jika Anda memilih untuk mengaktifkan Cloud Logging untuk layanan Model Armor, detail peristiwa—yang mungkin mencakup metadata atau cuplikan konten yang dianalisis sebagaimana dikonfigurasi—dikirim ke tujuan Cloud Logging yang Anda tetapkan. Cakupan data yang dicatat dan retensinya ditentukan oleh konfigurasi Cloud Logging Anda.
- Penyimpanan dan enkripsi yang aman: Semua data yang ditangani oleh Model Armor dilindungi oleh enkripsi standar industri. Hal ini mencakup data dalam pengiriman menggunakan TLS 1.2 dan yang lebih baru serta data apa pun yang berada sebentar dalam memori selama analisis.
- Residensi data regional: Meskipun pemrosesan Model Armor tidak memiliki status, layanan ini mendukung kontrol residensi data yang ketat. Hal ini memastikan bahwa semua pemrosesan sementara terjadi secara eksklusif dalam batas geografis yang Anda tentukan, seperti
USatauEU. - Pemrosesan selektif: Untuk memastikan efisiensi operasional dan kepatuhan regional, Model Armor hanya mengirimkan dan memproses data untuk filter aktif. Jika filter tertentu dinonaktifkan (misalnya, karena ketersediaan regional atau preferensi pengguna), tidak ada data yang dikirim ke atau diproses oleh layanan pokok yang terkait dengan filter tersebut.
- Standar kepatuhan global: Sebagai bagian dari ekosistem Google Cloud , Model Armor diuntungkan oleh fondasi keamanan yang ketat. Infrastruktur menjalani audit independen secara rutin untuk mempertahankan sertifikasi, termasuk SOC 1/2/3 dan ISO/IEC 27001.
Harga
Model Armor dapat dibeli sebagai layanan mandiri atau sebagai bagian terintegrasi dari Security Command Center. Anda tidak akan ditagih untuk data yang dilewati. Untuk mengetahui informasi harga, lihat referensi berikut:
Token
Model AI generatif menguraikan teks dan data lain menjadi unit-unit yang disebut token. Token setara dengan sekitar 4 karakter. Untuk mengetahui informasi selengkapnya tentang cara penghitungan token, lihat Memahami dan menghitung token.
Model Armor menggunakan jumlah total token dalam perintah dan respons AI untuk tujuan penetapan harga dan penerapan batas filter. Untuk mengetahui informasi selengkapnya tentang batas token untuk setiap filter, lihat Batas sistem token.
Langkah berikutnya
- Pelajari template Model Armor.
- Pelajari setelan batas bawah Model Armor.
- Pelajari endpoint Model Armor.
- Membersihkan perintah dan respons.
- Pelajari logging audit Model Armor.
- Memecahkan masalah Model Armor.