


이 페이지에서는 표준 등급의 Redis용 Memorystore 인스턴스에 대한 고가용성 (HA)을 설명합니다.
표준 등급은 데이터를 하나 이상의 복제본으로 복제하고 복제본에 빠른 자동 장애 조치를 제공하여 일반적인 장애로부터 Redis 인스턴스를 보호합니다.
readReplicaMode 설정이 비활성화된 표준 등급 인스턴스에는 기본 인스턴스와 HA 기능을 제공하는 복제본이 포함됩니다. 이 설정이 사용 설정된 표준 등급 인스턴스에는 기본 인스턴스와 1~5개의 읽기 복제본이 있습니다. 이 구성의 읽기 복제본은 읽기를 실행할 뿐만 아니라 HA 기능의 장애 조치 지원도 제공합니다. readReplicaMode 설정이 비활성화되어 있는지 또는 사용 설정되어 있는지 확인하려면 인스턴스의 읽기 복제본 정보 보기를 참고하세요.
Redis용 Memorystore는 기본 인스턴스를 하나 이상의 복제본으로 복제하여 고가용성을 제공합니다. Memorystore for Redis는 비동기 복제 프로토콜을 사용하여 기본 인스턴스의 데이터에 대한 변경사항을 복제본에 복사합니다. 복제의 비동기적 특성으로 인해 기본 인스턴스의 쓰기 속도에 따라 복제본이 인스턴스보다 뒤쳐질 수 있습니다.
기본 인스턴스에 장애가 발생하면 인스턴스는 자동으로 복제본으로 장애 조치됩니다. 복제본이 두 개 이상 있는 인스턴스의 경우 인스턴스는 자동으로 복제 지연이 가장 적은 정상 상태의 복제본으로 장애 조치됩니다.
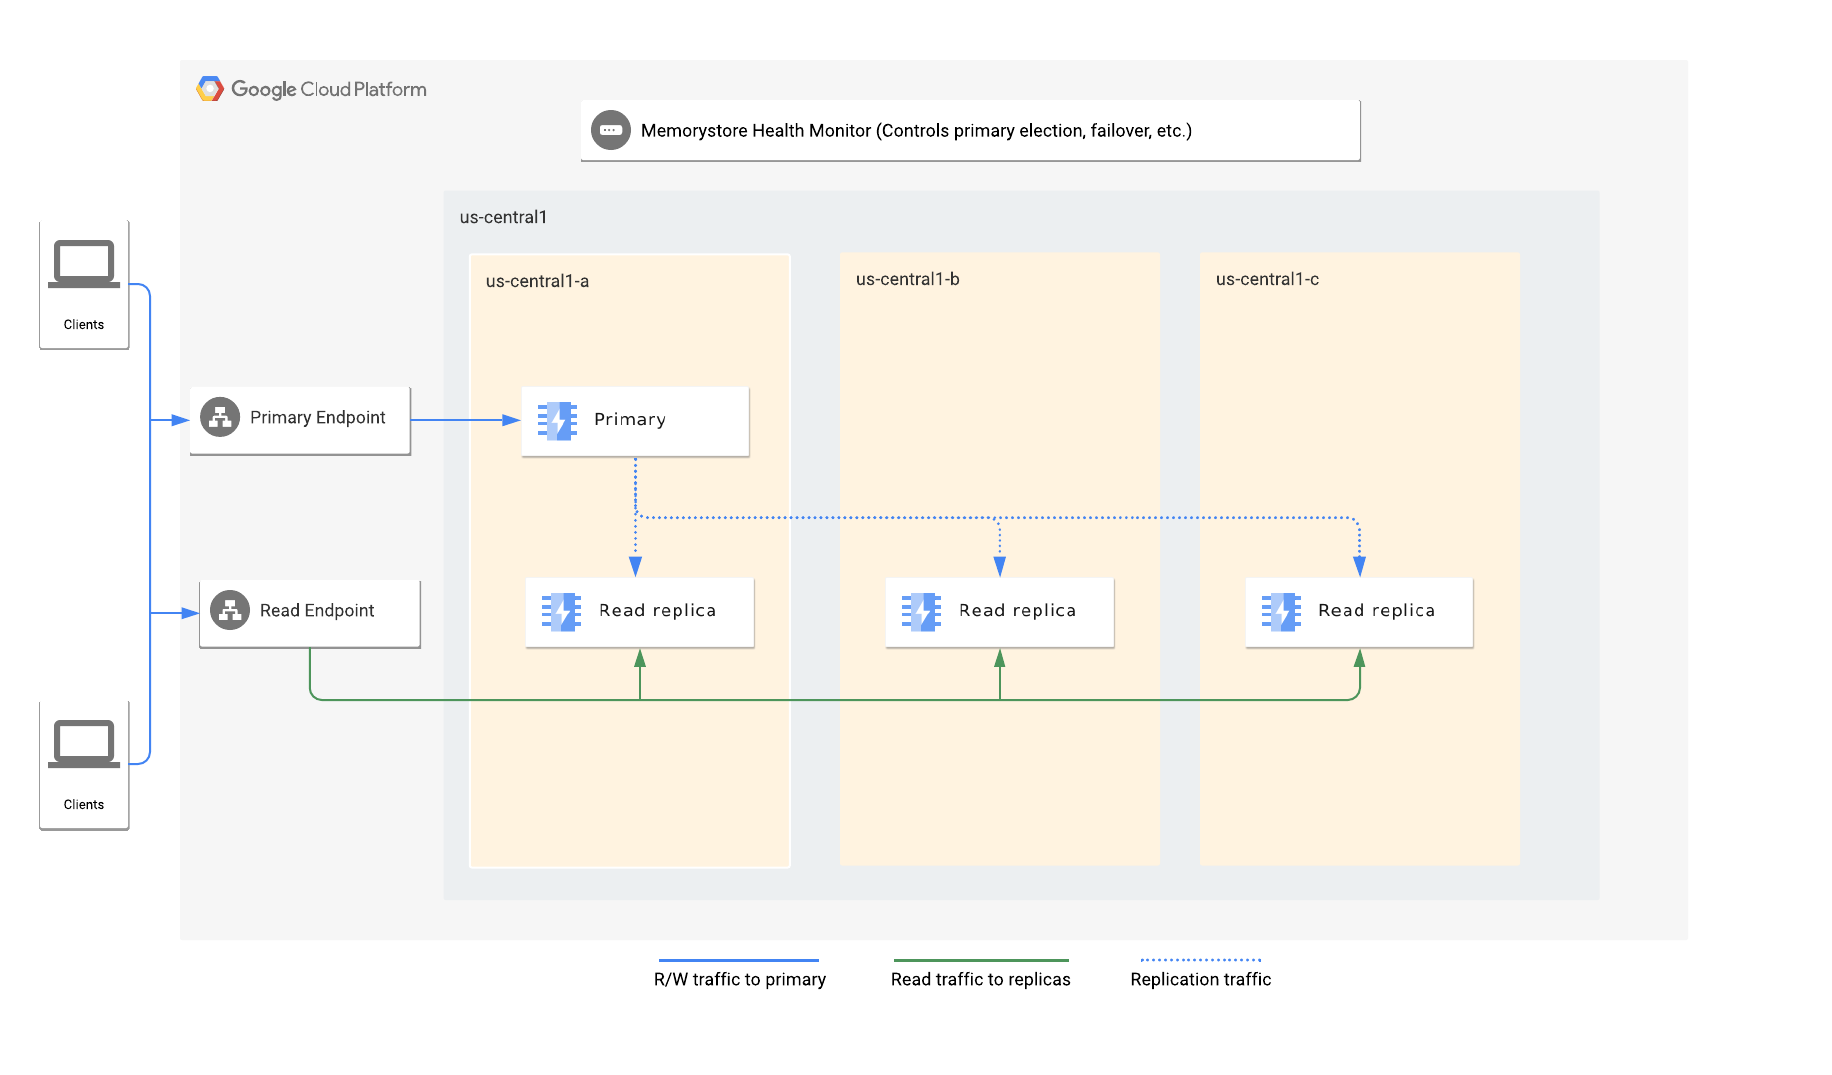
비읽기 복제본이 하나만 있는 인스턴스를 구성하면 Memorystore for Redis에서 모든 애플리케이션 연결을 기본 엔드포인트로 전달합니다. 읽기 복제본을 사용하도록 인스턴스를 구성하면 애플리케이션이 읽기 엔드포인트를 사용하여 모든 복제본에 읽기 쿼리를 배포할 수도 있습니다.
데이터 지속성 및 고가용성
표준 등급은 복제 및 자동 장애 조치를 통해 고가용성 (HA)을 제공하지만 HA는 완전한 데이터 내구성을 보장하지 않습니다. Redis용 Memorystore는 일시적인 리전 장애와 같은 특정 재난 상황에서 HA가 사용 설정된 경우에도 완전한 데이터 내구성을 제공할 수 없습니다.
데이터를 보호하고 기본 수준의 지속성을 제공하기 위해 Google Cloud 콘솔을 사용하여 Memorystore for Redis 인스턴스를 만들면 RDB 스냅샷이 기본적으로 사용 설정됩니다.
프로덕션 워크로드의 경우 데이터 복원력을 더욱 개선하기 위해 다음 권장사항을 고려하세요.
- 재해 복구: Memorystore for Redis는 리전 간 복제를 지원하지 않습니다. 재해 복구 전략에 진정한 리전 복원력을 위한 교차 리전 복제가 필요한 경우 Memorystore for Valkey 인스턴스를 사용하는 것이 좋습니다. 리전 간 보조 인스턴스 구성 및 관리에 대한 자세한 내용은 Memorystore for Valkey 문서의 리전 간 복제 사용을 참고하세요.
- 최대 내구성: 애플리케이션에 가능한 최고 수준의 데이터 내구성이 필요한 경우 리전 간 복제, 일일 자동 백업, 추가 전용 파일 (AOF) 지속성으로 구성된 Memorystore for Valkey 인스턴스를 사용하는 것이 좋습니다. 이 조합은 데이터 손실에 대한 가장 강력한 보호를 제공합니다. 자세한 내용은 Memorystore for Valkey 문서의 지속성 개요를 참고하세요.
장애 조치가 발생하는 경우
기본 인스턴스가 실패하면 장애 조치가 발생합니다. 장애 조치 중에 기본 인스턴스와 읽기 엔드포인트는 새 기본 인스턴스와 복제본으로 자동 리디렉션됩니다. Redis용 Memorystore가 기본 엔드포인트에 대한 모든 연결을 삭제합니다. Memorystore for Redis는 승격된 읽기 복제본에 대한 읽기 엔드포인트 연결도 삭제합니다.
장애 조치가 애플리케이션에 미치는 영향
기본 인스턴스에서 복제본으로 장애 조치가 수행되면 Memorystore for Redis에서 인스턴스의 기본 엔드포인트에 대한 기존 연결이 끊어집니다. 자동 복구 중에는 평균 30초 동안, 유지보수 이벤트 중에는 15초 동안 인스턴스를 사용할 수 없습니다. 다시 연결하면 애플리케이션이 동일한 연결 문자열 또는 IP 주소를 사용하여 새 기본 인스턴스로 자동 리디렉션됩니다. 장애 조치 후 애플리케이션을 업데이트할 필요가 없습니다.
장애 조치 중에 읽기 엔드포인트에 대한 연결이 있으면 Memorystore for Redis에서 기본 인스턴스로 승격되는 복제본에 대한 연결을 끊습니다. Memorystore for Redis는 다른 복제본에 대한 연결을 계속 제공합니다. 장애 조치가 완료되고 새 복제본을 사용할 수 있게 되면 Memorystore for Redis에서 연결을 새 복제본으로 리디렉션합니다.
장애 조치 후 인스턴스 연결 재시도
장애 조치가 발생하면 Memorystore for Redis가 기본 엔드포인트의 모든 연결을 끊습니다. 복제본 수에 따라 Memorystore for Redis에서 일부 읽기 연결을 삭제할 수도 있습니다.
이 연결 손실로 인해 애플리케이션은 연결을 다시 설정하기 위해 재시도해야 합니다. 재시도 로직에서 지수 백오프를 사용하여 너무 많은 재시도 요청으로 인스턴스가 과부하되지 않도록 하는 것이 좋습니다. 재시도 로직을 포함하는 것 외에도 수동 장애 조치로 애플리케이션을 테스트하여 장애 조치가 애플리케이션에 미치는 영향을 테스트하는 것이 좋습니다.
대부분의 Redis 클라이언트에는 재시도 기능이 내장되어 있습니다. 장애 조치로 인해 연결이 끊어지는 경우 이러한 재시도 기능을 사용하는 것이 좋습니다.
다음 작업을 수행하면 장애 조치가 발생합니다.
장애 조치로 인한 연결 끊김을 처리하기 위해 애플리케이션에 재시도 로직을 구현하는 경우 인스턴스의 성능에 미치는 영향이 크지 않을 것입니다.
고가용성 상태 보기
Cloud Monitoring을 사용하여 Redis 인스턴스의 고가용성 측정항목을 확인할 수 있습니다. Cloud Monitoring이 Memorystore for Redis에 제공하는 측정항목에 대한 자세한 내용은 Redis 인스턴스 모니터링 및 Memorystore for Redis에 지원되는 모니터링 측정항목을 참고하세요.
Redis가 제공하는 기본 복제 상태를 보려면 INFO 명령어를 사용하세요.