


このページでは、Memorystore for Redis Cluster アーキテクチャで高可用性(HA)が提供され、サポートされる仕組みについて説明します。このページでは、推奨される HA 構成を使用してクラスタのパフォーマンスと安定性を向上させる方法についても説明します。
リージョン固有の考慮事項の詳細については、地域とリージョンをご覧ください。
高可用性
Memorystore for Redis Cluster は、クライアントがマネージド Memorystore for Redis Cluster VM に直接アクセスする高可用性アーキテクチャ上に構築されています。クライアントは、Memorystore for Redis Cluster インスタンスに接続するで説明されているように、個々のシャード ネットワーク アドレスに接続することでこれを行います。
シャードに直接接続すると、次のようなメリットがあります。
直接接続では、各シャードが独立して障害が発生するように設計されているため、単一障害点を回避できます。たとえば、複数のクライアントからのトラフィックによってスロット(キースペース チャンク)が過負荷状態になった場合、シャード障害により、スロットの処理を担当するシャードへの影響が制限されます。
直接接続では中間ホップが回避されるため、クライアントと Redis VM 間のラウンドトリップ時間(クライアント レイテンシ)が最小限に抑えられます。
推奨構成
信頼性が高いため、単一ゾーン インスタンスではなく、高可用性のマルチゾーン インスタンスを作成することをおすすめします。ただし、レプリカなしでインスタンスをプロビジョニングする場合は、単一ゾーン インスタンスを選択することをおすすめします。詳細については、単一ゾーン クラスタを使用するタイミングをご覧ください。
インスタンスの高可用性を有効にするには、シャードごとに 1 つ以上のレプリカをプロビジョニングする必要があります。これは、インスタンスの作成時に行うか、シャードごとに少なくとも 1 つのレプリカになるようにレプリカ数をスケーリングします。レプリカは、計画メンテナンス中や予期しないシャード障害発生時に自動フェイルオーバーを提供します。
Redis クライアントのベスト プラクティスのガイダンスに従ってクライアントを構成することをおすすめします。推奨されるベスト プラクティスを使用することで、OSS Redis クライアントはダウンタイムなしでクラスタの役割(自動フェイルオーバー)とスロット割り当ての変更(ノードの交換、コンシューマのスケールアウト/イン)を自動的かつ適切に処理できます。
レプリカ
高可用性の Memorystore for Redis Cluster インスタンスはリージョン リソースです。つまり、シャードのプライマリ VM とレプリカ VM は複数のゾーンに分散され、ゾーンの停止から保護されます。Memorystore for Redis Cluster は、シャードあたり 0 ~ 5 個のレプリカを持つインスタンスをサポートしています。
レプリカを使用すると、読み取りをスケーリングして読み取りスループットを増やすことができます。これを行うには、READONLY コマンドを使用して、クライアントがレプリカから読み取ることができる接続を確立する必要があります。レプリカからの読み取りの詳細については、Redis クラスタでスケーリングするをご覧ください。
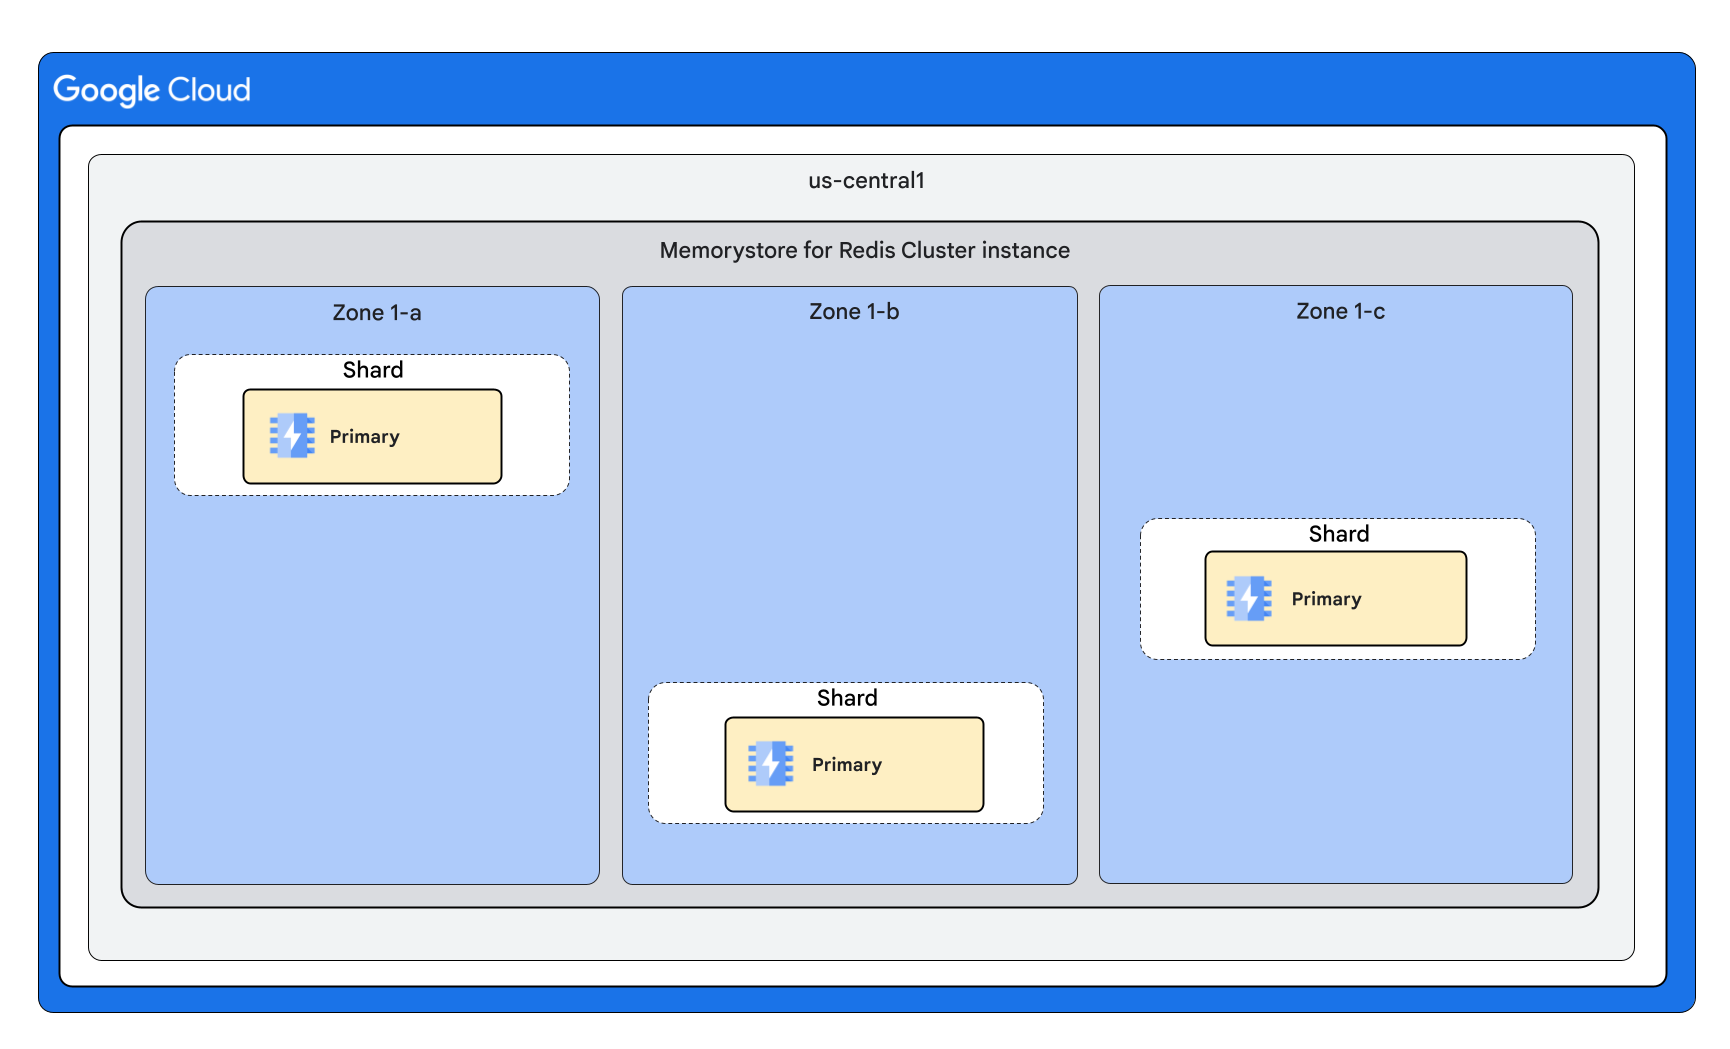
シャードごとに 0 個のレプリカを持つクラスタの例
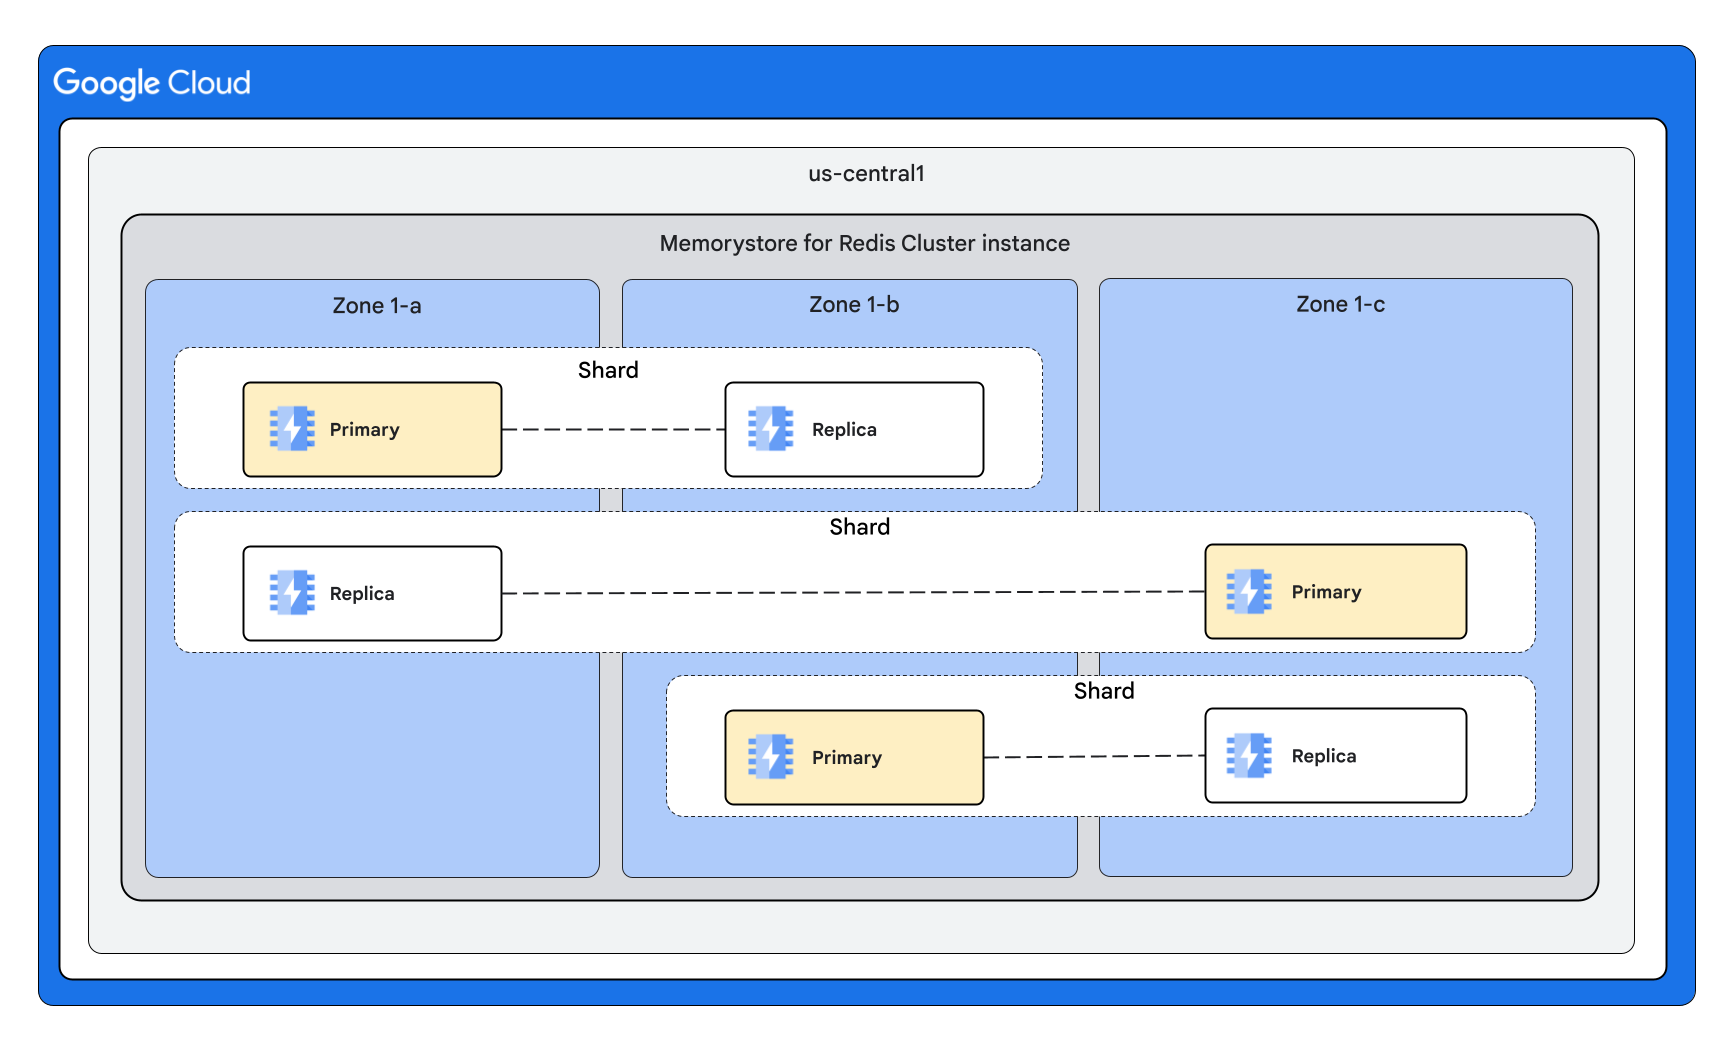
シャードごとに 1 個のレプリカを持つクラスタの例
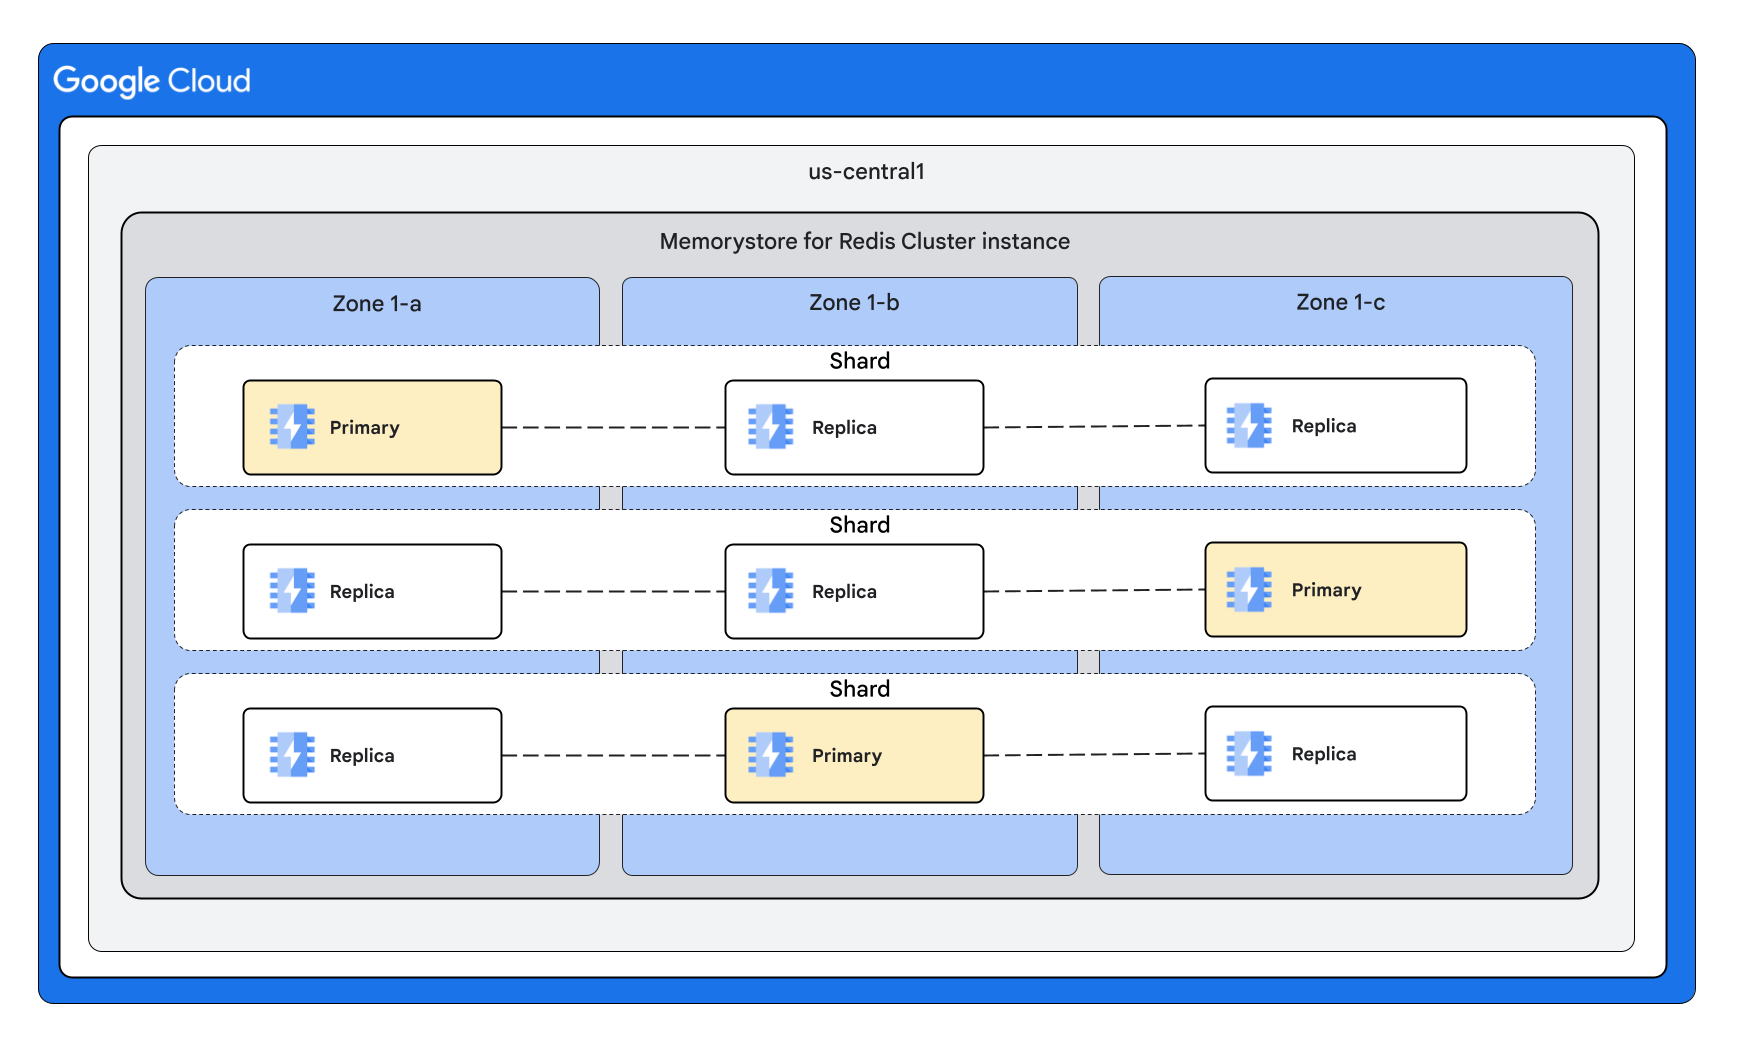
シャードごとに複数のレプリカを持つクラスタの例
自動フェイルオーバー
シャード内の自動フェイルオーバーは、メンテナンスまたはプライマリ ノードの予期しない障害が原因で発生する可能性があります。フェイルオーバー中に、レプリカがプライマリに昇格します。レプリカは明示的に構成できます。また、サービスは内部メンテナンス中にダウンタイムを回避するために、一時的に追加のレプリカをプロビジョニングできます。
自動フェイルオーバーにより、メンテナンス アップデート中のデータ損失を防ぐことができます。メンテナンス中の自動フェイルオーバーの動作について詳しくは、メンテナンス中の自動フェイルオーバーの動作をご覧ください。
フェイルオーバーとノード修復の期間
自動フェイルオーバーは、プライマリ ノード プロセスのクラッシュやハードウェア障害などの計画外のイベントの場合、数十秒かかることがあります。この間、システムは障害を検出し、新しいプライマリになるレプリカを選択します。
ノードの修復には、サービスが障害が発生したノードを置き換えるまでに数分かかることがあります。これは、すべてのプライマリ ノードとレプリカノードに当てはまります。高可用性でないインスタンス(レプリカがプロビジョニングされていない)の場合、障害が発生したプライマリ ノードの修復にも数分程度の時間がかかります。
計画外フェイルオーバー中のクライアントの動作
障害の性質によっては、クライアント接続がリセットされる可能性があります。自動復旧後、指数バックオフを使用して接続を再試行し、プライマリ ノードとレプリカ ノードの過負荷を回避できます。
読み取りスループットにレプリカを使用しているクライアントでは、障害が発生したノードが自動的に置き換えられるまで、容量が一時的に低下する可能性があります。
書き込みの消失
予期しない障害によるフェイルオーバー中に、Redis のレプリケーション プロトコルの非同期性により、確認済みの書き込みが失われる可能性があります。
クライアント アプリケーションは、Redis の WAIT コマンドを利用して、実際のデータの安全性を高めることができます。これは、Redis WAIT コマンドのドキュメントで説明されているように、トレードオフを伴うベスト エフォート型のアプローチです。
単一ゾーンの停止によるキースペースへの影響
このセクションでは、単一ゾーンの停止が Memorystore for Redis Cluster インスタンスに与える影響について説明します。
マルチゾーン インスタンス
HA インスタンス: ゾーンで停止が発生した場合、キースペース全体で読み取りと書き込みが可能になりますが、一部のリードレプリカが使用できないため、読み取り容量が減少します。1 つのゾーンで障害が発生した場合に、インスタンスに十分な読み取り容量を確保できるように、クラスタ容量をオーバー プロビジョニングすることを強くおすすめします。停止が終了すると、影響を受けたゾーンのレプリカが復元され、クラスタの読み取り容量が構成された値に戻ります。詳細については、スケーラブルで信頼性の高いアプリのパターンをご覧ください。
非 HA インスタンス(レプリカなし): ゾーンで停止が発生すると、影響を受けるゾーンでプロビジョニングされたキースペースの部分でデータ フラッシュが発生し、停止期間中は書き込みや読み取りに使用できなくなります。停止が終了すると、影響を受けたゾーンのプライマリが復元され、クラスタの容量が構成された値に戻ります。
シングルゾーン インスタンス
- HA インスタンスと非 HA インスタンスの両方: インスタンスがプロビジョニングされているゾーンが停止すると、クラスタが使用できなくなり、データがフラッシュされます。別のゾーンで停止が発生した場合、クラスタは読み取りリクエストと書き込みリクエストの処理を継続します。停止が終了すると、クラスタの構成済み容量が復元されます。
ベスト プラクティス
このセクションでは、高可用性とレプリカに関するベスト プラクティスについて説明します。
レプリカを追加する
レプリカを追加するには、RDB スナップショットが必要です。RDB スナップショットは、プロセス フォークと「コピーオンライト」メカニズムを使用して、ノードデータのスナップショットを作成します。ノードへの書き込みパターンに応じて、書き込みによってアクセスされたページがコピーされると、ノードの使用済みメモリが増加します。メモリ使用量は、ノード内のデータの最大 2 倍になることがあります。
ノードにスナップショットを完了するのに十分なメモリがあることを確認するには、maxmemory をノード容量の 80% に維持または設定して、20% をオーバーヘッド用に予約します。スナップショットのモニタリングに加え、このメモリ オーバーヘッドにより、ワークロードのスナップショットを正常に処理できます。また、レプリカを追加するときは、書き込みトラフィックをできるだけ減らしてください。詳細については、書き込み負荷の高いクラスタをモニタリングするをご覧ください。