


Cette page explique comment l'architecture Memorystore pour Redis Cluster offre et prend en charge la haute disponibilité (HD). Cette page explique également comment améliorer les performances et la stabilité des clusters grâce aux configurations à haute disponibilité que nous recommandons.
Pour en savoir plus sur les considérations spécifiques à la région, consultez la page Zones géographiques et régions.
Haute disponibilité
Memorystore for Redis Cluster repose sur une architecture à disponibilité élevée dans laquelle vos clients accèdent directement aux VM Memorystore for Redis Cluster gérées. Pour ce faire, vos clients se connectent aux adresses réseau des shards individuels, comme décrit dans Se connecter à une instance Memorystore for Redis Cluster.
La connexion directe aux shards offre les avantages suivants :
La connexion directe évite tout point de défaillance unique, car chaque partition est conçue pour échouer indépendamment. Par exemple, si le trafic de plusieurs clients surcharge un emplacement (segment d'espace de clés), l'échec du shard limite l'impact au shard responsable de la diffusion de l'emplacement.
La connexion directe évite les sauts intermédiaires, ce qui minimise le délai aller-retour (latence du client) entre votre client et la VM Redis.
Configurations recommandées
Nous vous recommandons de créer des instances multizones à disponibilité élevée plutôt que des instances monozones, car elles offrent une meilleure fiabilité. Toutefois, si vous choisissez de provisionner une instance sans réplicas, nous vous recommandons de choisir une instance à zone unique. Pour en savoir plus, consultez Quand utiliser un cluster à une seule zone.
Pour activer la haute disponibilité de votre instance, vous devez provisionner au moins une instance répliquée pour chaque shard. Vous pouvez le faire lorsque vous créez l'instance ou mettre à l'échelle le nombre d'instances répliquées à au moins une instance répliquée par segment. Les réplicas offrent un basculement automatique lors de la maintenance planifiée et en cas de défaillance inattendue des partitions.
Nous vous recommandons de configurer votre client en suivant les conseils de la section Bonnes pratiques concernant les clients Redis. L'utilisation des bonnes pratiques recommandées permet à votre client OSS Redis de gérer automatiquement et correctement les changements de rôle (basculements automatiques) et d'attribution d'emplacements (remplacement de nœuds, effectuer un scaling horizontal/à la baisse des consommateurs) pour votre cluster sans aucun temps d'arrêt.
Instances répliquées
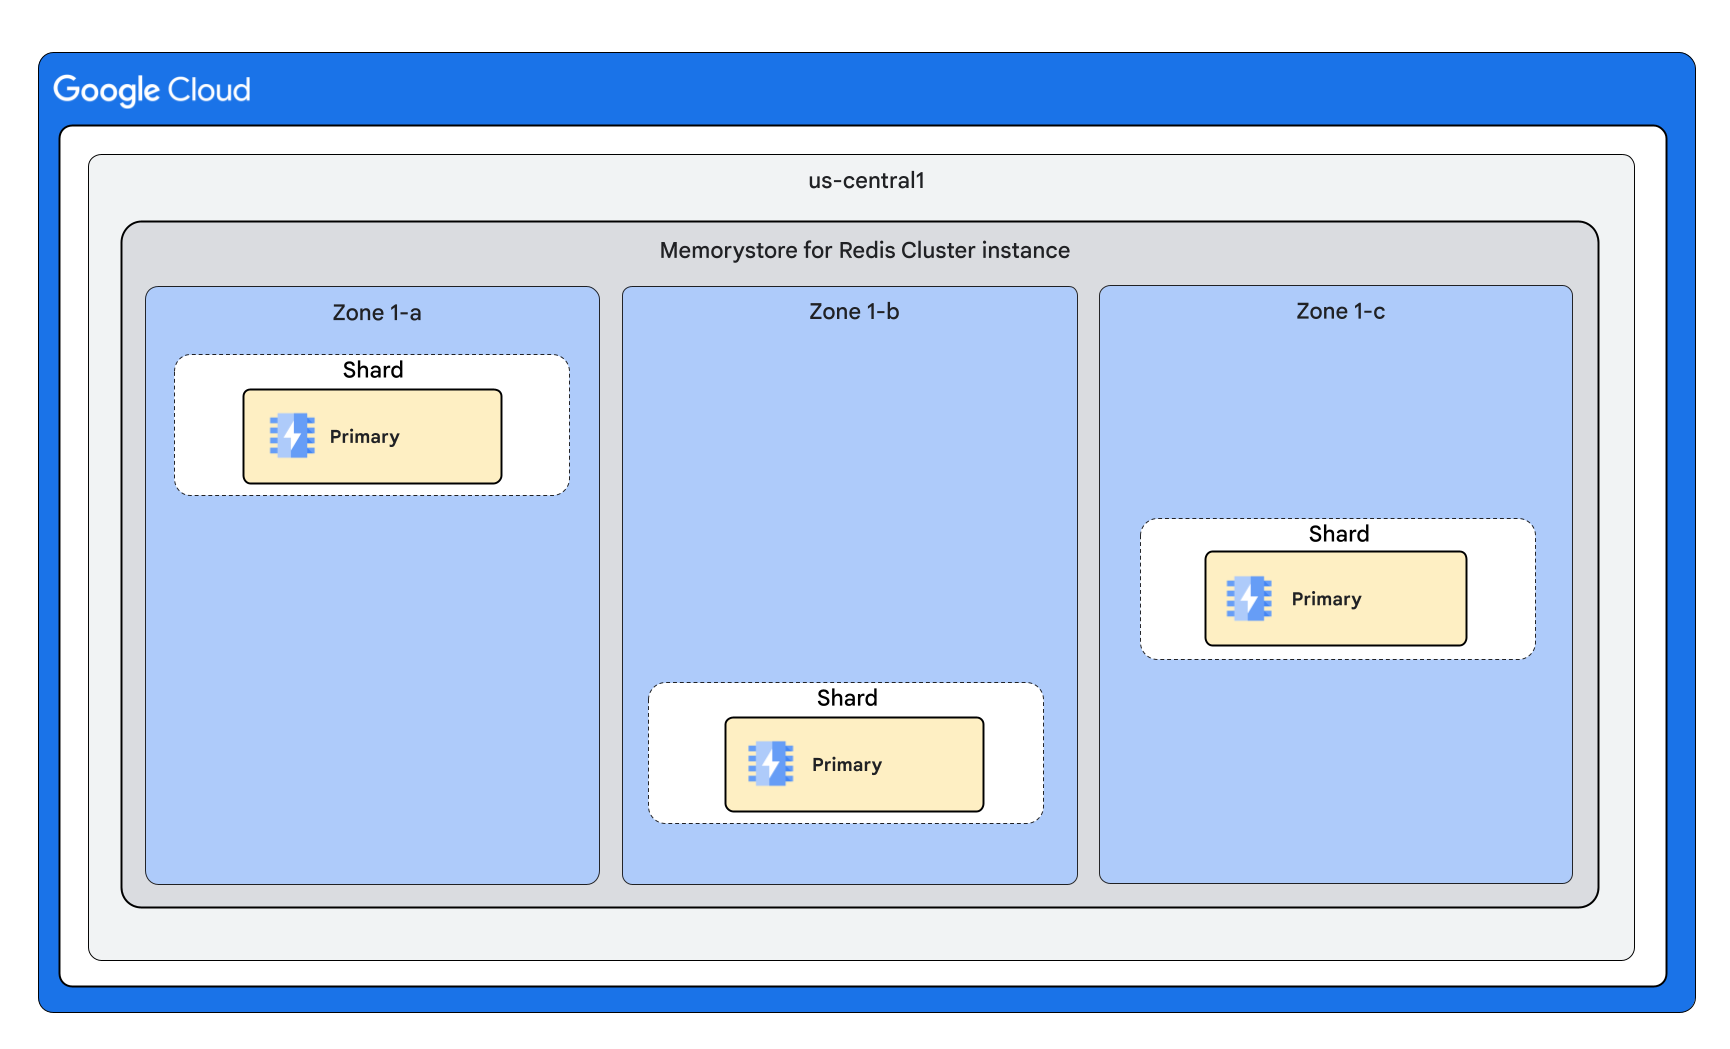
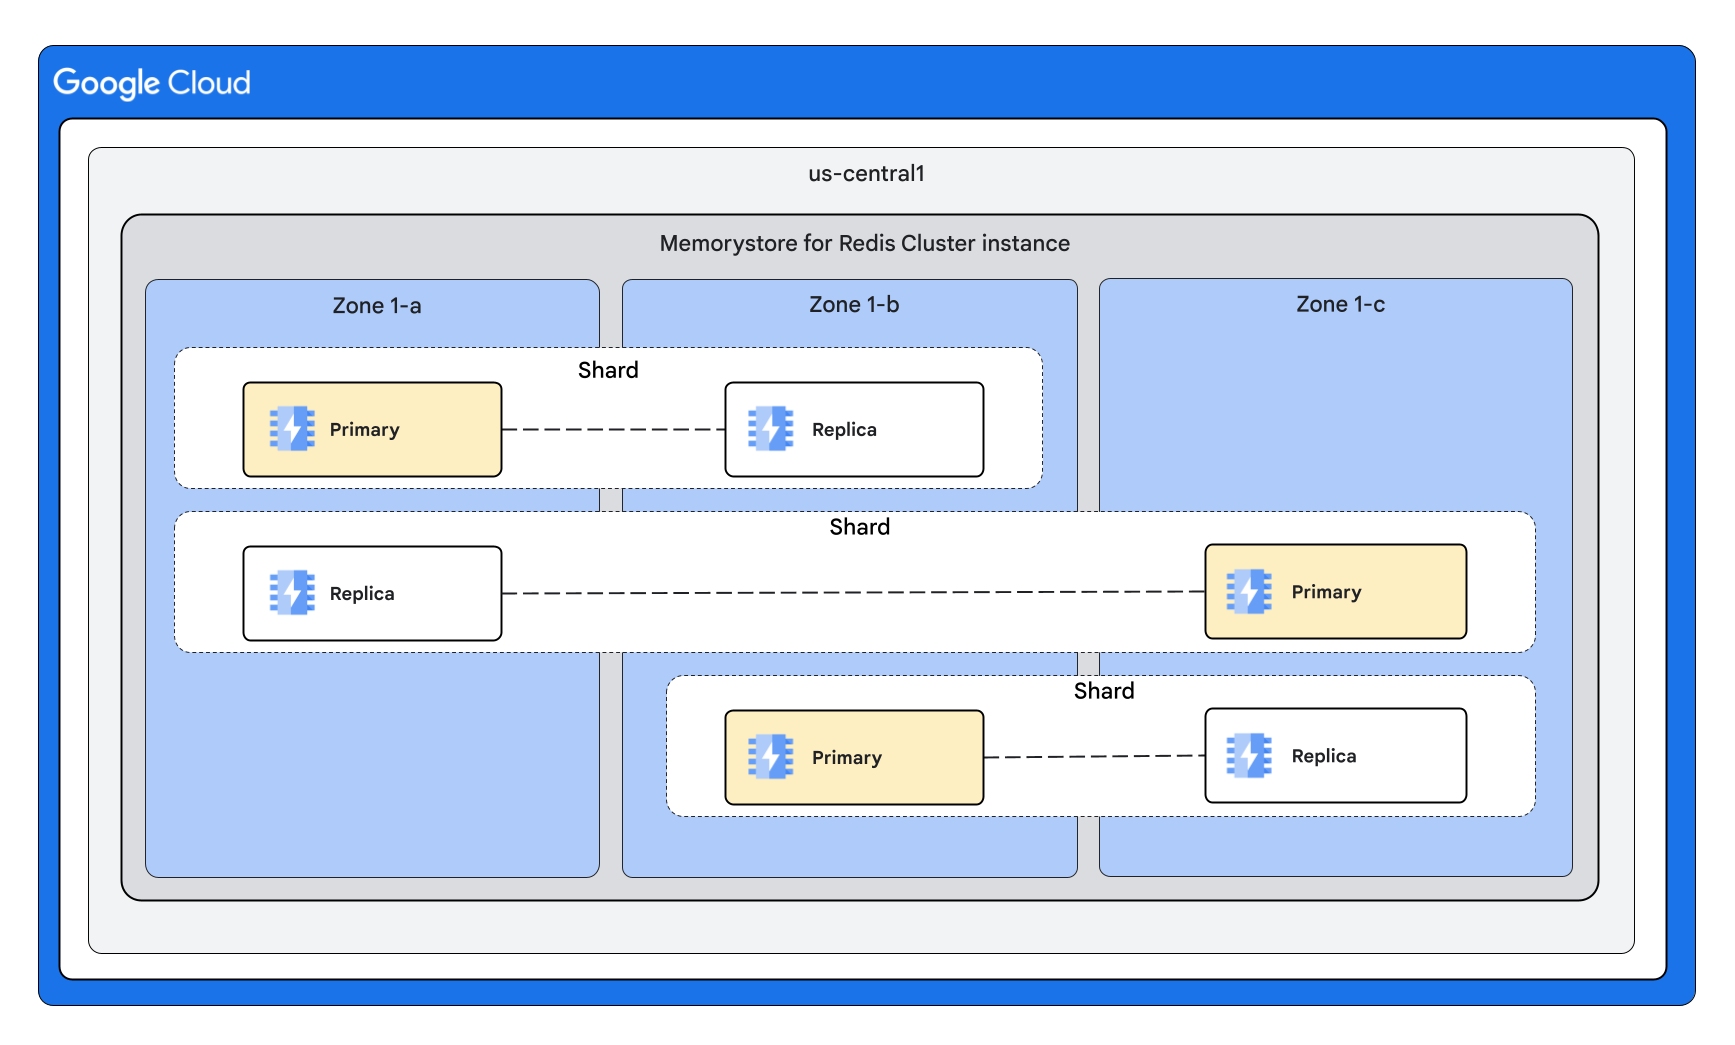
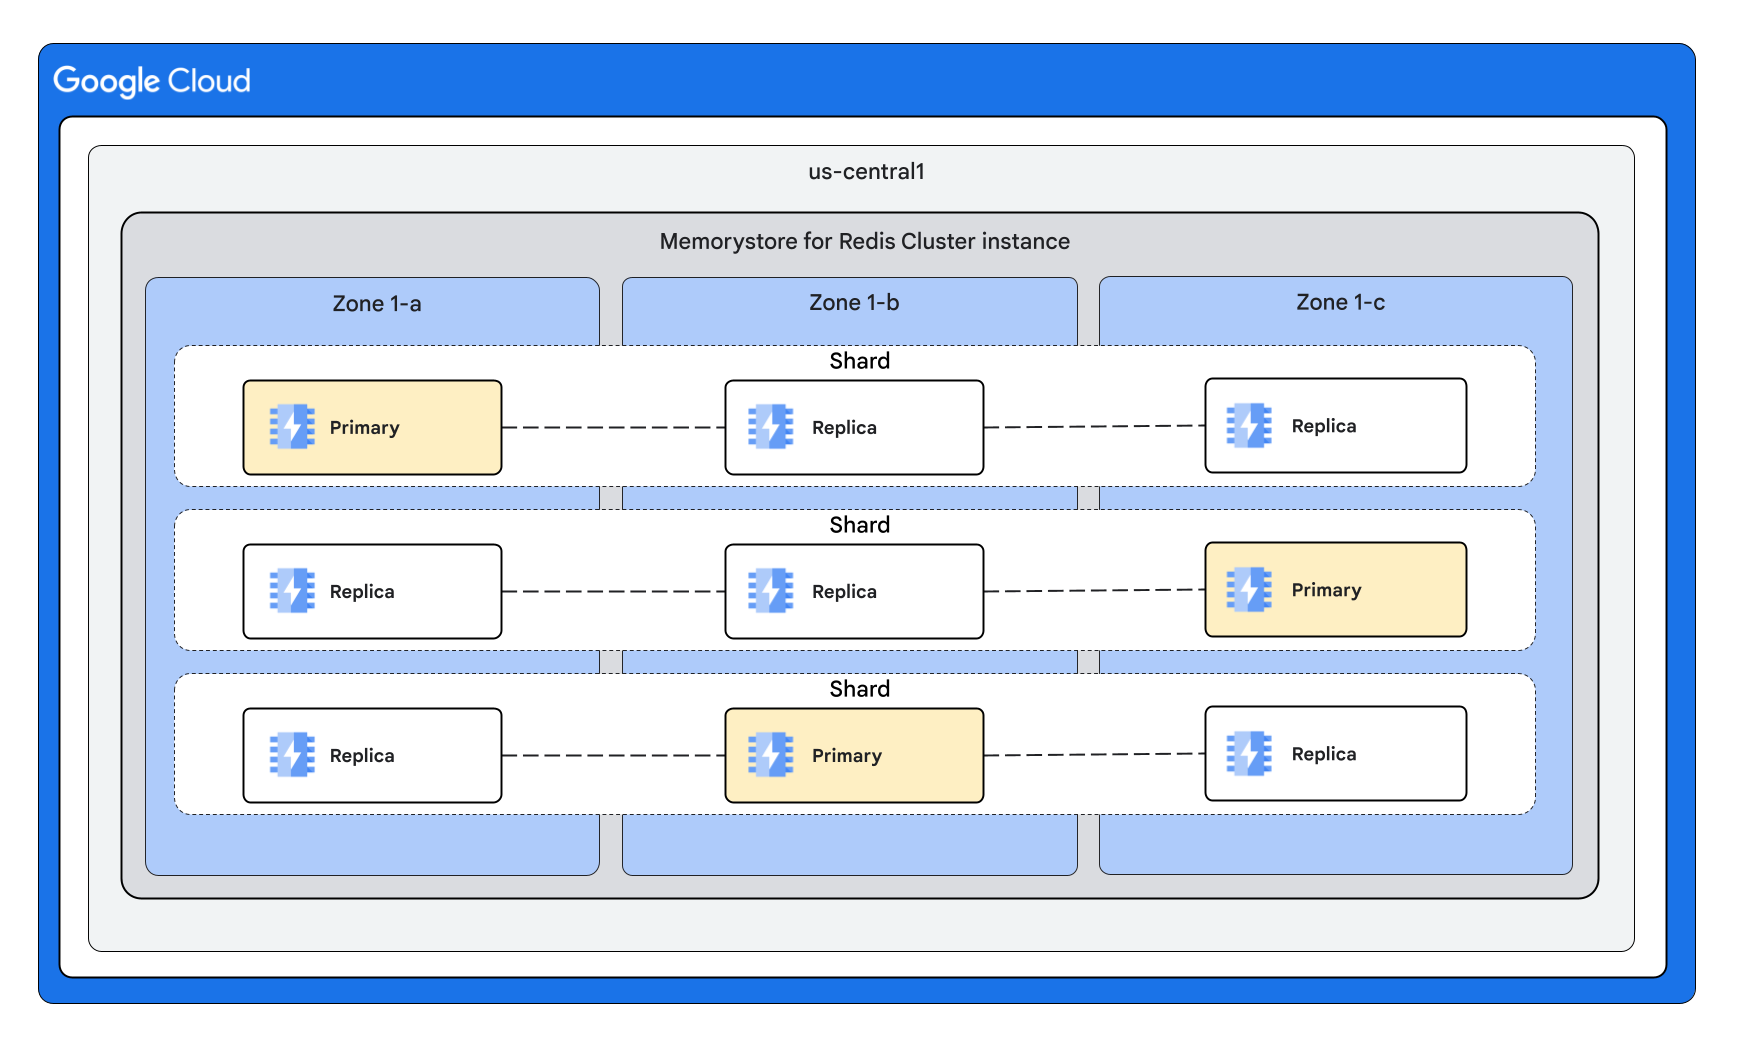
Une instance Memorystore pour Redis Cluster à disponibilité élevée est une ressource régionale. Cela signifie que les VM principales et répliquées des partitions sont réparties sur plusieurs zones pour se prémunir contre une panne zonale. Memorystore pour Redis Cluster est compatible avec les instances comportant entre 0 et 5 répliques par shard.
Vous pouvez utiliser des instances répliquées pour augmenter le débit de lecture en effectuant un scaling des lectures.
Pour ce faire, vous devez utiliser la commande READONLY afin d'établir une connexion qui permet à votre client de lire les répliques. Pour en savoir plus sur la lecture à partir de répliques, consultez Mettre à l'échelle avec Redis Cluster.
Exemple de cluster avec 0 réplique par shard
Exemple de cluster avec une instance répliquée par segment
Exemple de cluster avec plusieurs répliques par segment
Basculement automatique
Les basculements automatiques au sein d'un shard peuvent se produire en raison d'une maintenance ou d'une défaillance inattendue du nœud principal. Lors d'un basculement, une instance répliquée est promue en tant qu'instance principale. Vous pouvez configurer explicitement les instances répliquées. Le service peut également provisionner temporairement des réplicas supplémentaires lors de la maintenance interne pour éviter tout temps d'arrêt.
Les basculements automatiques empêchent la perte de données lors des mises à jour de maintenance. Pour en savoir plus sur le comportement du basculement automatique pendant la maintenance, consultez Comportement du basculement automatique pendant la maintenance.
Durée du basculement et de la réparation des nœuds
Les basculements automatiques peuvent prendre plusieurs dizaines de secondes en cas d'événements imprévus tels qu'un plantage du processus de nœud principal ou une défaillance matérielle. Pendant ce temps, le système détecte la défaillance et choisit une réplique pour devenir la nouvelle instance principale.
La réparation d'un nœud peut prendre plusieurs minutes pour que le service remplace le nœud défaillant. Cela s'applique à tous les nœuds principaux et de réplique. Pour les instances qui ne sont pas disponibilité élevée (aucune instance répliquée provisionnée), la réparation d'un nœud principal défaillant prend également quelques minutes.
Comportement du client lors d'un basculement non planifié
Les connexions client sont susceptibles d'être réinitialisées en fonction de la nature de l'échec. Après la récupération automatique, vous pouvez réessayer vos connexions avec un intervalle exponentiel entre les tentatives pour éviter de surcharger les nœuds principaux et répliqués.
Les clients qui utilisent des répliques pour le débit de lecture peuvent constater une dégradation temporaire de la capacité jusqu'à ce que le nœud défaillant soit automatiquement remplacé.
Écritures perdues
Lors d'un basculement résultant d'une défaillance inattendue, les écritures confirmées peuvent être perdues en raison de la nature asynchrone du protocole de réplication de Redis.
Les applications clientes peuvent utiliser la commande Redis WAIT pour améliorer la sécurité des données réelles. Il s'agit d'une approche au mieux qui comporte des compromis, comme expliqué dans la documentation de la commande Redis WAIT.
Impact d'une panne de zone unique sur l'espace de clés
Cette section décrit l'impact d'une panne dans une seule zone sur une instance Memorystore pour Redis Cluster.
Instances multizones
Instances à haute disponibilité : en cas de panne dans une zone, l'intégralité de l'espace de clés est disponible en lecture et en écriture, mais la capacité de lecture est réduite, car certaines instances dupliquées avec accès en lecture ne sont pas disponibles. Nous vous recommandons vivement de surprovisionner la capacité du cluster afin que l'instance dispose d'une capacité de lecture suffisante en cas de défaillance d'une seule zone, ce qui est rare. Une fois l'indisponibilité terminée, les réplicas de la zone concernée sont restaurés et la capacité de lecture du cluster revient à sa valeur configurée. Pour en savoir plus, consultez Modèles d'applications évolutives et fiables.
Instances non HA (sans réplicas) : en cas de panne dans une zone, la partie de l'espace de clés provisionnée dans la zone concernée fait l'objet d'un vidage des données et n'est pas disponible pour les opérations d'écriture ou de lecture pendant la durée de la panne. Une fois l'indisponibilité terminée, les nœuds principaux de la zone concernée sont restaurés et la capacité du cluster revient à sa valeur configurée.
Instances à zone unique
- Instances HD et non HD : si la zone dans laquelle l'instance est provisionnée est en panne, le cluster est indisponible et les données sont vidées. Si une autre zone subit une panne, le cluster continue de diffuser les requêtes de lecture et d'écriture. Une fois la panne terminée, la capacité configurée du cluster est restaurée.
Bonnes pratiques
Cette section décrit les bonnes pratiques concernant la haute disponibilité et les répliques.
Ajouter une réplique
L'ajout d'une instance répliquée nécessite un instantané RDB. Les instantanés RDB utilisent un fork de processus et un mécanisme de copie sur écriture pour prendre un instantané des données de nœud. En fonction du modèle d'écriture dans les nœuds, la mémoire utilisée par les nœuds augmente à mesure que les pages concernées par les écritures sont copiées. L'espace mémoire utilisé peut atteindre le double de la taille des données dans le nœud.
Pour vous assurer que les nœuds disposent de suffisamment de mémoire pour effectuer l'instantané, conservez ou définissez maxmemory à 80% de la capacité du nœud afin que 20% soient réservés aux frais généraux. Cette surcharge de mémoire, en plus des instantanés de surveillance, vous aide à gérer votre charge de travail pour obtenir des instantanés réussis. De plus, lorsque vous ajoutez des répliques, réduisez le trafic d'écriture autant que possible. Pour en savoir plus, consultez Surveiller un cluster avec une charge d'écriture élevée.