


Datensenken konfigurieren
In diesem Leitfaden wird beschrieben, wie Sie Datensenken in Manufacturing Data Engine (MDE) konfigurieren.
MDE unterstützt fünf Datensenken für Datensätze:
- BigQuery
- Cloud Storage
- Bigtable und Federation API
- Pub/Sub (JSON-Format)
- Pub/Sub (Protobuf-Format)
Datensatzpersistenz
Im Folgenden finden Sie ein Beispiel dafür, wie Sie einzelne Senken beim Erstellen eines Typs konfigurieren können:
REST
POST /configuration/v1/types
{
  "archetype": "<ARCHETYPE NAME>",
  "name": "<TYPE_NAME>",
  "metadataBuckets": [
    {
      "bucketName": "<BUCKET_NAME>",
      "version": "<BUCKET_VERSION>"
    }
  ],
  "storageSpecs": [
    {
      "sink": "BIG_QUERY",
      "disabled": "false",
      "materializeCloudMetadata": "false"
    },
    {
      "sink": "BIG_TABLE",
      "disabled": "false",
      "materializeCloudMetadata": "false"
    },
    {
      "sink": "GCS",
      "disabled": "false",
      "materializeCloudMetadata": "false"
    },
    {
      "sink": "PUBSUB_PROTO",
      "disabled": "false",
      "materializeCloudMetadata": "false"
    },
    {
      "sink": "PUBSUB_JSON",
      "disabled": "false",
      "materializeCloudMetadata": "false"
    }
  ]
}
Ersetzen Sie Folgendes:
ARCHETYPE: Name des Archetyps. Einer vonDISCRETE_DATA_SERIES,CLUSTERED_DISCRETE_DATA_SERIES,NUMERIC_DATA_SERIES,CLUSTERED_NUMERIC_DATA_SERIES,CONTINUOUS_DATA_SERIES,CLUSTERED_CONTINUOUS_DATA_SERIES.TYPE_NAME: Name des zu erstellenden Typs.BUCKET_NAME: Name des Buckets, der mit diesem Typ verknüpft werden soll.BUCKET_VERSION: Version des Buckets, der mit diesem Typ verknüpft werden soll.
Console
Öffnen Sie im Web interface den Bereich CLOUD-TAGS , um die Einstellung für die Datensatzpersistenz für ein bestimmtes Tag zu ändern:

Klicken Sie für das Tag, für das Sie die Persistenzeinstellungen ändern möchten, auf das Symbol Aktionen.
Wählen Sie die Option Ansehen / Bearbeiten aus. Die folgende Seitenleiste wird angezeigt:

Maximieren Sie den Bereich Speichereinstellungen. Die Liste aller verfügbaren Persistenzsenken wird mit einer Umschaltfläche neben jeder Senke angezeigt:

Wählen Sie die Senken aus, die für das Tag aktiv sind. Alle für dieses Tag aufgenommenen Datensätze werden in allen ausgewählten Senken gespeichert.
Ebenso können Sie Senken konfigurieren, wenn Sie eine neue Version für einen vorhandenen Typ erstellen. Hier ein Beispiel:
REST
POST /configuration/v1/types/TYPE_NAME/versions
{
  "metadataBuckets": [
    {
      "bucketName": "EXISTING_BUCKET_NAME",
      "version": "EXISTING_BUCKET_VERSION"
    },
    {
      "bucketName": "NEW_BUCKET_NAME",
      "version": "NEW_BUCKET_VERSION"
    }
  ],
  "storageSpecs": [
    {
      "sink": "BIG_QUERY",
      "disabled": "false",
      "materializeCloudMetadata": "true"
    },
    {
      "sink": "BIG_TABLE",
      "disabled": "false",
      "materializeCloudMetadata": "false"
    },
    {
      "sink": "GCS",
      "disabled": "false",
      "materializeCloudMetadata": "false"
    },
    {
      "sink": "PUBSUB_PROTO",
      "disabled": "false",
      "materializeCloudMetadata": "false"
    },
    {
      "sink": "PUBSUB_JSON",
      "disabled": "false",
      "materializeCloudMetadata": "false"
    }
  ]
}
Ersetzen Sie Folgendes:
TYPE_NAME: Name des Typs, für den eine neue Version erstellt wirdEXISTING_BUCKET_NAME: Name des vorhandenen Buckets, der bereits mit diesem Typ verknüpft ist.EXISTING_BUCKET_VERSION: Version des vorhandenen Buckets, der bereits mit diesem Typ verknüpft ist.NEW_BUCKET_NAME: Name des neuen Buckets.NEW_BUCKET_VERSION: Version des neuen Buckets.
Console
Öffnen Sie im oberen Menü den Bereich TYPEN , um die Speichereinstellungen auf Typebene zu ändern:
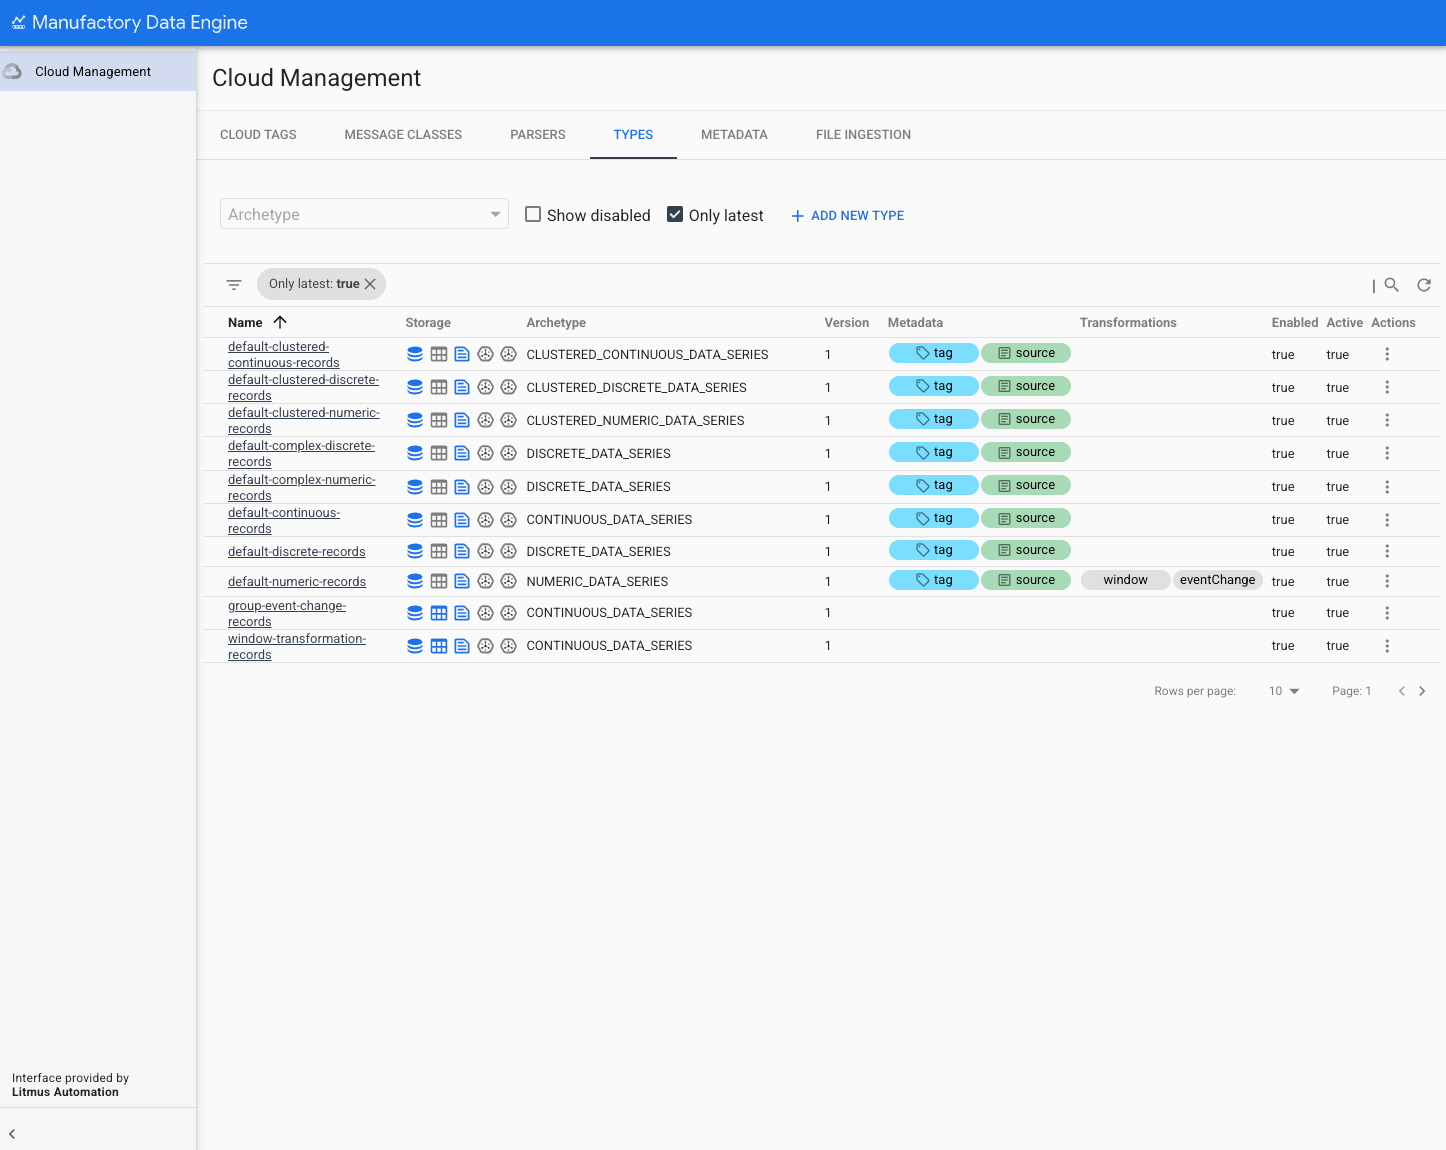
Wählen Sie im Symbol Aktionen des Typs , den Sie bearbeiten möchten, die Option Ansehen / Bearbeiten aus. Das seitliche Menü Typversion bearbeiten wird angezeigt.
Maximieren Sie den Bereich Speichereinstellungen , um auf die Persistenzeinstellungen für den Typ zuzugreifen:
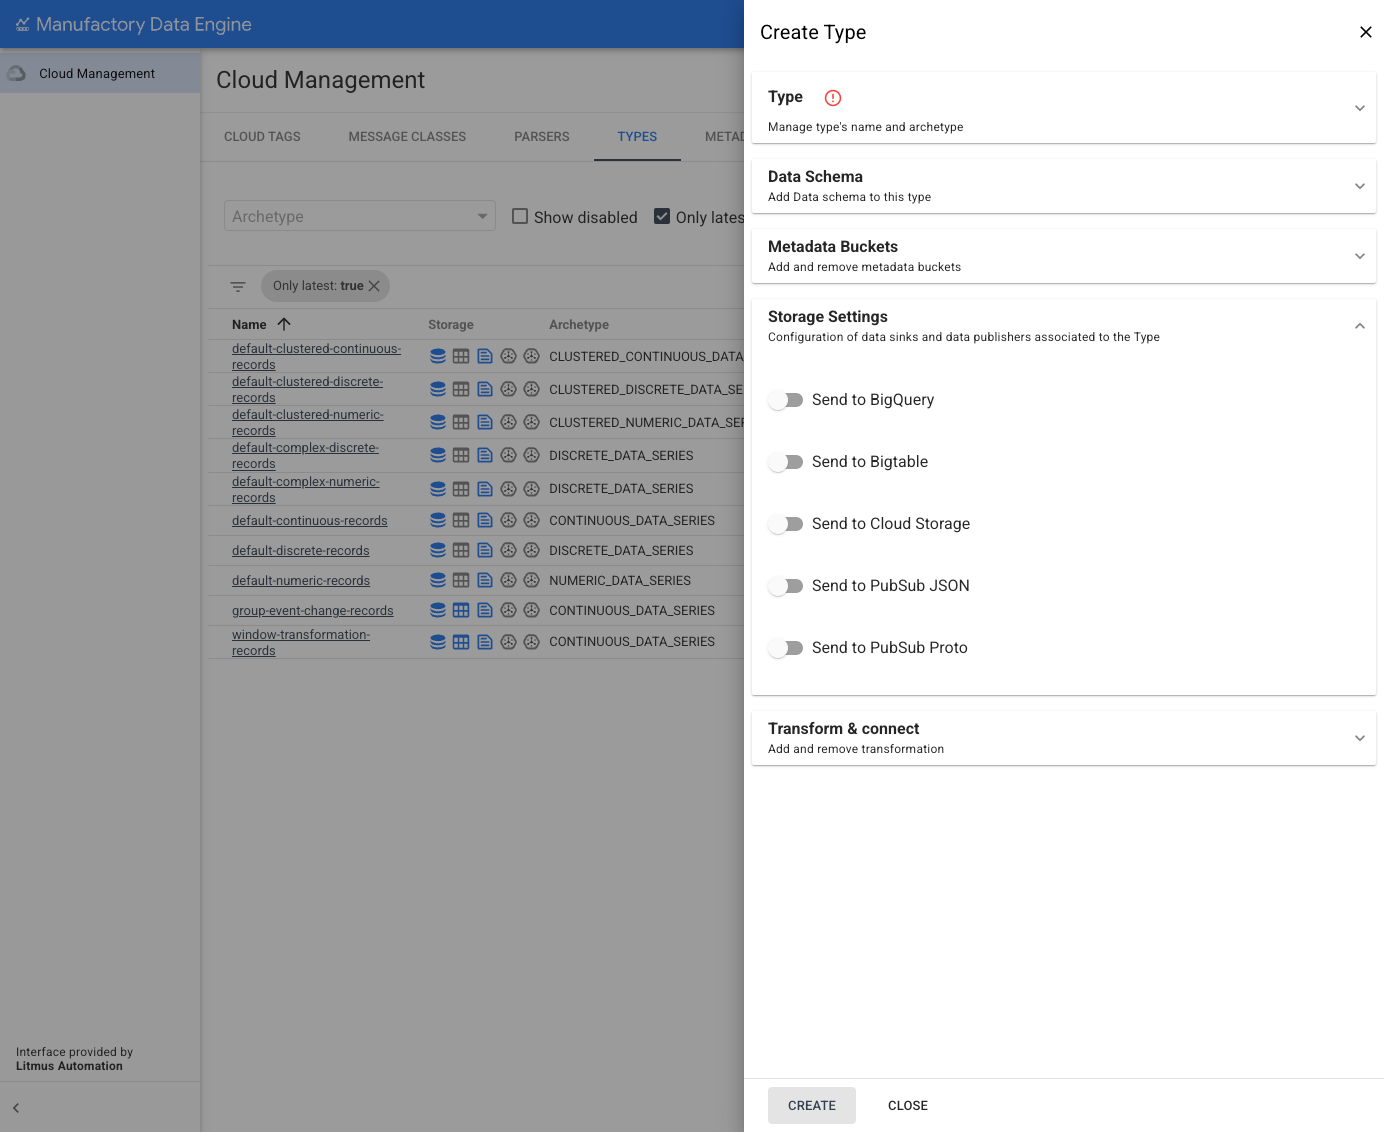
Wählen Sie jede Senke aus, in der die Datensätze der zu diesem Typ gehörenden Tags standardmäßig gespeichert werden. Die Speicherspezifikation wird von den Tags beim Erstellen übernommen. Die Speicherspezifikation kann jederzeit auf Tag-Ebene geändert werden.
Materialisierung von Metadateninstanzen
Die Materialisierung von Metadateninstanzen kann für jede Senke einzeln konfiguriert werden. Weitere Informationen finden Sie unter Instanzmaterialisierung.
Standardmäßige Speicherspezifikationen für Typversionen für einzelne Tags überschreiben
Sie können auch die standardmäßigen Speicherspezifikationen für eine Typversion für einzelne Tags überschreiben. Das bedeutet, dass die Tag-Konfigurationseinstellungen für eine Typversion die Standardeinstellungen für diese Typversion überschreiben.
Senkenspezifische Überlegungen
In den folgenden Abschnitten werden einige senkenspezifische Überlegungen erläutert:
BigQuery
Wenn Sie einen Datentyp erstellen, erstellt MDE automatisch eine neue Tabelle dafür im Dataset mde_data. Sie können konfigurieren, ob Datensätze in dieser Tabelle gespeichert werden, indem Sie die BigQuery-Senke für eine Typversion oder ein Tag für eine Typversion aktivieren.
Bigtable Federation API
Wenn Sie einen Bigtable-Cluster bereitgestellt haben, können Sie konfigurieren, ob Datensätze in Bigtable gespeichert werden, damit Sie mit der Federation API darauf zugreifen können.
Cloud-Metadateninstanzen werden nicht eigenständig in Bigtable gespeichert.
Wenn Sie Cloud-Metadaten in Datensätzen benötigen, die Sie mit der Federation API aus Bigtable abrufen, müssen Sie den Wert von materializeCloudMetadata für die Bigtable-Senke auf true setzen.
Cloud Storage
Datensätze werden in einem Cloud Storage-Bucket namens
<project_id>-gcs-ingestion in AVRO-Dateien mit Hive-Partitionierung gespeichert. Dabei wird ein 10
Minuten-Fenster und 10 Partitionen pro Fenster verwendet. Datensätze werden nach Typ in Ordnern gruppiert. Cloud-Metadateninstanzen werden nicht eigenständig an die Cloud Storage-Senke gesendet. Wenn Sie Cloud-Metadaten in Datensätzen in Cloud Storage benötigen, müssen Sie den Wert von materializeCloudMetadata für die Cloud Storage-Senke auf true setzen.
Pub/Sub: Proto und JSON
MDE bietet zwei Varianten der Pub/Sub-Senke: eine, die Datensätze im JSON-Datenformat bereitstellt, und eine andere, die Nachrichten im Protobuf-Datenformat bereitstellt. Die entsprechenden Datenschemas finden Sie im Referenzabschnitt.
Der im JSON-Format formatierte Datensatzstream wird an das Pub/Sub-Thema mde-tag-stream-json gesendet und der im Protobuf-Format formatierte Datensatzstream an mde-tag-stream-proto. Cloud-Metadateninstanzen werden nicht an die entsprechenden Pub/Sub-Themen gesendet. Wenn Sie Cloud-Metadaten in Datensätzen benötigen, die an Pub/Sub gesendet werden, müssen Sie den Wert von materializeCloudMetadata für die Pub/Sub-Senken auf true setzen.
Wenn die Pub/Sub-Senken nicht explizit für einen Typ aktiviert werden, sind sie standardmäßig deaktiviert.
Persistenz von Metadaten, Logs und Konfigurationsdaten
MDE speichert Metadateninstanzen, Logs und Konfigurationsdaten immer in den Datasets mde_dimension und mde_system in BigQuery. Außerdem speichert MDE immer Rohquellnachrichten in Cloud Storage. Die Persistenz dieser Daten kann nicht deaktiviert werden.