


在大型主機上本機轉碼資料是 CPU 密集型程序,會導致每秒百萬指令數 (MIPS) 消耗量偏高。為避免這種情況,您可以使用 Cloud Run 在Google Cloud上遠端移動及轉碼大型主機資料。這樣一來,大型主機就能釋出資源,用於處理業務上的重要工作,同時也能減少 MIPS 用量。
如果您想將大量資料 (每天約 500 GB 以上) 從主機轉移至 Google Cloud,但不想使用主機來執行這項作業,可以使用支援雲端的虛擬磁帶庫 (VTL) 解決方案,將資料傳輸至 Cloud Storage 儲存桶。接著,您可以使用 Cloud Run 將儲存桶中的資料轉碼,並移至 BigQuery。
本頁面說明如何讀取複製到 Cloud Storage 儲存桶的大型主機資料,並將其從擴充二進位元編碼十進位元交換碼 (EBCDIC) 資料集轉碼為 UTF-8 的 ORC 格式,然後將資料集載入 BigQuery 資料表。
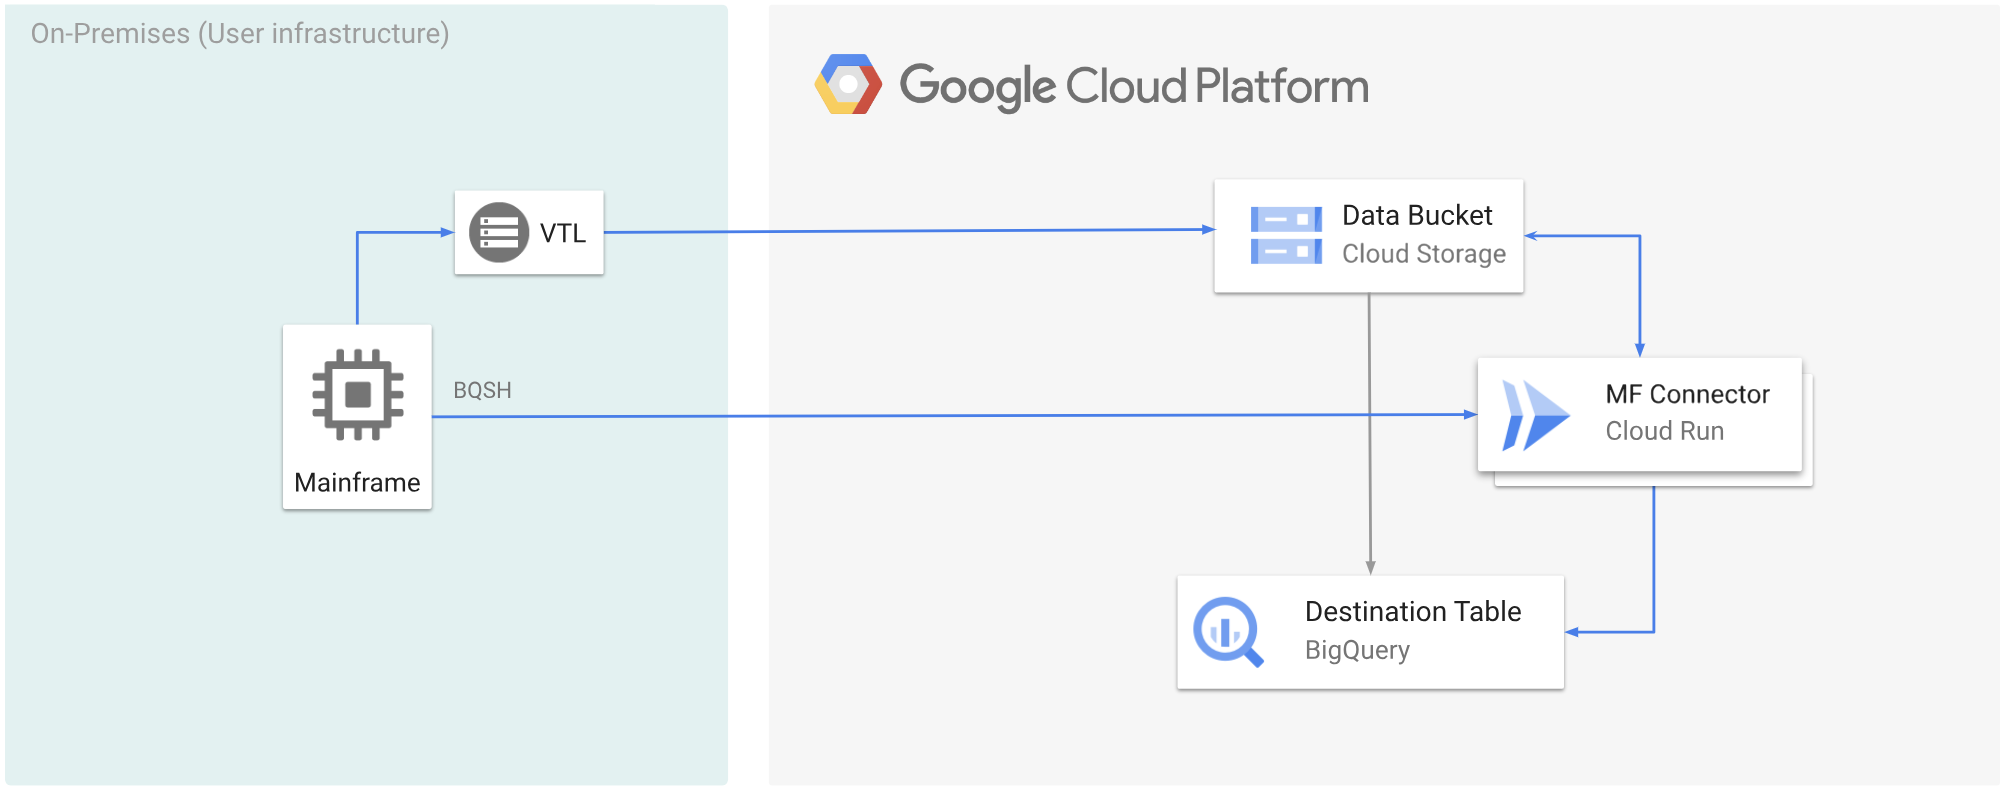
下圖說明如何使用 VTL 解決方案將大型主機資料移至 Cloud Storage 值區、使用 Cloud Run 將資料轉碼為 ORC 格式,然後將內容移至 BigQuery。
事前準備
- 請選擇符合需求的 VTL 解決方案,並將大型主機資料移至 Cloud Storage 值區,並儲存為
.dat。請務必將名為x-goog-meta-lrecl的中繼資料鍵新增至已上傳的.dat檔案,且中繼資料鍵長度必須與原始檔案的記錄長度相同,例如 80。 - 在 Cloud Run 部署 Mainframe Connector。
- 在主機電腦中,將
GCSDSNURI環境變數設為 Cloud Storage 值區中主機電腦資料的前置字串。export GCSDSNURI="gs://BUCKET/PREFIX"
- BUCKET:Cloud Storage 值區的名稱。
- PREFIX:您要在值區中使用的前置字串。
- 建立服務帳戶或識別要與 Mainframe Connector 搭配使用的現有服務帳戶。此服務帳戶必須具備存取 Cloud Storage 值區、BigQuery 資料集和您要使用的任何其他 Google Cloud 資源的權限。
- 確認您建立的服務帳戶已獲派 Cloud Run 叫用者角色。
將上傳至 Cloud Storage 值區的大型主機資料轉碼
如要使用 VTL 和遠端轉碼功能將大型主機資料移至 Google Cloud ,您必須執行下列工作:
- 讀取 Cloud Storage 值區中的資料,並將資料轉碼為 ORC 格式。轉碼作業會將大型主機 EBCDIC 資料集轉換為 UTF-8 中的 ORC 格式。
- 將資料集載入 BigQuery 資料表。
- (選用) 對 BigQuery 資料表執行 SQL 查詢。
- (選用) 將資料從 BigQuery 匯出至 Cloud Storage 中的二進位檔案。
如要執行這些工作,請按照下列步驟操作:
在大型主機中建立工作,讀取 Cloud Storage 儲存桶中的
.dat檔案資料,並將資料轉碼為 ORC 格式,如下所示。如需 Mainframe Connector 支援的完整環境變數清單,請參閱「環境變數」。
//STEP01 EXEC BQSH
//COPYBOOK DD DISP=SHR,DSN=<HLQ>.COPYBOOK.FILENAME
//STDIN DD *
gsutil cp --replace gs://mybucket/tablename.orc \
--inDsn INPUT_FILENAME \
--remoteHost <mainframe-connector-url>.a.run.app \
--remotePort 443 \
--project_id PROJECT_NAME
/*
更改下列內容:
PROJECT_NAME:您要執行查詢的專案名稱。INPUT_FILENAME:您上傳至 Cloud Storage 值區的.dat檔案名稱。
如要記錄在這項程序中執行的指令,可以啟用載入統計資料。
(選用) 建立並提交 BigQuery 查詢工作,執行從 QUERY DD 檔案讀取的 SQL。通常,查詢會是
MERGE或SELECT INTO DML陳述式,可轉換 BigQuery 資料表。請注意,Mainframe Connector 會記錄工作指標,但不會將查詢結果寫入檔案。您可以透過各種方式查詢 BigQuery,包括內嵌式查詢、使用 DD 的獨立資料集,或使用 DSN 的獨立資料集。
Example JCL
//STEP03 EXEC BQSH
//QUERY DD DSN=<HLQ>.QUERY.FILENAME,DISP=SHR
//STDIN DD *
PROJECT=PROJECT_NAME
LOCATION=LOCATION
bq query --project_id=$PROJECT \
--location=$LOCATION/*
/*
更改下列內容:
PROJECT_NAME:您要執行查詢的專案名稱。LOCATION:查詢執行的位置。建議您在靠近資料的位置執行查詢。
(選用) 建立並提交匯出工作,執行從 QUERY DD 檔案讀取的 SQL,並將產生的資料集以二進位檔的形式匯出至 Cloud Storage。
Example JCL
//STEP04 EXEC BQSH
//OUTFILE DD DSN=<HLQ>.DATA.FILENAME,DISP=SHR
//COPYBOOK DD DISP=SHR,DSN=<HLQ>.COPYBOOK.FILENAME
//QUERY DD DSN=<HLQ>.QUERY.FILENAME,DISP=SHR
//STDIN DD *
PROJECT=PROJECT_NAME
DATASET_ID=DATASET_ID
DESTINATION_TABLE=DESTINATION_TABLE
BUCKET=BUCKET
bq export --project_id=$PROJECT \
  --dataset_id=$DATASET_ID \
  --destination_table=$DESTINATION_TABLE \
  --location="US" \
  --bucket=$BUCKET \
  --remoteHost <mainframe-connector-url>.a.run.app \
  --remotePort 443
/*
更改下列內容:
PROJECT_NAME:您要執行查詢的專案名稱。DATASET_ID:包含要匯出的資料表的 BigQuery 資料集 ID。DESTINATION_TABLE:要匯出的 BigQuery 資料表。BUCKET:包含輸出二進位檔的 Cloud Storage 值區。