


Nutzung
explore: explore_name {
  join: view_name { ... }
}
|
Hierarchie
join |
Standardwert
Keine
Akzeptiert
Der Name einer vorhandenen Ansicht
Sonderregeln
|
Definition
Mit join können Sie die Join-Beziehung zwischen einem Explore und einer Ansicht definieren, um Daten aus mehreren Ansichten zu kombinieren. Sie können beliebig viele Ansichten für ein bestimmtes Explore verknüpfen.
Jede Ansicht ist einer Tabelle in Ihrer Datenbank oder einer abgeleiteten Tabelle zugeordnet, die Sie in Looker definiert haben. Da ein Explore mit einer Ansicht verknüpft ist, ist es auch mit einer Tabelle verbunden.
Die dem Explore zugeordnete Tabelle wird in die FROM-Anweisung des von Looker generierten SQL-Codes eingefügt. Tabellen, die mit zusammengeführten Ansichten verknüpft sind, werden in die JOIN-Anweisung des von Looker generierten SQL-Codes eingefügt.
Wichtige Join-Parameter
Um die Join-Beziehung (die SQL-ON-Klausel) zwischen einem Explore und einer Ansicht zu definieren, müssen Sie join in Kombination mit anderen Parametern verwenden.
Sie müssen entweder den Parameter sql_on oder den Parameter foreign_key verwenden, um die SQL-Anweisung ON festzulegen.
Außerdem müssen Sie darauf achten, dass Sie die richtigen Join-Typen und Beziehungen verwenden. Die Parameter type und relationship sind jedoch nicht immer explizit erforderlich. Wenn die Standardwerte type: left_outer und relationship: many_to_one für Ihren Anwendungsfall geeignet sind, können Sie diese Parameter ausschließen.
Diese wichtigen Parameter und ihre Beziehung zum SQL-Code, den Looker generiert, lassen sich so zusammenfassen:
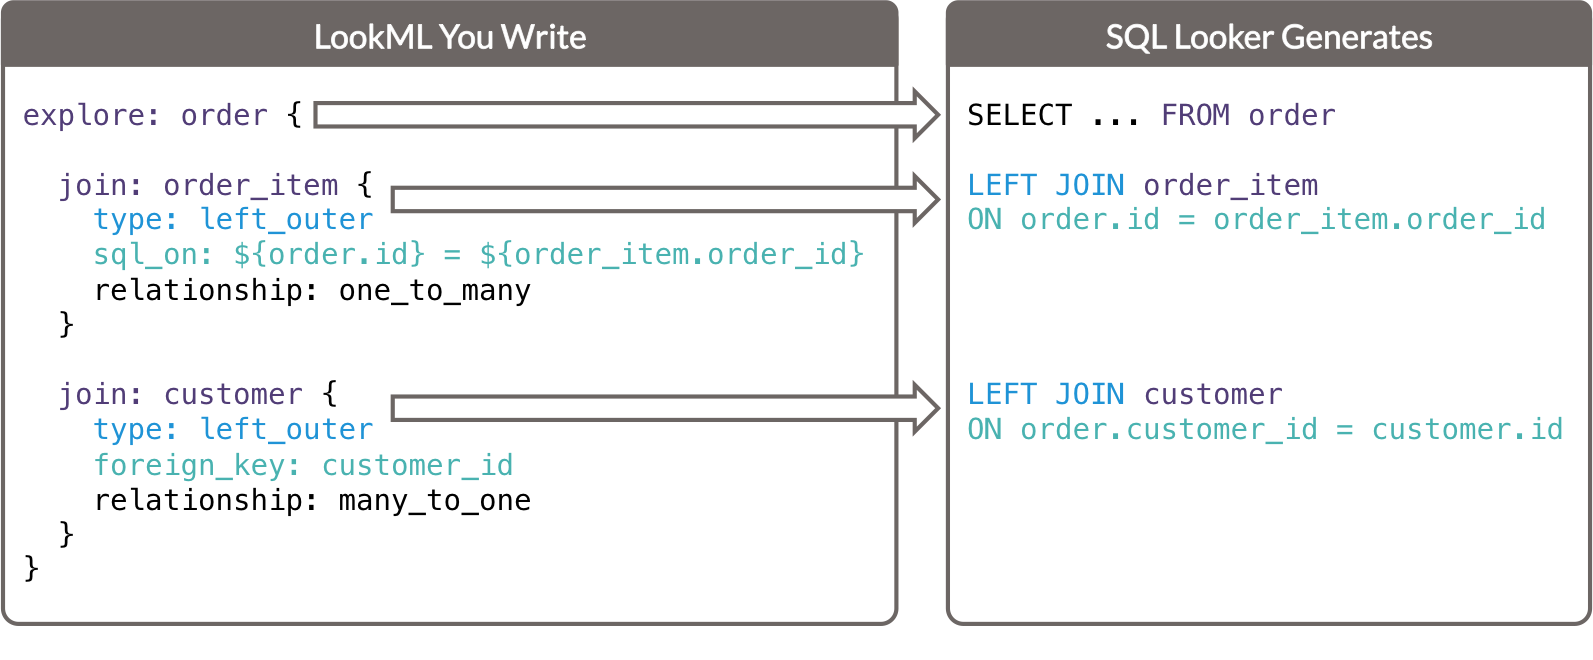
- Mit dem Parameter
explorewird die Tabelle in derFROM-Anweisung der generierten SQL-Abfrage festgelegt. - Jeder
join-Parameter bestimmt eineJOIN-Anweisung der generierten SQL-Abfrage.- Der Parameter
typebestimmt den Typ des SQL-Joins. - Die Parameter
sql_onundforeign_keybestimmen dieON-Klausel der generierten SQL-Abfrage.
- Der Parameter
sql_on
Mit sql_on können Sie eine Join-Beziehung herstellen, indem Sie die SQL-Anweisung ON direkt schreiben. Damit lassen sich dieselben Joins wie mit foreign_key ausführen, aber sie sind leichter zu lesen und zu verstehen.
Weitere Informationen finden Sie auf der Dokumentationsseite zum Parameter sql_on.
foreign_key
Mit foreign_key können Sie eine Join-Beziehung mit dem Primärschlüssel der verbundenen Ansicht herstellen und sie mit einer Dimension im Explore verbinden. Dieses Muster ist im Datenbankdesign sehr häufig und foreign_key ist eine elegante Möglichkeit, den Join in diesen Fällen auszudrücken.
Weitere Informationen finden Sie auf der Dokumentationsseite zum Parameter foreign_key.
type
Die meisten Joins in Looker sind LEFT JOIN. Die Gründe dafür werden im Abschnitt Geschäftslogik nach Möglichkeit nicht in Joins anwenden auf dieser Seite erläutert. Wenn Sie also kein type explizit hinzufügen, geht Looker davon aus, dass Sie ein LEFT JOIN wünschen. Wenn Sie aus irgendeinem Grund einen anderen Join-Typ benötigen, können Sie type verwenden.
Eine ausführliche Erklärung finden Sie auf der Dokumentationsseite zum Parameter type.
relationship
relationship hat keine direkten Auswirkungen auf den von Looker generierten SQL-Code, ist aber entscheidend für das ordnungsgemäße Funktionieren von Looker. Wenn Sie nicht explizit relationship hinzufügen, interpretiert Looker die Beziehung als many-to-one. Das bedeutet, dass viele Zeilen im Explore eine Zeile in der verknüpften Ansicht haben können. Nicht alle Joins haben diese Art von Beziehung und Joins mit anderen Beziehungen müssen richtig deklariert werden.
Weitere Informationen finden Sie auf der Dokumentationsseite zum Parameter relationship.
Beispiele
Verknüpfen Sie die Ansicht mit dem Namen customer mit dem Explore mit dem Namen order, wobei die Verknüpfungsbeziehung
FROM order LEFT JOIN customer ON order.customer_id = customer.id:
explore: order {
  join: customer {
    foreign_key: customer_id
    relationship: many_to_one # Could be excluded since many_to_one is the default
    type: left_outer          # Could be excluded since left_outer is the default
  }
}
Verknüpfen Sie die Ansicht mit dem Namen address mit dem Explore mit dem Namen person, wobei die Verknüpfungsbeziehung
FROM person LEFT JOIN address ON person.id = address.person_id
AND address.type = 'permanent':
explore: person {
  join: address {
    sql_on: ${person.id} = ${address.person_id} AND ${address.type} = 'permanent' ;;
    relationship: one_to_many
    type: left_outer # Could be excluded since left_outer is the default
  }
}
Verknüpfen Sie die Ansicht mit dem Namen member mit dem Explore mit dem Namen event, wobei die Verknüpfungsbeziehung
FROM event INNER JOIN member ON member.id = event.member_id:
explore: event {
  join: member {
    sql_on: ${event.member_id} = ${member.id} ;;
    relationship: many_to_one # Could be excluded since many_to_one is the default
    type: inner
  }
}
Häufige Herausforderungen
join muss Ansichtsnamen und nicht zugrunde liegende Tabellennamen verwenden.
Für den Parameter join ist nur ein Datenansichtsname zulässig, nicht der mit dieser Datenansicht verknüpfte Tabellenname. Häufig sind der Ansichtsname und der Tabellenname identisch, was zu dem falschen Schluss führen kann, dass Tabellennamen verwendet werden können.
Für einige Arten von Measures sind symmetrische Aggregate erforderlich
Wenn Sie keine symmetrischen Aggregate verwenden, sind die meisten Messwerttypen in Ansichten mit Joins ausgeschlossen. Damit Looker symmetrische Summen in Ihrem Looker-Projekt unterstützen kann, müssen diese auch von Ihrem Datenbankdialekt unterstützt werden. In der folgenden Tabelle ist zu sehen, welche Dialekte symmetrische Aggregate in der aktuellen Looker-Version unterstützen:
| Dialekt | Unterstützt? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |
Ohne symmetrische Aggregate können Join-Beziehungen, die nicht 1:1 sind, zu ungenauen Ergebnissen in Aggregatfunktionen führen. Da Looker-Measures Aggregatfunktionen sind, werden nur Measures von type: count (als COUNT DISTINCT) aus verknüpften Ansichten in das Explore übernommen. Wenn Sie eine 1:1-Join-Beziehung haben, können Sie den Parameter relationship verwenden, um die Einbeziehung der anderen Messwerttypen zu erzwingen:
explore: person {
  join: dna {
    sql_on: ${person.dna_id} = ${dna.id} ;;
    relationship: one_to_one
  }
}
Die Gründe dafür, dass Looker so funktioniert (für Dialekte, die keine symmetrischen Aggregate unterstützen), werden im Community-Beitrag The problem of SQL fanouts (Das Problem von SQL-Fanouts) ausführlicher erläutert.
Wichtige Punkte
Sie können dieselbe Tabelle mit from mehrmals verknüpfen.
Wenn eine einzelne Tabelle verschiedene Arten von Entitäten enthält, kann eine Ansicht mehr als einmal mit einem Explore verknüpft werden. Dazu müssen Sie den Parameter from verwenden. Angenommen, Sie haben eine order-Schaltfläche und müssen sie zweimal mit einer person-Ansicht verknüpfen: einmal für den Kunden und einmal für den Kundenservicemitarbeiter. Das könnte dann folgendermaßen aussehen:
explore: order {
  join: customer {
    from: person
    sql_on: ${order.customer_id} = ${customer.id} ;;
  }
  join: representative {
    from: person
    sql_on: ${order.representative_id} = ${representative.id} ;;
  }
}
Geschäftslogik nach Möglichkeit nicht in Joins anwenden
Beim standardmäßigen Looker-Ansatz für Joins wird nach Möglichkeit ein LEFT JOIN verwendet. Wenn Sie etwas in dieser Art tun, sollten Sie einen anderen Ansatz in Betracht ziehen:
explore: member_event {
  from: event
  always_join: [member]
  join: member {
    sql_on: ${member_event.member_id} = ${member.id} ;;
    type: inner
  }
}
In diesem Beispiel haben wir einen Explore-Bereich erstellt, in dem nur Ereignisse im Zusammenhang mit bekannten Mitgliedern berücksichtigt werden. Die bevorzugte Methode, dies in Looker auszuführen, ist jedoch die Verwendung von LEFT JOIN, um Ereignisdaten und Mitgliedsdaten zusammenzufügen:
explore: event {
  join: member {
    sql_on: ${event.member_id} = ${member.id} ;;
  }
}
Anschließend erstellen Sie eine Dimension, die Sie auf yes oder no festlegen können, wenn Sie sich nur Mitgliederereignisse ansehen möchten:
dimension: is_member_event {
  type: yesno
  sql: ${member.id} IS NOT NULL ;;
}
Diese Vorgehensweise ist vorzuziehen, da Nutzer so die Möglichkeit haben, sich entweder alle Ereignisse oder nur Mitgliedereignisse anzusehen. Sie haben sie nicht gezwungen, sich nur Mitgliederevents anzusehen.
Wenn Sie keine symmetrischen Aggregationen verwenden, sollten Sie Joins vermeiden, die Fanouts verursachen.
Dieser Abschnitt gilt nur für Datenbankdialekte, die symmetrische Aggregationen nicht unterstützen. Im Abschnitt Häufige Probleme auf dieser Seite finden Sie Informationen dazu, ob Ihr Dialekt symmetrische Aggregate unterstützt.
Wenn Ihr Datenbankdialekt symmetrische Summen nicht unterstützt, sollten Sie Joins vermeiden, die zu einem Fanout führen. Joins mit einer 1-zu-N-Beziehung zwischen dem Explore und der Ansicht sollten also generell vermieden werden. Fassen Sie stattdessen die Daten aus der Ansicht in einer abgeleiteten Tabelle zusammen, um eine 1:1-Beziehung zum Explore herzustellen, und führen Sie diese abgeleitete Tabelle dann mit dem Explore zusammen.
Dieses wichtige Konzept wird im Community-Beitrag The problem of SQL fanouts (Das Problem von SQL-Fanouts) näher erläutert.