


La función de acceso a datos multinube te permite consultar datos almacenados en otros proveedores de servicios en la nube directamente desde Google Cloud sin migrar archivos ni compilar canalizaciones de ETL complejas. Las consultas se pueden enrutar a través de la Internet pública o usar Cross‑Cloud Interconnect para el transporte de redes privadas.
Como parte de Lakehouse sin fronteras, esta capacidad unifica las cargas de trabajo de análisis y de IA en tus conjuntos de datos distribuidos a través de BigQuery, entornos independientes de Apache Spark o Managed Service para Apache Spark.
Además de ejecutar consultas analíticas, puedes crear agentes de análisis conversacional basados en tus tablas distribuidas, incluidas las fuentes multinube, para analizar datos en diferentes nubes desde una sola conversación. También puedes usar Knowledge Catalog para generar perfiles de datos y estadísticas en plataformas remotas.
Casos de uso
Lakehouse admite varios casos de uso clave para acceder a datos en varios proveedores de servicios en la nube:
- La reducción del movimiento de datos te permite consultar los datos almacenados en otros entornos de nube directamente, lo que simplifica el acceso a los datos y su procesamiento.
- Las estadísticas unificadas te permiten realizar análisis avanzados con funciones coherentes y optimización de hardware en todos tus datos, sin importar dónde se encuentren.
- La IA y el AA sin fronteras te permiten aplicar modelos de IA, agentes autónomos y aprendizaje automático directamente a tus datos remotos sin migrarlos.
Arquitectura
En el siguiente diagrama, se ilustra la arquitectura de acceso a los datos multinube de Lakehouse:
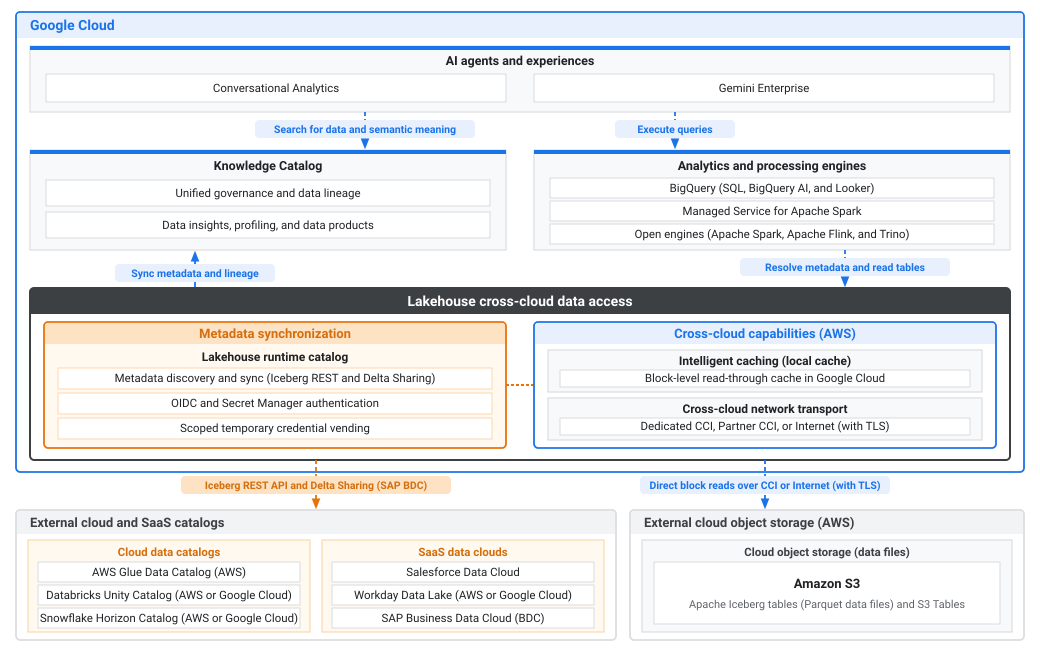
En el diagrama anterior, se ilustra la arquitectura en Google Cloud y los entornos externos de nube y SaaS:
- Google Cloud: Proporciona IA, gobernanza, análisis y acceso a datos
multinube en conjuntos de datos remotos:
- Agentes y experiencias de IA: Crea agentes autónomos en Conversational Analytics y Gemini Enterprise que buscan datos y significado semántico en Knowledge Catalog y ejecutan consultas a través de motores de análisis y procesamiento.
- Knowledge Catalog: Ofrece administración unificada y linaje de datos, junto con estadísticas de datos, generación de perfiles y productos de datos, a través de la sincronización de metadatos y linaje de Lakehouse.
- Motores de análisis y procesamiento: Ejecuta cargas de trabajo de BigQuery SQL, BigQuery AI y Looker, o procesa datos remotos con Managed Service para Apache Spark y motores abiertos (Apache Spark, Apache Flink y Trino) resolviendo metadatos y leyendo tablas a través de Lakehouse.
- Acceso a datos multinube de Lakehouse: Consulta datos remotos
in situ sin migración de archivos ni canalizaciones de ETL:
- Sincronización de metadatos: Descubre y sincroniza los metadatos de las tablas en Apache Iceberg REST y Delta Sharing con el catálogo de tiempo de ejecución de Lakehouse, se autentica a través de OpenID Connect (OIDC) o Secret Manager, y vende credenciales temporales con permisos.
- Funciones multinube (AWS): Almacena en caché los bloques de datos de lectura en Google Cloud con una caché de lectura directa a nivel de bloque (Almacenamiento en caché inteligente (caché local)) y enruta el tráfico a través de Cross‑Cloud Interconnect (CCI) dedicada, la interconexión de socio o Internet (con TLS) con el transporte de red multinube.
- Fuentes de datos externas de SaaS y de la nube: Aloja los catálogos remotos, las nubes de datos de SaaS y el almacén de objetos:
- Catálogos externos de SaaS y de la nube: Sincroniza los metadatos de los catálogos de datos de la nube (AWS Glue Data Catalog en AWS, y Databricks Unity Catalog y Snowflake Horizon Catalog en AWS o Google Cloud) y las nubes de datos de SaaS (Salesforce Data Cloud, Workday Data Lake en AWS oGoogle Cloudy SAP Business Data Cloud [BDC]) a través de la API de REST de Iceberg y Delta Sharing (para SAP BDC).
- Almacenamiento de objetos en la nube externa (AWS): Almacena tablas de Apache Iceberg (archivos de datos de Parquet) y tablas de Amazon S3 en Amazon S3 para lecturas de bloques directas a través de CCI o Internet (con TLS).
Cómo funciona el acceso a los datos multinube
Lakehouse consulta datos remotos con el siguiente proceso:
- Descubrimiento de metadatos: El Lakehouse de Google Cloud se conecta a catálogos de REST de Apache Iceberg remotos, como Databricks Unity Catalog o AWS Glue. Lakehouse descubre los datos sin copiar ningún archivo. Según el proveedor de catálogo remoto, Lakehouse se autentica de forma segura a través de Secret Manager o la federación de tokens de OIDC con Google como proveedor de identidad.
- Transporte seguro: Elegir enrutar el tráfico a través de una interconexión privada (por ejemplo, CCI dedicada o interconexión de socio) reduce significativamente los costos de transferencia de datos en comparación con la Internet pública y hace que la latencia sea muy predecible.
- Ejecución optimizada: A medida que las consultas leen datos de nubes remotas, Lakehouse almacena en caché de forma temporal esos segmentos de datos de manera local en Google Cloud en un almacenamiento especializado. Las consultas posteriores usan la caché local, lo que evita una parte significativa de los cargos de salida multinube.
Catálogos admitidos
Lakehouse admite la consulta de datos de los siguientes proveedores de catálogos remotos:
- Databricks Unity Catalog: Se aloja en Amazon Web Services (AWS) o Google Cloud.
- AWS Glue: Se aloja en AWS.
- Catálogo de Snowflake Horizon: Alojado en AWS o Google Cloud.
- Data Lake de Workday: Se aloja en AWS o Google Cloud.
- SAP Business Data Cloud (BDC): Se aloja en AWS, Microsoft Azure o Google Cloud con el conector de SAP BDC.
Conceptos básicos
En esta sección, se describen los componentes clave esenciales para usar la función de acceso a datos multinube.
Capa de metadatos
La capa de metadatos se conecta a los extremos remotos del catálogo de REST de Apache Iceberg para sincronizar los metadatos de los recursos de Iceberg (espacio de nombres, tabla) según un intervalo de actualización. Lakehouse se autentica de forma segura con credenciales de OAuth almacenadas en Secret Manager o en la federación de tokens de OIDC.
Capa de transporte
La capa de transporte permite que BigQuery y los motores de código abierto consulten los datos con los metadatos sincronizados de la capa de metadatos. Para ciertos tipos de catálogos remotos, Lakehouse admite la consulta de datos a través de la Internet pública o una interconexión privada dedicada.
Selecciona el método de transporte que coincida con tus requisitos de arquitectura y seguridad:
Propiedad del cliente (CCI)
Puedes configurar BigQuery para consultar datos almacenados en buckets de AWS Amazon S3 a través de una conexión privada de Cross-Cloud Interconnect con Cross-Cloud Interconnect dedicada o Cross-Cloud Interconnect para socios.
El uso de una interconexión privada proporciona los siguientes beneficios:
- Seguridad mejorada: Los datos viajan a través de una conexión de red privada entre Google Cloud y AWS, lo que evita el Internet público.
- Costos reducidos: Es posible que los cargos de salida de AWS sean más bajos en comparación con la salida de Internet, en especial cuando se combinan con tu capacidad de interconexión privada.
- Rendimiento constante: Latencia de red y ancho de banda más predecibles en comparación con la Internet pública.
Descripción general de la arquitectura
Para habilitar las consultas privadas, configura una ruta de acceso de BigQuery a tu bucket de Amazon S3 de AWS a través de tu interconexión privada. Un componente clave en la nube privada virtual (VPC) de Google Cloud es un balanceador de cargas interno (ILB). El ILB distribuye las solicitudes de BigQuery a los extremos privados para Amazon S3 dentro de tu VPC de AWS, que se aprovisionan con AWS PrivateLink.
Usar un ILB con varias interfaces de red elásticas (ENI) como backends es esencial para el balanceo de cargas, la escalabilidad y la alta disponibilidad. Esto se aplica ya sea que uses CCI dedicada o interconexión de socio.
El flujo de trabajo de la consulta privada sigue este proceso:
- BigQuery usa una conexión configurada con un servicio del Directorio de servicios.
- El Directorio de servicios resuelve el nombre del servicio en la dirección IP interna del ILB de Google Cloud .
- El ILB recibe las solicitudes de BigQuery y las distribuye a los backends configurados.
- Los backends del ILB son grupos de extremos de red (NEG) de conectividad híbrida, cada uno de los cuales apunta a la dirección IP privada de una ENI en tu VPC de AWS.
- El tráfico fluye desde el ILB, a través de los NEG, por la interconexión privada, hasta las ENI de AWS.
- Las ENI de AWS, que forman parte de un extremo de interfaz de VPC de Amazon S3 (AWS PrivateLink), proporcionan acceso privado al servicio de Amazon S3.
Internet público (sin CCI)
Si no configuras una interconexión privada, las consultas a tu catálogo remoto se envían a través de la Internet pública de forma predeterminada.
Cuando consultes datos a través de la Internet pública, ten en cuenta las siguientes implicaciones:
- Encriptación estándar: Las solicitudes de acceso a los datos y las transferencias de datos se encriptan en tránsito con protocolos TLS estándar en la Internet pública.
- Costos de salida: La transferencia de datos genera cargos estándar de salida de Internet desde tu proveedor de servicios en la nube remoto (por ejemplo, AWS), que suelen ser más altos que las tarifas de salida de interconexión privada.
- Latencia variable: El rendimiento, el ancho de banda y la latencia de la red dependen del enrutamiento y la congestión de la Internet pública, lo que genera tiempos de ejecución de consultas menos predecibles en comparación con una interconexión privada dedicada.
- Configuración simplificada: No requiere infraestructura de red adicional, intercambio de tráfico entre VPC ni configuración del Directorio de servicios en Google Cloud ni en tu proveedor de servicios en la nube remoto.
Descripción general de la arquitectura
Cuando se consultan datos a través de la Internet pública, Lakehouse se conecta directamente a tus extremos de catálogo remoto y almacén de objetos sin necesidad de infraestructura de red de nube privada Google Cloud o remota.
El flujo de trabajo de consultas de Internet pública sigue este proceso:
- BigQuery inicia una consulta en una tabla remota definida en tu catálogo de Lakehouse.
- Lakehouse se autentica de forma segura con tu catálogo remoto de Apache Iceberg con credenciales almacenadas en Secret Manager o la federación de tokens de OIDC.
- Lakehouse recupera los metadatos de la tabla y los archivos de manifiesto a través de la Internet pública para identificar los archivos de datos subyacentes relevantes (por ejemplo, en AWS Amazon S3).
- Las solicitudes de acceso a los datos de los objetos subyacentes se envían directamente desde Google Cloud a través de la Internet pública con la encriptación TLS estándar.
- El servicio de almacenamiento remoto verifica la solicitud con credenciales temporales y con alcance que vende Lakehouse y devuelve los bloques de datos solicitados a través de la Internet pública a Google Cloud.
Almacenamiento en caché inteligente
Cuando consultas datos remotos de la nube, Lakehouse almacena en caché de forma automática los bloques de datos recuperados de forma local en Google Cloud. El almacenamiento en caché se habilita automáticamente para todas las consultas multinube para ayudar a minimizar las tarifas de salida de los proveedores de servicios en la nube remotos. Las consultas posteriores orientadas a los datos almacenados en caché se leen directamente desde el almacenamiento local de Google Cloud en lugar de volver a recuperar los datos en las nubes.
Ahorro de costos de salida
En la ejecución inicial de la consulta, Lakehouse recupera los bloques de datos necesarios del proveedor de servicios en la nube remoto y propaga la caché local. Las consultas posteriores que se orientan a los mismos bloques de datos se leen directamente desde la caché local de Google Cloud en lugar de volver a recuperar los datos en las nubes.
En el caso de las cargas de trabajo con patrones de consulta repetidos en el mismo conjunto de datos, el almacenamiento en caché reduce las tarifas de salida multinube, ya que entrega solicitudes de datos desde el almacenamiento local. Los ahorros reales en los costos de salida dependen de factores como los patrones de acceso a las consultas, las tasas de modificación de datos y la retención de la caché en la región de Google Cloudde destino.
Verifica el uso de la caché y el ahorro de costos de salida en las estadísticas de trabajos
Para verificar las tasas de acierto de caché y los ahorros en los costos de salida de una consulta, inspecciona las
estadísticas de la consulta en la consola o la API de BigQuery (JobStatistics2).
Debido a que una consulta puede hacer referencia a datos de varios proveedores, las estadísticas del trabajo
proporcionan un campo object_storage_stats (objectStorageStats) repetido con una
entrada para cada proveedor de servicios en la nube al que se accedió durante la ejecución.
Cada entrada de object_storage_stats informa las siguientes métricas:
cloud_provider(cloudProvider): Es el proveedor de servicios en la nube que aloja el almacén de objetos (por ejemplo,AWSoAZURE).cache_bytes_read(cacheBytesRead): Es el total de bytes leídos de la caché local de Google Cloud , lo que evita una lectura remota del almacén de objetos.object_storage_bytes_read(objectStorageBytesRead): Es el total de bytes leídos directamente desde el almacén de objetos del proveedor de servicios en la nube remoto.
Consideraciones sobre la residencia de datos y la jurisdicción
Cuando creas un catálogo o una conexión remotos en una región de Google Cloud , se almacenan los datos almacenados en caché en reposo de forma local dentro de esa región de destino.
Si la residencia de tus datos remotos en la nube se encuentra en una región geográfica o jurisdicción diferente (por ejemplo, AWS Amazon S3 en la Unión Europea vinculado con el procesamiento de BigQuery en us-east4), las consultas multinube almacenan copias en caché de datos en reposo de datos remotos en la regiónGoogle Cloud de destino. El usuario o administrador que crea la conexión o el catálogo debe asegurarse de que el almacenamiento en caché entre jurisdicciones cumpla con los requisitos de residencia de datos, soberanía y cumplimiento de su organización.
Compatibilidad con la encriptación y las CMEK
Las claves de encriptación administradas por el cliente (CMEK) no son compatibles con el almacenamiento en caché de Lakehouse. Todos los bloques de datos almacenados en caché se encriptan en reposo con lasGoogle-owned and Google-managed encryption keyspredeterminadas.
Si tu organización aplica la restricción de la política de la organización
Restringir servicios que no son de CMEK (constraints/gcp.restrictNonCmekServices), Lakehouse
inhabilita automáticamente el almacenamiento en caché para las consultas que acceden a tablas restringidas. Las
consultas se siguen ejecutando correctamente, pero no almacenan en caché los bloques de datos ni se benefician
de los ahorros de salida relacionados con la caché.
¿Qué sigue?
- Configura una conexión multinube para AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog, Workday Data Lake o SAP Business Data Cloud.