


Este documento ajuda você a solucionar e resolver os problemas mais comuns com os gráficos de linhagem de dados do Knowledge Catalog (antigo Dataplex Universal Catalog) que não aparecem. A resolução desses problemas garante que você possa rastrear a movimentação de dados, entender as origens deles e depurar pipelines de dados.
Tipos de projeto
Os recursos de dados podem estar em projetos diferentes. Confira a seguir um resumo dos possíveis projetos e os nomes dos recursos deles.
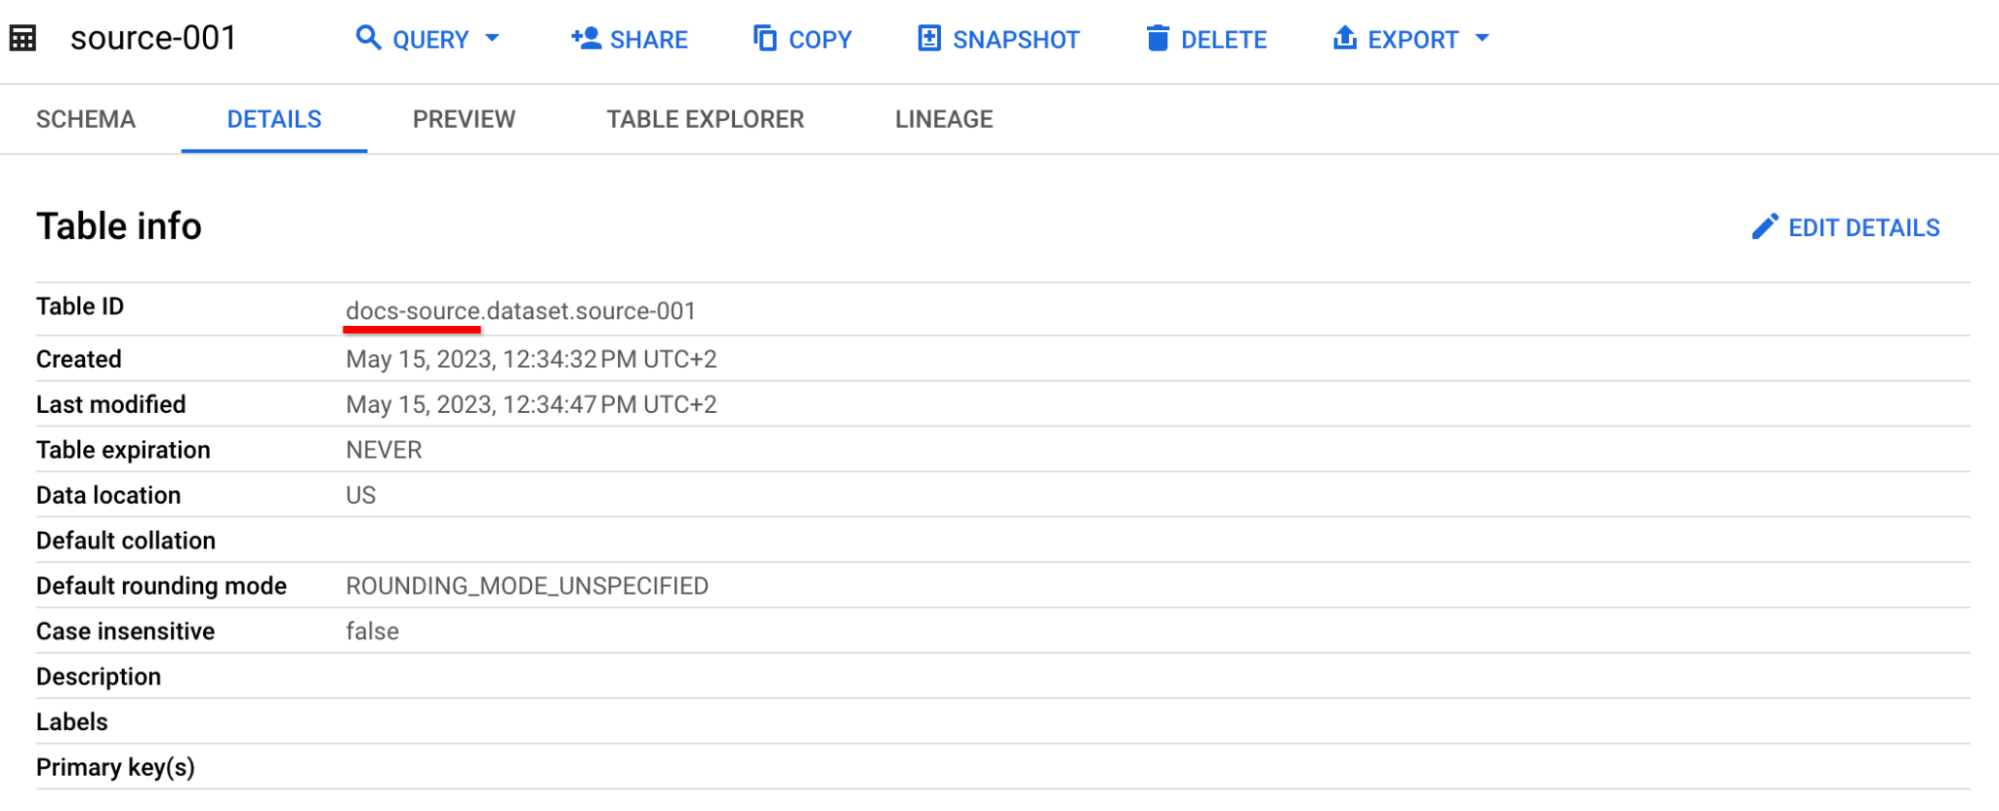
Projeto de armazenamento do BigQuery
Esse projeto armazena seus recursos de dados do BigQuery.
Ele está nos detalhes do recurso como parte de Table ID, antes do primeiro ponto.
Projeto do Compute
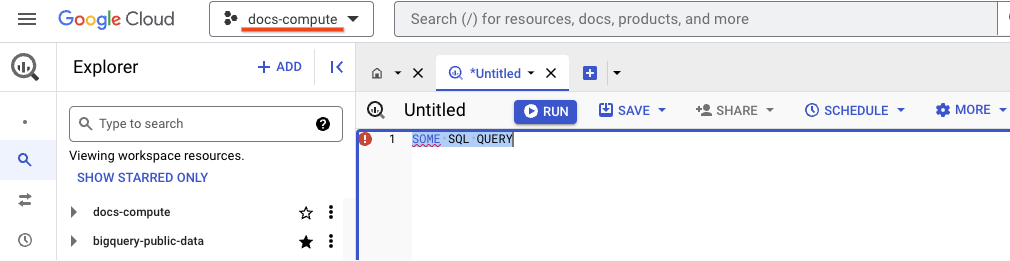
Esse projeto armazena os metadados de linhagem de dados. No BigQuery, é aqui que você executa um job. Se você executar um job usando o console Google Cloud , poderá encontrar o nome do projeto de computação no seletor de projetos:
Ao enviar solicitações para a API BigQuery, especifique o projeto de computação no URL. Por exemplo:
POST /bigquery/v2/projects/docs-compute/jobs HTTP/1.1
Host: bigquery.googleapis.com
User-Agent: Go-http-client/1.1
Authorization: <REDACTED 1031 BYTES>
Accept-Encoding: gzip
{
  "configuration": {
    "query": {
      "useLegacySql": false,
      "query": "CREATE OR REPLACE TABLE `docs-target.dataset.target-002` AS SELECT * FROM `docs-source.dataset.source-002`;"
    }
  },
  "jobReference": {
    "projectId": "docs-compute",
    "jobId": "docs-compute-job-id",
    "location": "us",
  }
}
Projeto ativo
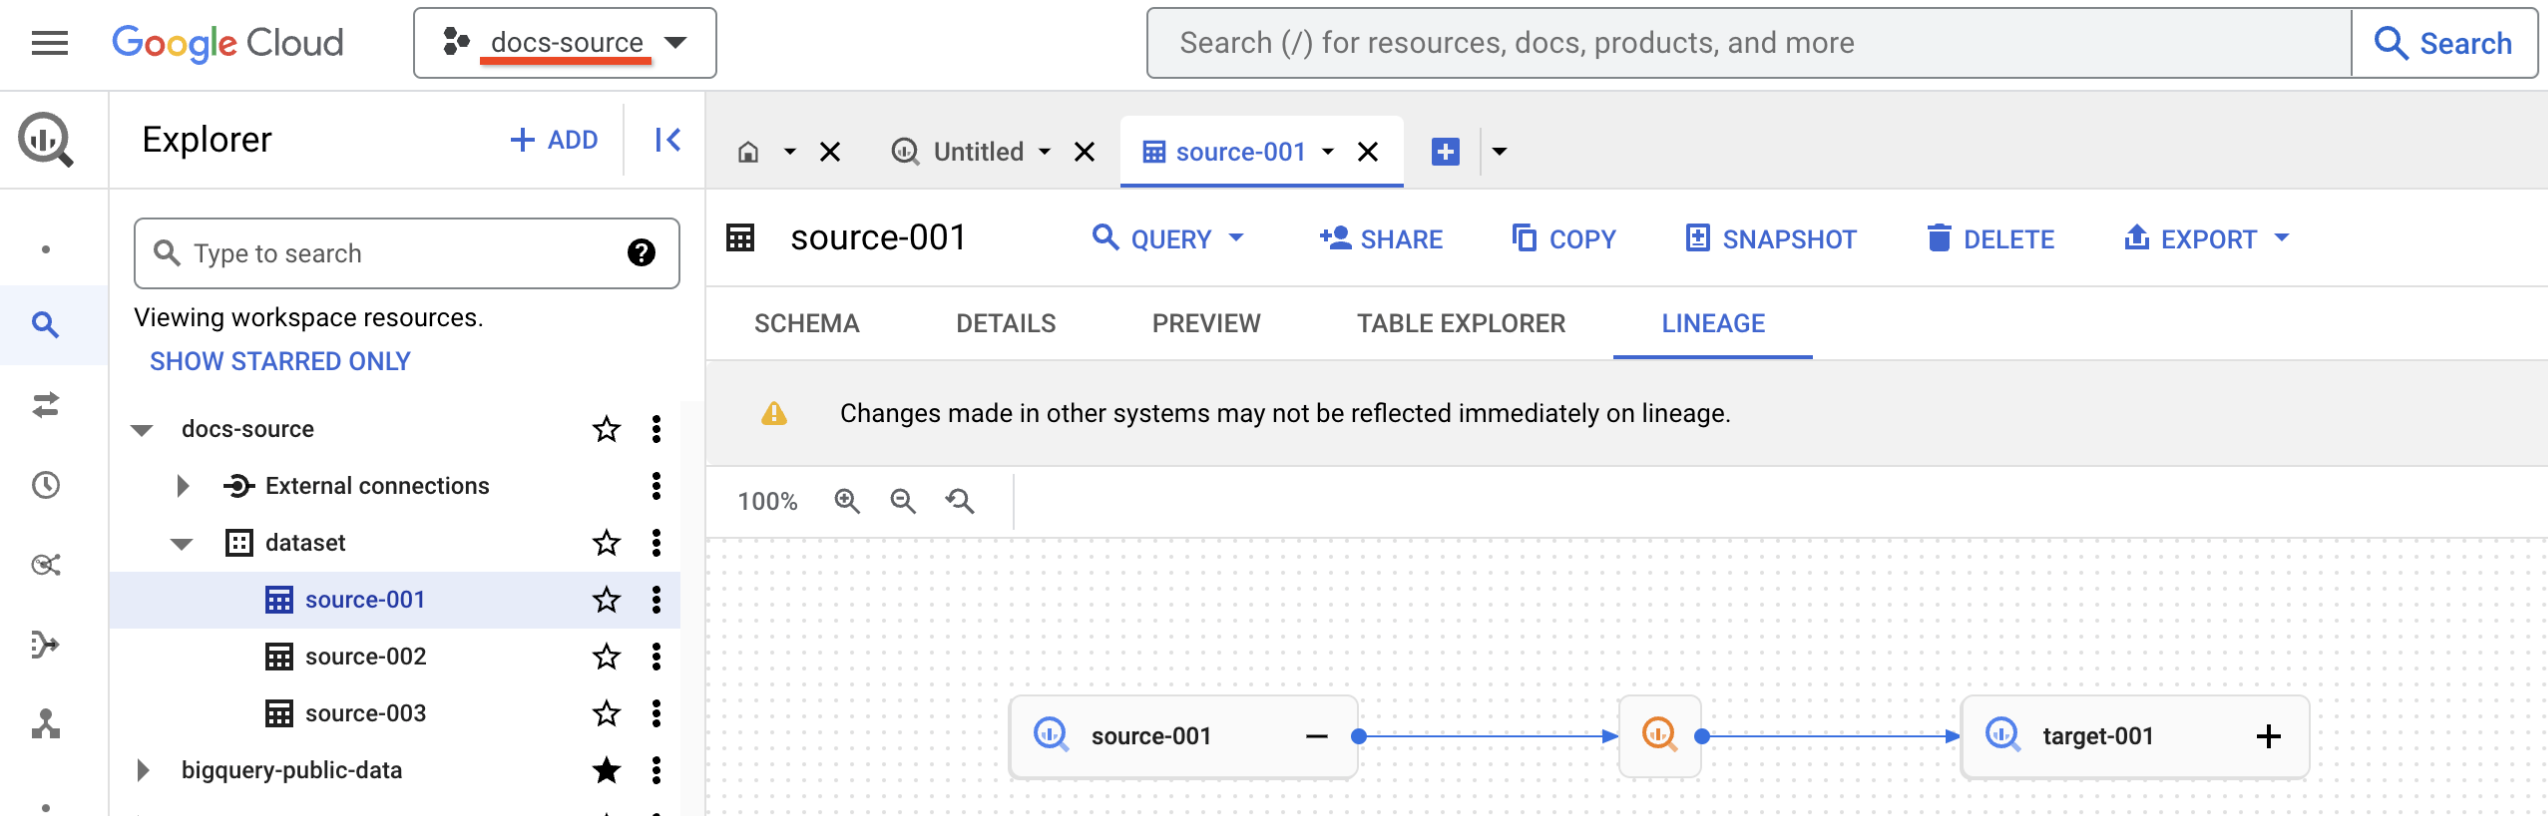
É o projeto em que você está visualizando a linhagem de dados. O console Google Cloud mostra o projeto ativo no seletor de projetos. Se você estiver usando a API, o projeto ativo será aquele de onde você está fazendo chamadas de API.
A linhagem de dados do BigQuery não está aparecendo
O problema a seguir ocorre depois de executar um job do BigQuery. Nesse caso, o problema pode ser causado por três cenários:
- A API Data Lineage está desativada no projeto ativo ou no projeto de computação.
- Você não tem o papel de leitor da linhagem de dados (
roles/datalineage.viewer) no projeto ativo ou compute. - A linhagem de dados ainda não chegou. Dependendo do volume e da complexidade dos dados processados, a linhagem de dados pode levar de 30 minutos a 24 horas para aparecer.
Se você vir a mensagem "A busca da linhagem falhou devido à ausência de permissões", isso significa que você não tem permissões no projeto ativo. Caso contrário, você não tem permissões no projeto de computação.
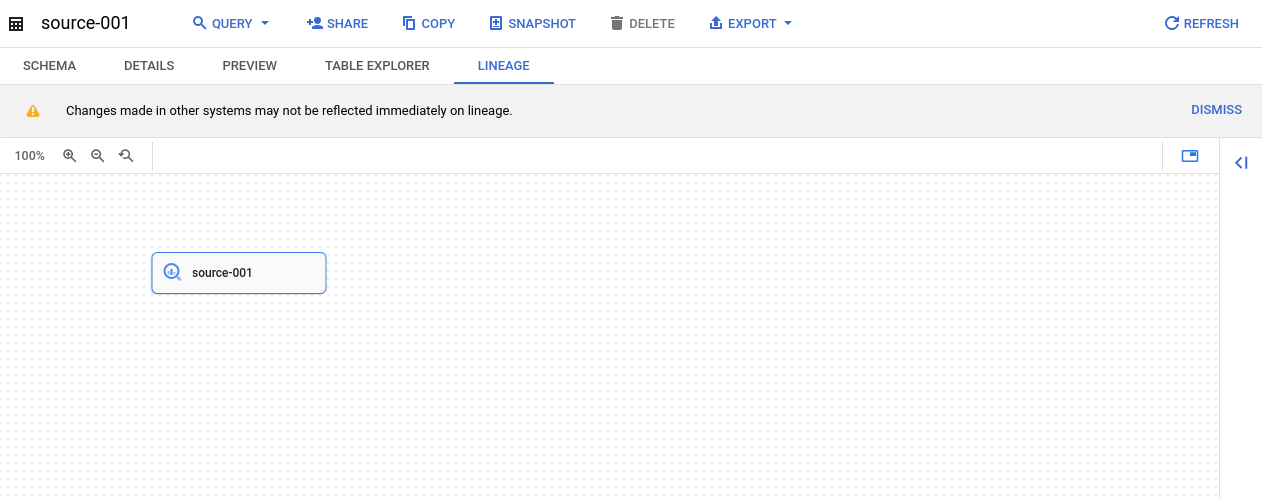
Para resolver esse problema, verifique se a API Data Lineage está ativada no projeto de computação. Depois de ativar a API, execute um job para conferir a linhagem de dados. Dependendo do volume e da complexidade dos dados processados, pode levar de 30 minutos a 24 horas para que a linhagem de dados seja exibida.
Em seguida, verifique se a API Data Lineage está ativada para o projeto ativo.
Quando a API Data Lineage estiver ativada, conceda o
papel de Leitor da linhagem de dados (roles/datalineage.viewer)
nos projetos ativo
e de computação.
Os metadados do processo do BigQuery não estão aparecendo
O problema a seguir ocorre quando você abre o painel de detalhes da tabela, que não mostra todos os detalhes, como a instrução SQL ou a propriedade Process type.
Isso acontece mesmo que a linhagem de dados seja mostrada corretamente.
Isso pode acontecer quando você não tem permissões para ver metadados no projeto de computação.
Exemplo:
- Tabela de origem do BigQuery:
docs-source.dataset.source-001 - Tabela de destino do BigQuery:
docs-target.dataset.target-001 - Linhagem de dados entre
docs-source.dataset.source-001edocs-target.dataset.target-001no projeto de computaçãodocs-compute - Você tem o papel de leitor da linhagem de dados para os projetos ativos e de computação
docs-compute.
Ao clicar nos detalhes do processo do BigQuery, a seguinte mensagem aparece no console do Google Cloud :
You don't have permission to view BigQuery process metadata in project X.
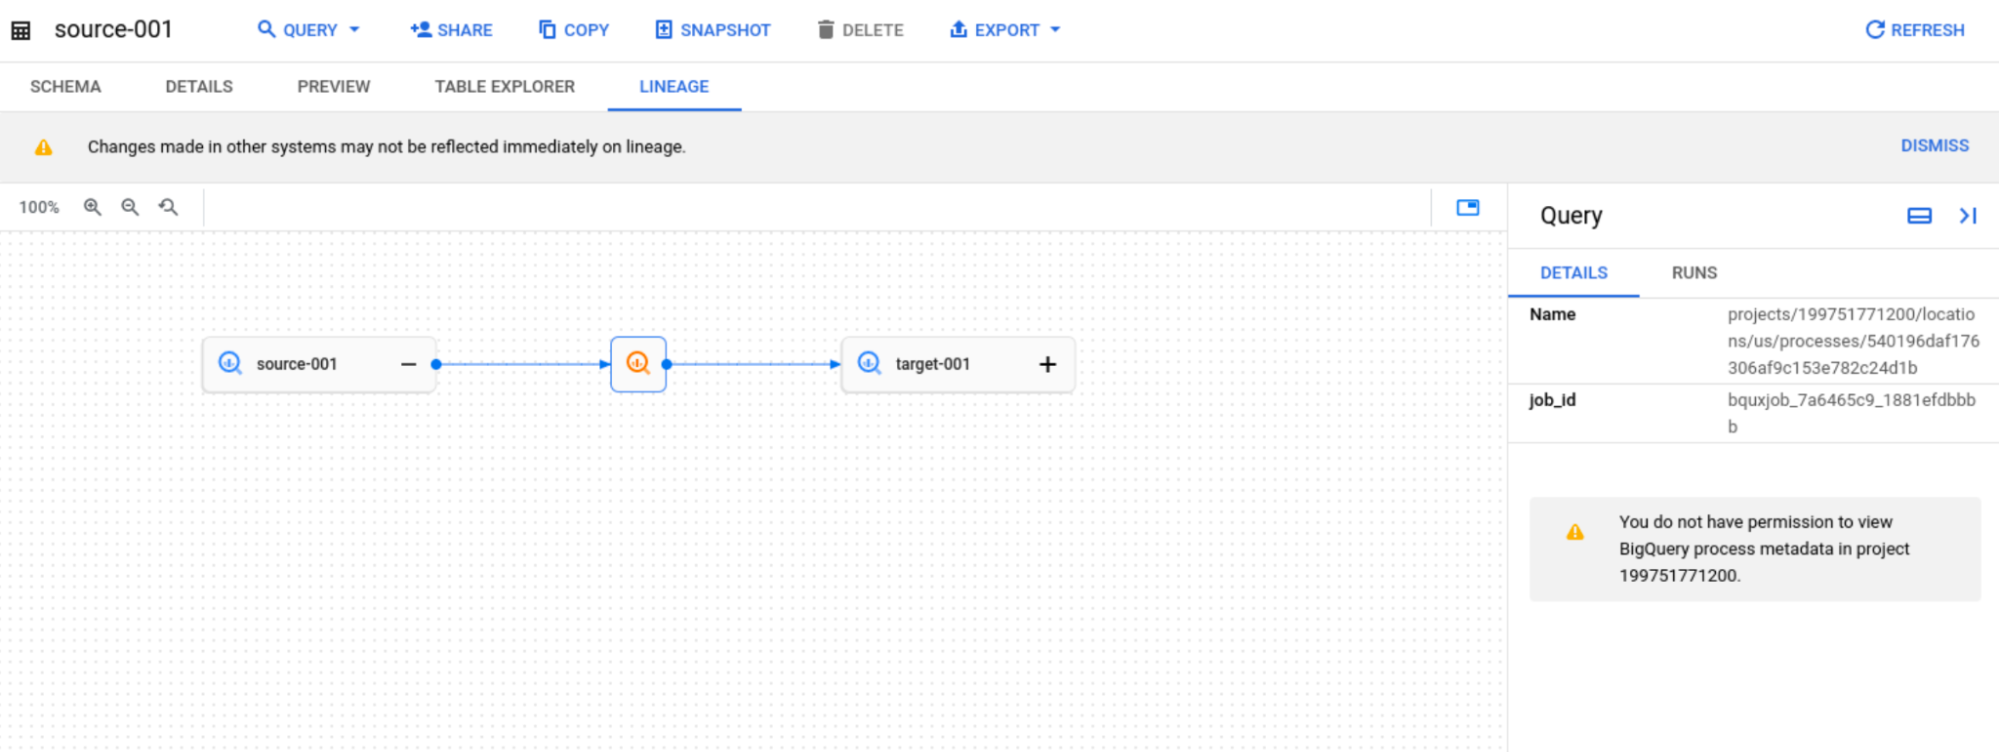
Para resolver esse problema, conceda ao usuário a permissão bigquery.jobs.get
(por exemplo, incluída no papel Leitor de recursos do BigQuery
) no projeto de computação.
Os detalhes da tabela do BigQuery não aparecem
O problema a seguir ocorre quando você abre o painel de detalhes da tabela, que mostra apenas a propriedade Fully qualified name. Isso acontece mesmo que a linhagem de dados seja mostrada corretamente.
Isso pode acontecer quando você não tem todas as permissões necessárias nos projetos de armazenamento da tabela.
Exemplo:
- Tabela do BigQuery
docs-source.dataset.source-001 - Tabela do BigQuery
docs-target.dataset.target-001 - Linhagem de dados entre
docs-source.dataset.source-001edocs-target.dataset.target-001com projeto de computaçãodocs-compute - Você tem o papel de leitor da linhagem de dados para os projetos ativos e de computação
docs-compute.
Nesse caso, ao clicar em "Detalhes do nó do BigQuery", a mensagem Entry with this fully qualified name is not available in Knowledge
Catalog or you do not have permissions to view it vai aparecer.
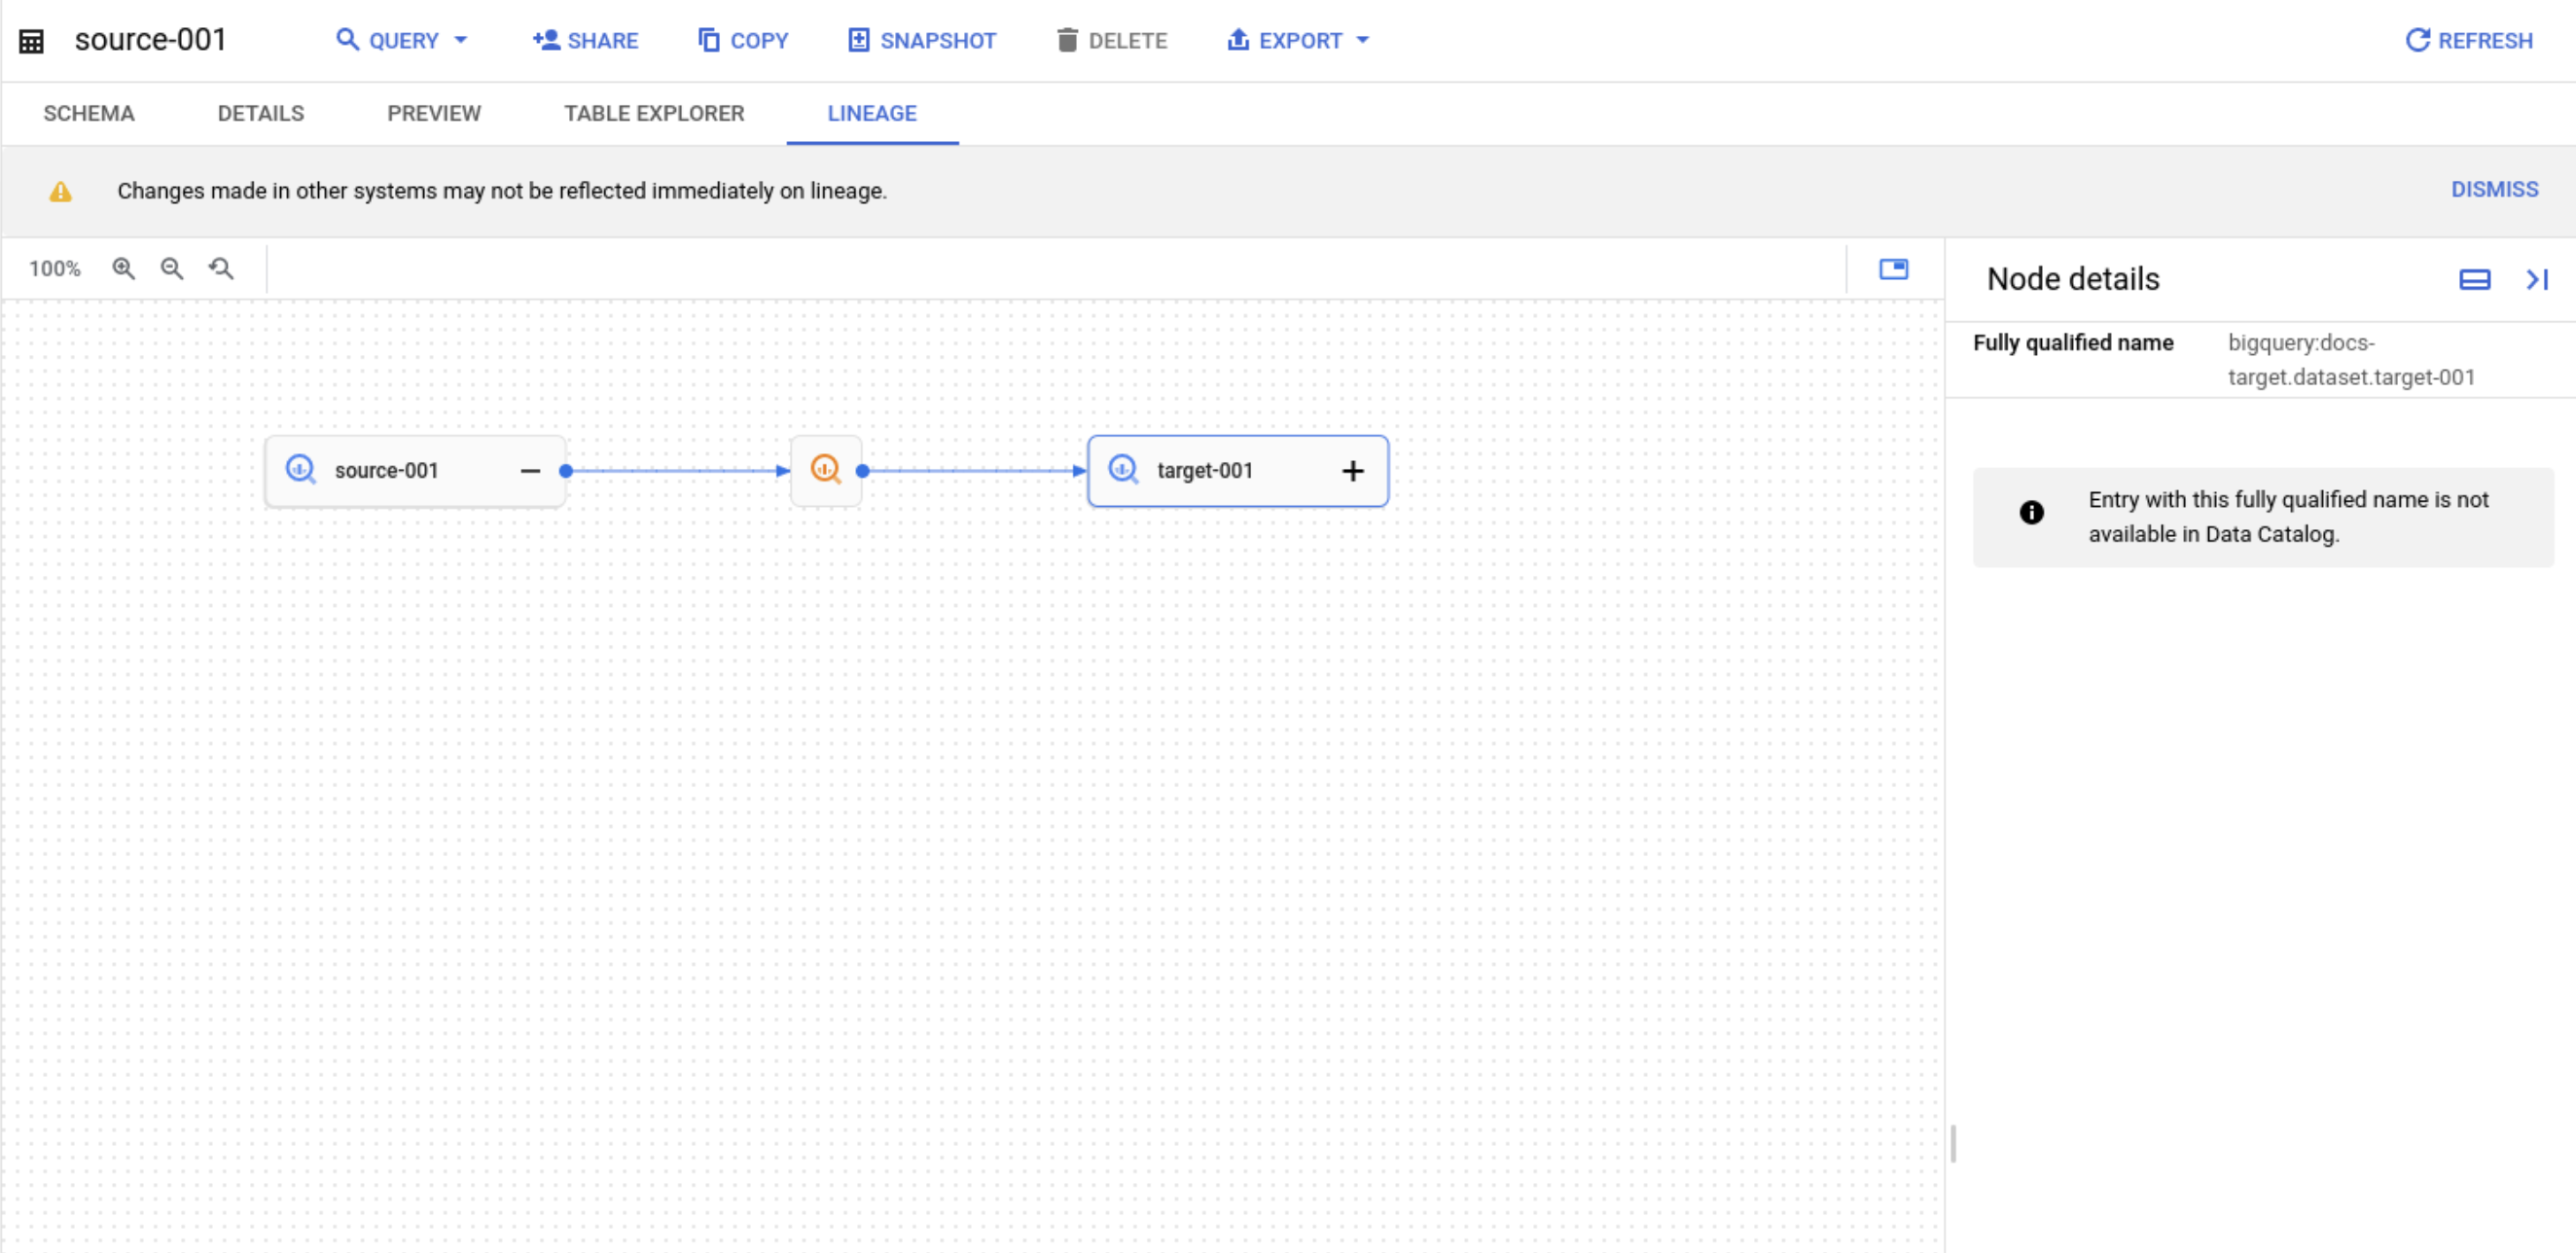
Para resolver esse problema, conceda a permissão bigquery.tables.get (por exemplo, incluída no papel Leitor de dados do BigQuery) no projeto de armazenamento.
A linhagem no nível da coluna mostra a mensagem "Não há colunas para selecionar"
O problema a seguir ocorre quando você visualiza um recurso no console do Google Cloud , e o gráfico de linhagem no nível da tabela é exibido corretamente, mas ao selecionar a linhagem no nível da coluna, a mensagem "Não há colunas para selecionar" aparece ou não há links de coluna para coluna.
Esse problema pode acontecer nos seguintes cenários:
- Eventos personalizados do OpenLineage:os eventos ingeridos pelo endpoint
Data Lineage API
ProcessOpenLineageRunEventsão compatíveis apenas com linhagem no nível da tabela. Facetas personalizadas no nível da coluna não são renderizadas no consoleGoogle Cloud . - Fontes ou sistemas de dados não compatíveis:os gráficos de linhagem no nível da coluna são gerados apenas para transformações de SQL do BigQuery e jobs do Serviço Gerenciado para Apache Spark. Outros sistemas integrados (como o Cloud Data Fusion e a Vertex AI) oferecem suporte apenas ao linhagem no nível da tabela.
- Tipos de jobs do BigQuery sem suporte:a linhagem no nível da coluna não é coletada para jobs de carregamento, jobs de cópia ou rotinas do BigQuery.
- Tabelas externas:a linhagem upstream no nível da coluna não é coletada para tabelas externas.
- Ativos não estruturados ou no nível de armazenamento:embora os ativos baseados em arquivos (como arquivos ou buckets brutos do Cloud Storage) geralmente não sejam estruturados, a linhagem de dados pode mostrar colunas para eles se a linhagem no nível da coluna for informada ao sistema. Se a linhagem no nível da coluna não for informada para o recurso de arquivo, não será possível selecionar nenhuma coluna.
- Tipos aninhados complexos:a linhagem no nível da coluna rastreia apenas as colunas de nível superior. Não é possível selecionar individualmente campos aninhados em tipos de dados complexos (como
STRUCTouJSON). - Pseudocolunas de particionamento:as colunas de particionamento do sistema (como
_PARTITIONDATEe_PARTITIONTIME) não são reconhecidas em gráficos de linhagem no nível da coluna. - Limite de links excedido:se um job de transformação gerar mais de 1.500 links no nível da coluna, o Knowledge Catalog vai ignorar a coleta de linhagem no nível da coluna e manter apenas a linhagem no nível da tabela.
- Recursos entre organizações:se um caminho de linhagem atravessar um recurso localizado em outra organização, não será possível acessar os detalhes do esquema e da coluna se você não pertencer à mesma organização do recurso.
Cobranças inesperadas de processamento do Knowledge Catalog Premium
Você desativou a API Dataplex (dataplex.googleapis.com) para interromper
as cobranças, mas continua recebendo cobranças diárias pela
SKU "Processamento Premium do Knowledge Catalog".
Esse problema pode ocorrer se a API Data Lineage (datalineage.googleapis.com)
permanecer ativada. A API Data Lineage é faturada no SKU "Processamento Premium do Knowledge Catalog", mas é gerenciada como uma API separada no console do Google Cloud . Desativar a API Dataplex não desativa a API Data Lineage nem interrompe as cobranças dela.
Para identificar se a linhagem de dados é a origem das cobranças, verifique seu relatório de faturamento do Cloud Billing para o rótulo goog-dataplex-workload-type com o valor LINEAGE.
Para interromper as cobranças, desative a linhagem de dados desativando a API Data Lineage nos seus projetos.