


In diesem Dokument erfahren Sie, wie Sie die häufigsten Probleme beheben können, wenn keine Datenabstammungsdiagramme im Knowledge Catalog (ehemals Dataplex Universal Catalog) angezeigt werden. Wenn Sie diese Probleme beheben, können Sie Datenbewegungen nachvollziehen, Datenquellen ermitteln und Datenpipelines debuggen.
Projekttypen
Daten-Assets können sich in verschiedenen Projekten befinden. Im Folgenden finden Sie eine Zusammenfassung der möglichen Projekte und ihrer Asset-Namen.
BigQuery-Speicherprojekt
In diesem Projekt werden Ihre BigQuery-Daten-Assets gespeichert.
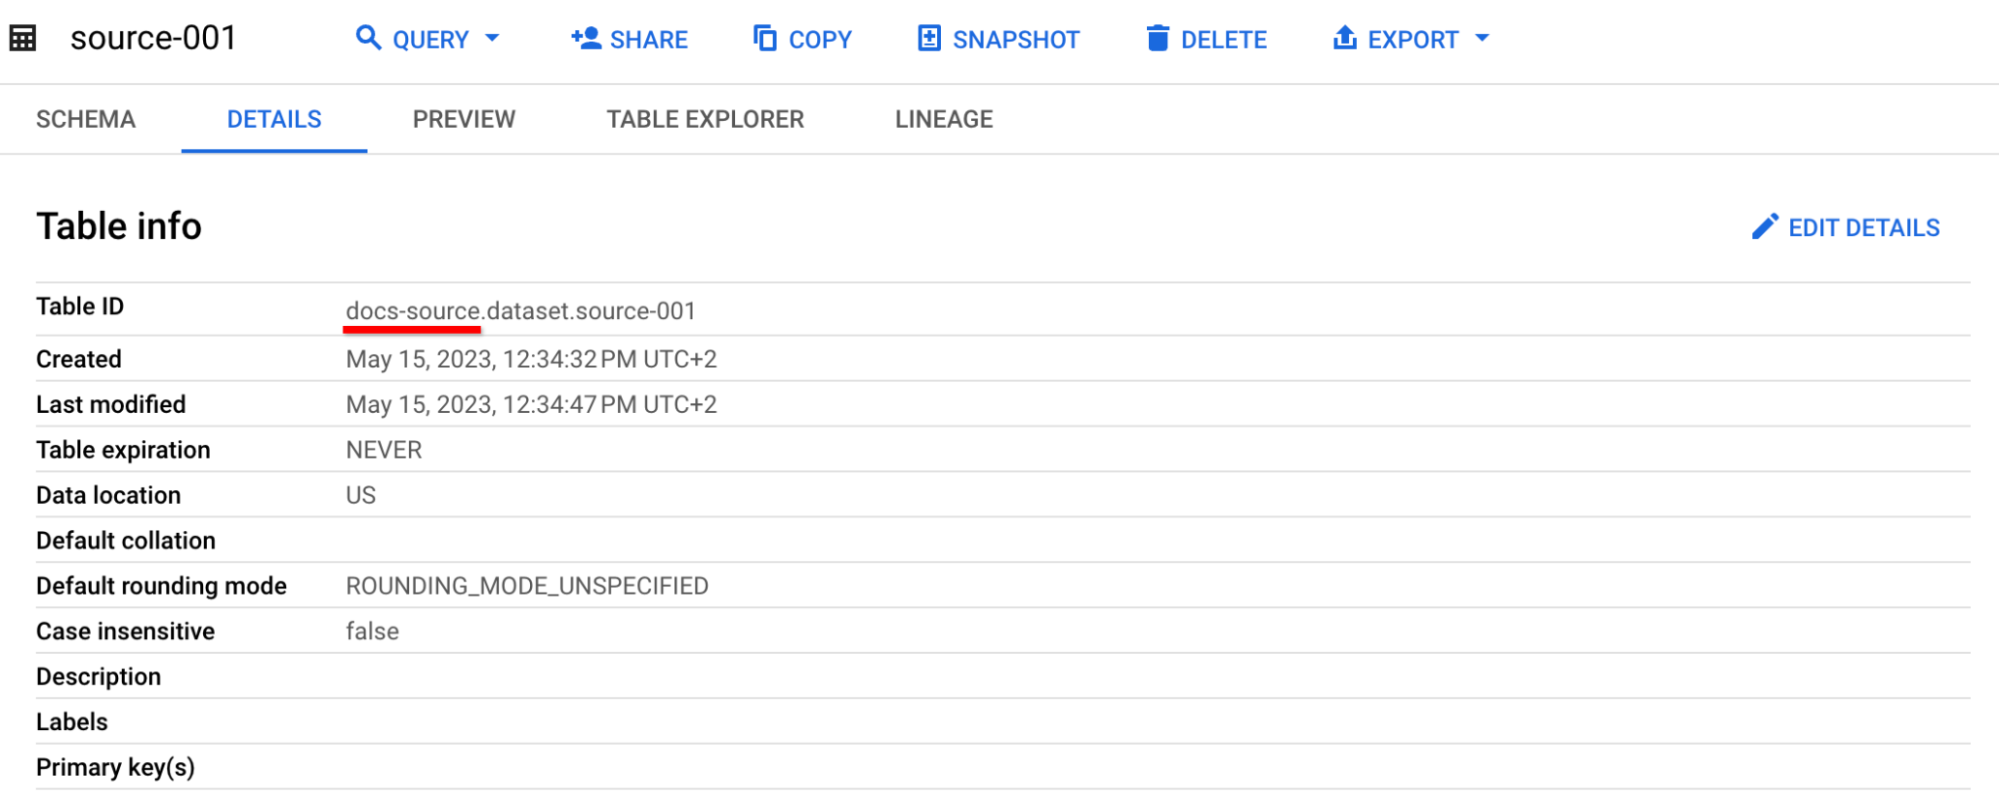
Sie finden sie in den Asset-Details als Teil von Table ID vor dem ersten Punkt.
Compute-Projekt
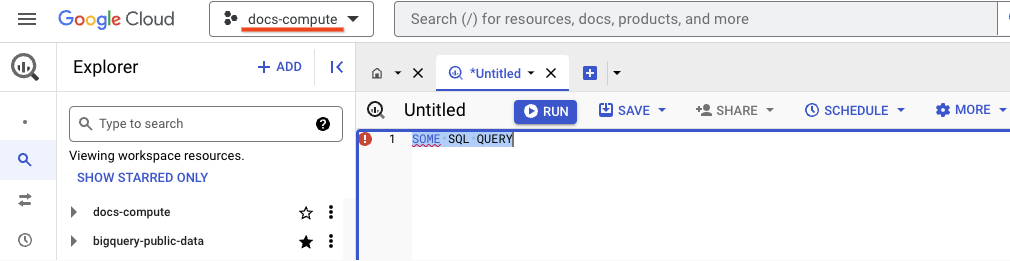
In diesem Projekt werden die Metadaten zum Datenursprung gespeichert. In BigQuery führen Sie hier einen Job aus. Wenn Sie einen Job über die Google Cloud -Konsole ausführen, finden Sie den Namen des Compute-Projekts in der Projektauswahl:
Geben Sie beim Senden von Anfragen an die BigQuery API das Compute-Projekt in der URL an, z. B.:
POST /bigquery/v2/projects/docs-compute/jobs HTTP/1.1
Host: bigquery.googleapis.com
User-Agent: Go-http-client/1.1
Authorization: <REDACTED 1031 BYTES>
Accept-Encoding: gzip
{
  "configuration": {
    "query": {
      "useLegacySql": false,
      "query": "CREATE OR REPLACE TABLE `docs-target.dataset.target-002` AS SELECT * FROM `docs-source.dataset.source-002`;"
    }
  },
  "jobReference": {
    "projectId": "docs-compute",
    "jobId": "docs-compute-job-id",
    "location": "us",
  }
}
Aktives Projekt
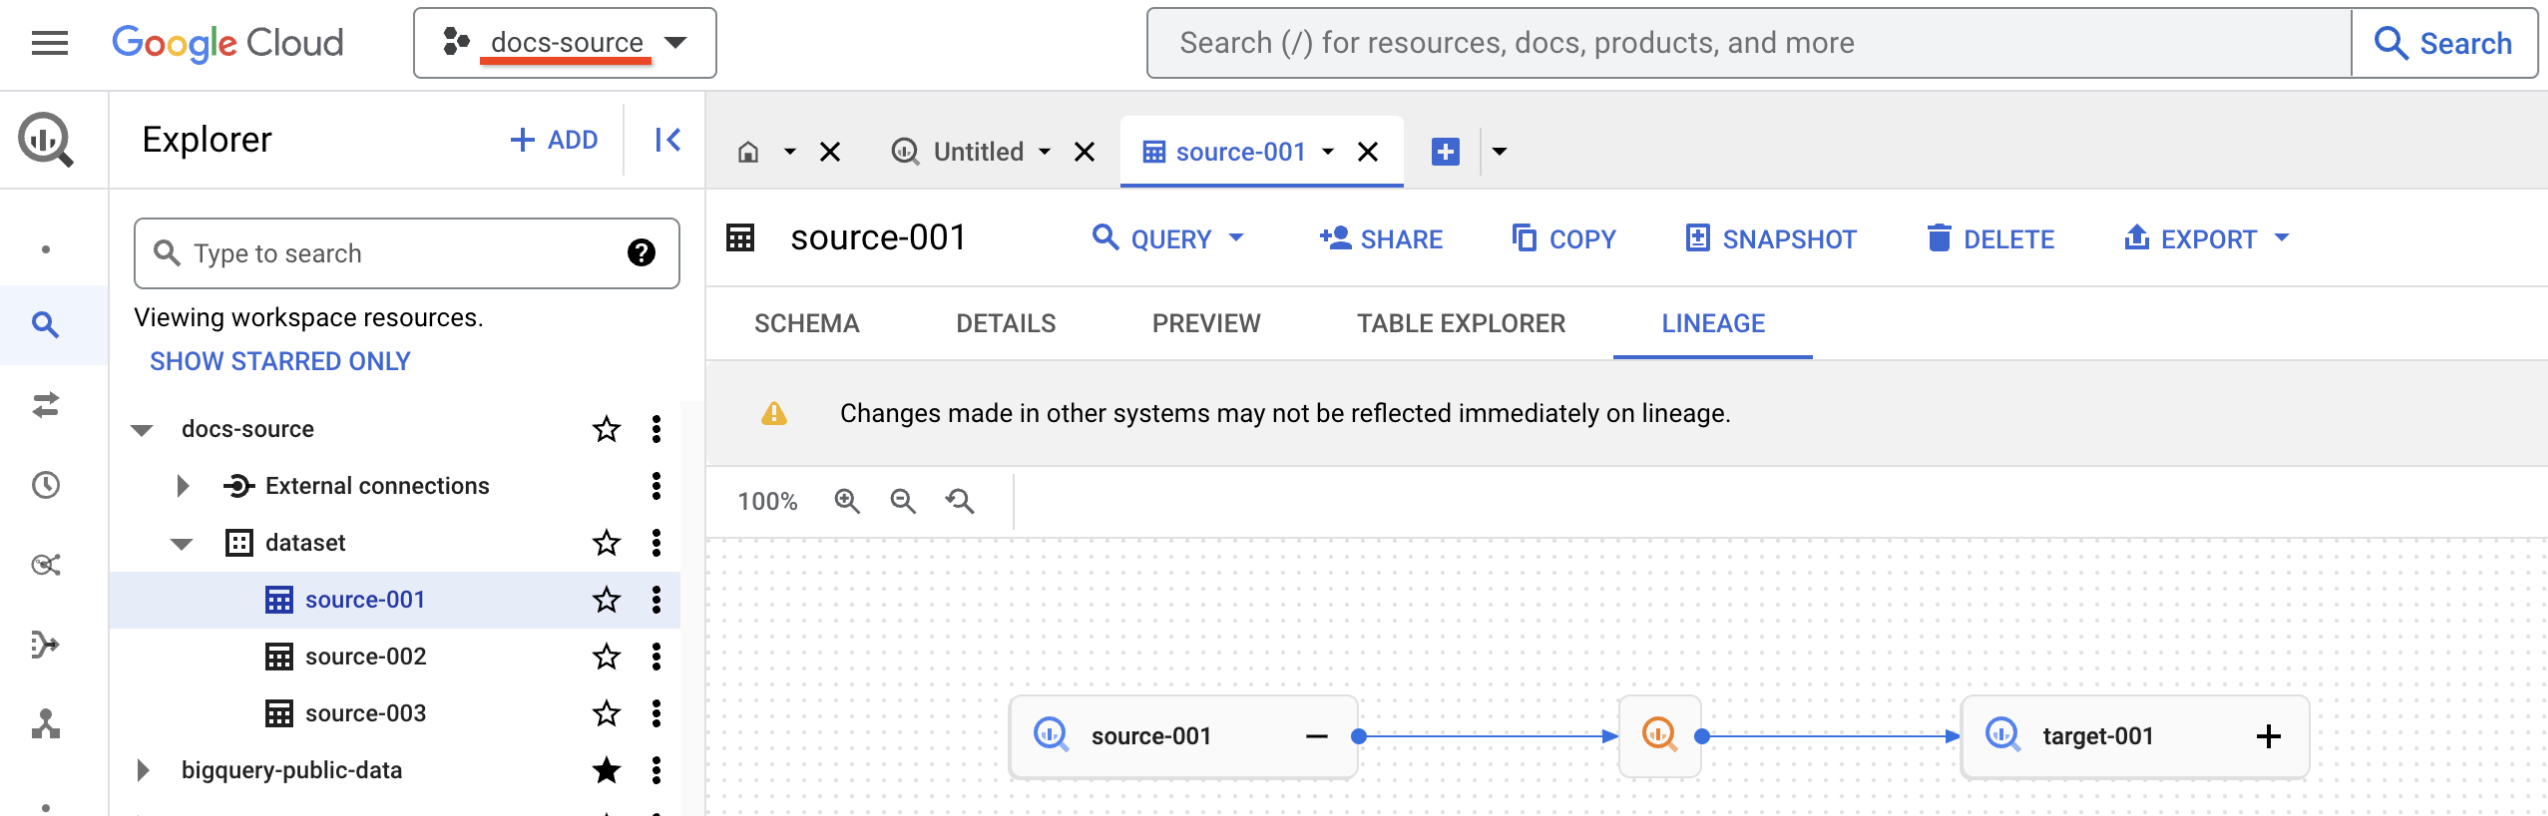
Dies ist das Projekt, in dem Sie die Datenherkunft ansehen. In der Google Cloud -Console wird das aktive Projekt in der Projektauswahl angezeigt. Wenn Sie die API verwenden, ist das aktive Projekt das Projekt, aus dem Sie API-Aufrufe ausführen.
BigQuery-Datenherkunft wird nicht angezeigt
Das folgende Problem tritt nach dem Ausführen eines BigQuery-Jobs auf. In diesem Fall kann das Problem drei Ursachen haben:
- Die Data Lineage API ist im aktiven Projekt oder im Compute-Projekt deaktiviert.
- Sie haben nicht die Rolle Data Lineage Viewer (
roles/datalineage.viewer) im aktiven oder im Compute-Projekt. - Die Datenherkunft ist noch nicht verfügbar. Je nach Menge und Komplexität der verarbeiteten Daten kann es zwischen 30 Minuten und 24 Stunden dauern, bis der Datenursprung angezeigt wird.
Wenn die Meldung „Herkunft konnte aufgrund fehlender Berechtigungen nicht abgerufen werden.“ angezeigt wird, fehlen Ihnen Berechtigungen für das aktive Projekt. Andernfalls fehlen Ihnen Berechtigungen für das Compute-Projekt.
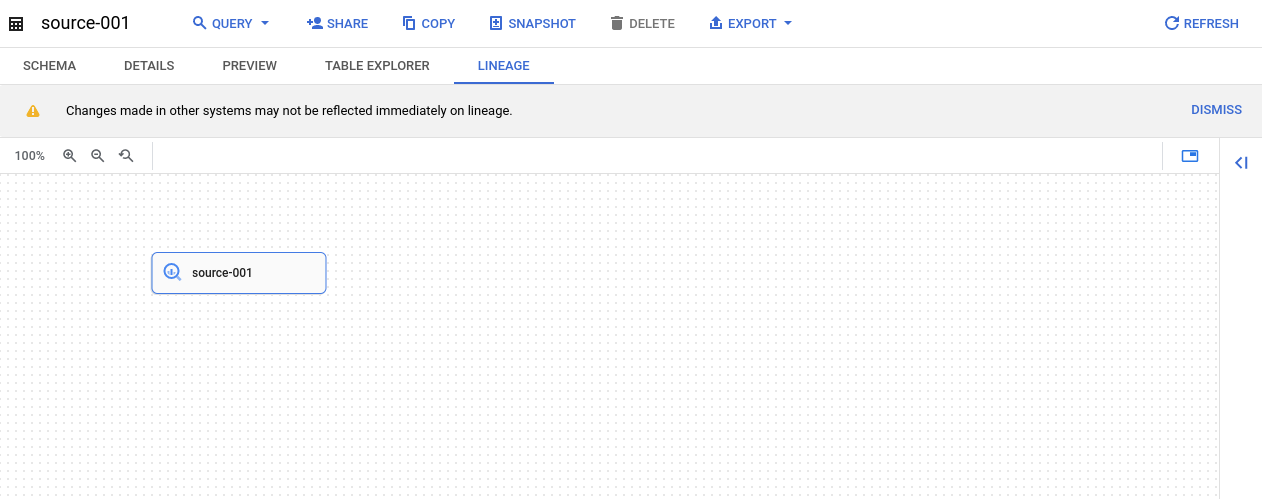
Prüfen Sie zur Behebung dieses Problems, ob die Data Lineage API für das Compute-Projekt aktiviert ist. Nachdem Sie die API aktiviert haben, müssen Sie einen Job ausführen, um die Datenherkunft zu sehen. Je nach Menge und Komplexität der zu verarbeitenden Daten kann es zwischen 30 Minuten und 24 Stunden dauern, bis der Datenursprung angezeigt wird.
Prüfen Sie als Nächstes, ob die Data Lineage API für das aktive Projekt aktiviert ist.
Wenn die Data Lineage API aktiviert ist, weisen Sie die Rolle „Data Lineage Viewer“ (roles/datalineage.viewer) sowohl dem aktiven als auch dem Compute-Projekt zu.
BigQuery-Prozessmetadaten werden nicht angezeigt
Das folgende Problem tritt auf, wenn Sie den Detailbereich der Tabelle öffnen. Dort werden nicht alle Details wie die SQL-Anweisung oder die Property Process type angezeigt.
Das passiert, obwohl die Datenherkunft korrekt angezeigt wird.
Das kann passieren, wenn Sie nicht berechtigt sind, Metadaten im Compute-Projekt anzusehen.
Beispiel:
- BigQuery-Quelltabelle:
docs-source.dataset.source-001 - BigQuery-Zieltabelle:
docs-target.dataset.target-001 - Data Lineage zwischen
docs-source.dataset.source-001unddocs-target.dataset.target-001im Compute-Projektdocs-compute - Sie haben die Rolle Data Lineage Viewer für die aktiven und Compute-Projekte
docs-compute.
Wenn Sie auf die BigQuery-Prozessdetails klicken, wird in der Google Cloud Console die folgende Meldung angezeigt:
You don't have permission to view BigQuery process metadata in project X.
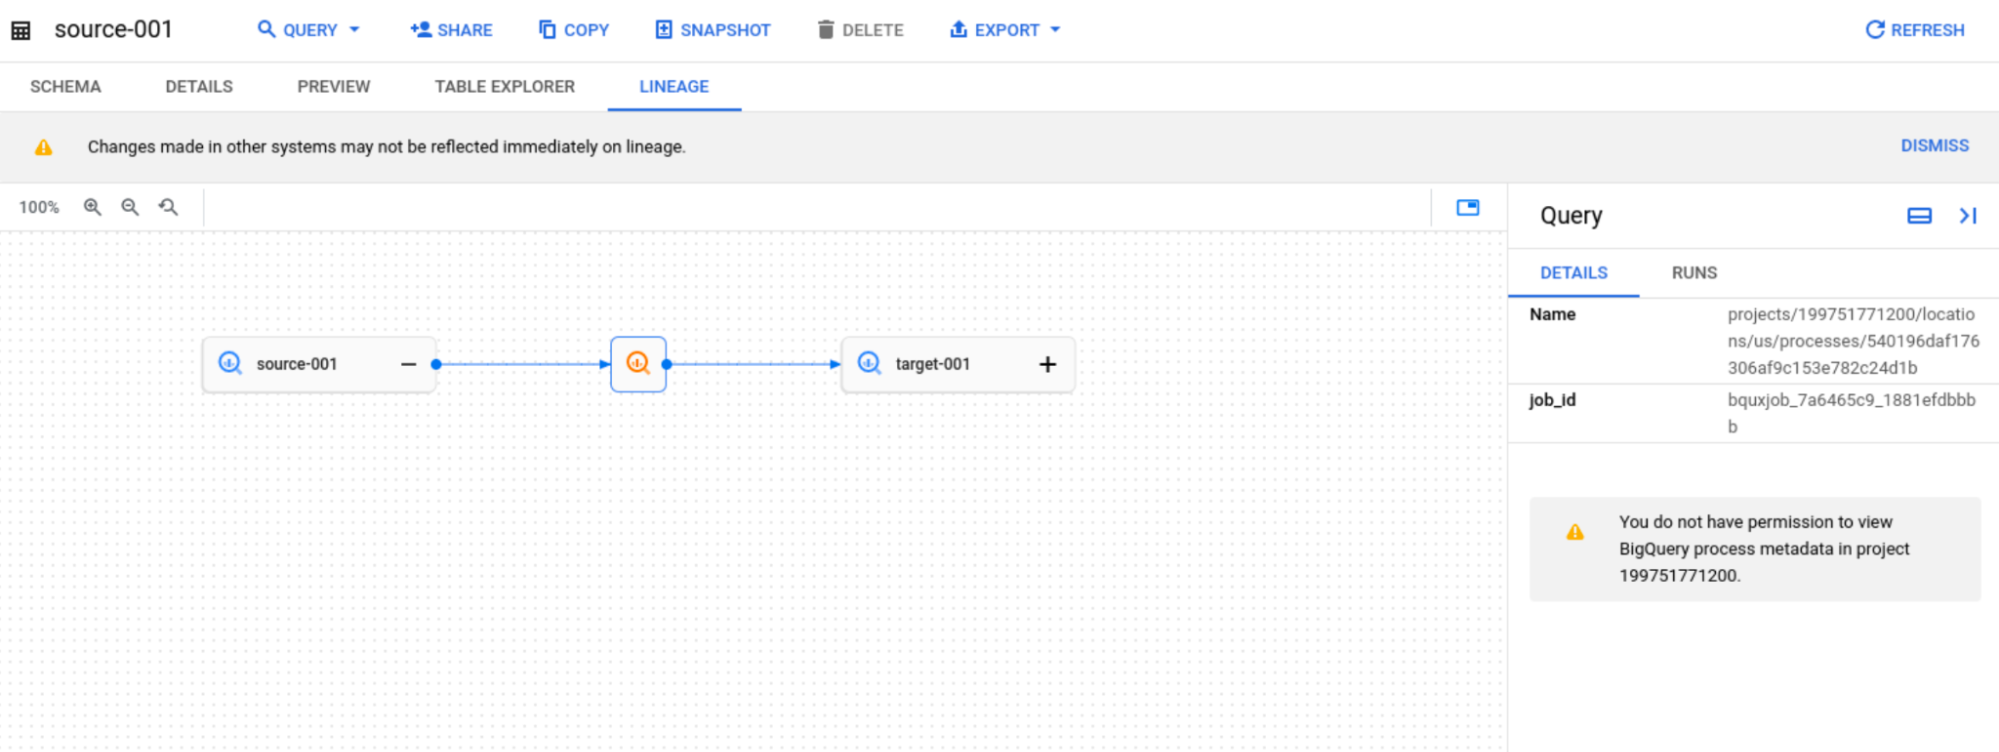
Um dieses Problem zu beheben, weisen Sie dem Nutzer im Compute-Projekt die Berechtigung bigquery.jobs.get zu, die beispielsweise in der Rolle BigQuery-Ressourcenbetrachter enthalten ist.
BigQuery-Tabellendetails werden nicht angezeigt
Das folgende Problem tritt auf, wenn Sie den Bereich mit den Tabellendetails öffnen, in dem nur die Property Fully qualified name angezeigt wird. Das passiert, obwohl die Datenherkunft richtig angezeigt wird.
Das kann passieren, wenn Sie nicht alle erforderlichen Berechtigungen in den Speicherprojekten der Tabelle haben.
Beispiel:
- BigQuery-Tabelle
docs-source.dataset.source-001 - BigQuery-Tabelle
docs-target.dataset.target-001 - Data Lineage zwischen
docs-source.dataset.source-001unddocs-target.dataset.target-001mit Compute-Projektdocs-compute - Sie haben die Rolle Data Lineage Viewer für die aktiven und Compute-Projekte
docs-compute.
Wenn Sie in diesem Fall auf die Details des BigQuery-Knotens klicken, wird die Meldung Entry with this fully qualified name is not available in Knowledge
Catalog or you do not have permissions to view it angezeigt.
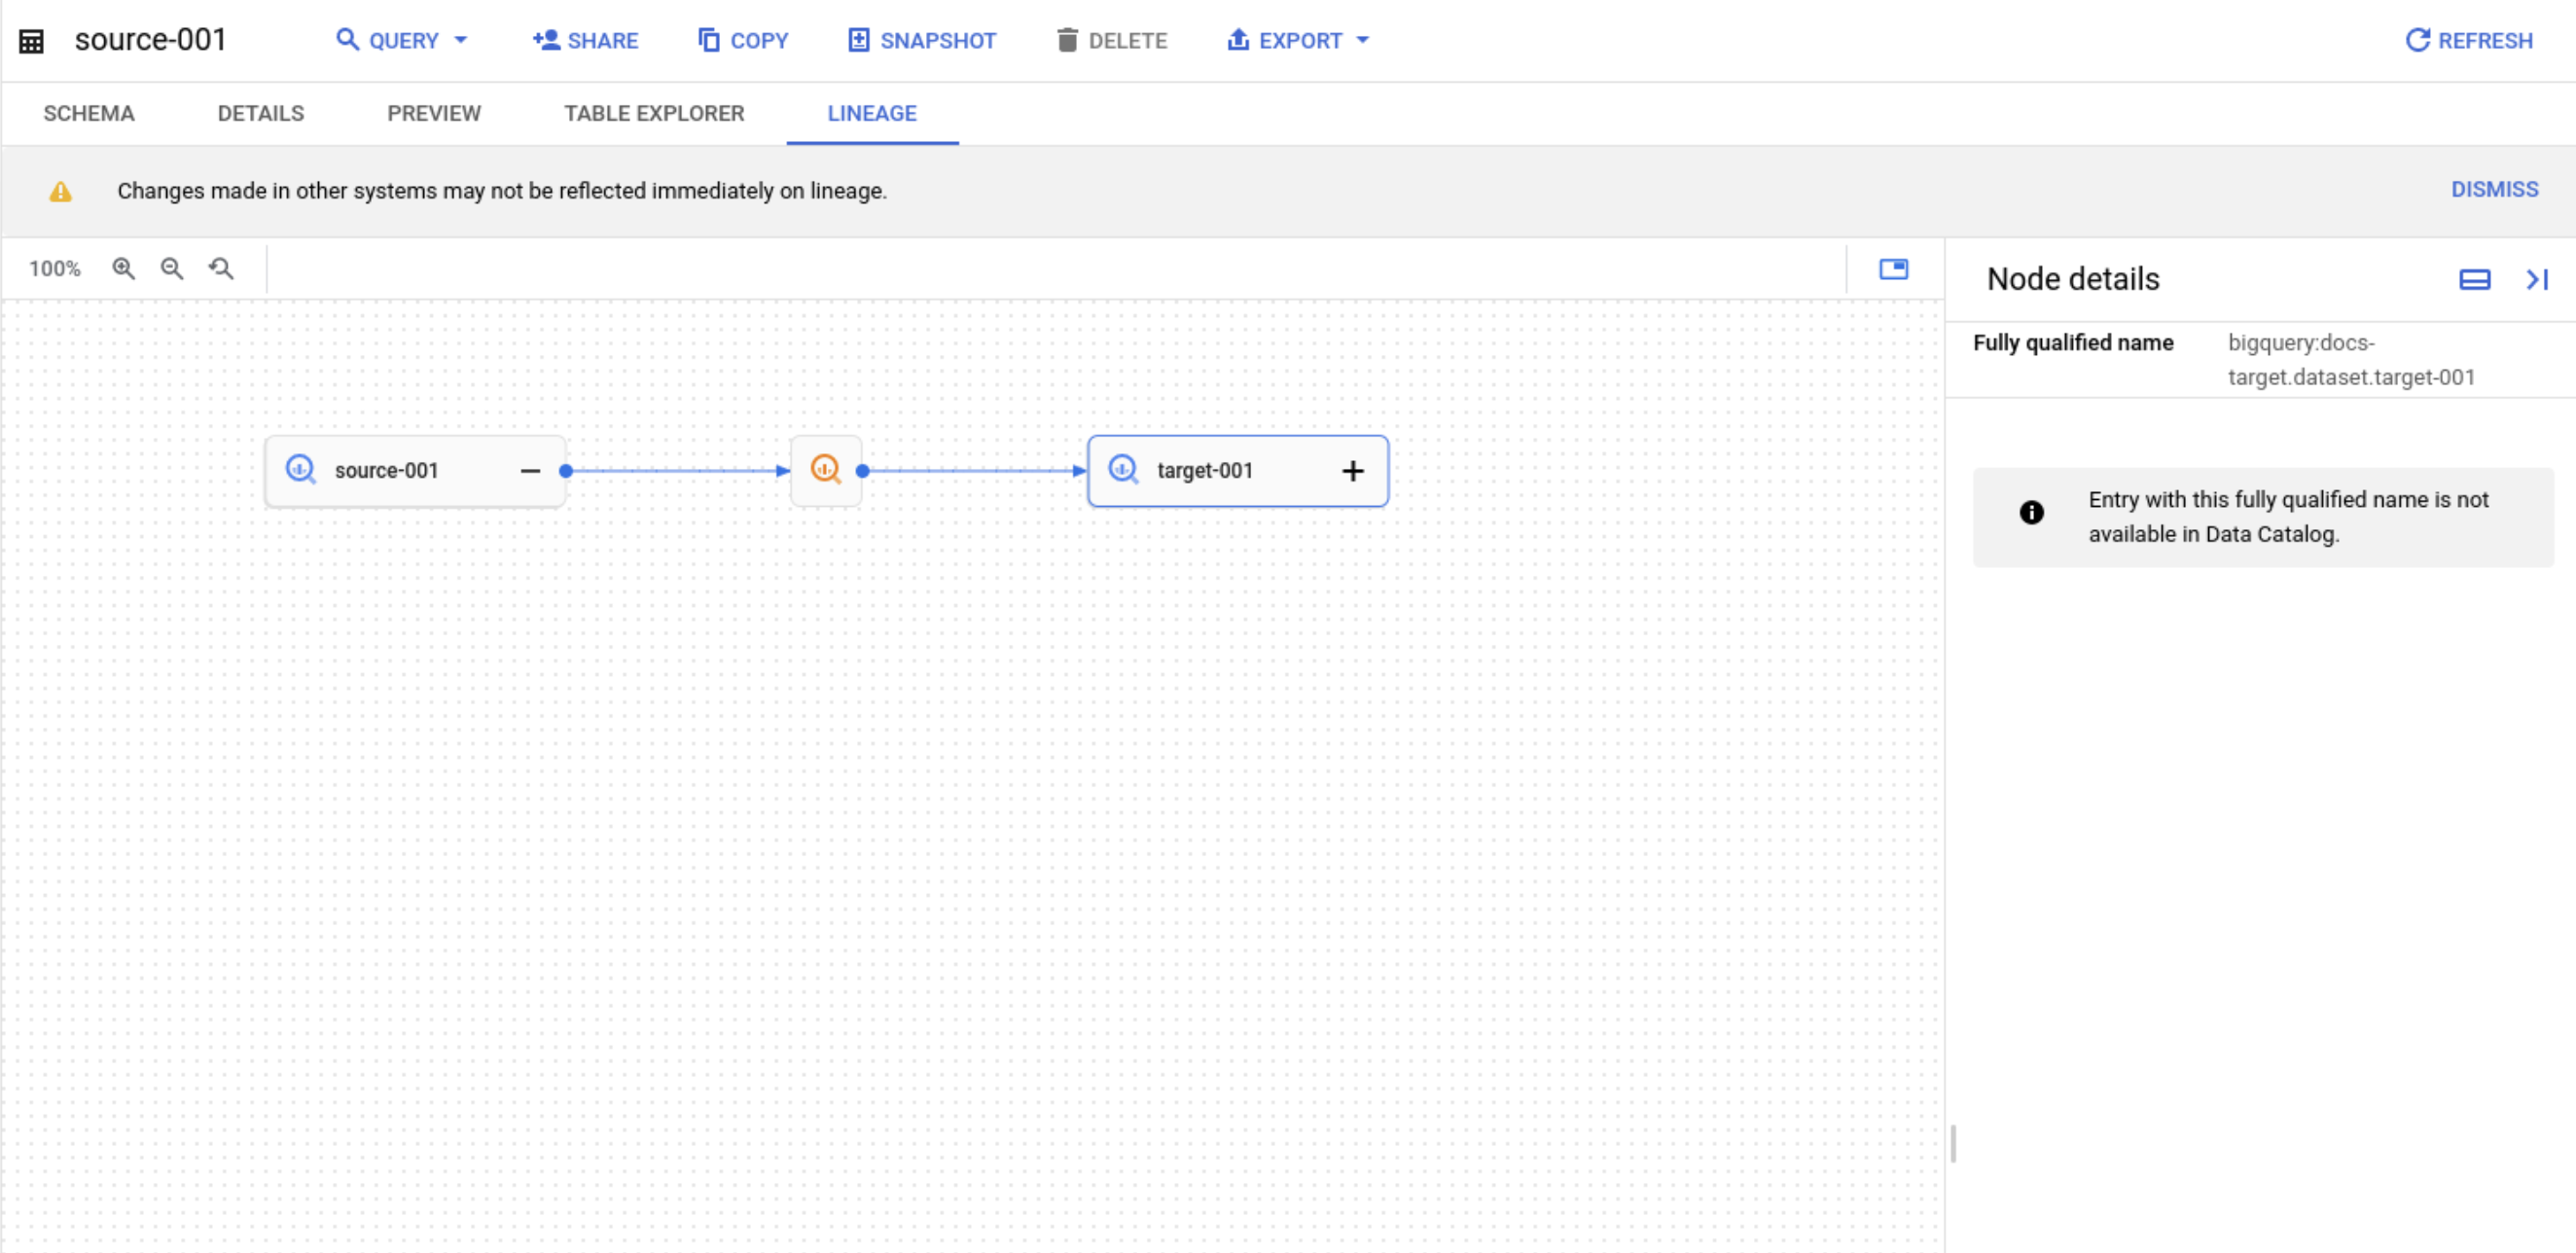
Um dieses Problem zu beheben, müssen Sie die Berechtigung bigquery.tables.get (z. B. in der Rolle BigQuery-Datenbetrachter enthalten) im Storage-Projekt gewähren.
Bei der Herkunft auf Spaltenebene wird die Meldung „Es sind keine Spalten zum Auswählen vorhanden“ angezeigt.
Das folgende Problem tritt auf, wenn Sie ein Asset in der Google Cloud Konsole aufrufen und das Lineage-Diagramm auf Tabellenebene richtig angezeigt wird, aber beim Auswählen von Lineage auf Spaltenebene die Meldung „Es sind keine Spalten zum Auswählen vorhanden“ angezeigt wird oder keine Spalten-zu-Spalten-Verknüpfungen zu sehen sind.
Dieses Problem kann in den folgenden Szenarien auftreten:
- Benutzerdefinierte OpenLineage-Ereignisse:Ereignisse, die über den
ProcessOpenLineageRunEvent-Endpunkt der Data Lineage API aufgenommen werden, unterstützen nur den Datenfluss auf Tabellenebene. Benutzerdefinierte Facetten auf Spaltenebene werden nicht in derGoogle Cloud Console gerendert. - Nicht unterstützte Datenquellen oder Systeme:Herkunftsgraphen auf Spaltenebene werden nur für BigQuery SQL-Transformationen und Managed Service for Apache Spark-Jobs generiert. Andere integrierte Systeme wie Cloud Data Fusion und Vertex AI unterstützen nur den Datenursprung auf Tabellenebene.
- Nicht unterstützte BigQuery-Jobtypen:Die Herkunft auf Spaltenebene wird nicht für Ladejobs, Kopierjobs oder Routinen in BigQuery erfasst.
- Externe Tabellen:Für externe Tabellen werden keine Upstream-Abstammungsinformationen auf Spaltenebene erfasst.
- Unstrukturierte Assets oder Assets auf Speicherebene:Obwohl dateibasierte Assets (z. B. Cloud Storage-Rohdateien oder -Buckets) in der Regel nicht strukturiert sind, können in der Datenherkunft Spalten für sie angezeigt werden, wenn die Herkunft auf Spaltenebene an das System gemeldet wird. Wenn die Herkunft auf Spaltenebene für das Datei-Asset nicht angegeben ist, können Sie keine Spalten auswählen.
- Komplexe verschachtelte Typen:Die Herkunft auf Spaltenebene wird nur für Spalten der obersten Ebene erfasst. Sie können keine Felder auswählen, die in komplexen Datentypen (z. B.
STRUCToderJSON) verschachtelt sind. - Pseudospalten für die Partitionierung:Systempartitionierungsspalten wie
_PARTITIONDATEund_PARTITIONTIMEwerden in Herkunftsgraphen auf Spaltenebene nicht erkannt. - Linklimits überschritten:Wenn bei einem Transformationsjob mehr als 1.500 Links auf Spaltenebene generiert werden, überspringt Knowledge Catalog die Erfassung der Herkunft auf Spaltenebene und behält nur die Herkunft auf Tabellenebene bei.
- Organisationsübergreifende Assets:Wenn ein Lineage-Pfad ein Asset in einer anderen Organisation durchläuft, können Sie nicht auf die Schema- und Spaltendetails zugreifen, wenn Sie nicht derselben Organisation wie das Asset angehören.
Unerwartete Gebühren für die Premium-Verarbeitung im Knowledge Catalog
Sie haben die Dataplex API (dataplex.googleapis.com) deaktiviert, um Gebühren zu vermeiden, sehen aber weiterhin tägliche Gebühren für die SKU „Knowledge Catalog Premium Processing“.
Dieses Problem kann auftreten, wenn die Data Lineage API (datalineage.googleapis.com) aktiviert bleibt. Die Data Lineage API wird unter der SKU „Knowledge Catalog Premium Processing“ abgerechnet, aber in der Google Cloud Console als separate API verwaltet. Wenn Sie die Dataplex API deaktivieren, wird die Data Lineage API nicht deaktiviert und die Gebühren dafür werden nicht eingestellt.
Wenn Sie feststellen möchten, ob die Gebühren auf die Datenherkunft zurückzuführen sind, suchen Sie in Ihrem Cloud Billing-Bericht nach dem Label goog-dataplex-workload-type mit dem Wert LINEAGE.
Um die Gebühren zu vermeiden, deaktivieren Sie die Data Lineage, indem Sie die Data Lineage API in Ihren Projekten deaktivieren.