


マネージド接続パイプラインは、サードパーティ ソースから Knowledge Catalog(以前の Dataplex Universal Catalog)にメタデータをインポートします。これらのパイプラインを使用して、メタデータを Knowledge Catalog に大規模にインポートし、ソースからデータを抽出できます。パイプラインは、必要に応じてGoogle Cloud プロジェクトに Knowledge Catalog エントリ グループも作成します。この方法では、ワークフローをオーケストレートし、要件に応じてインポート ジョブをスケジュールできます。
MySQL、SQL Server、Oracle、Snowflake、Databricks などのさまざまなサードパーティ ソースからメタデータを抽出するカスタム コネクタを構築します。また、より広範なソースに対してコミュニティ提供のカスタム コネクタを使用することもできます。
マネージド接続性の仕組み
次の図は、マネージド接続性パイプラインを示しています。
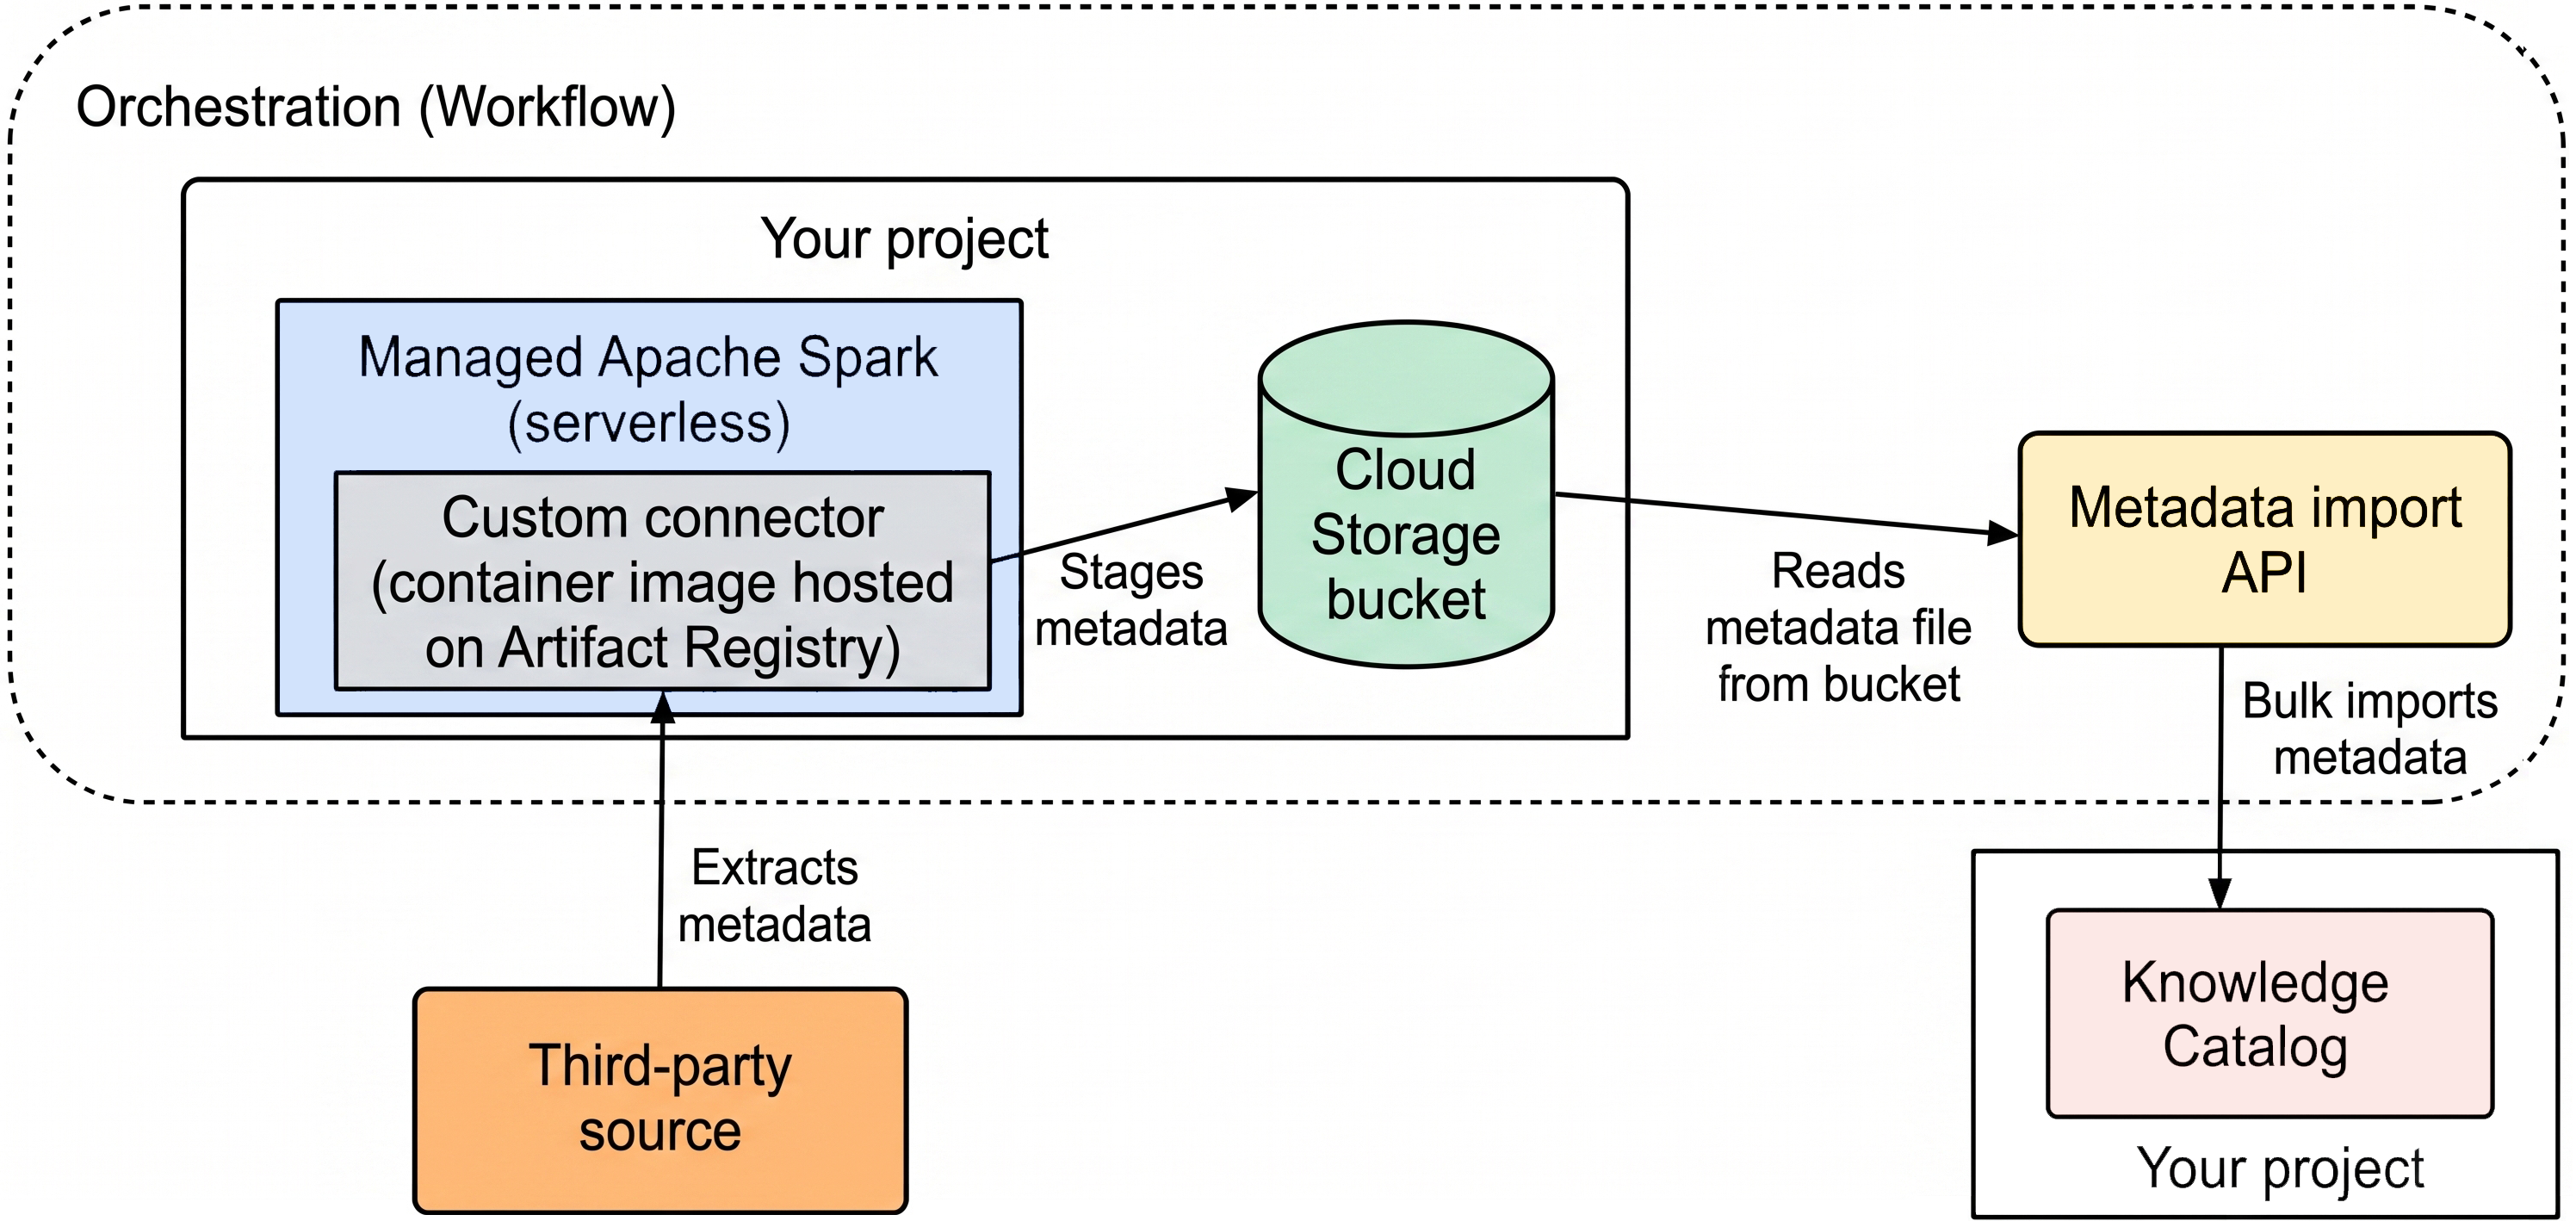
マネージド接続性の仕組みの概要は次のとおりです。
データソースのコネクタを構築します。
コネクタは、Managed Service for Apache Spark で実行できる Artifact Registry イメージであることが必要です。
オーケストレーション プラットフォームである Workflows でマネージド接続性パイプラインを実行します。
マネージド接続性パイプラインは、次のアクションを実行します。
- エントリ グループが存在しない場合は、構成に基づいてターゲット エントリ グループを作成します。
- コネクタを実行します。コネクタは、データソースからメタデータを抽出し、Knowledge Catalog にインポートできるメタデータ インポート ファイルを生成します。
- メタデータの抽出の進行状況をモニタリングします。
- メタデータのインポート ジョブを実行して、メタデータを Knowledge Catalog にインポートします。
- メタデータのインポート ジョブの進行状況をモニタリングします。
マネージド接続パイプラインは、Managed Service for Apache Spark を使用してコネクタを実行し、Knowledge Catalog メタデータ インポート API メソッドを使用してメタデータ インポート ジョブを実行します。
インポートするメタデータは、Knowledge Catalog エントリとそれらのアスペクトで構成されます。Knowledge Catalog のメタデータの詳細については、Knowledge Catalog のメタデータ管理についてをご覧ください。
コミュニティ提供のカスタム コネクタ
サードパーティ ソースからメタデータをインポートするには、コミュニティから提供されたカスタム コネクタを使用します。設定手順とコネクタの詳細については、各コネクタの README ファイルをご覧ください。
| データソース | リポジトリ |
|---|---|
| MySQL | mysql-connector |
| Oracle | oracle-connector |
| PostgreSQL | postgresql-connector |
| Snowflake | snowflake-connector |
| SQL Server | sql-server-connector |