


托管式连接流水线可将元数据从第三方来源导入 Knowledge Catalog(原 Dataplex Universal Catalog)。您可以使用这些流水线大规模将元数据导入 Knowledge Catalog,以从来源中提取数据。流水线还会根据需要在您的Google Cloud 项目中创建 Knowledge Catalog 条目组。借助此方法,您可以根据自己的需求编排工作流并安排导入作业。
您可以构建自定义连接器,以从各种第三方来源(包括 MySQL、SQL Server、Oracle、Snowflake 和 Databricks)提取元数据。或者,您也可以使用社区贡献的自定义连接器来连接更多来源。
托管式连接的运作方式
下图展示了托管式连接流水线。
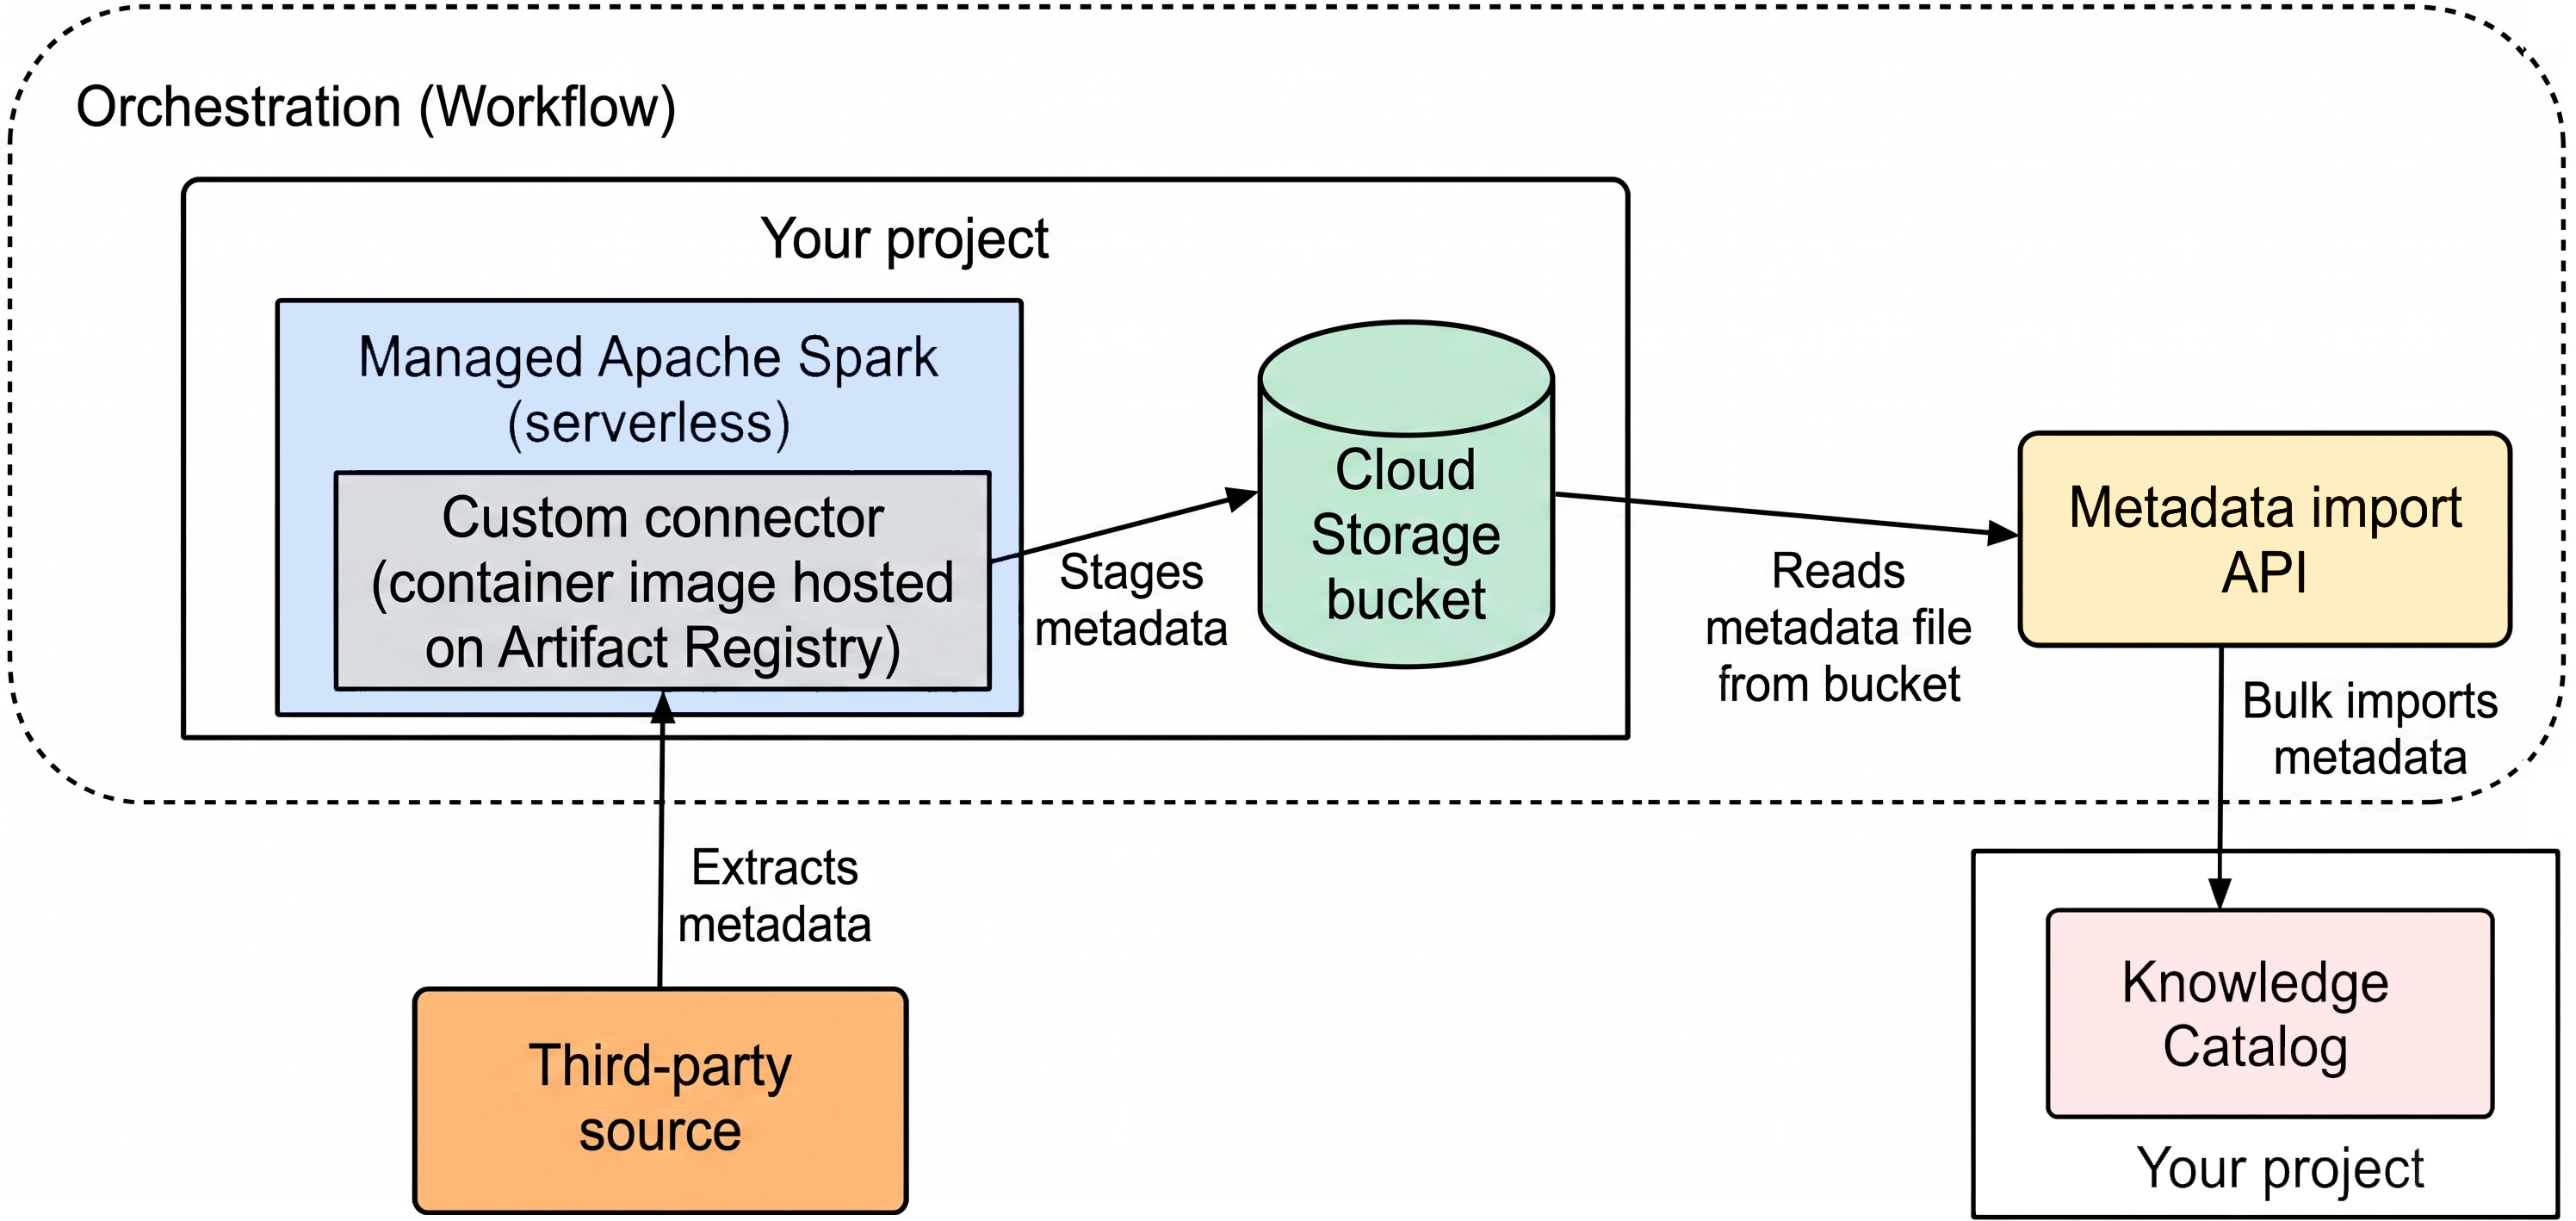
概括来讲,托管式连接的运作方式如下:
您需要为数据源构建连接器。
连接器必须是一个可在 Managed Service for Apache Spark 上运行的 Artifact Registry 映像。
您可以在编排平台 Workflows 中运行托管式连接流水线。
托管式连接流水线会执行以下操作:
- 根据您的配置创建目标条目组(如果该条目组尚不存在)。
- 运行连接器。连接器会从您的数据源提取元数据,并生成可导入 Knowledge Catalog 的元数据导入文件。
- 监控元数据提取的进度。
- 运行元数据导入作业,将元数据导入 Knowledge Catalog。
- 监控元数据导入作业的进度。
托管式连接流水线使用 Managed Service for Apache Spark 运行连接器,并使用 Knowledge Catalog 元数据导入 API 方法运行元数据导入作业。
您导入的元数据由 Knowledge Catalog 条目及其切面组成。如需详细了解 Knowledge Catalog 元数据,请参阅 Knowledge Catalog 中的元数据管理简介。
社区提供的自定义连接器
如需从第三方来源导入元数据,您可以使用社区贡献的自定义连接器。如需了解设置说明和有关连接器的更多信息,请参阅每个连接器的自述文件。
| 数据源 | 代码库 |
|---|---|
| MySQL | mysql-connector |
| Oracle | oracle-connector |
| PostgreSQL | postgresql-connector |
| 雪花 | snowflake-connector |
| SQL Server | sql-server-connector |