


A linhagem de dados ajuda você a entender como os dados se movem pelos sistemas ao rastrear os relacionamentos entre os recursos de dados e os processos que os transformam. É possível conferir essas informações de linhagem como gráficos e listas no console Google Cloud .
Este documento descreve a granularidade da linhagem de dados no nível da tabela e da coluna e fornece instruções para usar as visualizações em gráfico e em lista para explorar a linhagem de dados no console do Google Cloud .
Para detalhes sobre o modelo de dados subjacente, consulte o modelo de informações de linhagem de dados.
Diferenças entre a linhagem no nível da tabela e da coluna
Com a linhagem de dados, é possível rastrear a origem e o caminho de transformação dos seus dados nos níveis da tabela e da coluna.
Quando usar a linhagem no nível da tabela
A linhagem no nível da tabela oferece uma visão geral de alto nível dos seus pipelines de dados mostrando as relações entre tabelas inteiras. Use a linhagem no nível da tabela para tarefas de macro nível, como:
Descoberta de dados. Um analista que cria um painel novo pode usar a linhagem no nível da tabela para rastrear uma tabela de resumo até as fontes e confirmar se os dados vêm de um banco de dados confiável.
Planejamento de migração. Um administrador de banco de dados que planeja migrar um banco de dados principal pode usar a linhagem no nível da tabela para identificar todos os relatórios e painéis downstream que dependem dele.
Auditoria e governança. Um administrador de dados pode usar a linhagem no nível da tabela e da coluna para verificar como os dados de uma tabela que contém informações de identificação pessoal (PII) fluem por um pipeline.
Quando usar a linhagem no nível da coluna
A linhagem no nível da coluna oferece uma visão mais detalhada ao rastrear o fluxo de dados entre colunas individuais. Nessa visualização, os links em um evento de linhagem representam a relação entre uma coluna de origem e uma de destino. Cada um desses links no nível da coluna tem um tipo de dependência que descreve a transformação:
Exact copy: os valores são copiados entre colunas.Other: outros tipos de dependências entre colunas.
Use a linhagem no nível da coluna para tarefas como as seguintes:
Análise da causa raiz. Se um analista de dados encontrar um valor incorreto em uma coluna, ele poderá usar a linhagem no nível da coluna para rastrear até as colunas de origem e encontrar a causa raiz.
Análise de impacto. Antes de descontinuar uma coluna, um engenheiro de dados pode usar a linhagem no nível da coluna para encontrar todas as colunas downstream que dependem dela.
Verificação da fonte de dados para métricas. Um analista de dados pode usar a linhagem em nível de coluna para identificar quais colunas de origem são usadas para calcular uma métrica sem decifrar uma consulta SQL complexa.
A linhagem no nível da coluna é coletada automaticamente para os seguintes tipos de jobs do BigQuery:
Para jobs do Serviço Gerenciado para Apache Spark, o suporte depende do tipo e da versão da dependência do Open Lineage usada pelo Serviço Gerenciado para Apache Spark. A versão mínima compatível é a 1.34. Estas são as versões mínimas compatíveis de imagens de cluster do Serviço Gerenciado para Apache Spark:
- 3.0.3
- 2.3.22
- 2.2.75
- 2.1.107
Estas são as versões mínimas compatíveis do ambiente de execução do Serviço Gerenciado para Apache Spark:
- 3.0.3
- 2.3.20
Visualizações de linhagem no console do Google Cloud
Com a linhagem de dados no console Google Cloud , é possível interagir com informações de linhagem de duas maneiras: analisar o gráfico de linhagem em várias regiões disponíveis ou usar o painel Explorador de linhagem para ter uma visão mais focada em uma região específica. Você também pode alternar entre as visualizações Gráfico e Lista para analisar o fluxo de dados em diferentes níveis de detalhe.
As visualizações de linhagem estão disponíveis apenas para entradas do Knowledge Catalog (antigo Dataplex Universal Catalog), recursos do BigQuery e recursos da Vertex AI (modelos, conjuntos de dados, visualizações do Feature Store e grupos de atributos).
Para conferir as diferentes visualizações discutidas neste documento, consulte Usar linhagem de dados com sistemas Google Cloud .
Visualização do gráfico de linhagem
A visualização Gráfico mostra o fluxo e as relações de recursos de dados em sistemas e regiões, ajudando você a entender a arquitetura de dados, rastrear origens e destinos e identificar padrões. Esses gráficos de linhagem, gerados pelo serviço da API Data Lineage para uma entrada específica do Knowledge Catalog, mostram como os dados são transformados ao longo do tempo, exibindo fluxos upstream, downstream ou ambos de uma entrada raiz selecionada.
A API Data Lineage recebe automaticamente informações de ativos de sistemas compatíveis e por chamadas de API para fontes personalizadas.
Os principais elementos do gráfico são:
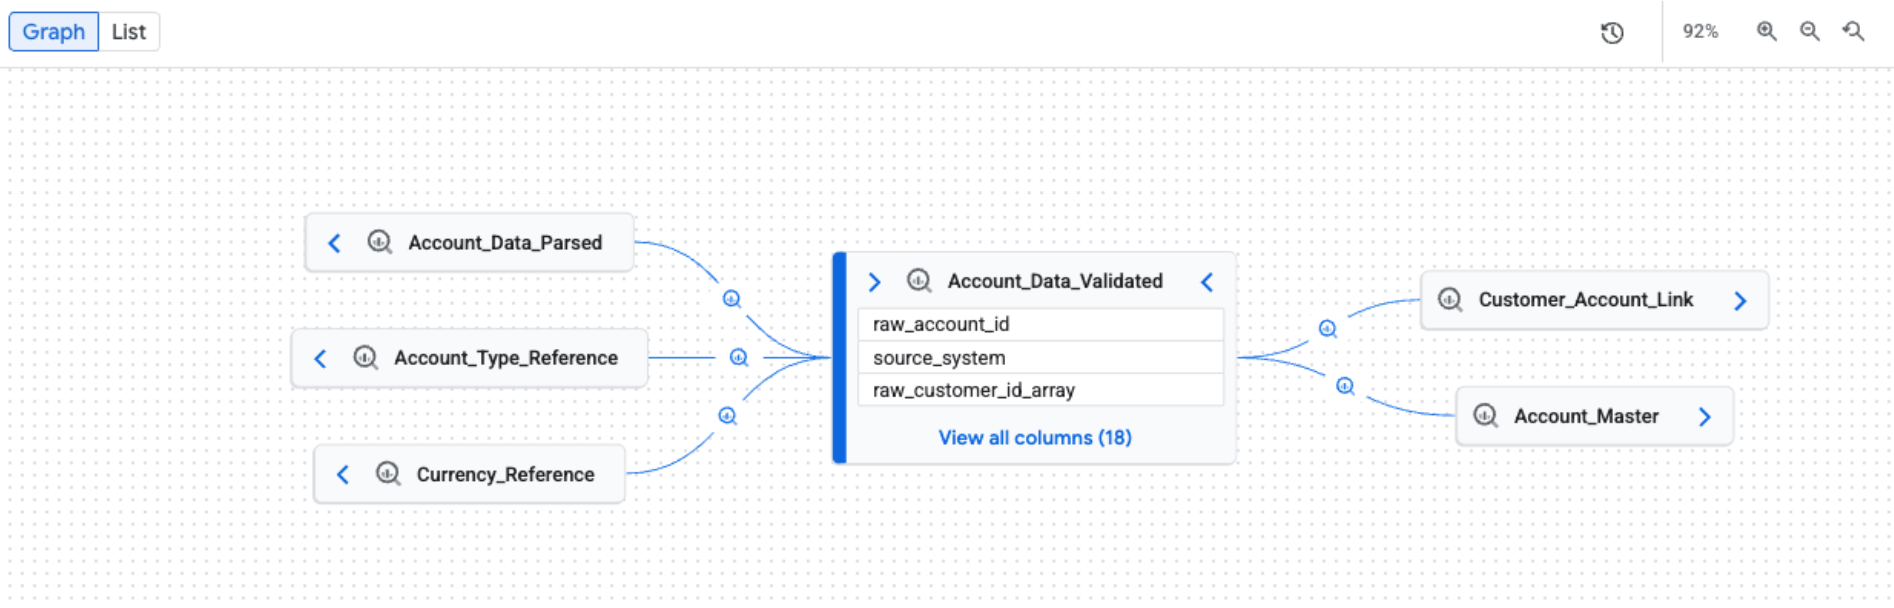
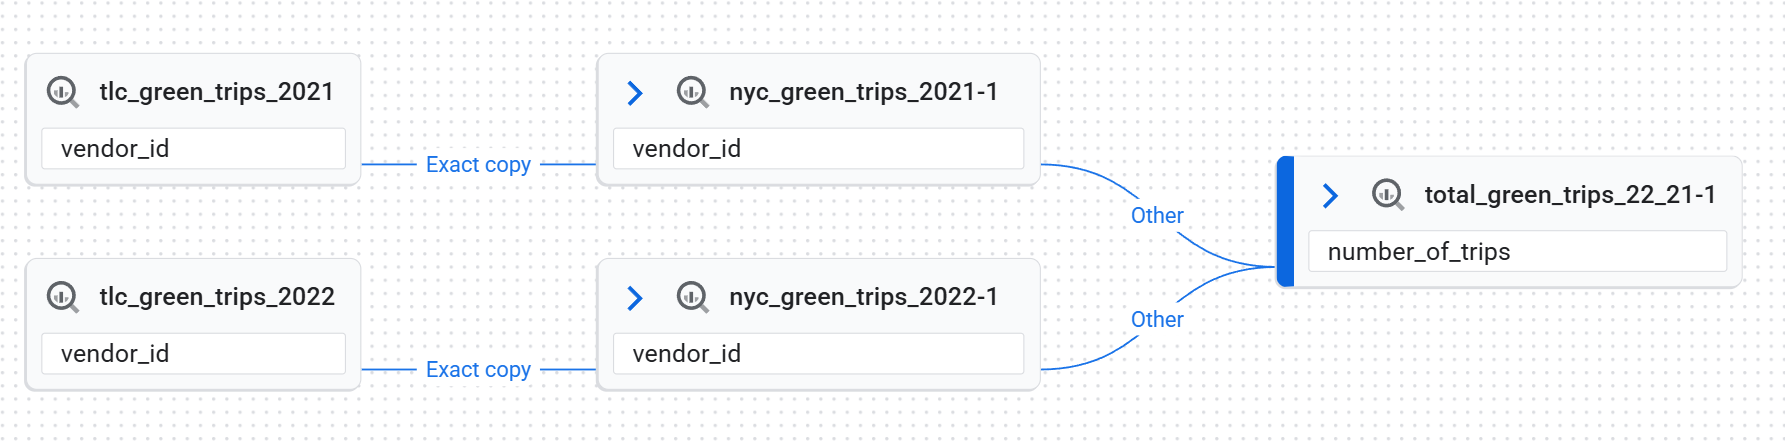
Nós. Os nós representam as entidades de dados. Em uma visualização no nível da tabela, um nó mostra o nome da tabela e as colunas dela. Em uma visualização no nível da coluna, cada nó representa uma tabela e uma coluna específicas.
Bordas. As arestas são as linhas que conectam os nós e representam os processos que ocorrem entre eles. A aparência de uma aresta depende da visualização de linhagem:
- Na visualização no nível da tabela, as arestas têm ícones que indicam transformações de dados.
- Na visualização no nível da coluna, as arestas têm rótulos para indicar transformações de dados. Por exemplo, um rótulo de aresta pode dizer
Exact copypara descrever como uma coluna de origem foi copiada para uma coluna de destino.
Processar ícones e rótulos. Os ícones e rótulos de processo aparecem nas bordas para fornecer mais informações sobre a transformação.
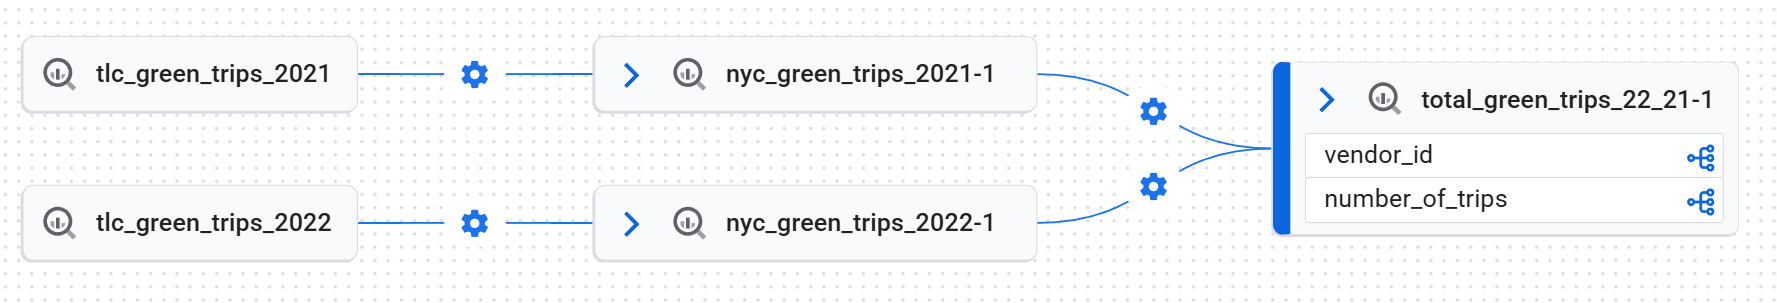
- Ícones. Os ícones representam o processo de transformação. Ao explorar o gráfico manualmente, os ícones nas arestas representam o sistema de origem do processo (por exemplo, BigQuery ou Vertex AI). Se vários processos estiverem envolvidos, um ícone "vários processos" será exibido. Se o sistema de origem do processo for desconhecido, um ícone de engrenagem será usado. Quando você aplica filtros, um ícone de engrenagem é usado para todos os processos.
- Rótulos Na visualização de linhagem no nível da coluna, um rótulo descreve o tipo de dependência entre colunas:
Exact copyouOther.
Analisar o gráfico de linhagem
Ao abrir a guia Linha de origem, você vê a visualização Gráfico padrão. A visualização padrão oferece uma visão geral de alto nível em sistemas e regiões, com expansão manual e incremental do gráfico que pode carregar cinco nós por vez. Os ícones de processo nas bordas representam o sistema de origem ou indicam vários processos.
Filtrar e destacar visualizações de linhagem de dados
Em gráficos de linhagem grandes e complexos, é possível aplicar filtros ou realces para reduzir o ruído visual e se concentrar na linhagem em uma região específica. Use o painel Explorador de linhagem para definir seus critérios. Quando os filtros são aplicados, uma barra de filtro aparece na parte de cima das visualizações Gráfico e Lista, mostrando os filtros ativos como ícones.
Para refinar a visualização do linhagem, escolha um dos seguintes modos:
Destaque: os nós correspondentes são enfatizados visualmente com cores e bordas, enquanto o gráfico completo permanece visível. Isso ajuda a localizar recursos específicos sem perder o contexto geral do gráfico de linhagem.
Filtrar: os nós que não correspondem são ocultados, e o gráfico é simplificado para mostrar apenas os nós correspondentes e os caminhos entre eles. Todos os recursos não correspondentes que fazem parte de um caminho entre nós correspondentes são agrupados em nós recolhidos. Esse modo é útil para reduzir a complexidade e focar apenas nos recursos relevantes e nas relações diretas deles.
Para filtrar ou destacar a linhagem, use os seguintes critérios:
- Projeto: filtre pelo ID do projeto Google Cloud .
- Sistema: filtre pelo sistema em que o recurso de dados está localizado (por exemplo, BigQuery ou Cloud Storage).
- Nome da entidade: filtre pelo nome do recurso. Você pode usar
*para pesquisas com caracteres curinga (somente prefixo e sufixo, por exemplo,*tableoutest*). - Subtipo: filtre por subtipo de recurso (por exemplo,
dashboardoumodel). - Nome da coluna: filtre a linhagem por nome da coluna para ver detalhes no nível da coluna.
- Direção: mostra a linhagem upstream ou downstream, ou ambas.
- Intervalo de tempo: filtre a linhagem com base em um horário de início ou término específico.
- Tipo de dependência: filtre a linhagem no nível da coluna com base no tipo de dependência.
Exemplos de opções disponíveis incluem
AllouExact copy.
Para reduzir ainda mais a confusão, selecione Ocultar tabelas temporárias do BigQuery e oculte os recursos transitórios criados pelo BigQuery, como tabelas em conjuntos de dados com nomes que começam com _script.
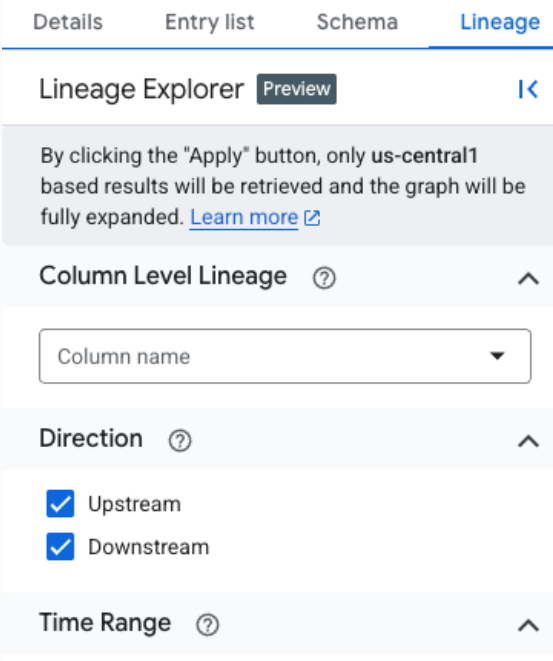
A visualização focada na guia Gráfico expande automaticamente o gráfico em até três níveis, carregando toda a linhagem que corresponde aos critérios de filtro. O explorador de linhagem busca até 10 níveis do gráfico de linhagem, mas apenas os três primeiros níveis são expandidos por padrão. Clique nas setas para expandir o gráfico e ver os níveis restantes.
A visualização focada oferece suporte à linhagem no nível da tabela e da coluna, incluindo visualização de caminho de qualquer nó selecionado de volta à raiz. Nessa visualização focada, um ícone de engrenagem genérico é usado para todos os processos.
Para conferir a linhagem no nível da coluna, use um dos seguintes métodos:
Em uma visualização Gráfico focada, clique no ícone de coluna em uma tabela para mudar para a linhagem no nível da coluna.
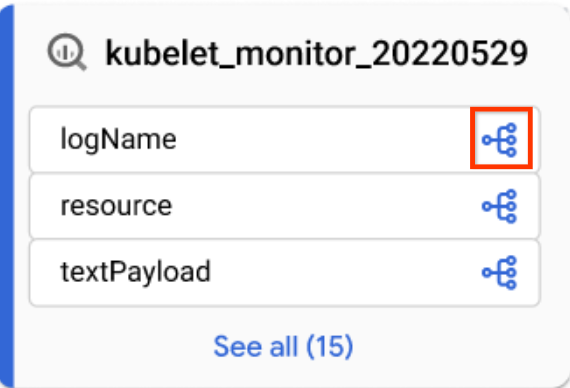
Ícone de coluna Na visualização padrão Gráfico ou na visualização focada Gráfico, aplique um nome de coluna no painel Análise de linhagem.
Para remover todos os filtros e voltar à visualização padrão, clique em Redefinir.
Para alternar entre os modos de destaque e filtro, consulte Refinar a visualização da linhagem.
Conferir detalhes do nó de linhagem
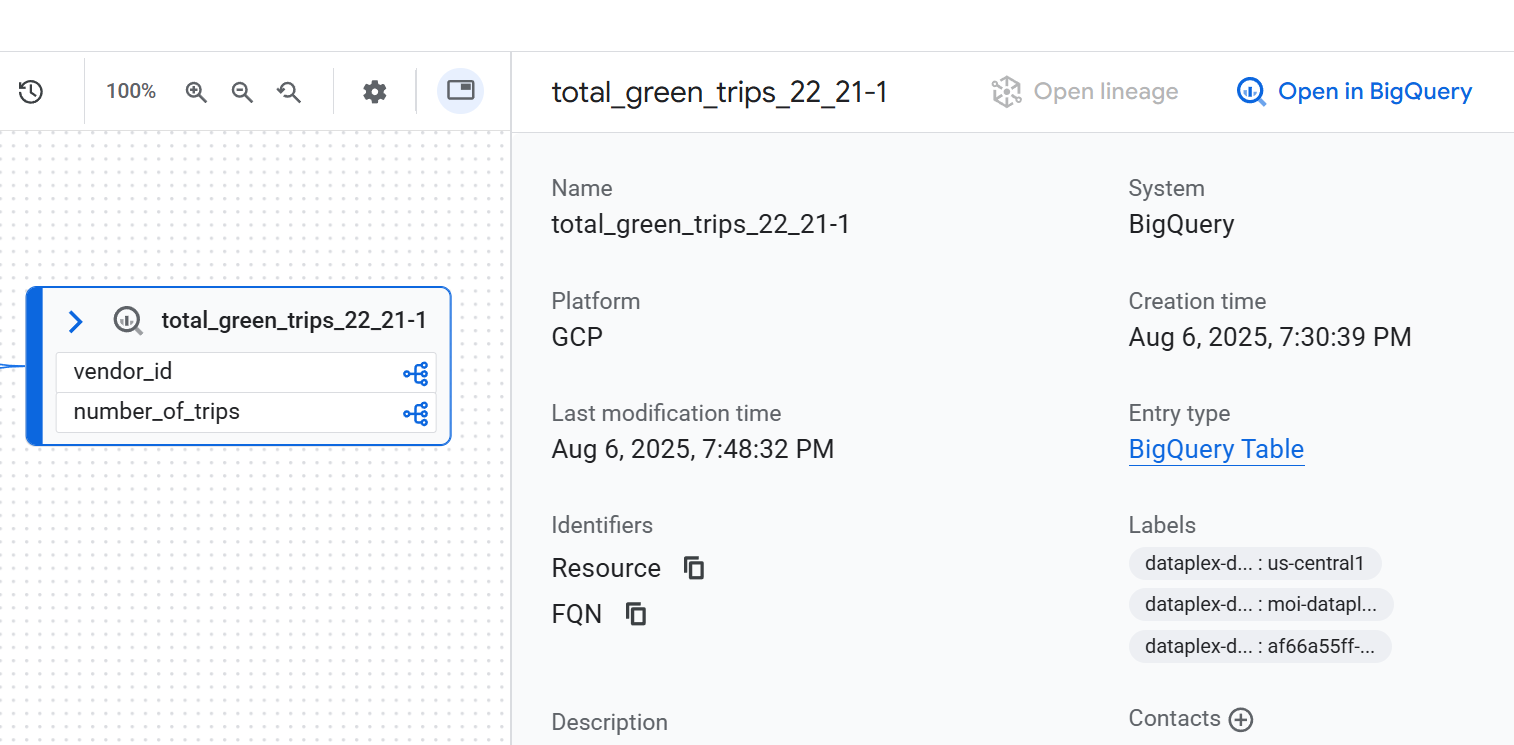
Para conferir os detalhes de um nó, clique nele. Um painel lateral aparece e mostra informações detalhadas sobre o recurso de dados selecionado. Por exemplo, em uma visualização de linhagem no nível da tabela, clicar em um nó mostra informações como o nome totalmente qualificado, o tipo e outros atributos relevantes do recurso.
Ver o histórico de execuções de linhagem
Um gráfico de linhagem completo é o resultado de execuções de vários jobs diferentes. Cada trabalho cria um link específico no gráfico. Várias execuções são registradas como novas execuções, mas não mudam a aparência estática do gráfico.
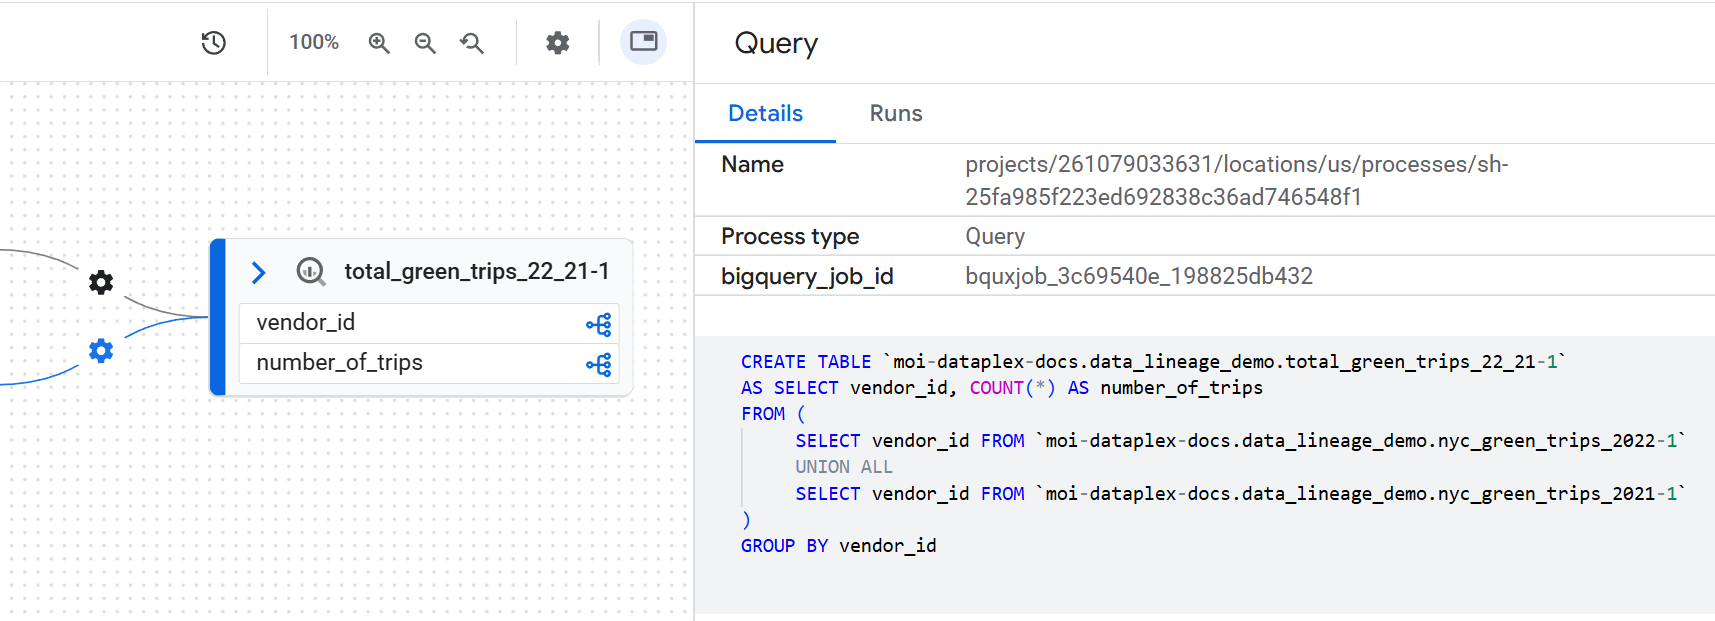
Para conferir os detalhes dessas execuções individuais, clique em uma aresta com um processo no gráfico. No painel Consulta, clique na guia Execuções.
Inspecionar a lógica de transformação de dados
Para entender a lógica de negócios de uma transformação sem pesquisar o código, é possível conferir a consulta SQL exata que foi executada. Para ver o código SQL, clique em uma aresta com um processo no gráfico. No painel lateral que aparece, clique na guia Detalhes.
Visualizar um caminho de linhagem de dados
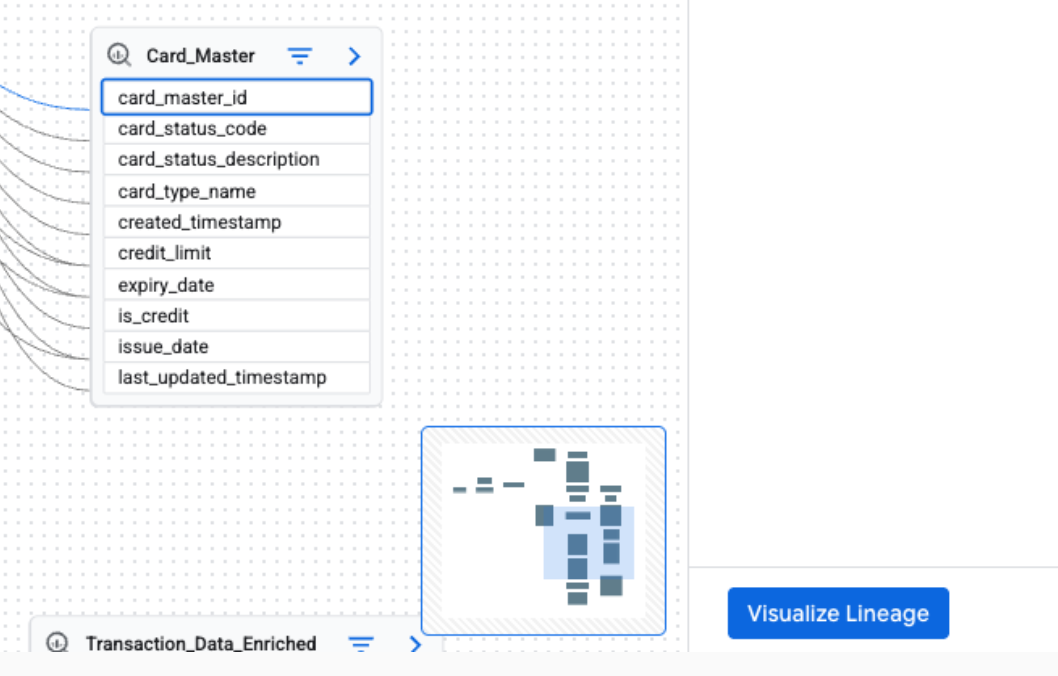
A visualização do caminho de linhagem ajuda a rastrear o caminho de qualquer nó selecionado no gráfico até a entrada raiz. Quando você seleciona um nó e clica em Visualizar caminho, o gráfico destaca apenas os nós e processos que formam o caminho de linhagem direta até a entrada raiz.
Para ver a visualização do caminho de linhagem, no painel Explorador de linhagem, aplique um filtro para criar uma visualização de Gráfico focada. Em seguida, na visualização Gráfico em foco, selecione um nó. No painel de detalhes do nó selecionado, clique em Visualizar caminho.
A visualização do caminho de linhagem está disponível para linhagem no nível da tabela e da coluna. Também é possível usar a visualização do caminho de linhagem na visualização Lista.
Visualização em lista de linhagem
A visualização Lista oferece uma representação tabular e estruturada da linhagem, sincronizada com a visualização Gráfico. Ele ajuda você a classificar, filtrar e baixar recursos de dados. Essa visualização é ideal para analisar relações de origem-destino, detalhar os recursos envolvidos e exportar dados de linhagem.
A visualização Lista está disponível para linhagem no nível da tabela e da coluna. É possível alternar entre as seguintes visualizações de lista detalhada e simplificada:
Visualização simplificada em lista: útil para ter uma lista condensada e exclusiva de todos os recursos envolvidos na linhagem. As colunas Sistema, Projeto, Entidade, FQN (nome totalmente qualificado), Direção e Profundidade ajudam a ver todos os recursos de dados na linhagem, onde eles residem, a origem original e a distância do recurso central que está sendo analisado. É ideal para uma visão geral de alto nível de todas as entidades que participam do fluxo de dados. Essa é a visualização padrão.
Visualização de lista detalhada: criada para analisar relações individuais de origem e destino. Ao fornecer colunas separadas para Origem e Destino, você pode conferir cada link de transformação de dados específico. Essa visualização é ideal para tarefas que exigem um entendimento profundo de como os dados se movem entre pares específicos de recursos, como auditoria de fluxos de dados individuais, compreensão das dependências entre tabelas ou exportação de registros detalhados de linhagem para cada conexão.
Visualização em lista da linhagem no nível da tabela
Essa visualização mostra as relações entre as tabelas como um todo. Use os filtros fornecidos para selecionar as colunas necessárias.
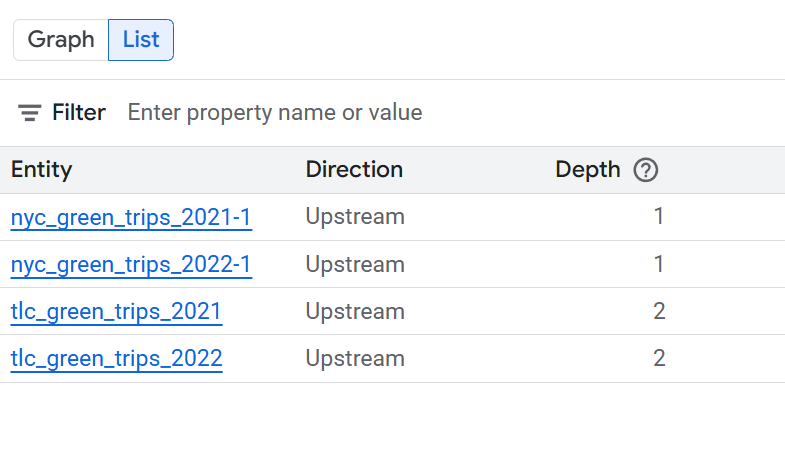
Abra as seções a seguir para conferir as colunas disponíveis nas visualizações de lista no nível da tabela.
Colunas disponíveis na visualização simplificada em lista no nível da tabela
- Sistema: o sistema em que o ativo de dados está localizado. Por exemplo, o [BigQuery](/bigquery/docs).
- Projeto: o ID do projeto Google Cloud que contém o recurso de dados.
- Entidade: o nome do recurso de dados. Por exemplo, um nome de tabela.
- FQN: o nome totalmente qualificado (FQN) da entidade ou coluna de origem original.
- Direção: indica se o recurso listado é upstream (origem) ou downstream (destino) no fluxo de linhagem.
- Profundidade: o número de etapas de linhagem do recurso central que está sendo analisado.
Colunas disponíveis na visualização em lista detalhada no nível da tabela
- Sistema de origem: o sistema em que o recurso de dados de origem está localizado. Exemplos incluem o BigQuery.
- Projeto de origem: o ID do projeto Google Cloud que contém o recurso de dados de origem.
- Origem: o nome do recurso de dados de origem. Por exemplo, um nome de tabela.
- FQDN de origem: o FQDN da entidade de origem.
- Sistema de destino: o sistema em que o recurso de dados de destino está localizado. Exemplos incluem o BigQuery.
- Projeto de destino: o ID do projeto Google Cloud que contém o recurso de dados de destino.
- Destino: o nome do recurso de dados de destino. Por exemplo, um nome de tabela.
- FQN de destino: o FQN da entidade de destino.
- Direção: indica se o recurso listado é upstream (origem) ou downstream (destino) no fluxo de linhagem.
- Profundidade: o número de etapas de linhagem do recurso central que está sendo analisado.
Visualização em lista da linhagem no nível da coluna
Essa visualização mostra as relações entre colunas individuais nas tabelas de origem e de destino. Use os filtros fornecidos para selecionar as colunas necessárias.
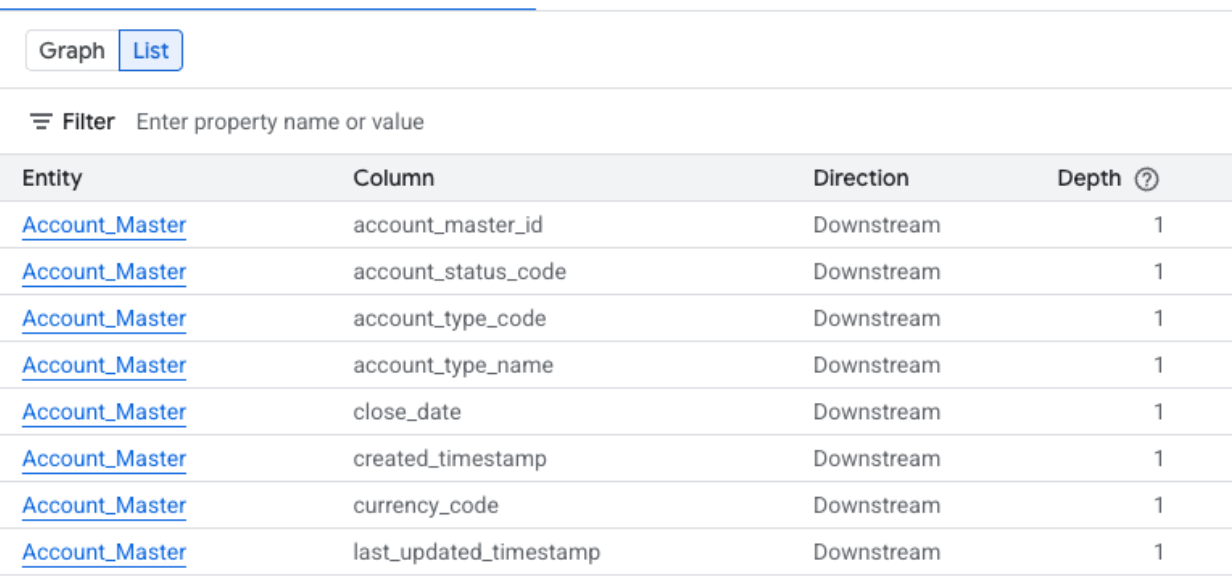
Expanda as seções a seguir para conferir as colunas disponíveis nas visualizações de lista no nível da coluna.
Colunas disponíveis na visualização simplificada em lista no nível da coluna
- Sistema: o sistema em que o recurso de dados está localizado. Exemplos incluem o BigQuery.
- Projeto: o ID do projeto Google Cloud que contém o recurso de dados.
- Entidade: o nome do recurso de dados. Por exemplo, um nome de tabela.
- Coluna: a coluna específica escolhida no painel Análise de linhagem dentro da entidade.
- FQN: o nome totalmente qualificado (FQN) da entidade ou coluna de origem original.
- Direção: indica se o recurso listado é upstream (origem) ou downstream (destino) no fluxo de linhagem.
- Profundidade: o número de etapas de linhagem do recurso central que está sendo analisado.
Colunas disponíveis na visualização em lista detalhada no nível da coluna
- Sistema de origem: o sistema em que o recurso de dados de origem está localizado.
- Projeto de origem: o ID do projeto Google Cloud que contém o recurso de dados de origem.
- FQN de origem: o FQN da coluna de origem.
- Sistema de destino: o sistema em que o recurso de dados de destino está localizado.
- Projeto de destino: o ID do projeto Google Cloud que contém o recurso de dados de destino.
- FQDN de destino: o FQDN da coluna de destino.
- Direção: indica se o fluxo de dados é upstream ou downstream.
- Tipos de dependência: descreve a natureza da relação entre as colunas.
- Profundidade: o número de etapas de linhagem do recurso central que está sendo analisado.
A seguir
Saiba mais sobre as origens de linhagem.
Saiba como rastrear a linhagem de dados de uma cópia de tabela do BigQuery e jobs de consulta.
Saiba como usar a linhagem de dados com sistemas Google Cloud .